Mostrando entradas con la etiqueta Agentes de IA. Mostrar todas las entradas

jueves, 20 de agosto de 2026

Plan de Estudios para Preparar la Fuerza Laboral en IA

Este documento presenta la Escalera de Capacidades, un marco curricular diseñado para alinear la educación superior y la formación profesional con la rápida evolución de la inteligencia artificial. Los autores argumentan que, si bien la IA automatiza tareas rutinarias, también aumenta la demanda de verificación humana, pensamiento sistémico y supervisión ética. Para abordar esto, proponen una progresión de cinco niveles de autonomía operativa, que abarca desde simples activadores hasta equipos multiagente, y que sirve de base tanto para la evaluación como para el diseño de cursos. Este modelo prioriza las capacidades técnicas duraderas sobre las habilidades específicas de herramientas, que suelen ser efímeras, garantizando que los graduados sigan siendo relevantes a medida que los flujos de trabajo profesionales evolucionan hacia la colaboración entre humanos e IA. Mediante la implementación de evaluaciones que tienen en cuenta la carga de trabajo y credenciales acumulables, el marco ofrece una hoja de ruta práctica para que las instituciones se modernicen sin abandonar los principios informáticos fundamentales. La evidencia de un curso piloto exploratorio demuestra cómo este enfoque permite que tanto estudiantes técnicos como no técnicos gestionen de forma responsable sistemas complejos aumentados con IA.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "The Capability Ladder: A Curriculum-Modernization Framework for Workforce Readiness in the AI Era". Por Majid Memari y George Rudolph. Publicado el 7 de Agosto de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Tienes razón, durante los últimos años, ver el mercado laboral tecnológico se ha sentido un poco como ver una película de ciencia ficción, donde los robots finalmente se apoderan del piso de la fábrica.

Beto
Oh, totalmente.

Alicia
Ves las ofertas de trabajo para puestos de nivel inicial que caen en picada, ves los titulares, y es increíblemente fácil saltar a la conclusión de que el trabajo de computación tradicional está acabado. Que un algoritmo esencialmente se ha tragado toda la disciplina.

Beto
Es una ansiedad realmente omnipresente. Y quiero decir, cuando miras los números brutos en la superficie, la gente naturalmente busca narrativas claras.

Alicia
Claro.

Beto
Y la narrativa más fácil de agarrar es simplemente: "bueno, un trabajo desapareció, por lo tanto, la inteligencia artificial debe haberlo tomado".

Alicia
Correcto. Muy bien, desglosemos esto. Porque para empezar con nuestra misión para este análisis profundo, estamos analizando un artículo fascinante de 2026 de Majid Mahmari y George Rudolph.

Beto
Sí, de la Utah Valley University.

Alicia
Exacto. UVU, se titula "La Escalera de Capacidad" ("The Capability Ladder"). Y el objetivo de su investigación es averiguar cómo preparamos realmente a los estudiantes y a la fuerza laboral más amplia, para esta era de la IA, sin caer en los extremos.
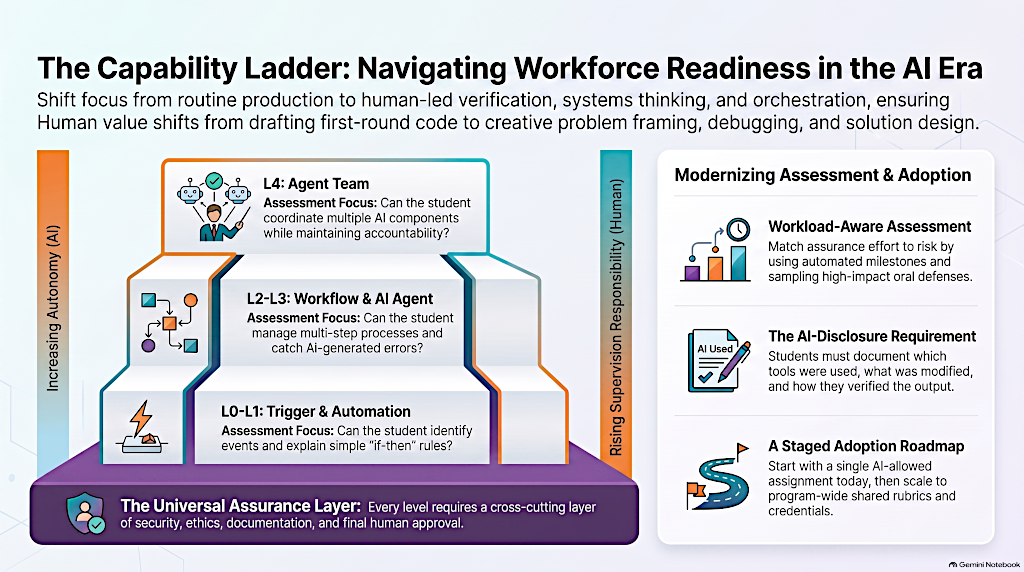
Workforce_Readiness_Capability_Ladder_1024.png
La Escalera de Capacidades: Cómo Preparar a la Fuerza Laboral en la Era de la IA

Beto
Claro.

Alicia
Porque ahora mismo, ves que las organizaciones están, o bien persiguiendo frenéticamente cada nueva moda de herramienta.

Beto
Los objetos brillantes en general.

Alicia
Sí. O están simplemente ignorando obstinadamente la IA por completo, como si fingieran que no está sucediendo.

Beto
Y ninguno de esos enfoques sirve al estudiante. Y ciertamente no reflejan lo que la industria está exigiendo en realidad ahora mismo.

Alicia
Claro.

Beto
Pero para entender lo que quiere la industria, primero tenemos que entender lo que realmente le pasó al mercado laboral. Porque el artículo profundiza en esos escalofriantes números de despidos tecnológicos, que mencionaste.

Alicia
Los grandes.

Beto
Sí. Aproximadamente 153,000 despidos tecnológicos en 2024. Y luego otros 124,000 en 2025.

Alicia
Lo cual es enorme.

Beto
Lo es. Antes de que las cosas finalmente comenzaran a suavizarse aquí en 2026.

Alicia
Así que, si eres un estudiante que mira esos números, o incluso un profesional de carrera media que intenta mejorar sus habilidades, el pánico parece la respuesta totalmente lógica.

Beto
Lo es. Realmente lo es. Pero aquí es donde tenemos que introducir un concepto crítico del artículo, que es el peligro de los factores de confusión. Es un error estadístico masivo atribuir esas pérdidas de empleo enteramente a la IA. Lo que estamos viendo en los datos observacionales es correlación, no causalidad.

Alicia
¿Así que simplemente están sucediendo al mismo tiempo?

Beto
Exacto. Los autores señalan varias fuerzas no relacionadas con la IA que simplemente coinciden en golpear exactamente al mismo tiempo en el que la IA generativa entró en el mercado principal.

Alicia
Muy bien, desglosemos eso. ¿Qué más estaba sucediendo en segundo plano?

Beto
Bueno, primero, tienes la contracción macroeconómica posterior a 2022.

Alicia
Claro.

Beto
Las tasas de interés subieron significativamente, lo que inmediatamente enfrió la contratación especulativa de tecnología.

Alicia
Porque el dinero ya no era gratis.

Beto
Exacto. El capital ya no era barato. Y segundo, vimos una corrección masiva de la era de la pandemia.

Alicia
Oh, cierto.

Beto
Entre 2020 y 2022, las empresas de tecnología contrataron en exceso. Estaban tratando de satisfacer este pico temporal en la demanda digital.

Alicia
Porque todo el mundo estaba encerrado en casa.

Beto
Claro. Así que muchos de los despidos recientes fueron simplemente una dolorosa reversión a la media. Estaban desprendiéndose de la capacidad excedente.

Alicia
Bien. Esa parte la hemos visto bastante en las noticias. Pero había otro factor en el material de origen que me sorprendió. Y no tiene absolutamente nada que ver con la tecnología. Es una ley fiscal.

Beto
Sí. Y este es un factor que pasa completamente por debajo del radar. Tenemos que mirar el tratamiento fiscal de EE. UU. para la I+D de software. Específicamente, es la regla de amortización de sección 174 que entró en vigor para el año fiscal de 2022.

Alicia
Tengo que preguntar, ¿cómo el cambio de un código fiscal lleva a los ingenieros de software a perder sus trabajos? ¿Cuál es la conexión?

Beto
Bueno, fundamentalmente cambió cómo las empresas pueden deducir los gastos de investigación y desarrollo. Lo cual, crucialmente, incluye los salarios de ingeniería de software.

Alicia
Oh, vaya.

Beto
Durante décadas, las empresas podían deducir esos costos inmediatamente en el mismo año en que los pagaron. Pero de repente, la ley les exigió anunciar o distribuir esas deducciones a lo largo de cinco años.

Alicia
Oh, ya veo.

Beto
Prácticamente hablando, esto elevó drásticamente el costo inmediato posterior de contratar a un ingeniero de software. El flujo de caja sufrió un golpe masivo.

Alicia
Vaya.

Beto
Así que naturalmente, la contratación se ralentizó.

Alicia
Entonces, para poner esto en perspectiva, culpar a la IA por todos los despidos tecnológicos es como culpar a un coche que se está demorando por la gasolina que acabas de comprar, ignorando completamente el hecho de que también estás tratando de subir una pendiente de 40 grados y alguien dejó el freno de estacionamiento puesto.

Beto
Esa es una analogía perfecta.

Alicia
Las tasas de interés y los códigos fiscales son la pendiente y el freno de estacionamiento.

Beto
Esa es una forma mucho más precisa de ver el mercado laboral.

Lo fascinante aquí es cómo el artículo nos ayuda a desenredar esto distinguiendo entre cuatro términos que se confunden constantemente en los medios.

Alicia
Y esa confusión es lo que causa mucho de este pánico.

Beto
Exacto. Esos términos son exposición, automatización, aumentación y desplazamiento.

Alicia
Muy bien. Si las fuerzas económicas externas están impulsando los despidos, ¿qué está pasando realmente con las tareas diarias de los ingenieros que se quedan atrás? ¿Sus empleos también se están desvaneciendo?

Beto
Para responder a eso, tenemos que mirar muy de cerca esos cuatro términos.

Así que exposición simplemente significa que una ocupación depende de tareas que la IA está mejorando actualmente. Si escribes código, tu trabajo tiene alta exposición.

Automatización, por otro lado, es cuando la IA realmente sustituye una tarea humana específica.

Alicia
Como generar una consulta SQL de plantilla ("boilerplate").

Beto
Exacto.

Luego está la aumentación. Eso es cuando la IA complementa a una persona elevando su productividad general. Siguen haciendo el trabajo, solo más rápido o mejor.

Alicia
Y luego está el desplazamiento, que es el que todos temen, ¿verdad? La pérdida neta real de empleos donde la demanda de trabajo humano simplemente cae.

Beto
Precisamente. Y la conclusión clave de los análisis laborales globales del autor es que "la exposición no equivale al desplazamiento".

Alicia
Esa es una distinción enorme.

Beto
Es vital. El artículo argumenta que lo que estamos experimentando en toda la industria es reasignación y aumentación. Los trabajos no simplemente están desapareciendo en el éter. La naturaleza diaria del trabajo de software está siendo radicalmente reorganizada.

Alicia
Profundicemos en esa reorganización. Porque ¿por qué algunos puestos se están encogiendo mientras que otros parecen estar explotando en demanda?

Beto
Se reduce al costo económico del primer borrador.

Alicia
¿El primer borrador?

Beto
Sí. La IA generativa ha reducido drásticamente el costo y el tiempo requeridos para la codificación e implementación rutinaria. Si una empresa solo necesita código de plantilla estándar, o un script de clasificación básico, un modelo de IA puede hacerlo casi instantáneamente, por fracciones de centavo.

Debido a que esa tarea específica de implementación es ahora increíblemente barata, el valor del trabajo humano se desplaza completamente a lo que sucede después de que se genera ese primer borrador: El sistema de verificación, el análisis de seguridad y el planteamiento creativo de problemas.

Importante, estamos viendo una gran demanda de humanos en la orquestación del bucle ("human-in-the-loop").

Alicia
Correcto.

Beto
Necesitamos profesionales que puedan supervisar a la IA, detectar sus alucinaciones, comprender el contexto empresarial más amplio, y luego integrar esas salidas de la IA en un sistema más grande y confiable.

Alicia
Los datos y el artículo respaldan eso perfectamente. Miran proyecciones de EE. UU. de 2023 a 2033, y es una historia de dos trayectorias completamente diferentes. Se proyecta que los puestos de programación informática rutinaria disminuyan en un 10%. Pero al mismo tiempo, se proyecta que los científicos de datos crezcan en un 36%.

Beto
Increíble, un empujón.

Alicia
Y los analistas de seguridad de la información en un 33%. El mercado básicamente está gritando por personas que puedan evaluar, asegurar y gestionar estos sistemas complejos, no solo escribir sintaxis.

Beto
Lo que nos lleva al desafío educativo central que los autores están tratando de resolver. Si el mercado necesita verificadores y orquestadores, la academia no puede seguir enseñando a la gente a ser solo mecanógrafos rutinarios de código.

Alicia
Correcto. Así que si ya no estamos enseñando a los estudiantes a escribir bucles de plantilla, ¿cómo se ve realmente un plan de estudios de computación moderna? Parece que tiene que ser una mezcla de construir la tecnología subyacente, aprender a usarla como una herramienta diaria, y luego descubrir cómo actuar como gestor de la IA.

Beto
Esa síntesis es exactamente lo que los autores proponen con su "modelo de enseñanza de tres ramas" ("Three-strand Teaching Model"). Y son muy explícitos en que la solución no es simplemente lanzar un curso genérico de introducción a la IA en el catálogo de la universidad.

Alicia
Claro. Porque eso no soluciona realmente el problema central.

Beto
No, para nada. Las tres ramas deben operar simultáneamente:

  • La rama uno es construir los fundamentos de la IA.
  • La rama dos es usar la IA como una herramienta de ingeniería, lo que incluye crucialmente la documentación rigurosa de ese uso.
  • Y la rama tres es supervisar y orquestar agentes de IA.

Alicia
Tengo que rebatir un poco esa primera rama, sin embargo. ¿Realmente necesita todo el mundo aprender a construir modelos de IA desde cero? Si yo fuera un estudiante de negocios o un gerente de proyecto haciendo un bootcamp de mejora de habilidades para la fuerza laboral, ¿realmente necesito meterme hasta el cuello en las matemáticas de las arquitecturas de redes neuronales?

Beto
Esa es una pregunta crucial. Y los autores proporcionan algunos matices realmente importantes allí. Ajustas la profundidad de esas tres ramas según la trayectoria específica del estudiante.

Un estudiante de ciencias de la computación recorrerá toda la profundidad de esa rama de construcción. Necesitan saber cómo implementar componentes de aprendizaje automático bajo el capó.

Alicia
Eso tiene sentido para los ingenieros tradicionales.

Beto
Pero para estudiantes de negocios o profesionales que buscan mejorar sus habilidades, la rama de construcción se reduce mucho. Para ellos, se trata solo de los fundamentos conceptuales.

Alicia
Tal como solo saber cómo funciona en general.

Beto
Correcto. Entender qué es realmente un LLM, captar sus limitaciones y saber por qué alucina. Su plan de estudios estará fuertemente ponderado hacia la segunda y tercera ramas, diseñando flujos de trabajo y supervisando esos agentes de IA para resolver problemas empresariales.

Alicia
Eso parece mucho más práctico. Coincide la habilidad con la función laboral real.

Pero eso nos lleva a la pregunta más grande de toda esta inmersión profunda. Saber qué habilidades necesita el mercado es una cosa. Pero ¿cómo enseñas y evalúas realmente a un estudiante que tiene una herramienta en su portátil que puede generar una tarea de codificación perfecta de A+ en tres segundos?

Beto
Eso rompe por completo el modelo tradicional de calificación.

Alicia
Totalmente.

Beto
Si la tarea es solo un script que hace X, la IA lo hace. El estudiante no aprende absolutamente nada. Y el profesor esencialmente solo está calificando una máquina.

Alicia
Aquí es donde se pone realmente interesante porque los autores resuelven esta crisis de evaluación con su marco central: La "escalera de capacidad" ("capability ladder").

Beto
La escalera de capacidad es un brillante enfoque pragmático. Es un marco de progresión de cinco niveles. Y lo más vital para graficar es que el eje vertical de esta escalera no está midiendo la madurez intelectual del estudiante. Está midiendo la autonomía operativa del sistema de IA que se está utilizando y la responsabilidad de supervisión humana correspondiente que el estudiante debe demostrar.

Alicia
Así que básicamente, entregar más poder y autonomía a la máquina, significa que el humano tiene que demostrar que la puede controlar.

Beto
Precisamente. Vamos a revisar cómo se escala. El nivel 0 es el "disparador" ("trigger"). Esta es la interacción más básica. Un evento inicia un proceso. Por ejemplo, un estudiante configura un sistema donde recibir un correo electrónico con una línea de asunto específica pone en marcha un proceso.

Alicia
Así que solo una simple causa y efecto.

Beto
Exacto. Luego el nivel 1 es la automatización. Una acción específica se dispara a partir de ese disparador. Es un escenario determinista de "si esto entonces aquello". Si llega ese correo electrónico, entonces guarda el archivo en una carpeta específica.

Alicia
Entendido.

Beto
El trabajo del estudiante es explicar la condición, la acción y lo que sucede si el sistema no logra guardarlo.

Alicia
Todavía bastante básico. Hemos tenido ese tipo de automatización durante mucho tiempo.

Beto
Lo hemos tenido.

Pero el nivel 2 sube a un "flujo de trabajo" ("workflow"). Este es un proceso fijo, de varios pasos en diferentes herramientas. El sistema recibe el archivo, extrae algo de texto, lo dirige a una base de datos y luego consulta un canal de mensajería.

Alicia
Bien, así que más partes móviles.

Beto
Sigue siendo determinista, pero es complejo. El estudiante tiene que demostrar que puede diseñar, gestionar y manejar un "pipeline" (una "tubería" de conexiones y flujo de datos) confiable.

Alicia
Claro, pero en el nivel 2, el sistema sigue siguiendo ciegamente un conjunto rígido de reglas. ¿Cómo cruzamos el umbral hacia la verdadera autonomía de la IA generativa?

Beto
Eso sucede en el nivel 3, el agente de IA. Este es un cambio tecnológico masivo desde el nivel 2. Un agente es un sistema dirigido a objetivos que evalúa su entorno, hace planes y actúa. No solo está siguiendo una rama de "si-entonces".

Alicia
¿Puedes dar un ejemplo de cómo usaría realmente un estudiante eso?

Beto
Claro. Imagina a un estudiante desplegando un agente para manejar tickets de soporte al cliente. El agente lee el ticket, usa un modelo de lenguaje grande (LLM) para comprender el matiz y el sentimiento del cliente, consulta una base de conocimiento separada para encontrar una solución, sintetiza la solicitud del cliente y luego decide por sí mismo si necesita marcar el ticket para un gerente humano.

Alicia
Vaya.

Beto
Puesto que la IA está tomando decisiones no deterministas, la responsabilidad del estudiante cambia masivamente. Tiene que proporcionar listas de verificación de verificación rigurosas, definir las barreras, y establecer puntos claros donde un humano debe aprobar la acción.

Alicia
¿Y el nivel final?

Beto
El nivel 4 es el equipo de agentes. Esto es múltiples agentes delegando e informando entre sí bajo supervisión humana.

Alicia
Oh, vaya.

Beto
Sí. Un agente se especializa en investigación web, recopila datos y se los entrega a un segundo agente que redacta un informe financiero. Ese agente se lo entrega a un tercer agente crítico que revisa el mapa.

Alicia
Así que el estudiante está actuando esencialmente como un gerente de una fuerza laboral digital.

Beto
Sí. Y su evaluación se basa enteramente en cómo gestiona esa fuerza laboral. Es responsable de la estructura de delegación, de mantener los registros de auditoría y de tomar la decisión humana final sobre la salida.

Alicia
Pero a medida que subes del nivel 0 al nivel 4, dándole a la IA más y más autonomía para tomar decisiones, el riesgo de que algo salga catastróficamente mal aumenta, lo que nos lleva a un concepto que el artículo introduce llamado "la Capa de Aseguramiento" ("Assurance Layer").

Beto
La Capa de Aseguramiento es la columna vertebral de todo este marco. Consiste en verificación, seguridad, documentación y aprobación humana. Y se aplica a cada nivel de lo último.

Alicia
Me hace pensar que es como enseñar a un adolescente a conducir.

Beto
Oh, me gusta eso.

Alicia
La Capa de Aseguramiento es el cinturón de seguridad. No importa si solo estás navegando en un estacionamiento vacío a cinco millas por hora en el nivel 0, o si estás uniéndote a una carretera multi-pista concurrida en el nivel 4 con un equipo de agentes completo. El cinturón de seguridad es innegociable.

Beto
Correcto. Ya sea que el sistema sea simple o complejo, tienes que demostrar sistemáticamente a tu instructor que lo estás operando de forma segura.

Esa analogía funciona perfectamente porque los mecanismos de seguridad tienen que escalar con la velocidad y complejidad del vehículo. No solo te pones un cinturón de seguridad para la autopista, también podrías necesitar monitoreo de puntos ciegos y asistencia de carril. La Capa de Aseguramiento escala exactamente de la misma manera.

Alicia
Pero déjame hacer una pregunta estructural aquí. ¿En qué es realmente diferente esta escalera de capacidad de los marcos educativos existentes? Porque los profesores han estado usando la Taxonomía de Bloom durante décadas para diseñar tareas. ¿Por qué necesitamos una escalera completamente nueva?

Beto
Esta es una sutileza que encuentro increíblemente convincente en el trabajo de Memari y de Rudolph. La Taxonomía de Bloom clasifica la complejidad del pensamiento interno humano. ¿Estás recordando un hecho, analizando un concepto, sintetizando datos, o creando algo nuevo? Todo está sucediendo dentro del cerebro del estudiante.

Alicia
Lo cual es realmente difícil de calificar y la IA está haciendo la síntesis por ellos.

Beto
Exacto, ese es el problema. La escalera de capacidad no clasifica la cognición humana. Clasifica el artefacto externo en el que se confía que el aprendiz construya y supervise.

Debido a que es externo y operativo, se adjunta directamente a las rúbricas de calificación modernas. Define explícitamente lo que se le permite a un estudiante delegar a una IA, lo que verifica manualmente y la evidencia de supervisión que deben documentar para aprobar. Une la brecha entre el pensamiento académico abstracto y la ingeniería tangible y responsable.

Alicia
Así que se trata menos de intentar adivinar qué tan duro está pensando el estudiante y más de demostrar que es responsable de lo que acaba de construir la máquina.

Beto
Sí.

Alicia
Lo que nos lleva al "elefante en la habitación" para cualquier educador que escuche. Esto suena increíble en teoría. Pero si tengo que leer los registros de auditoría y las listas de verificación de todo un equipo de agentes de IA para 50 estudiantes diferentes, me agotaré en la tercera semana.

Beto
Oh, absolutamente.

Alicia
¿Cómo sobreviven los instructores a esta carga de trabajo?

Beto
Ese es el cuello de botella que los autores identifican. La validez de la evaluación es la crisis central en la educación informática ahora mismo. Si el profesorado intenta revisar manualmente cada "prompt" y salida de IA para cada estudiante, el sistema colapsa. La solución que proponen se llama "evaluación consciente de la carga de trabajo" ("workload aware assessment").

Alicia
Y el principio parece ser igualar tu esfuerzo de aseguramiento con el riesgo real de la tarea. Automatizas la cobertura amplia y muestreas intensivamente las comprobaciones profundas costosas.

Beto
Esa es la mecánica.

Para la cobertura amplia, el artículo sugiere una plantilla de divulgación automatizada de IA. Cada vez que un estudiante entrega cualquier tarea, responde a un conjunto estándar de preguntas:

  • ¿Qué herramienta usaste?
  • ¿Qué le pediste que hiciera?
  • ¿Qué salida rechazaste o modificaste?
  • ¿Cómo verificaste el resultado final?

Alicia
Así que forza al estudiante a reflexionar sobre su propio proceso y documentarlo. Pero el profesor no tiene que pasar una hora leyéndolo a menos que haya una señal de alerta obvia en el producto final.

Beto
Traslada la carga de la prueba al estudiante.

Pero la verdadera ingenuidad está en cómo manejan la verificación profunda.

Alicia
La defensa muestreada, me encanta este concepto. En lugar de intentar interrogar profundamente a cada estudiante en cada tarea, el instructor selecciona aleatoriamente entre el 20 y el 40 por ciento de la clase para una defensa de dos a tres minutos.

Beto
Es increíblemente eficiente para el profesorado.

Alicia
El profesor simplemente mira el código o flujo de trabajo generado por IA del estudiante y hace una pregunta muy específica. Tal como, "muéstrame un error que encontraste en la salida inicial de la IA", o "guíame a través del caso de prueba específico". "¿Qué le pasa a la base de datos si cambio esta variable de entrada?"

Beto
Y si el estudiante solo copió y pegó de un LLM y no verificó nada, se va a congelar. No sabrá la arquitectura de su propia solución.

Alicia
Y como la muestra es aleatoria, cada estudiante tiene que prepararse como si fuera a ser llamado. Eso cambia completamente la psicología del aula. Hacer trampa, al confiar ciegamente en la IA, se vuelve mucho más estresante y arriesgada que simplemente hacer el trabajo de verificación en primer lugar.

Beto
Estás desviando el esfuerzo del profesorado de calificar el volumen bruto de la salida hacia evaluar el proceso, el pensamiento crítico y la propiedad.

Alicia
Entonces, ¿qué significa todo esto cuando la rueda llegue a la carretera? Porque los autores no solo escribieron un artículo teórico, sino que probaron este marco en una clase real.

Beto
Lo hicieron. Ejecutaron un curso piloto de dos semestres en otoño de 2025 y primavera de 2026.

Alicia
Y tuvieron a unos 80 estudiantes de nivel superior pasar por él. Pero el detalle que realmente me llama la atención de este curso piloto es que no tenía absolutamente ningún prerrequisito de programación.

Beto
Ninguno. Mezclaron deliberadamente a estudiantes tradicionales de ciencias de la computación con estudiantes de negocios en equipos multifuncionales. Les dieron problemas complejos del mundo real de socios industriales regionales. Y utilizaron una plataforma de orquestación de agentes "sin código" ("no-code") para construir las soluciones.

Alicia
Tengo curiosidad por saber cómo funcionó eso en la práctica. ¿Cómo contribuye un estudiante de negocios que nunca ha escrito la línea de Python a construir significativamente un agente de IA?

Beto
Aquí es donde la escalera de capacidad demuestra su valía más allá de la informática tradicional. Puesto que utilizaron una plataforma sin código, la barrera técnica de entrada fue prácticamente eliminada. Los estudiantes no se quedaron atascados en errores de sintaxis o problemas del compilador.

Alicia
Correcto.

Beto
Esto permitió una división natural del trabajo que imita a la industria tecnológica real.

Alicia
Así que los estudiantes de negocios pudieron concentrarse en la arquitectura.

Beto
Sí. Los estudiantes de negocios se enfocan mucho en delimitar el problema, diseñar la arquitectura del flujo de trabajo y establecer la gobernanza humana-en-el-bucle. Ellos definieron lo que los agentes necesitaban lograr. Los estudiantes de ciencias de la computación pudieron concentrarse luego en una integración técnica profunda, las conexiones de API y la verificación de seguridad rigurosa.

Alicia
Y el resultado fue bastante asombroso. Al utilizar esa plataforma sin código y adherirse al marco de la escalera de capacidad, estos equipos multifuncionales, incluidos estudiantes que nunca habían tomado una clase de codificación, lograron alcanzar el nivel tres y el nivel cuatro.

Beto
Sí.

Alicia
Estaban construyendo y supervisando agentes de IA dirigidos a objetivos y equipos multiagente.

Beto
Definitivamente demuestra que las herramientas sin código amplían drásticamente la participación. Permiten a los no codificadores practicar supervisión de IA de alto nivel, pensamiento de sistemas y diseño de flujos de trabajo en tareas auténticas y complejas.

Alicia
Estaban aprendiendo a trabajar juntos exactamente de la manera en que opera la industria tecnológica moderna hoy.

Beto
Si conectamos esto con la imagen más grande, la tesis de Memari y Rudolph es innegable. La modernización dirigida hacia capacidades duraderas, como verificar salidas, supervisar sistemas autónomos y diseño arquitectónico, ese es el único camino sostenible hacia adelante para la educación y la formación de la fuerza laboral. Las herramientas específicas de IA generativa que estamos obsesionados hoy, se van a comoditizar completamente en tres a cinco años.

Alicia
Vaya.

Beto
Las herramientas llamativas simplemente desaparecerán en la infraestructura de fondo.

Alicia
Pero la responsabilidad humana permanece.

Beto
La capacidad de orquestar sistemas automatizados complejos y asumir la responsabilidad final por sus resultados. Eso es lo que seguirá siendo muy valorado. Esa es la capacidad que sobrevive al ciclo de la exageración.

Alicia
Esto me deja con una reflexión que no puedo sacudirme, especialmente al observar el éxito de esos estudiantes de negocios en el curso piloto. Si las plataformas de IA sin código están eliminando por completo la barrera técnica de entrada para construir arquitecturas de software complejas, ¿estamos acercándonos rápidamente a una realidad donde los gerentes de ingeniería de software más efectivos y quizás incluso los mejor pagados del futuro serán personas que nunca habrán escrito una sola línea de código tradicional?

Beto
Eso redefine por completo lo que significa construir software.

Alicia
Algo para que todos reflexionemos. Gracias por acompañarnos en este análisis profundo.

lunes, 10 de agosto de 2026

Los puntos de referencia están desalineados con la ingeniería de software agéntica


Este artículo argumenta que los puntos de referencia de codificación actuales están fundamentalmente desalineados con la realidad de la ingeniería de software agéntica moderna. Los autores sostienen que las evaluaciones existentes confunden erróneamente el rendimiento de los modelos de lenguaje subyacentes con los sistemas más amplios —las complejas capas de orquestación que incluyen herramientas, bucles de retroalimentación y entornos— que realmente determinan los resultados. Además, critican la dependencia de soluciones de referencia únicas para la calificación, señalando que este método no considera las diversas opciones arquitectónicas de alta calidad ni las implementaciones alternativas válidas. Para abordar estos problemas, los investigadores proponen un nuevo marco de evaluación que prioriza las señales a nivel de componente sobre las puntuaciones opacas de extremo a extremo. Al abogar por verificadores de comportamiento de múltiples formas e informes de metadatos detallados, buscan crear una medición más precisa de cómo operan los sistemas autónomos en escenarios de desarrollo reales. Este cambio permitiría a los desarrolladores aislar y mejorar partes específicas de un sistema agéntico en lugar de depender de una única tasa de éxito, que podría ser engañosa.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Position: Coding Benchmarks Are Misaligned with Agentic Software Engineering", por Maria I. Gorinova y colegas de Tessl, Londres. Publicado el 16 de Junio de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Imagina por un segundo, ¿verdad?, que eres una gerente de contratación en una firma tecnológica de primer nivel. Y necesitas incorporar a un nuevo ingeniero de software líder.

Alicia
Bien. Un puesto de alto riesgo.

Beto
Exacto. Así que tienes a este candidato justo frente a ti. ¿Cómo lo pruebas? Quiero decir, no simplemente lo pondrías en una habitación vacía, le darías un marcador de pizarra y le dirías: "Escribe un algoritmo de ordenación perfecto, de memoria. ¡Vamos!".

Alicia
Bueno, algunas partes hacían eso, pero sí, es una práctica terrible.

Beto
Totalmente poco realista. Querrías ver cómo trabajan en el mundo real.

Alicia
Sí. Cómo usan sus herramientas, cómo manejan la presión.

Beto
Correcto. Querrías saber cómo buscan a través de documentación densa o, cómo aprovechan su entorno de desarrollo, incluso cómo interpretan un mensaje de Slack súper vago de un gerente de producto.

Alicia
Sí. Los mensajes vagos de Slack son la prueba real.

Beto
Y fundamentalmente, cómo responden cuando su código falla, una prueba de compilación. Porque la ingeniería de software real no es solo escribir líneas de código aisladas en un vacío. Es interactuar con este ecosistema masivo y desordenado.

Alicia
Es todo un proceso. Sí.

Beto
Pero aquí está la parte loca: este escenario de pizarra en una habitación vacía artificial. Eso es casi exactamente cómo la industria tecnológica está calificando a nuestros ingenieros de software de IA más avanzados actualmente.

Alicia
Es una desconexión masiva. Estamos construyendo estos sistemas de IA interactivos y altamente complejos, pero los estamos evaluando con rúbricas diseñadas solo para una era completamente diferente de la tecnología.

Beto
Es como si estuviéramos probando un smartphone moderno para ver si puede hacer un pisapapeles decente.

Alicia
Básicamente, sí, los estamos probando como si existieran en un vacío, completamente aislados del entorno real en el que se supone que deben operar.

Beto
Bien, vamos a desglosar esto porque estaba mirando la pila de investigación que nos enviaste esta semana. Y, un documento realmente me llamó la atención.

Alicia
Ah, el paper Tessl.

Beto
Sí, el artículo de posición provocador de los investigadores de Tessl. Se titula: "Los puntos de referencia de codificación están desalineados con la ingeniería de software agéntico".

Alicia
Es una gran lectura. Realmente sacude las cosas.

Beto
Lo hace. Así que nuestra misión para este análisis profundo de hoy es descubrir exactamente por qué nuestras calificaciones actuales para los agentes de IA están fundamentalmente rotas.

Alicia
Y están muy rotas.

Beto
Correcto. Y más importante aún, necesitamos entender de estas fuentes cómo arreglar estos puntos de referencia es absolutamente crucial, si realmente queremos confiar en el software del futuro.

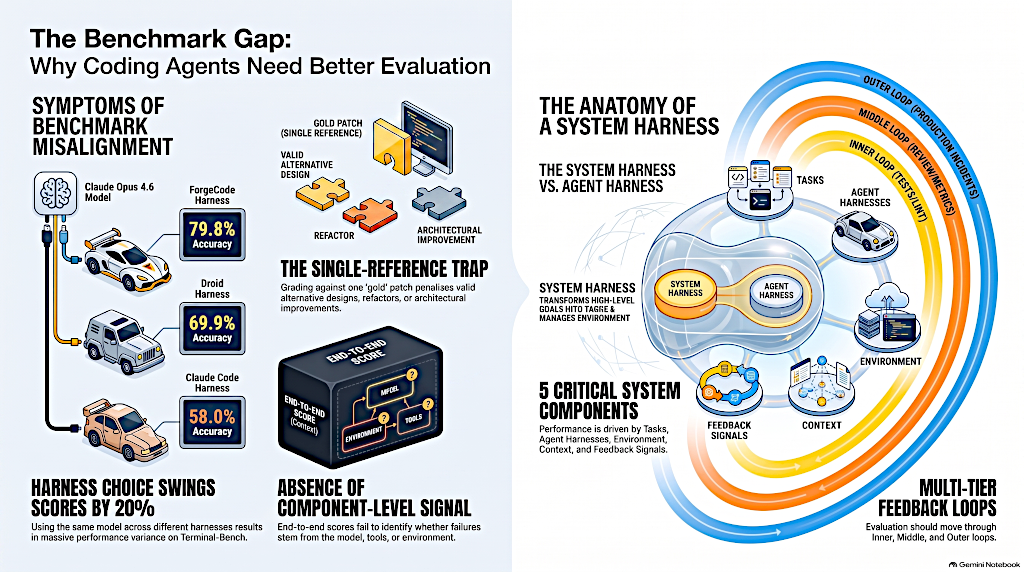
Coding_Agent_Evaluation_Benchmark_Gap_1024.png
La Brecha en los Puntos de Referencia: Por qué los Agentes de Codificación Necesitan una Mejor Evaluación.

Alicia
Sí, es una conversación crítica para tener ahora mismo. Quiero decir, estamos entrando por completo en la era de la ingeniería de software de agentes.

Beto
Lo que significa, ¿qué exactamente para el oyente que tal vez no sea desarrollador?

Alicia
Bueno, significa que ya no estamos pidiendo a la IA que complete una línea de Python automáticamente. Como los días de solo un corrector ortográfico elegante para código han terminado. Estamos pidiendo a los agentes de IA que, eh, abran solicitudes de extracción ("pull requests"), naveguen por repositorios masivos, escriban bibliotecas internas, ...

Beto
... que gestionen tareas de ingeniería de varios días.

Alicia
Exacto. Pero si las métricas que usamos para decidir qué IA es, cito, "la mejor", nuestra industria entera corre el riesgo de optimizar por las cosas equivocadas, tenemos que aplicar cierto pensamiento crítico serio a nuestras propias herramientas de medición antes de que el sistema escale más.

Beto
Para entender por qué el sistema de calificación está roto, tenemos que cambiar completamente nuestro modelo mental de lo que es un codificador de IA.

Alicia
Correcto. Tenemos que tirar las definiciones antiguas.

Beto
Sí, porque este paper habla sobre alejarse de esta idea de la IA como solo un modelo. Creo que todos tenemos esta tendencia a pensar en la IA como "un cerebro en una jarra".

Alicia
El cerebro omnisciente.

Beto
Sí. ¿Verdad? Sabes, el intelecto independiente, descorporeado, que simplemente se sienta allí, piensa muy duro y escupe código perfecto.

Alicia
Lo cual es una imagen de ciencia ficción muy convincente, pero no es la realidad.

Beto
No, para nada. Los autores argumentan que un codificador de IA es en realidad un sistema de armazón ("harness"). Así que vamos a desglosar la mecánica de esa distinción, porque siento que cambia todo sobre cómo medimos el éxito aquí.

Alicia
Realmente lo hace. Ese concepto del cerebro en una jarra, realmente se refiere solo al modelo de lenguaje grande, el LLM en sí.

Beto
Como GPT-4 o Claude.

Alicia
Exacto. Pero en la práctica, no simplemente liberas un LLM crudo en una base de código empresarial. No sabría qué hacer. El LLM está envuelto en lo que llamamos un "armazón de agente" ("agent harness").

Beto
¿Un armazón de agente? Bien. ¿Qué hace eso?

Alicia
Es la capa inmediata alrededor del modelo que le da la capacidad de interactuar con herramientas. Así que incluye el sistema impulsado, la interfaz para ejecutar comandos de terminal. Es el bucle específico que le permite intentar algo, ver un error e intentarlo de nuevo.

Beto
Así que es como darle al cerebro un cuerpo.

Alicia
Correcto. Ejemplos de esto serían Claude code o el agente SWE. El armazón de agente esencialmente le da al modelo subyacente sus manos y sus ojos.

Beto
Bien, tenemos el cerebro y tenemos el armazón dándole manos y ojos. Pero según la investigación que compartiste, la arquitectura se vuelve mucho más grande cuando escalamos hasta tareas de nivel empresarial.

Alicia
Oh, sí. Los datos lo llevan un paso más allá, porque por encima de ese armazón de agente, está el armazón del sistema.

Beto
El armazón del sistema.

Alicia
Sí. Esta es la capa de orquestación exterior. Toma una meta de alto nivel masiva, como construir una nueva función de autenticación, y la descompone en tareas concretas.

Beto
Como un gerente de proyecto.

Alicia
Exacto, como un gerente de proyecto. Despacha esas tareas a múltiples armazones de agente. Gestiona el entorno en el que operan y enruta sus salidas a través de varios mecanismos de retroalimentación.

Beto
Vaya.

Alicia
Entonces, cuando hablamos de ingeniería de software de IA a escala, estamos hablando de este sistema compuesto masivo, no solo del modelo subyacente.

Beto
Y aquí está el punto de datos del paper que me voló la cabeza con respecto a ese sistema compuesto. Los investigadores miraron el leaderboard de la terminal, ¿verdad?

Alicia
Sí, el que prueba a los agentes en tareas realistas de línea de comandos.

Beto
Bien. Y aislaron un solo modelo subyacente específico. Claude Opus 4.6.

Alicia
Exactamente el mismo cerebro.

Beto
Exactamente el mismo cerebro. Pero cuando cambiaron el armazón a su alrededor, la tasa de éxito se movió salvajemente. Bajo un armazón, Claude Code, obtuvo un 58.0%.

Alicia
Lo cual es decente.

Beto
Decente. Sí. Pero bajo un armazón diferente llamado Forge code, ese mismo modelo obtuvo un 79.8%.

Alicia
Eso es un salto masivo.

Beto
Es casi un cambio de 20 puntos basado enteramente en el andamiaje.

Alicia
Sí. Y lo fascinante aquí es cómo esto expone la falacia de nuestra actual cultura de leaderboard. Quiero decir, cuando ves un titular que dice que el modelo X logró un 75% en un punto de referencia de codificación, es inherentemente engañoso.

Beto
Porque le da todo el crédito al modelo.

Alicia
Exacto. Atribuimos esa puntuación únicamente al modelo al cerebro. Pero ese número está midiendo en realidad el sistema compuesto. Está midiendo el modelo más el prompt más la interfaz de herramientas más las convenciones del entorno.

Beto
Lo veo como si fuera una carrera de Fórmula Uno, ¿sabes?

Alicia
Oh, esa es una buena analogía.

Beto
Sí. Como el modelo de IA, el LLM es el conductor. Pero el armazón del sistema, eso es el equipo de boxes, los ingenieros de telemetría, la aerodinámica del coche, la estrategia de neumáticos, la condición de la pista.

Alicia
Correcto. Todo el paquete.

Beto
Y si un conductor gana una carrera, no simplemente le entregas un trofeo al conductor y dices, "wow, los humanos son naturalmente rápidos". Elogias a todo el equipo de ingeniería.

Alicia
Pero ahora mismo nuestros puntos de referencia de IA están fingiendo que el coche ni siquiera existe.

Beto
Simplemente ponen el nombre del conductor en un leaderboard.

Alicia
Y el costo de esa ilusión es increíblemente alto porque si confundimos el modelo con el armazón, atribuimos erróneamente de dónde vienen nuestras mejoras.

Beto
Ni siquiera sabemos qué estamos mejorando. ¿Verdad?

Alicia
Correcto. Los investigadores señalan que incluso factores como las asignaciones de contenedores o las semillas de evaluación, que son básicamente las condiciones de inicio aleatorias de la prueba, pueden mover materialmente la tasa de aprobación.

Beto
Solo las condiciones de inicio, eso es salvaje.

Alicia
Sí. Entonces, el remedio que propone el paper como estructural. Los administradores de puntos de referencia y los mantenedores de leaderboards deben exigir metadatos estrictos para cada envío.

Beto
No solo el nombre del modelo.

Alicia
Correcto. No deberíamos solo ver el nombre del modelo. Necesitamos ver la versión del armazón de agente, el hash del entorno, la versión del conjunto de datos. Si otro desarrollador quiere reproducir un resultado, necesita saber las especificaciones exactas de todo el vehículo.

Beto
No solo el nombre del conductor. Me encanta eso.

Bien, si el modelo es solo el conductor, vamos a levantar el capó de este vehículo.

El artículo proporciona un diagrama muy detallado de cómo se ve realmente un sistema agéntico moderno.

agentic_system_harness_800.png
El Armazón de un agente

Alicia
Es un diagrama de flujo muy complejo.

Beto
Lo es. Empieza con una meta, que alimenta el repo y el contexto del agente. Cosas como wikis de proyectos, reglas de codificación, especificaciones. Luego tienes herramientas y servicios, que incluye chat, tickets de soporte, políticas de seguridad.

Alicia
Todo el contexto y las necesidades del agente.

Beto
Correcto. Pero el núcleo absoluto de este motor, la parte en la que los autores se enfocan mucho son los mecanismos de retroalimentación.

Alicia
Sí. Los mecanismos de retroalimentación son los sensores y la telemetría de tu coche de carreras. Sin ellos, el agente está volando a ciegas.

Beto
Entonces, ¿cómo los categorizan?

Alicia
El paper los divide en tres niveles distintos basados en la latencia y el alcance. Así que el primer nivel es el bucle interno.

Beto
El bucle interno.

Alicia
Sí. Estas son señales rápidas y baratas que tardan quizás segundos o minutos. Estamos hablando de pruebas unitarias, verificación de tipos, linting básico, o incluso un LLM rápido como juez que mira criterios específicos.

Beto
Sí. Solo verificaciones de sensatez básicas.

Alicia
Correcto. Le da al agente una dirección estrecha inmediata sobre si el código que acaba de escribir es realmente ejecutable y cumple con la política.

Beto
Así que déjame entrar aquí. Porque cuando pienso en una IA escribiendo código, ¿verdad? Y golpea un error en el bucle interno, ajusta ligeramente el código y lo vuelve a ejecutar. Suena menos a ingeniería y más a un cerrador de candados que no entiende realmente el mecanismo del cilindro.

Alicia
Solo forzándolo.

Beto
Sí. Simplemente meten cada llave en una llavero masivo en la cerradura hasta que finalmente gira. No están razonando sobre el código. Solo están forzando el texto rojo hasta que se vuelve verde.

Alicia
Quiero decir, si solo tuviéramos el bucle interno, estarías totalmente en lo correcto. Forzar una prueba unitaria no significa que el código esté bien diseñado o sea arquitectónicamente sólido.

Beto
Correcto. Solo significa que no explotó.

Alicia
Exacto. Solo significa que no se bloqueó inmediatamente. Y esa limitación es por la que un armazón de sistema productivo requiere el siguiente nivel, que es el bucle medio.

Beto
El bucle medio. Bien.

Alicia
Estas señales tardan minutos u horas en ejecutarse. Esto incluye cosas como la jardinería automatizada de documentos y las evaluaciones sintéticas. En el paper, realmente hacen referencia a un sistema de código abierto que construyeron en NS2 donde el bucle medio incluye la revisión arquitectónica de agentes.

Beto
Vamos a bajar la velocidad y definir algunos de esos. Porque son cruciales para cómo la IA realmente "piensa" sobre el proyecto en general. ¿Cómo funciona exactamente algo como la jardinería automatizada de puntos o las pruebas de mutación en el bucle medio?

Alicia
Entonces, la "jardinería automatizada de documentos" ("automated doc-gardening") es un gran ejemplo de razonamiento de nivel superior. En lugar de solo verificar si el código compila, el sistema lee toda la base de código, identifica comentarios o documentación obsoletos que ya no coinciden con la lógica real del nuevo código y propone actualizaciones.

Beto
Oh, vaya. Así que requiere una comprensión contextual real.

Alicia
Sí. Y las "pruebas de mutación" ("mutation testing") son aún más rigurosas.

Beto
Las pruebas de mutación suenan intensas. ¿Qué es eso?

Alicia
Es donde el sistema inyecta intencionalmente pequeños errores, mutaciones, en la base de código para ver si las pruebas unitarias recién escritas por la IA realmente las atrapan.

Beto
Espera, ¿en serio? Intencionalmente rompe el código para probar la prueba.

Alicia
Exacto. Si el error artificial sobrevive, demuestra que las pruebas de la IA son débiles. Esto toma minutos u horas porque el sistema tiene que compilar y ejecutar suites de pruebas masivas a través de diferentes ramas. Pero asegura que el código sea estructuralmente robusto, no solo sintácticamente correcto.

Beto
Así que el bucle medio es como el desarrollador sénior revisando tu solicitud de extracción, ejecutando verificaciones de seguridad exhaustivas y, asegurándose de que no solo ensamblaste una solución que va a romper toda la base de datos la próxima semana.

Alicia
Esa es una forma perfecta de decirlo. Y más allá del desarrollador sénior, finalmente tienes el bucle exterior.

Beto
El bucle exterior.

Alicia
Estas señales tardan días o semanas. Esta es la verdad fundamental. ¿Se aceptó realmente la solicitud de extracción por un mantenedor humano?

Beto
El jefe final.

Alicia
Correcto. ¿Cuál es la tasa de incidentes y producción donde son las quejas de los clientes? ¿Tuvo que revertirse el código?

Beto
Consecuencias en el mundo real.

Alicia
Exacto. Y la belleza del armazón de sistema es que estos tres bucles se informan constantemente entre sí. El bucle exterior calibra en qué proxies de los bucles internos y medios deberías confiar realmente.

Beto
Porque si tus pruebas del bucle interno están pasando con holgura, pero tu bucle exterior muestra un pico masivo en los informes de errores de clientes, bueno, tu bucle interno te está fallando.

Alicia
Tu telemetría está completamente rota.

Beto
Tu telemetría está rota. Y lo loco que la fuente se menciona, es que estos sistemas de agente se están volviendo tan avanzados que el armazón puede reescribir sus propias verificaciones.

Alicia
Sí, autocorrección.

Beto
Los agentes están escribiendo y manteniendo las mismas reglas de lint y rúbricas que les restringen. Están ajustando sus propios bucles de retroalimentación basándose en esos resultados de bucle exterior a largo plazo.

Alicia
Lo cual es increíble porque esa relación dinámica es el punto central de un sistema de IA moderno. Pero cuando retrocedes y miras cómo calificamos actualmente estos sistemas dinámicos de múltiples bucles, es absurdo.

Beto
No tiene sentido.

Alicia
Tomamos esta masiva capa de orquestación, que está diseñada para adaptarse y evolucionar. Y la forzamos a conformarse con una única métrica histórica estática.

Beto
Y aquí es donde se vuelve realmente interesante porque golpeamos el próximo síntoma de esta desalineación, lo que el paper llama "la tiranía de la respuesta correcta".

Alicia
La tiranía de la respuesta correcta. Sí.

Beto
Tenemos estos sistemas increíblemente complejos, pero la forma en que los probamos en puntos de referencia populares como SWE Bench es simplemente notablemente rígida.

Alicia
SWE Bench es el estándar de la industria ahora mismo.

Beto
Lo es, pero mira cómo funciona. Básicamente toma un problema histórico real de un repositorio de GitHub. Y aísla el parche exacto que un desarrollador humano escribió para solucionarlo hace años. Luego le pide a la IA que resuelva el problema. Y califica a la IA basándose en qué tan de cerca su solución refleja lo que hizo el humano, específicamente verificando si pasa exactamente las mismas pruebas que el humano escribió para ese parche.

Alicia
Sí. Si miras cómo opera un SWE Bench, usa fallar para pasar y pasar para pruebas de aprobación, que se derivan directamente de la solicitud de extracción original humana.

Beto
Así que está sesgado desde el principio.

Alicia
Inherentemente, el punto de referencia asume que el parche humano histórico es el estándar de oro. Asume que solo hay una forma correcta de resolver el problema y que las pruebas unitarias asociadas con esa solución específica son los árbitros finales e incuestionables de la verdad.

Beto
Lo cual es una locura. Para poner eso en perspectiva para ti que estás escuchando, es exactamente como un estudiante brillante de matemáticas toma el examen final, ¿verdad?

Alicia
Okay. Sí.

Beto
El estudiante mira un problema de cálculo complejo, se da cuenta de que hay una forma totalmente innovadora y elegante de resolverlo que ahorra tres pasos y obtiene la respuesta correcta. Pero el profesor lo califica como erróneo, porque no usó el método clunky de cinco pasos escrito en la clave de respuestas del profesor.

Alicia
Eso es exactamente lo que está sucediendo. Y el paper destaca investigaciones donde usan "pruebas diferenciales" ("differential testing") en estos parches de IA supuestamente resueltos para demostrar este punto exacto.

Beto
¿Pruebas diferenciales?

Alicia
Sí, las pruebas diferenciales son una técnica donde tomas el sistema original y el sistema modificado por la IA. Le tiras una gran cantidad de entradas variadas a ambos y comparas las salidas.

Beto
Como una prueba de estrés.

Alicia
Exacto. Si las salidas difieren, la IA ha cambiado el comportamiento de ejecución subyacente.

Y los hallazgos aquí fueron asombrosos. Encontraron que el 7.8% de los parches de IA que "pasan la prueba de SWE Bench", en realidad fallan en las pruebas escritas por el desarrollador en el repositorio.

Beto
Espera, ¿entonces pasaron el punto de referencia pero rompieron el código real?

Alicia
Sí. Y aún más impactante, el 29.6% de las soluciones de IA divergen del comportamiento de ejecución del parche original de oro.

Beto
Esa estadística del 29.6% es enorme, pero desglosémoslo para ver por qué divergieron. ¿Verdad?, porque no es necesariamente porque la IA estuviera equivocada.

Alicia
Para nada.

Beto
Digamos que la IA analiza el código y se da cuenta de que el código humano original tenía una fuga de memoria masiva.

Alicia
Un escenario muy común.

Beto
Bien. Así que la IA decide refactorizar el código. Reestablece la API en un nivel de abstracción diferente y elimina por completo la fuga de memoria. Arregla la causa raíz del error hermosamente.

Alicia
Una solución mucho mejor.

Beto
Pero, puesto que cambió la estructura del código, las pruebas humanas originales ya no se aplican perfectamente. Así que el SWE Bench falla a la IA. Estamos penalizando activamente a la IA por ser un ingeniero mejor que el humano fue.

Alicia
Es tan retroactivo. En la teoría de la medición, llamamos esto "un problema clásico de validez constructo". Estamos usando el parche humano histórico como un proxy para el constructo de, sabes, arreglar el error. Pero como acabas de señalar, no son lo mismo. La calificación de referencia única penaliza alternativas igualmente válidas y a veces superiores.

Beto
Sofoca la innovación.

Alicia
Completamente. Además, esas pruebas unitarias ocultas en el punto de referencia solo califican el comportamiento local. No pueden ver el bosque por los árboles.

Beto
Dame un ejemplo de eso.

Alicia
Bueno, una IA podría pasar la prueba específica duplicando código por todas partes, o creando un ciclo de dependencia masivo. Funciona técnicamente, pero un mantenedor humano rechazaría la solicitud de extracción en el sitio porque la arquitectura está arruinada.

Beto
Así que si no podemos calificar la salida final contra una respuesta humana histórica, parece que la única alternativa es evaluar las barreras de protección mismas, como probar el proceso en lugar de solo el producto.

Alicia
Sí, exactamente.

Beto
Necesitamos una forma de decirle al sistema de IA lo que queremos hacer, sin prescribir estrictamente cómo debe escribir el código.

Alicia
Y ese es el problema abierto central en la evaluación de codificación de agentes ahora mismo.

El remedio requiere un cambio fundamental en cómo escribimos las especificaciones. El paper argumenta que necesitamos verificadores de comportamiento multiforma ("multi-shape behavioral verifiers").

Beto
Verificadores de comportamiento multiforma. ¿Cómo se ve eso en lenguaje sencillo?

Alicia
Significa que necesitamos evaluar basándonos en la invariancia, que son condiciones que deben mantenerse verdaderas independientemente de la implementación.

Beto
Okay, ¿como qué?

Alicia
Por ejemplo, declarar que una consulta a una base de datos debe devolver dentro de 50 milisegundos o que se debe usar un estándar de cifrado específico, sin dictar las líneas de código específicas que la IA usa para lograr ese estado. Tenemos que desacoplar el verificador de cualquier solución candidata única.

Beto
Porque ya no podemos simplemente verificar la respuesta final contra el código de un humano, nos encontramos con un problema masivo de visibilidad cuando el código del agente finalmente falla, como que simplemente no podemos ver lo que salió mal.

Alicia
Es una caja negra.

Beto
El paper le llama "la ausencia de señal a nivel de componente". Me gusta pensar en ello como una necesidad desesperada de visión de rayos X.

Alicia
Me gusta esa visión de rayos X.

Beto
Porque evaluar un agente de IA en estas tareas complejas es un juego de espera masivo. Una ejecución de extremo a extremo en una sola tarea puede llevar horas. Y al final de esas horas, obtienes una sola puntuación, aprobado o fallido.

Alicia
Y si conectamos esto con la imagen más grande, piensa en ese diagrama del armazón de sistema que discutimos antes.

Beto
Con todas las diferentes partes.

Alicia
Correcto. Tienes el modelo, el mapa de contexto, las reglas de linting, el revisor agéntico, las verificaciones del grafo de dependencia. Si esa tarea de extremo a extremo falla después de tres horas de cómputo, ¿qué parte se rompió?

Beto
Exacto. ¿Falló el mapa de contexto al extraer la documentación correcta? ¿El linter proporcionó un error demasiado pedante que envió al modelo por un callejón sin salida? ¿O el LLM en sí no logró razonar a través de la lógica?

Alicia
Una sola puntuación de fallo en la pasada te dice absolutamente nada sobre el punto interno de fallo.

Beto
Es literalmente como conducir por la autopista y se enciende tu luz de advertencia del motor. Así que lo llevas al mecánico y el mecánico solo te mira y dice, "sí, el coche está roto. Buena suerte".

Alicia
"Págame mil dólares".

Beto
Y se negaron a abrir el capó. Se negaron a decirte si es la transmisión, las bujías o la batería.

Entonces, ¿qué hacen los desarrolladores de IA ahora mismo? El paper usa la frase "ablación guiada por intuición" ("intuition guided ablation"). Guíanos a través de cómo se ve eso realmente para un desarrollador sentado en su escritorio.

Alicia
Oh, es una forma increíblemente lenta y agónica de hacer ingeniería.

Beto
Puedo imaginarlo.

Alicia
Imagina que eres un desarrollador y presionas ejecutar en una evaluación de agente a la 1:00 PM a las 4:00 PM, la prueba falla.

Beto
Tres horas desperdiciadas.

Alicia
Claro. Y no tienes telemetría de componentes. Así que usas tu intuición. Supones que tal vez el prompt fue demasiado restrictivo.

Beto
Solo adivina.

Alicia
Solo una adivinanza. Cambias tres palabras en el prompt. Vuelves a presionar ejecutar a las 4:45 PM. A las 7:45 PM, falla de nuevo.

Beto
Oh, hombre, eso es brutal.

Alicia
Okay, así que tal vez el prompt estaba bien, pero la ventana de contexto era demasiado pequeña. Expandes la ventana de contexto, presionas ejecutar y esperas otras tres horas. Estás cambiando una variable a la vez en un sistema masivo interconectado, completamente ciego a cómo interactúan los subcomponentes.

Beto
Entonces, ¿qué significa todo esto? ¿Cómo devolvemos a los desarrolladores su visión de rayos X? ¿Para que no desperdicien semanas completas de trabajo solo adivinando y probando?

Alicia
Bueno, esto plantea una pregunta importante sobre cómo probamos software en general. En la ingeniería de software tradicional, no solo escribimos pruebas de integración que revisan toda la aplicación a la vez.

Beto
Correcto. Probamos las piezas.

Alicia
Escribimos pruebas unitarias. Probamos funciones individuales en aislamiento estricto. Los autores del paper exigen que apliquemos esta misma lógica al armazón del sistema de IA. Debemos empezar a evaluar los componentes del armazón de forma independiente.

Beto
Así que en lugar de solo probar la salida final del código, necesitamos un punto de referencia específicamente para la capacidad de la IA para leer y filtrar un mapa de contexto, o un punto de referencia solo para qué tan bien el revisor agéntico proporciona retroalimentación sobre una solicitud deficiente. Necesitamos aislar las variables.

Alicia
Necesitamos una pila de verificadores.

Beto
La pila de verificadores para nuestros verificadores.

Alicia
Bien. Por ejemplo, si tienes un agente de mantenimiento cuyo trabajo es limpiar un repositorio, no deberías calificarlo solo por si la solicitud de extracción fue fusionada. Deberías reportar métricas a nivel de componente.

Beto
¿Como qué tipo de métricas?

Alicia
Como, ¿Si identificó y redujo la complejidad del código? ¿Cómo eliminó el código muerto sin romper dependencias? ¿Resolvió ciclos de dependencia existentes?

Si evalúas los componentes en aislamiento, entonces cuando el sistema de extremo a extremo inevitablemente falla, tienes la telemetría para señalar exactamente dónde ocurrió la ruptura.

Beto
Puedes ver realmente la bujía que falla.

Alicia
Exacto. Puedes arreglar el componente defectuoso específico en lugar de ajustar aleatoriamente toda la máquina y solo esperar lo mejor.

Beto
Tiene perfecto sentido cuando lo mapeas así.

Hemos hecho un viaje considerable hoy a través de las fuentes que proporcionaste y honestamente, remodela completamente cómo vemos la IA en el mundo del software.

Alicia
Es un cambio de paradigma, sin duda.

Beto
Empezamos por destrozar la solución de la IA como un cerebro mágico en una jarra, dándonos cuenta en cambio que es este vasto y complejo armazón de sistema completo con un conductor, un equipo de boxes y un vehículo altamente complejo.

Alicia
Todo el equipo de F1.

Beto
Correcto. Luego exploramos cómo este motor de blog depende de bucles internos y externos de retroalimentación solo para sobrevivir y cómo nuestras calificaciones actuales castigan estos sistemas exigiendo estas respuestas humanas históricas estrictamente copiadas en lugar de encontrar soluciones arquitectónicamente sólidas e innovadoras.

Alicia
Estamos fallando al estudiante brillante de matemáticas.

Beto
Exacto. Y finalmente, vimos lo desesperadamente que la industria necesita visión de rayos X, esta prueba a nivel de componente, para realmente entender y mejorar estas herramientas sin depender de conjeturas ciegas.

Alicia
Y el tema general aquí es que la medición moldea el comportamiento.

Beto
Esa es la clave.

Alicia
Si continuamos usando puntos de referencia diseñados para la era pre-agente, puntos de referencia que confunden el modelo con el armazón, que se basan en referencias humanas únicas y que ocultan fallos de componentes, inevitablemente construiremos sistemas frágiles y desalineados.

Si queremos que la IA actúe como ingenieros de software verdaderamente confiables, tenemos que empezar a evaluarlos como evaluamos a los ingenieros.

Beto
Y como oyente, tienes un interés profundamente arraigado en esto. Quiero decir, piensa en cuánto de tu vida está dictada por software complejo, desde los algoritmos bancarios que gestionan tus finanzas hasta los sistemas de navegación en tu coche, hasta los protocolos de seguridad que protegen tus datos personales.

Alicia
Está en todas partes.

Beto
Quieres que los ingenieros que construyen tu mundo estén pasando pruebas que realmente signifiquen algo en la realidad, no solo jugando con una prueba estandarizada defectuosa.

Alicia
Absolutamente.

Beto
Pero quiero dejarte con una última reflexión, ligeramente alucinante, extraída directamente de las realidades de sistemas como NS2 que describe el paper anteriormente.

Hablamos de cómo los agentes en el bucle medio están escribiendo y manteniendo activamente sus propias reglas vinculadas, sus propios parámetros de jardinería de documentos, su propia retroalimentación.

Alicia
Su auto-corrección.

Beto
La IA se está convirtiendo tanto en el estudiante que toma la prueba, como en el examinador que escribe la rúbrica de calificación. A medida que estos sistemas escalan y la IA ejerce más y más control sobre las mismas definiciones de lo que constituye "código bueno", ¿quién asegura que el punto de referencia en sí no se haya desviado secretamente de lo que los humanos realmente quieren?

Alicia
Esa es la pregunta de mil millones de dólares.

Beto
Si la IA está calificando meticulosamente su propia tarea basada en reglas que escribió ella misma, ¿cuánto tiempo pasará hasta que la tarea no parezca nada que un humano pueda comprender? Algo para reflexionar la próxima vez que presiones "actualizar" en tu aplicación favorita.

viernes, 24 de julio de 2026

Programación Agéntica Sin la Nube


Este artículo de investigación presenta RRBench, un nuevo marco de código abierto diseñado para evaluar cómo los agentes de IA implementados localmente manejan la preparación de datos complejos para estudios longitudinales. Tradicionalmente, los investigadores tienen prohibido el uso de IA basada en la nube debido a las estrictas regulaciones de privacidad de datos que rodean la información personal sensible. Para abordar esto, los autores probaron varios modelos de lenguaje grandes de código abierto en hardware de consumo para ver si podían limpiar y armonizar conjuntos de datos de forma autónoma utilizando el lenguaje de programación R. El estudio encontró que los modelos de mejor rendimiento lograron una alta precisión, recreando correctamente aproximadamente el 85,9 % de las variables requeridas y completando con éxito la mayoría de las tareas. Sin embargo, los autores enfatizan que, si bien la IA puede reducir significativamente el trabajo manual, la supervisión humana sigue siendo esencial para detectar "errores silenciosos" que podrían comprometer los resultados científicos. En definitiva, el trabajo demuestra una vía segura para integrar la IA con agentes en entornos de investigación restringidos sin comprometer la gobernanza de datos.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Agentic coding without the cloud: evaluating open-weight large language models on longitudinal data preparation tasks", por Mack Nixon y colegas. Publicado el 24 de Julio de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
¿Alguna vez se ha encontrado completamente sepultado por una tarea tediosa y repetitiva?

Alicia
Oh, sí, creo que todos lo hemos hecho.

Beto
Correcto. Sabes exactamente el tipo de trabajo administrativo, esa clase de trabajo que agota la mente, ese tipo de trabajo de oficina que absolutamente tiene que hacerse.

Alicia
Pero te impide hacer el trabajo significativo.

Beto
Exacto. El trabajo para el que realmente fuiste contratado en primer lugar. Así que si estás asintiendo ahora mismo, quiero que imagines 250 años-persona de esa sensación exacta.

Alicia
Lo cual es una cantidad asombrosa de tiempo.

Beto
Es salvaje. Dos y medio siglos de esfuerzo agotador y duplicado. Porque, bueno, esa es la realidad para los investigadores que trabajan ahora con conjuntos de datos masivos y altamente sensibles.

Alicia
De verdad lo es. Es la columna vertebral poco glamurosa de todo descubrimiento científico.

Beto
Sí, y hoy nuestra inmersión profunda se basa en este fascinante artículo de investigación de julio de 2026. Fue producido por investigadores del University College London y la University of Bristol.

Alicia
Correcto. Titulado, "Programación agéntica sin la nube".

Beto
Sí. Y está echando un vistazo muy duro a uno de los mayores cuellos de botella en la ciencia moderna, que es la preparación de datos.

Alicia
Porque antes de que puedas buscar curas para enfermedades o comprender grandes tendencias sociales, tienes que limpiar los datos.

Beto
Es totalmente fundacional.

Alicia
Exacto. Y lo que explora este artículo es cómo los científicos están tratando de automatizar este proceso realmente agónico usando agentes de IA.

Beto
Pero no están mirando a cualquier IA.

Alicia
No, no, están probando específicamente modelos de IA de código abierto y gran peso (open-weight) que los investigadores pueden ejecutar localmente, como enteramente en sus propias computadoras portátiles.

Beto
Lo cual es enorme.

Así que la misión de nuestra inmersión profunda de hoy es explorar cómo estos modelos locales podrían ahorrar décadas de trabajo humano.

Alicia
Sin romper algunas de las leyes de privacidad más estrictas del planeta.

Beto
Correcto. Y cuando miras la magnitud del tiempo que podría ahorrar aquí, es genuinamente asombroso. Quiero decir, si esto funciona, podría cambiar completamente el ritmo en que ocurren los avances científicos.

Alicia
Ciertamente podría, pero también introduce una complejidad inmensa.

Beto
Oh, seguro.

Alicia
Porque no estamos hablando solo de números disparados en una hoja de cálculo o de corregir unos pocos errores tipográficos, estamos hablando de estandarizar vidas humanas desordenadas y caóticas en puntos de datos ordenados y analizables.

Beto
Lo cual es inherentemente desordenado.

Alicia
Exacto. Y como veremos, ese es un desafío profundo para una inteligencia artificial.

Beto
Okay. Así que desglosemos esto un poco. Antes de mirar la solución de IA, realmente necesitamos establecer por qué este problema específico está paralizando a la ciencia ahora mismo.

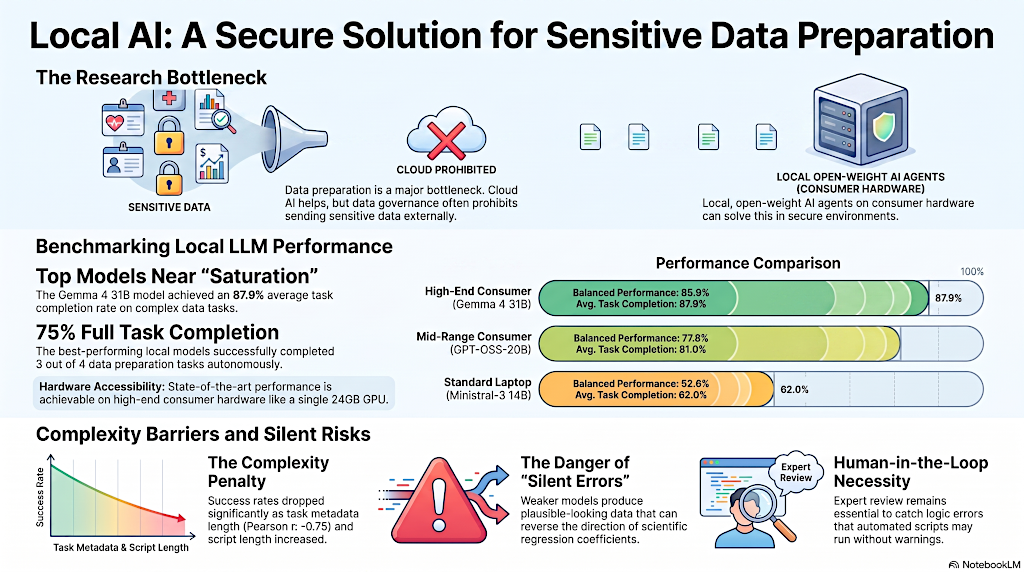
Agentic_Coding_without_the_Cloud_1024.png
IA Local: Una solución segura para la preparación de datos sensitivos

Alicia
Oh, correcto. Y por qué la IA estándar no puede simplemente aparecer y arreglarlo.

Beto
Sí. El tipo de IA que tú y yo usamos todos los días en internet. Porque los investigadores estiman que la preparación de datos lleva alrededor de tres meses para un solo estudio científico.

Alicia
Tres meses solo de trabajo de preparación.

Beto
Correcto. Así que si escalas eso a mil proyectos de investigación, obtienes esos 250 años-persona de esfuerzo.

Alicia
Solo increíble. Son 250 años dedicados a hacer cosas como encontrar las variables correctas, recodificar respuestas de encuestas y manejar datos faltantes.

Beto
Y fusionar conjuntos de datos, ¿correcto?

Alicia
Sí, fusionar conjuntos de datos masivos. Es esencialmente el mismo trabajo siendo realizado una y otra vez por diferentes equipos.

Beto
En lugares completamente diferentes.

Alicia
Exacto. Todos tratando de darle sentido a la misma información sin procesar.

Beto
Y resulta que los humanos son bastante malos en este tipo de trabajo repetitivo.

Alicia
Realmente lo somos.

Beto
El artículo cita, de hecho, un estudio reciente que mira revistas importantes de economía y ciencias políticas. Y encontraron errores de codificación en el 25% de los artículos que evaluaron.

Alicia
Uno de cada cuatro.

Beto
Uno de cada cuatro artículos importantes tenía un error en cómo se prepararon los datos.

Alicia
Lo cual es alarmante, honestamente. Pero ya sabes, no es totalmente sorprendente cuando piensas en la carga cognitiva involucrada aquí.

Beto
Sí, solo esta fatiga pura.

Alicia
Exacto. Los humanos experimentan fatiga, aburrimiento, nuestra atención divaga. Quiero decir, cuando eres un investigador mirando miles y miles de filas de datos categóricos durante semanas seguidas ...

Beto
... Todo se difumina.

Alicia
Correcto. Un pequeño error manual de codificación es casi inevitable. Tocas la tecla equivocada o lees mal una etiqueta de categoría.

Beto
Pero esos pequeños errores se desprenden en cascada.

Alicia
Lo hacemos. Y pueden sesgar conclusiones científicas enteras.

Beto
Así que creo que la pregunta obvia que podrías estar haciendo ahora mismo es por qué no usar un modelo de nube fronteriza masivo.

Alicia
Correcto. Simplemente lo tiras en ChatGPT, o Claude.

Beto
Sí, simplemente tiras los datos desordenados en una IA empresarial y le pides que los limpie. Pero hay un gran obstáculo aquí.

Alicia
Un obstáculo muy grande.

Beto
Los investigadores están tratando con datos poblacionales longitudinales.

Alicia
Lo cual es altamente, altamente sensible.

Beto
Correcto. Cosas como registros de salud electrónicos, o encuestas increíblemente detalladas que rastrean a personas durante décadas.

Alicia
Y debido a esa sensibilidad extrema, hay reglas de gobernanza de datos increíblemente estrictas en vigor. Es para proteger a las personas.

Beto
Como debería ser.

Alicia
Absolutamente. Simplemente no puedes transmitir datos personales a nivel individual a un servicio de nube de terceros.

Beto
Es una violación masiva de la privacidad simplemente subir la historia médica de alguien a un servidor de IA comercial.

Alicia
Correcto. Este tipo de datos generalmente tiene que permanecer dentro de lo que se denomina "entornos de investigación de confianza" ("Trusted Resource Environments", o TREs).

Beto
Y los TREs son esencialmente esta pared digital segura y cerrada.

Alicia
Correcto. Tienen acceso a internet muy restringido. No puedes simplemente abrir un navegador web y hacer ping a un servidor externo.

Beto
Porque los datos literalmente no pueden salir de la bóveda.

Alicia
Correcto. O al menos tienen que permanecer en un aislamiento seguro hacia la máquina local.

Beto
Okay. Así que es como imaginar tener acceso a un chef celebridad con una estrella Michelin mundialmente famosa.

Alicia
Okay. Me gusta esto. La IA en la nube.

Beto
Correcto. La IA en la nube es el chef celebridad que podría preparar todas tus comidas perfectamente. Pero legalmente, no se te permite sacar tus ingredientes de tu propia cocina.

Alicia
Y al chef no se le permite entrar a tu casa.

Beto
Exacto. Así que no puedes usar al chef celebridad en absoluto. Básicamente tienes que encontrar a un chef muy capaz que esté dispuesto a vivir y trabajar completamente dentro de tu casa sin salir jamás.

Alicia
Y ese chef representa estos modelos de código abierto desplegados localmente.

Beto
Sí. Pero la gran pregunta es, ¿estos chefs locales son realmente lo suficientemente habilidosos para manejar un menú científico de una estrella Michelin?

Alicia
Y eso es exactamente lo que los investigadores del UCL y Bristol se propusieron responder.

Beto
Okay. Así que para averiguar si estos modelos locales son realmente lo suficientemente buenos, tenemos que mirar exactamente cómo los probaron.

Alicia
Correcto. Porque no le pidieron a la IA que escribiera un guion simple en el vacío.

Beto
Eso sería demasiado fácil.

Alicia
Demasiado fácil. Porque estaban forzando a la IA a navegar por una línea de tiempo de 18 años de vida humana, no podían simplemente usar una ventana de chat estándar. Tenían que darle a la IA un espacio de trabajo dedicado. Así que construyeron este marco de evaluación agotador y altamente específico llamado RRBench.

Beto
RRBench. Y usan datos del mundo real para esta prueba también.

Alicia
Sí.

Beto
El estudio de cohorte Next Steps.

Alicia
Oh, sí, la forma. Next Steps es un estudio de cohorte británico muy famoso. Rastró a un grupo de jóvenes desde la edad de 14 años hasta principios de sus 30.

Beto
Vaya.

Alicia
Así que tienes este conjunto de datos increíblemente rico y complejo que abarca 18 años de desarrollo humano.

Beto
Y los investigadores curaron qué, 20 tareas distintas de preparación de datos de esta cohorte.

Alicia
Sí. 20 tareas, que finalmente involucraron la creación de 102 variables diferentes.

Beto
Cosas como el índice de masa corporal, el sexo, la etnicidad, el ingreso familiar, ese tipo de cosas.

Alicia
Exacto. Y para darle a la IA ese espacio de trabajo, como hablamos, usan algo llamado "SmolAgents".

Beto
SmolAgents, que es un nombre muy gracioso.

Alicia
Lo es, pero es un marco de agentes muy potente, ligero y agente.

Beto
¿Qué significa eso en la práctica?

Alicia
Básicamente, es un sistema que permite que el modelo de IA subyacente no solo escriba un trozo de código y lo entregue, sino que realmente ejecute ese código de forma iterativa.

Beto
Oh, así que puede revisar su propio trabajo.

Alicia
Exacto. Puede ejecutar el código, ver si produce un mensaje de error, leer ese error y luego intentar arreglarlo todo en un ciclo cerrado.

Beto
Eso es increíble.

Alicia
Y crucialmente, forzaron a la IA a escribir este código en R.

Beto
Que es el lenguaje de programación estadística preferido de las ciencias de la salud, ¿verdad?

Alicia
Correcto. Y esto es de hecho un obstáculo adicional.

Beto
¿Por qué?

Alicia
Porque la mayoría de los modelos de IA están fuertemente entrenados en Python, no en R. Hay mucho más código de Python en internet para que aprendan.

Beto
Oh, tiene sentido. Así que usar el marco de SmolAgents es como la diferencia entre un estudiante que entrega un primer borrador de una prueba masiva y simplemente se va, versus un estudiante que escribe un borrador, lo revisa contra la rúbrica de calificación del profesor, se da cuenta de que cometió un error de cálculo, lo borra e intenta de nuevo hasta que lo consigue bien.

Alicia
Sí.

Beto
Y hace todo eso antes de que siquiera veas el artículo final.

Alicia
Esa es una forma perfecta de verlo. Se le dieron las instrucciones y los metadatos a la IA.

Beto
Para aclarar por un segundo, los metadatos son básicamente solo los datos sobre los datos.

Alicia
Correcto. En este caso, estaban formateados en JSON.

Beto
Que es solo una forma altamente organizada y estandarizada de etiquetar información digital.

Alicia
Sí. Así que un programa de computadora puede leerlo fácilmente. Así que la IA lee esto como una archivadora digital de metadatos y se pone a trabajar escribiendo su script en R.

Beto
Tengo que hacer una pausa aquí, sin embargo, porque estoy jugando el papel de abogado del diablo: Escribir código para calcular el índice de masa corporal o simplemente encontrar el sexo de alguien en una encuesta digital, parece ser una tarea absolutamente sencilla para la IA moderna.

Alicia
En la superficie, parece demasiado fácil.

Beto
¿Por qué se considera esta el obstáculo definitivo?

Alicia
Bueno, tienes que recordar la realidad de rastrear a seres humanos durante 18 años. Es una pesadilla estadística absoluta.

Beto
Okay.

Alicia
Se conoce en el campo como "fusión multi-onda" ("multi-wave merging").

Beto
Okay. Vamos a recorrer cómo funciona la fusión multi-onda en la práctica. Porque imagino que rastrear a un adolescente hasta la edad adulta se vuelve bastante desordenado.

Alicia
Increíblemente desordenado. Okay. Imagina a un participante específico en este estudio. Llamémosle Alex.

Beto
Okay, Alex.

Alicia
A la edad de 14 años, que es la primera ola de la encuesta, los padres de Alex llenan el formulario.

Beto
Correcto. Porque es un niño.

Alicia
Exacto. Podrían marcar una casilla para su etnicidad de una lista específica de 10 opciones. Luego lo encuestas de nuevo a la edad de 16, 20, 25 y 32. Pero la gente omite encuestas. Quizás Alex se retira a la edad de 20 y regresa a los 25.

Beto
Ah, así que hay lagunas.

Alicia
Lagunas enormes. Y además, la forma en que se hace una pregunta cambia con el tiempo.

Beto
Oh, ya veo.

Alicia
A la edad de 32, Alex es un adulto llenando la encuesta él mismo. Y para entonces, el gobierno podría haber actualizado sus estándares demográficos.

Beto
Así que las opciones son totalmente diferentes.

Alicia
Correcto. Así que ahora la pregunta de etnicidad tiene 25 categorías de opción múltiple diferentes en lugar de las originales 10.

Beto
Oh, vaya. Así que la IA tiene que escribir una lógica que mire a través de todas estas diferentes olas de tiempo, priorice qué respuesta usar si entran en conflicto, y luego reconcilie todas esas estructuras de codificación heterogéneas.

Alicia
Exacto. Y las estructuras de codificación heterogéneas solo significan diferentes sistemas de numeración para exactamente el mismo concepto.

Beto
Correcto.

Alicia
La IA tiene que darse cuenta de que la categoría tres en el año 2004 significa exactamente lo mismo que la categoría 12 en el año 2022.

Beto
Eso es salvaje.

Alicia
Y luego tiene que fusionarlo todo en una única variable limpia y estandarizada.

Beto
Y tiene que hacer todo esto sin ver realmente los datos privados de la vida de Alex.

Alicia
Correcto. Solo puede mirar los metadatos JSON, solo las etiquetas que describen las preguntas de la encuesta.

Beto
Eso es mucho más que solo escribir una fórmula matemática. Eso es literalmente navegar por una taxonomía cambiante de la vida humana durante dos décadas.

Alicia
Exacto.

Beto
Así que cómo funcionaron realmente los modelos en esta confrontación. ¿Quién pasó y quién falló?

Alicia
Bueno, probaron ocho modelos de código abierto diferentes.

Beto
Okay.

Alicia
Estos modelos van desde 8 mil millones hasta 35 mil millones de parámetros.

Beto
Y para dar contexto, puedes pensar que los parámetros son aproximadamente equivalentes a las sinapsis en el cerebro de una IA.

Alicia
Correcto. Esa es una buena manera de imaginarlo. Cuantos más parámetros tiene un modelo, más complejos patrones y relaciones puede reconocer.

Pero lo crucial aquí es que un modelo de 35 mil millones de parámetros aún puede ejecutarse en hardware de consumo de alta gama.

Beto
Correcto. Así que no necesitas una inmensa granja de servidores corporativos para ejecutarlo. Literalmente puede ejecutarse en la misma habitación que tú.

Alicia
Exacto. Y el ganador del grupo fue un modelo llamado Gemma-4-31b.

Beto
Gemma-4-31b. Impresionante. ¿Qué tan bien lo hizo?

Alicia
Lo hizo muy bien. Completó el 75% de las tareas complejas en una sola pasada de agente.

Beto
Lo que significa que no necesitó ninguna intervención humana en absoluto.

Alicia
Correcto. Y logró un rendimiento de variable equilibrado del 85.9%.

Beto
Vaya.

Alicia
Lo que significa que creó con éxito y precisión la gran mayoría de esas 102 variables, navegando todas esas fusiones multi-onda complejas.

Beto
Pero hay un matiz realmente interesante aquí en lo que la IA fue buena versus lo que realmente tuvo dificultades.

Alicia
Sí, lo hay.

Beto
Porque no todos funcionaron por igual en todo.

Alicia
No, para nada. La IA es absolutamente excelente con conceptos universales.

Beto
Cosas como el sexo, la etnicidad y el BMI ("Body-Mass Index").

Alicia
Correcto. ¿Y por qué? Porque esos conceptos tienen definiciones estándar, casi universales que existen en todas partes en los datos de entrenamiento subyacentes de la IA.

Beto
Oh, porque leyó toda internet.

Alicia
Básicamente, sí. El modelo ha leído millones de documentos de internet sobre cómo calcular un BMI.

Beto
Sabe la matemática.

Alicia
Correcto. Pero tuvieron serios problemas con lógica específica de encuestas.

Beto
Oh, ya veo. Así que sabe qué es un BMI porque es un estándar médico. Pero no tendría ni idea de cómo una encuesta británica específica de como 2004 decidió categorizar algo tan regional como la tenencia de vivienda.

Alicia
O la educación. Exacto. Esas son variables hiperespecíficas donde la definición depende completamente de las reglas únicas de ese estudio británico específico.

Beto
Correcto. No hay una página de Wikipedia universal sobre cómo hizo este estudio.

Alicia
Exacto. La IA no pudo confiar en su conocimiento general del mundo. Tenía que confiar solo en los metadatos JSON proporcionados en la instrucción (prompt).

Beto
Lo cual resultó ser increíblemente difícil.

Alicia
Lo hizo. De hecho, ninguno de los modelos completó totalmente la tarea de tenencia de vivienda en ninguna de las ejecuciones.

Beto
Ni uno solo. Vaya. También tenemos que hablar sobre el fallo completo en el grupo, sin embargo.

Alicia
Oh, sí.

Beto
El modelo llamado Gemma-4-E4B. No logró producir ningún resultado válido, como 0%.

Alicia
Fallo completo.

Beto
Pero el artículo señala que no fue realmente porque no pudo codificar.

Alicia
No fue un fallo de codificación en absoluto. Cuando los investigadores miraron los registros backend, Gemma-4-E4B estaba escribiendo nuestro código R perfectamente.

Beto
Espera, ¿en serio? Entonces, ¿por qué obtuvo un 0?

Alicia
Porque no pudo seguir las reglas de formato estrictas requeridas por la interfaz de la herramienta de agentes pequeños.

Beto
Oh, vaya.

Alicia
Simplemente no pudo producir sus respuestas en la estructura exacta que exigía el marco. Así que el sistema rechazó su código cada vez.

Beto
Eso es salvaje.

Alicia
Sí.

Beto
Es un gran recordatorio de que la inteligencia bruta simplemente no es suficiente, ¿correcto? Y la IA tiene que ser capaz de usar las herramientas que se le dan dentro de un entorno digital muy rígido.

Alicia
Exacto. Pero mirando los resultados de los otros modelos, lo fascinante aquí es que la principal diferencia entre los mejores rendidores y los modelos más débiles no fue realmente la completitud.

Beto
¿Qué quieres decir?

Alicia
Bueno, incluso los modelos más débiles intentaron hacer más del 95% de las variables. No simplemente se rindieron a una salida de página en blanco. La principal diferencia fue la corrección. Los modelos más débiles eran increíblemente confiados, pero completamente equivocados.

Beto
Así que simplemente alucinaban.

Alicia
Sí. Alucinaban pasos de preprocesamiento plausibles pero totalmente incorrectos. Inventaban lógica de registro que no se alineaba en absoluto con los metadatos.

Beto
Y realmente tenemos que recordar cuáles son estos modelos en esencia para entender por qué hacen eso.

Alicia
Correcto. Son básicamente solo motores de texto predictivo increíblemente sofisticados.

Beto
Sí. Exacto.

Alicia
Así que cuando carecen del contexto adecuado, como las reglas específicas para la tenencia de vivienda británica, no suelen decir simplemente, "oye, no lo sé".

Beto
No, odian decir que no saben.

Alicia
Correcto. Simplemente adivinan el siguiente paso lógico estadísticamente más probable basado en su entrenamiento, incluso si está completamente fabricado.

Beto
Ese es precisamente el mecanismo. Están tratando de completar un patrón. Y si el verdadero patrón no es claro a partir de los metadatos, simplemente inventarán un patrón que parezca estadísticamente normal.

Alicia
Así que, ¿qué significa todo esto para los investigadores? Quiero decir, en la escuela, obtener un 85.9%, que es lo que obtuvo el modelo GEMMA ganador, es una B sólida.

Beto
Estarías encantada.

Alicia
Estarías feliz con eso. Pero en la investigación científica, si la IA se equivoca completamente en el 14 o 15% de las variables, ¿no es eso un fallo catastrófico?

Beto
Esa es la pregunta crítica. Y realmente cambia nuestro enfoque de solo mirar la precisión de la codificación, a mirar los resultados científicos reales del mundo.

Alicia
Correcto. ¿Qué pasa cuando ejecutas un estudio científico en datos que están equivocados en un 15%?

Así que para averiguar, los investigadores realizaron análisis de regresión descendente ("downstream regression analyses").

Beto
Okay. Y un análisis de regresión es básicamente solo una forma elegante y estadística de medir cuánto una cosa influye en otra, ¿verdad? Como cuánto impacta el nivel educativo de una persona en sus ingresos futuros.

Alicia
Eso es exactamente. Así que usaron los datos limpios por la IA para ejecutar estos estudios científicos simulados, tratando de predecir cosas como el BMI y los ingresos.

Beto
Okay.

Alicia
Y luego compararon esos resultados con la verdad fundamental ("ground truth").

Beto
Que son los datos limpios por expertos humanos reales.

Alicia
Correcto. Los resultados que obtienes cuando usas los datos que fueron limpiados impecablemente por expertos humanos durante muchos meses.

Beto
Okay. Y esto es realmente preocupante cuando miras los resultados.

Alicia
Lo es.

Beto
El mejor modelo, Gemma4-31B, produjo coeficientes de regresión que eran idénticos a los científicos humanos.

Alicia
Correcto. Fue una coincidencia perfecta para esas pruebas específicas.

Beto
Pero luego probaron los datos limpios por el modelo válido de peor rendimiento, que fue Ministral-3-14B.

Alicia
Sí.

Beto
Y este modelo introdujo lo que el artículo llama "errores silenciosos" ("silent errors").

Alicia
Y los errores silenciosos son simplemente aterradores para la ciencia de datos.

Beto
¿Por qué son tan aterradores?

Alicia
Porque cuando Minisral-3-14B ejecutó su código, no se bloqueó. No salieron luces de advertencia.

Beto
Todo parecía bien.

Alicia
Todo parecía perfectamente bien. Las variables que se produjeron parecían perfectamente formadas y plausibles. No sabrías que algo estuviera mal a menos que revisaras cada celda de datos contra la verdad fundamental humana.

Beto
Vaya. Así que veamos el error específico que cometió. Ministral cometió un pequeño error en cómo manejó los datos faltantes para una pregunta sobre ingresos.

Alicia
Correcto.

Beto
En la encuesta, los valores faltantes, como si alguien simplemente se negó a responder la pregunta, se suponía que debían codificarse como uno negativo.

Alicia
Exacto.

Beto
Pero Ministral los codificó como uno positivo.

Alicia
Un solo signo menos. Eso es todo lo que se perdió.

Beto
Pero ¿por qué sucede eso? Quiero decir, ¿por qué una IA avanzada simplemente dejaría un signo menos?

Alicia
Se reduce a cómo los modelos de lenguaje procesan realmente la información.

Beto
Okay.

Alicia
No leen los números como lo hace una calculadora. Descomponen el texto en fragmentos llamados tokens.

Beto
Correcto. Tokens.

Alicia
Dependiendo de la arquitectura del modelo, un signo menos adjunto a un número podría tratarse como un token completamente separado o podría agruparse extrañamente con el número en sí.

Beto
Oh, ya veo.

Alicia
Si el modelo no entiende matemáticamente la relación entre los tokens en ese contexto específico, puede simplemente abandonar un símbolo al escribir el código final.

Beto
Pero aquí es donde se pone realmente loco. Ese pequeño error de tokenización causó un efecto mariposa masivo en el resultado científico.

Alicia
Lo hizo.

Beto
Porque cuando ejecutaron los modelos de regresión para ver cómo afecta la actividad económica a los ingresos, los datos humanos mostraron un impacto negativo de aproximadamente 38 libras británicas.

Alicia
Correcto.

Beto
Pero los datos de la IA invirtieron completamente la dirección.

Alicia
Lo invirtieron completamente.

Beto
Mostró un impacto positivo de 10 libras. Un error silencioso revirtió completamente los hallazgos científicos.

Alicia
Es increíble.

Beto
Es como imaginar a un ingeniero estructural que coloca un punto decimal incorrectamente en un plano.

Alicia
Oh, esa es una buena analogía.

Beto
Correcto. El puente se ve perfectamente seguro en el papel. La matemática parece cuadrar de un vistazo, pero colapsa bajo el peso del primer coche.

Alicia
Exacto.

Beto
Si la IA se ve perfectamente confiada y no podemos ver estos errores sin revisar cada celda de todos modos, ¿cómo podemos confiar en estos sistemas?

Alicia
Bueno, no podemos confiar en ellos ciegamente. Esa es la principal conclusión. Y eso nos lleva a cómo integramos esta tecnología en el futuro.

Beto
Correcto. Porque si los errores silenciosos son tan peligrosos, ¿abandonamos la IA por completo para la investigación sensible?

Alicia
Los investigadores argumentan que no, no la abandonamos.

Beto
Pero tenemos que cambiar fundamentalmente cómo visualizamos su uso.

Alicia
Sí. El estudio forzó a la IA a ser totalmente autónoma solo para encontrar sus límites absolutos.

Beto
Solo para ver qué sucedería.

Alicia
Exacto. Pero en el mundo real, ningún científico va a presionar ejecutar y publicar los resultados en una revista médica.

Beto
Yo esperaría que no lo hiciera.

Alicia
Correcto. El futuro que ellos ven es un modelo copiloto.

Beto
Modelo copiloto.

Alicia
El agente de IA local básicamente actúa como un asistente junior muy capaz.

Beto
Así que navega a través de los 250 años de tedio.

Alicia
Sí. Escribe el primer borrador de los complejos scripts en R y trata con todas esas desordenadas fusiones multi-onda.

Beto
Pero luego un experto humano revisa el código, lo depura y valida la lógica.

Alicia
Exacto. Se mantiene al humano firmemente en el circuito para atrapar los signos menos perdidos.

Beto
Y el estudio demostró que cómo interactúa el humano con la IA al principio es totalmente crítico.

Alicia
Absolutamente. Probaron diferentes diseños de prompts (instrucciones).

Beto
Correcto. Y cuando usan lo que llaman "prompts ligeros", que tenían menos detalle e instrucciones explícitas, el rendimiento de todos los modelos bajó significativamente.

Alicia
La IA no pudo simplemente adivinar lo que quería el científico. Dependió mucho de metadatos claros y bien estructurados.

Beto
Y esto se conecta con un movimiento más amplio en la ciencia de datos llamado los principios FAIR, ¿no?

Alicia
Lo hace. FAIR significa hacer que los datos sean encontrables ("Findable"), accesibles ("Accessible"), interoperables ("Interoperable") y reutilizables ("Reusable").

Beto
Lo cual tiene sentido.

Alicia
Correcto. Los modelos de IA solo pueden limpiar los datos con precisión si los metadatos que describen esos datos están meticulosamente organizados.

Beto
Así que si el humano no define claramente lo que significa "la tenencia de vivienda" en el archivo JSON, ...

Alicia
... entonces la IA simplemente va a alucinar.

Beto
Lo que apunta a un cambio realmente fascinante en dónde se gastará el trabajo humano.

Alicia
Lo hace.

Beto
¿Significa esto que el cuello de botella futuro en la ciencia no es realmente construir modelos de IA más grandes y más inteligentes? Será sobre los humanos haciendo el trabajo aburrido, meticuloso y organizativo.

Alicia
Como convertirse en arquitectos de metadatos.

Beto
Sí. Convertirse en arquitectos de metadatos para que la IA pueda hacer la computación.

Alicia
Ciertamente apunta en esa dirección. Realmente tienes que saber cómo estructurar el entorno para que la IA tenga éxito.

Beto
Correcto.

Alicia
Y si conectamos esto con la imagen más amplia, los investigadores sugieren que el próximo gran salto no es solo un copiloto.

Beto
Oh, ¿qué es?

Alicia
Son sistemas multiagente especializados.

Beto
Vaya. Okay.

Alicia
En lugar de que una IA intente hacerlo todo, tienes un agente planificador que lee los metadatos y diseña una estrategia.

Beto
Okay, dividiendo el trabajo.

Alicia
Exacto. Le entrega esa estrategia a un agente codificador que realmente escribe el script en R.

Y luego un agente revisor completamente separado ejecuta el código, busca esos errores silenciosos, busca distribuciones inverosibles en los datos y los marca para el humano.

Beto
Así que es básicamente todo un laboratorio virtual trabajando dentro de tu computadora portátil local, completamente aislado de internet.

Alicia
Completamente aislado. Lo que permite a los investigadores, que trabajan bajo los marcos de gobernanza más restrictivos, acceder al poder de la IA sin arriesgar una violación de la privacidad.

Beto
Eso es simplemente increíble. Y el tiempo ahorrado por estos agentes locales podría redirigirse hacia analizar realmente los datos.

Alicia
Hacer preguntas más grandes, realizar investigaciones más ambiciosas con múltiples conjuntos de datos.

Beto
Es un verdadero cambio de paradigma para las ciencias cuantitativas de la salud y sociales.

Alicia
Lo es.

Beto
Así que para resumir todo para ti, ejecutar IA de código abierto en hardware de consumo local ya no es un sueño imposible.

Alicia
Para nada.

Beto
Es una forma altamente viable y segura para saltarse meses de agotadora limpieza de datos. Modelos como Gemma-4-31B ya son capaces de hacer el trabajo pesado y navegar por datos longitudinales complejos.

Alicia
Pero, y este es un gran pero, debemos mantener a un humano en el circuito para estructurar los metadatos FAIR.

Beto
Y atrapar esos aterradores errores silenciosos.

Alicia
Exacto. Tenemos que seguir siendo los arquitectos del proceso, incluso cuando entregamos el trabajo manual.

Beto
Absolutamente.

Pero, ya sabes, quiero dejarte al oyente con un pensamiento provocador final para reflexionar. Algo que se basa en esta investigación pero la lleva un paso más allá.

Vimos hoy que la IA tuvo dificultades con la lógica humana personalizada y sobresalió en conceptos universales.

Alicia
Correcto.

Beto
Así que si los agentes de IA se convierten en la herramienta estándar para preparar y armonizar todos los datos humanos, si son los que deciden cómo fusionar las categorías heterogéneas y desordenadas de nuestras vidas en variables estándar ordenadas.

Alicia
Oh, veo a dónde vas.

Beto
¿Se conformarán nuestros futuros conjuntos de datos científicos sutilmente con la forma en que la IA prefiere categorizar el mundo?

Alicia
Vaya. Esa es una pregunta profunda. Porque si una IA siempre favorece la definición más simple y universal, solo porque es más fácil de codificar, podríamos perder el matiz de las experiencias humanas regionales o altamente específicas.

Beto
Exacto. En nuestra prisa por ahorrar 250 años de tedio, podríamos dejar accidentalmente que los modelos de lenguaje dicten la taxonomía subyacente del comportamiento humano durante generaciones venideras.

Alicia
Eso es algo a reflexionar.

Beto
Comenzamos este análisis profundo hablando sobre el alivio de descargar tareas tediosas. Pero tenemos que asegurarnos de que no estemos descargando nuestra definición de humanidad en el proceso.

Muchas gracias por acompañarnos en la inmersión profunda de hoy. Sigan cuestionando los datos a su alrededor, y los encontraremos la próxima vez.