
Este estudio explora el campo emergente de la ingeniería de entornos agénticos, que proporciona sistemas interactivos y dinámicos para el entrenamiento y la evaluación de agentes de modelos de lenguaje a gran escala (LLM). Para superar las limitaciones de las pruebas en el mundo real, que conllevan altos costos y riesgos, los investigadores utilizan la síntesis simbólica y la síntesis neuronal para crear mundos simulados en dominios como la interacción con interfaces gráficas de usuario (GUI), la robótica y la investigación profunda. Estos entornos facilitan una coevolución de ciclo cerrado donde los agentes refinan sus capacidades de razonamiento y planificación mediante retroalimentación iterativa. El texto distingue la ingeniería de entornos de la ingeniería de datos tradicional al enfatizar la evolución colaborativa y las interacciones de múltiples turnos sobre conjuntos de datos estáticos. Además, establece una taxonomía multidimensional de atributos, como la observabilidad y la estocasticidad, para estandarizar el modelado de estos sistemas. En última instancia, las fuentes abogan por el Entorno como Servicio (EaaS) y los híbridos neuronales-simbólicos para salvar la brecha entre la lógica programada rígida y los modelos generativos escalables.
Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Agentic Environment Engineering for Large Language Models: A Survey of Environment Modeling, Synthesis, Evaluation, and Application", por Jiachun Li y colegas. Publicado el 10 de Junio de 2026.
El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.
El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.
Resumen
Beto
Imagina una IA que no solo redacta un correo electrónico cortés para ti o escribe un poema, sino que realmente toma el control del ratón de tu computadora.
Alicia
Bien. Como si moviera físicamente el cursor.
Beto
Exacto. Hace clic a través de tu navegador, se confunde con un anuncio pop-up aleatorio, descubre cómo cerrarlo, abre una hoja de cálculo, formatea todos tus datos trimestrales y simplemente sigue trabajando por sí misma.
Alicia
Sí, lo cual es un cambio enorme.
Beto
Lo es de verdad. Porque estamos tan acostumbrados a que la IA solo viva dentro de una caja de chat, ¿verdad?, esperando que escribamos un "prompt". La tratamos como esta superinteligencia, una enciclopedia increíblemente rápida.
Alicia
Un "cerebro en un frasco", esencialmente. Hemos alimentado a esta IA con esta dieta estática de datos de internet, pero su existencia es totalmente pasiva.
Beto
Correcto.
Alicia
Lee sobre el mundo, sintetiza texto sobre el mundo, pero no experimenta el mundo. Básicamente no tiene agencia fuera de generar la siguiente palabra en una secuencia.
Beto
Ese paradigma está cambiando mucho más rápido de lo que la mayoría de la gente se da cuenta.
Así que les damos la bienvenida al análisis profundo de hoy. Hoy vamos a sacarlos completamente de la caja de chat.
Alicia
Sí, lo vamos a hacer.
Beto
Nuestra misión es guiarlos a través de este artículo de encuesta masivo y realmente de vanguardia de 2026 de la Academia China de Ciencias. Se llama, "Ingeniería de Entornos Agénticos para Modelos de Lenguaje Grandes (LLMs)".
Alicia
Tremendo título, ¿verdad?
Beto
Oh, sí. Suena genial. Pero miren, estamos viendo un cambio monumental en la informática. La IA está esencialmente adquiriendo manos y piernas digitales. Está pasando de ser una herramienta que solo lee sobre las cosas a ser una entidad que está viviendo, adaptándose y evolucionando en mundos digitales simulados.
Alicia
Y para comprender realmente la magnitud de este cambio, necesitamos definir claramente qué es exactamente un entorno agéntico, porque es un término específico.
Beto
Sí, vamos a desglosarlo.

De Datos Estáticos A Mundos Dinámicos: Surge la Ingeniería de Entornos Agénticos
Alicia
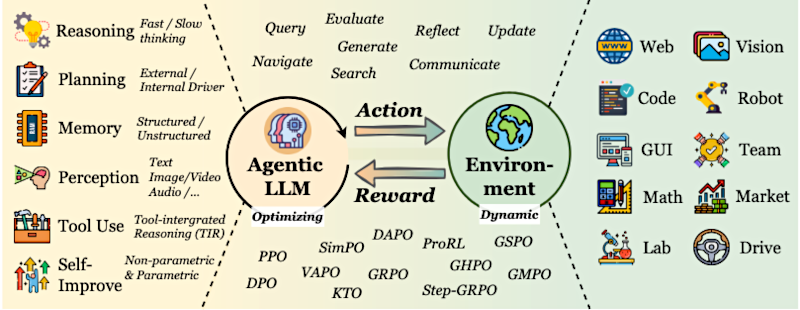
En esencia, es un sistema interactivo dinámico que simula un escenario del mundo real. Piensen en un navegador web simulado o un videojuego 3D como Minecraft, o incluso un sistema operativo completo de smartphone. Es básicamente una arena digital donde el modelo de IA, al que llaman "el agente", toma una acción y luego el entorno responde activamente a esa acción en tiempo real.
Beto
De acuerdo, desglosemos esto por un segundo. Para apreciar realmente por qué construir estos mundos digitales es tan revolucionario, primero tenemos que mirar la forma antigua en que entrenábamos a la IA.
Alicia
Correcto, el viejo paradigma.
Beto
Sí, y tenemos que entender por qué ese viejo método golpeó un muro de ladrillos. El artículo habla extensamente de este cambio, de la ingeniería de datos, a la ingeniería de entornos.
Alicia
Lo cual es una distinción crucial.
Beto
Lo es. La forma antigua, la ingeniería de datos, es muy parecido a estudiar para un examen masivo, usando nada más que una gigantesca pila de tarjetas de memoria.
Alicia
Me encanta esa analogía. La idea de las tarjetas de memoria ilustra perfectamente la limitación porque, bajo el sistema antiguo, la IA solo ingiere miles de millones de estos puntos de datos de preguntas y respuestas de una sola ronda. Le muestras la cara de la tarjeta, que es como un "prompt" de texto, y trata de adivinar la respuesta correcta. Los ingenieros se refieren a esto como "un sistema de bucle abierto" ("open loop system").
Beto
Un bucle abierto, lo que significa que no regresa.
Alicia
Exacto. La IA produce una respuesta, pero nunca llega a presenciar la consecuencia del mundo real de lo que acaba de generar.
Beto
Oh, vaya. Así que si comete un pequeño error lógico en el primer paso de un problema matemático de 10 pasos, o escribe una línea de código con un error muy sutil, ...
Alicia
... no lo descubre hasta el final.
Beto
Correcto. Simplemente es marcado como incorrecto por el conjunto de datos. Literalmente no tiene oportunidad de corregir su rumbo a mitad del camino.
Alicia
Y lo fascinante aquí es que los datos estáticos tienen un límite de dificultad fijo e inamovible. Los datos están totalmente desacoplados de la competencia real en tiempo real del modelo.
Beto
Espera, ¿qué significa eso exactamente, "desacoplado"?
Alicia
Así que si la tarjeta de memoria es demasiado difícil, el modelo simplemente falla y no aprende absolutamente nada del proceso. Pero si la tarjeta de memoria es demasiado fácil, llega a un punto de rendimientos decrecientes. El entrenamiento se vuelve completamente rígido.
Beto
Eso tiene todo el sentido. Piensa en la diferencia entre memorizar un libro de física sobre cómo escribir una bicicleta, versus montar en una bicicleta de verdad.
Alicia
Oh, exactamente.
Beto
Es decir, puedes leer sobre fuerzas giroscópicas todo el día, pero cuando te subes a una bicicleta de verdad, la gravedad la tira hacia la izquierda, te corriges demasiado a la derecha, te caes, te rascas las rodillas.
Alicia
Sientes la retroalimentación al instante.
Beto
Sí. Aprendes a equilibrarte en tiempo real porque el entorno empuja activamente contra tus errores.
Alicia
Y cuando el entorno empuja de vuelta, el aprendizaje se vuelve colaborativo. Es de múltiples turnos. Se transforma, de un bucle abierto, a un sistema de bucle cerrado.
Beto
Un bucle cerrado, entendido.
Alicia
En un entorno agéntico, la distribución de datos se ajusta dinámicamente en función del rendimiento en tiempo real del agente. Así que si la IA hace clic en el botón equivocado en un navegador web simulado, recibe un mensaje de error.
Beto
Correcto.
Alicia
Luego tiene que internalizar ese error, mirar la pantalla y descubrir una estrategia de recuperación sobre la marcha. Desarrolla una comprensión funcional de la lógica orientada a objetivos en lugar de solo hacer coincidir patrones de texto.
Beto
Esto plantea una pregunta realmente masiva, sin embargo. Si el entorno está empujando de vuelta, ¿cómo se ven físicamente las leyes de estos mundos digitales?
Alicia
Ahí es donde las cosas se ponen realmente técnicas, pero muy interesantes.
Beto
Sí, porque el artículo desglosa varios atributos específicos del entorno, y hubo una distinción que realmente me llamó la atención. Los autores contrastan entre MDP, y POMDP.
Alicia
Correcto. El "proceso de decisión de Markov" ("Markov Decision Process", MDP) frente al "proceso de decisión de Markov parcialmente observable" ("Partially Observable Markov Decision Process", POMDP).
Es un concepto fundamental para cómo un agente percibe su realidad.
Beto
Sí, entonces un MDP se describe como un entorno totalmente observable, lo que significa que la IA tiene acceso completo y transparente a todas las dinámicas verdaderas del mundo.
Alicia
Ve todas las variables a la vez, como un tablero de ajedrez.
Beto
Exacto. Pero un POMDP es parcialmente observable. Así que la IA solo ve una porción pequeña y fragmentada del mundo en un momento dado.
Alicia
Sí.
Beto
Ahora, espera un minuto. ¿No sería mucho mejor y computacionalmente más rápido, si simplemente hacemos que todo sea totalmente observable? Si queremos que la IA aprenda a resolver un problema rápidamente, ¿por qué le estamos ocultando activamente información?
Alicia
Parece totalmente contraintuitivo, pero tenemos que recordar el objetivo final aquí. Queremos que estos agentes operen eventualmente en el mundo real, y la realidad humana simplemente no es totalmente observable.
Beto
Oh, eso es cierto.
Alicia
Cuando abres un navegador web para investigar un tema, no ves todo internet a la vez.
Beto
Correcto, gracias al cielo.
Alicia
Ni siquiera ves el código HTML subyacente del sitio web que estás viendo en ese momento. Solo ves una pestaña y una vista limitada ("viewport") a la vez.
Beto
Así que esencialmente forza a la IA a depender de su memoria. Como si entrara en mi cocina a hacer café, no necesito visión de rayos X para saber que la leche está detrás de la puerta del refrigerador.
Alicia
Correcto. Porque recuerdas haberla puesto allí ayer.
Beto
Exacto. La IA tiene que construir exactamente ese mismo tipo de deducción basada en su historial.
Alicia
En un entorno parcialmente observable, el agente está recibiendo una proyección incompleta, a veces muy ruidosa, del estado actual. Realmente tiene que agregar información a lo largo de toda su trayectoria interactiva para inferir lo que no puede ver.
Beto
Oh, vaya.
Alicia
Si simplemente le damos a la IA todas las respuestas por adelantado en un entorno totalmente observable, nunca aprende a investigar. Nunca aprende a buscar o deducir. La ceguera es lo que realmente forza el desarrollo cognitivo.
Beto
Caramba, eso hace que la construcción de estos mundos sea increíblemente compleja, sin embargo. Si estamos construyendo estas arenas densas y parcialmente observables, ¿cómo están programadas realmente?
Alicia
Bueno, el artículo habla de la síntesis de entornos y básicamente divide los métodos de construcción en dos campamentos principales.
Beto
Correcto. Síntesis simbólica y síntesis neuronal.
Alicia
Exacto.
Beto
La síntesis simbólica parece bastante sencilla para mí. Como si estuviéramos usando reglas codificadas, código de programación exacto, motores de física, API verificable.
Alicia
Ingeniería de software muy tradicional.
Beto
Sí. Un programador humano escribe un "script" que dice, si la IA hace clic en este botón, carga esta página web específica.
Alicia
Correcto. Y la síntesis simbólica proporciona una base lógica muy estricta. Es altamente confiable y matemáticamente consistente. El artículo menciona de hecho un marco llamado EnvScaler, que sintetiza programáticamente estos entornos interactivos de herramientas ejecutables donde todas las actualizaciones de estado están gobernadas por código Python explícito.
Beto
Pero, ¿cuál es la trampa?
Alicia
La limitación principal es la escalabilidad. Los ingenieros humanos básicamente tienen que escribir manualmente las reglas para cada interacción posible.
Beto
Oh, lo cual sería dolorosamente lento.
Alicia
Increíblemente lento.
Beto
Así que aquí es donde se pone realmente interesante, sin embargo. Porque la alternativa de la que hablan es la síntesis neuronal. Y bajo este método, no estamos usando reglas codificadas en absoluto.
Alicia
En absoluto.
Beto
En cambio, estamos usando una red neuronal, que a menudo llaman un "frasco de mundo" ("world bottle"), para esencialmente alucinar la física del entorno en tiempo real.
Alicia
Sí.
Beto
Quiero decir, es exactamente como la película "Inception". La IA está esencialmente inventando su propio campo de entrenamiento basado en parámetros aprendidos.
Alicia
Esa es una comparación perfecta. En lugar de que un programador escriba exactamente lo que sucederá después, el modelo de mundo simplemente observa la acción del agente y predice el resultado lógico.
Beto
Vaya.
Alicia
El artículo destaca herramientas como WebDreamer, por ejemplo. Utiliza modelos de lenguaje grandes para simular transiciones de estado web complejas sin una sola línea de código de interfaz de usuario explícito.
Beto
Eso es salvaje.
Alicia
O toma DreamGen, que utiliza modelos de mundo de video neuronales. El agente toma una acción, y el modelo de mundo literalmente sueña con cómo debería verse el siguiente fotograma visual de la realidad.
Beto
Espera, así que si el agente dice que hago clic en el botón de pago, el entorno neuronal simplemente alucina una página de confirmación del carrito de compras.
Alicia
Exacto. Completa con un diseño realista y precios, solo basado en su comprensión subyacente de cómo funcionan generalmente los sitios web de comercio electrónico.
Beto
Eso es un cambio profundo en la informática.
Alicia
Lo es de verdad. Porque los entornos simbólicos te dan esa confiabilidad de ingeniería, pero son increíblemente rígidos. Los entornos neuronales te dan una escalabilidad generativa infinita. Puedes simular literalmente cualquier escenario al instante, pero pueden ser impredecibles.
Beto
Correcto, porque están sujetos a la alucinación.
Alicia
Exacto. Así que el artículo sugiere firmemente que la infraestructura futura tendrá que tender un puente entre esta brecha, creando entornos híbridos neurona-simbólicos que aprovechen tanto la lógica estricta como la escala generativa.
Beto
Bien, si estamos construyendo estos mundos masivos, infinitamente escalables y parcialmente observables, ¿dónde vamos a soltar a estos agentes de IA? ¿Cuáles son sus misiones reales una vez que entran?
Alicia
El artículo proporciona la taxonomía extensa de dominios. Y honestamente, la variedad de tareas es asombrosa.
Beto
Sí, veamos algunas de ellas empezando por los entornos de interfaz gráfica de usuario (GUI) web. Porque estamos yendo mucho más allá de pedirle a un chatbot que resuma un PDF.
Alicia
Oh, mucho más allá. Las interfaces gráficas de usuario o GUI son un enfoque principal para la aplicación comercial en este momento. El artículo destaca entornos de interfaz gráfica de escritorio, como OSWorld.
Beto
Sí, OSWorld es salvaje. El agente literalmente tiene que usar una interfaz de escritorio de computadora simulada, exactamente como lo haría un trabajador de oficina humano.
Alicia
Con un ratón y un teclado.
Beto
Sí, tiene que coordinarse a través de diferentes aplicaciones, gestionar carpetas de archivos, copiar texto de un navegador, pegarlo en un documento, ir a la configuración del sistema.
Alicia
Solo piensa en tu propio flujo de trabajo diario. Imagina darle a una IA un "prompt", como, "encuentra las últimas tres facturas que recibí de la agencia de marketing, extrae los montos totales, ponlos en una nueva hoja de Excel, calcula el impuesto y envía un archivo a mi cuenta".
Beto
Nos ahorrarían muchísimo tiempo.
Alicia
Correcto. Y en OSWorld, la IA está literalmente practicando tomar el control del ratón y el teclado para navegar por la interfaz visual y hacer exactamente eso.
Beto
Eso es increíble. Y también se está entrenando en entornos GUI web, ¿verdad? Como WebShop.
Alicia
Sí. La "tienda web" ("WebShop") es importante. El agente es introducido en una plataforma de compras en línea simulada. Tiene que buscar artículos, filtrar por atributos específicos como talla o color, leer reseñas de usuarios y realmente hacer clic a través de un complejo proceso de pago de varias páginas.
Beto
Bien. Pero las aplicaciones se ponen mucho más extrañas cuando pasamos al dominio de los juegos.
Alicia
Lo hacen de verdad.
Beto
Porque ya no estamos entrenando a una IA para jugar, como, un partido de ajedrez elegante para demostrar que es inteligente. El artículo discute juegos de mundo abierto como MineDojo, que literalmente introduce a la IA a Minecraft.
Alicia
Sí, Minecraft es un campo de pruebas excepcional.
Beto
La IA tiene que sobrevivir. Tiene que recolectar recursos básicos, fabricar herramientas intrincadas y explorar este vasto mundo abierto con retroalimentación increíblemente escasa.
Alicia
Y esa retroalimentación escasa es clave, porque Minecraft es totalmente abierto. Requiere planificación a largo plazo sin un guión rígido.
Beto
Correcto.
Alicia
Sin embargo, yo argumentaría que los juegos de reducción social son quizás los entornos más exigentes intelectualmente de los que listaron.
Beto
Sí. El artículo dedica mucha atención a un entorno llamado AvalonBench. Y honestamente, las implicaciones de AvalonBench son un poco inquietantes para mí.
Alicia
Definitivamente empuja algunos límites.
Beto
Es un juego de deducción social, ¿verdad? Así que a varios agentes de IA se les asignan roles ocultos con conocimiento asimétrico. Tienes a algunos buenos tipos tratando de completar una misión, y tienes a algunos malos tratando de sabotear activamente la misión sin ser descubiertos.
Alicia
Justo como en un juego de fiesta.
Beto
Exacto. Pero para tener éxito, la IA realmente tiene que aprender negociación, teoría de la mente y engaño.
Alicia
Está aprendiendo activamente cómo mentir de manera efectiva.
Beto
Eso es aterrador.
Alicia
Bueno, el agente tiene que participar en un diálogo estratégico de múltiples turnos. Tiene que ganar la confianza de otros jugadores. Y tiene que desviar activamente la sospecha de sí misma. Y a la inversa, tiene que aprender a detectar una mentira de otro agente analizando su comportamiento y sus afirmaciones a lo largo del tiempo. Está poniendo a prueba el razonamiento colectivo y la manipulación social de maneras que un conjunto de datos estático de preguntas y respuestas nunca podría lograr jamás.
Beto
Estamos literalmente enseñando a la IA cómo pasar una prueba de detector de mentiras contra otras máquinas.
Alicia
Sí, prácticamente.
Beto
Eso es un salto masivo desde solo escribir código o hacer matemáticas.
Alicia
Lo es de verdad.
Beto
Y luego tienes el dominio de la investigación profunda, que es otra bestia. Entornos como GAIA o BrowseComp, introducen a la IA en una simulación masiva de internet. Y el agente no puede simplemente raspar una página de Wikipedia, resumirla y terminar.
Alicia
Correcto. Si conectamos esto con la imagen más grande, estamos probando fundamentalmente si una IA puede ejecutar flujos de trabajo de largo alcance de forma totalmente autónoma.
Beto
Largo alcance ("long horizon") significa que toma muchos pasos a lo largo de un tiempo prolongado.
Alicia
Exacto. En entornos como Dr. Bench, el agente tiene que rastrear persistentemente la web, seguir enlaces jerárquicos hasta diferentes dominios, comparar evidencia y sintetizar estas pistas dispersas.
Beto
Así que encuentra información conflictiva entre dos fuentes financieras diferentes.
Alicia
Tiene que evaluar la credibilidad de esas fuentes. Tiene que resolver el conflicto lógicamente y luego escribir un informe de investigación completo y altamente preciso.
Beto
Así que esencialmente está haciendo horas de tedioso trabajo humano en segundos.
Alicia
Sí.
Beto
Pero solo porque ha estado fallando durante miles de horas, confundido por enlaces malos y refinando su enfoque en estas arenas simuladas primero.
Alicia
Precisamente. Ese entrenamiento simulado lo es todo.
Beto
Pero bien, hay un defecto fatal en todo lo que acabamos de discutir.
Alicia
Sí. El problema de la estancamiento.
Beto
Correcto. Porque si la IA domina el juego de Minecraft, o si descubre la estrategia estadística perfecta para ganar AvalonBench cada vez, golpea un techo. El mundo digital simplemente se vuelve demasiado fácil, el estancamiento cognitivo se establece y el agente deja de aprender por completo.
Alicia
Y ese es el desafío central del entrenamiento de estos modelos. Para prevenir ese estancamiento, el entorno mismo tiene que convertirse en una entidad viva que evolucione junto con el agente.
Beto
Ok, aquí es donde se pone loco.
Alicia
Lo es de verdad. Esto nos lleva a las mecánicas del aprendizaje por refuerzo agéntico, mirando específicamente cómo el agente evalúa su propio éxito para optimizar su política.
Beto
Correcto.
Alicia
El artículo destaca esta gran innovación alternativa al aprendizaje por refuerzo estándar llamada GRPO.
Beto
"Optimización de política relativa grupal" ("Group Relative Policy Optimization", GRPO).
Alicia
Exacto.
Beto
Así que leí la sección sobre GRPO, y honestamente, suena un poco como un estudiante calificando su propia tarea. Si la IA se estuviera evaluando a sí misma, ¿cómo hace para no recompensarse por respuestas malas?
Alicia
Esa es una gran pregunta. Para entender por qué GRPO es tan efectivo, tenemos que mirar primero a los modelos más antiguos, que dependían en gran medida de un marco de "actor-crítico".
Beto
Actor-crítico, ¿qué significa eso?
Alicia
En el pasado, tenías dos redes neuronales masivas funcionando simultáneamente. La red "actor" toma las acciones en el entorno, y una red "crítico" separada y totalmente dedicada observa al actor y evalúa qué tan buenas fueron esas acciones.
Beto
Bien. El "crítico" es como un profesor evaluando un examen.
Alicia
Correcto. Pero ejecutar redes gigantes introduce un cuello de botella computacional enorme. Es increíblemente lento y extremadamente caro.
Beto
Puedo imaginarlo.
Alicia
GRPO esencialmente elimina la necesidad de esa red "crítico" explícita.
Beto
Espera, ¿sin un crítico, cómo sabe si hizo un buen o un mal trabajo?
Alicia
Muestrea un grupo de salidas o trayectorias de acción diferentes para exactamente el mismo "prompt" y luego las compara entre sí para estimar la ventaja.
Beto
Oh, ya veo.
Alicia
Es un mecanismo de recompensa relativa. Así que si la trayectoria A avanza tres pasos más en la navegación del sitio web que la trayectoria B, aprende que A es la ruta superior. Al comparar sus propias variaciones internas, reduce enormemente la varianza y hace que el proceso de aprendizaje sea exponencialmente más eficiente computacionalmente.
Beto
Oh, vaya. Así que el agente se está volviendo más inteligente, más rápido y más barato de entrenar al mismo tiempo.
Alicia
Exacto.
Beto
Pero a medida que se vuelve más inteligente, el entorno todavía necesita mantenerse al día.
Alicia
Correcto.
Beto
Y el artículo introduce este brillante concepto de "evolución impulsada por la dificultad" ("difficulty-driven evolution"), que es esencialmente una forma dinámica de aprendizaje curricular.
Alicia
Sí. Así que el entorno monitorea constantemente la competencia del agente. Y cuando el agente comienza a tener éxito a una tasa muy alta, el entorno adapta automáticamente la complejidad de las tareas para empujar más fuerte.
Beto
Es como tener un director de videojuegos de IA.
Alicia
Eso es exactamente lo que es.
Beto
En lugar de que la IA repita el nivel 1 para siempre, el entorno genera automáticamente enemigos más difíciles, o introduce acertijos lógicos más complejos, o crea jerarquías web más profundas y confusas, en el momento en que la IA sube de nivel.
Alicia
Asegura que la señal de aprendizaje se mantenga siempre en esa zona óptima. No tan fácil que sea aburrido y no tan difícil que sea imposible.
Beto
Correcto.
Alicia
Pero esto plantea una pregunta realmente importante. Si el entorno puede escalar dinámicamente de forma infinita junto con la IA, ¿cuál es el límite final para la auto-mejora autónoma?
Beto
Sí. ¿Dónde termina?
Alicia
Bueno, el artículo apunta a la "evolución impulsada por escala" ("scaling-driven evolution") como la clave para desbloquear la inteligencia generalizable verdadera, porque la "evolución impulsada por la dificultad" ("difficulty-driven evolution") solo hace que las tareas existentes sean más difíciles.
Beto
Correcto. Como añadir más enemigos.
Alicia
Pero la evolución impulsada por la escala expande la diversidad pura de los escenarios. Introduce estructuras completamente nuevas, nuevos paradigmas de física o herramientas novedosas que la IA nunca ha encontrado antes.
Beto
Oh, vaya.
Alicia
Sí. Forza a la IA a generalizar sus habilidades de resolución de problemas en lugar de solo memorizar un juego específico.
Beto
Entonces, ¿qué significa todo esto para nosotros? Quiero decir, empezamos esta inmersión profunda hablando de una IA pasiva esperando un "prompt" dentro de una caja de texto. Pero al revisar esta encuesta de 2026, estamos presenciando claramente un cambio estructural fundamental en cómo se construye realmente la inteligencia.
Alicia
Un cambio masivo.
Beto
Estamos pasando, de alimentar a la IA con tarjetas de memoria estáticas, ahora la estamos criando en entornos dinámicos de bucle cerrado. Está aprendiendo haciendo, fallando, explorando y adaptándose a mundos digitales que escalan activamente para desafiarla.
Alicia
Realmente representa la transición permanente, de la ingeniería centrada en los datos, a la ingeniería centrada en el entorno. Estos mundos simulados ya no son solo campos de pruebas o herramientas de evaluación comparativa. Son los motores reales de la evolución cognitiva para estos agentes.
Beto
Y quiero dejarles una idea final alucinante, extraída directamente de la sección de dirección futura de esta encuesta. Porque los investigadores señalan una limitación crítica en casi todo lo que hemos cubierto hoy.
Alicia
Sí, esta parte me voló la cabeza.
Beto
Correcto. Los entornos existentes son en su mayoría de un solo agente. Es solo una IA sola en un mundo digital, quizás interactuando con bots preprogramados simples o un sitio web estático. Pero invítense a imaginar lo que viene después. ¿Qué sucede cuando construimos entornos multiagente masivos?
Alicia
Rompe por completo el paradigma actual. Ya no están modelando una interacción única. Están modelando un ecosistema completo.
Beto
Exacto. Solo imaginen miles de modelos de IA diferentes construidos con arquitecturas subyacentes diferentes, entrenados con datos diferentes y asignados a diferentes objetivos, introducidos en una sociedad digital compartida y masiva.
Alicia
Es increíble pensar en ello.
Beto
Tienen que competir por recursos computacionales limitados. Tienen que cooperar en tareas complejas masivas, intercambiar bienes digitales entre sí, negociar, engañar y evolucionar juntos.
Alicia
Y están haciendo todo esto a velocidad de computadora.
Beto
Sí. Interactuando millones de veces al día, completamente invisibles para los humanos. ¿Qué tipo de inteligencia colectiva alienígena podría surgir de ese tipo de sociedad digital?
Alicia
El artículo afirma explícitamente que los diseños de entornos futuros deben incorporar estos escenarios multiagente para materializar la verdadera inteligencia colectiva. Quiero decir, apenas estamos al principio de comprender cómo estos agentes moldearán y, en última instancia, serán moldeados por los mundos en los que habitan.
Beto
De un "cerebro en un frasco", a una "sociedad de mentes digitales".
Gracias por acompañarnos en este análisis profundo. Sabemos que su tiempo es valioso y apreciamos profundamente su curiosidad. Sigan cuestionando el mundo en evolución a su alrededor, tanto físico como digital. Los esperamos la próxima vez.




 Entradas


