Mostrando entradas con la etiqueta codificación. Mostrar todas las entradas

sábado, 19 de septiembre de 2026

Informe JetBrains - IA en 2025

Este informe analiza la evolución del papel de la inteligencia artificial en la comunidad global de desarrolladores a partir de 2025. Si bien la mayoría de los ingenieros de software consideran la competencia en IA un requisito esencial para su futura carrera, su respuesta emocional sigue siendo una compleja mezcla de entusiasmo y ansiedad. El uso actual suele ser informal, y los desarrolladores utilizan principalmente herramientas como ChatGPT y GitHub Copilot para automatizar tareas repetitivas, como escribir código estándar o resumir documentación. A pesar de las importantes mejoras en la productividad, muchos profesionales expresan profunda preocupación por la calidad del código, la seguridad y la posible pérdida de sus habilidades técnicas. Además, aunque la experimentación está muy extendida, la mayoría de las organizaciones aún se encuentran en las fases piloto o de adopción parcial, en lugar de integrar completamente estas tecnologías en sus flujos de trabajo principales. En definitiva, los desarrolladores buscan un equilibrio en el que deleguen tareas rutinarias a la IA, manteniendo al mismo tiempo el control personal sobre la lógica compleja y la toma de decisiones creativas.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "JetBrains Developer Ecosystem Report 2025 - AI". Por JetBrains. Informe publicado con datos colectados de entrevistas de Abril a Junio de 2025.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Imagina por un segundo un mundo que está funcionando a 400 terabits por segundo.

Alicia
Lo cual es una cantidad de datos sencillamente incomprensible.

Beto
Correcto. Quiero decir, esa es la realidad de nuestra infraestructura digital global hoy en día.

Es este volumen masivo de datos que fluye a través de cables de fibra óptica, redes satelitales y granjas de servidores. Cada segundo.

Alicia
Sí, es una escala completamente diferente a la que estamos acostumbrados a pensar.

Beto
Y con información moviéndose tan increíblemente rápido y con sistemas tan complejos, se siente como si la inteligencia artificial ya hubiera tomado el control de todo tras bambalinas.

Alicia
Sí, totalmente. Es la suposición natural hacer. Estamos viendo constantemente todos estos titulares sobre, ya sabes, inteligencia artificial general.

Beto
Correcto. Lo de la IAG (Inteligencia Artificial General).

Alicia
Exacto. Experimentamos la pura velocidad del mundo tecnológico de primera mano. Y pinta esta imagen de una dominación instantánea total de la IA en el tejido mismo de nuestro software.

Beto
Pero hay una desconexión masiva porque asumimos que estos sistemas autónomos ya están escribiendo el código del futuro.

Pero la inmersión profunda de hoy nos lleva directamente a la sala de máquinas del mundo digital, y la realidad se ve completamente diferente.

Alicia
De verdad que lo es. Es fascinante.

Beto
Así que hoy estamos desglosando un nuevo informe muy completo de JetBrains. Se llama "Inteligencia Artificial, el estado del ecosistema de desarrolladores en 2025".

Alicia
Y nuestra misión para esta inmersión profunda es básicamente cortar todo ese reluciente "hype" tecnológico.

Beto
Porque hay muchísimo de eso.

Alicia
Estamos mirando la realidad práctica de cómo los ingenieros de software, las mismas personas que están construyendo activamente este mundo de 400 terabits por segundo, están usando la IA ahora mismo día tras día.

Beto
Estamos viendo cómo se sienten realmente al respecto de esta supuesta revolución de la IA y la codificación, y resulta que es sorprendentemente retrasada.

Así que, ya seas un desarrollador experimentado que vive en la línea de comandos, o simplemente alguien que es intensamente curioso sobre si los algoritmos van a venir por los trabajos de todo el mundo, quieres escuchar esto.

Alicia
Sí, esto te da una mirada de dentro real a esta fascinante relación contradictoria entre los creadores humanos y su asistencia artificial.

Developer_AI_2025_Productivity_Report_1024.png
El Estado de Desarrolladores de IA 2025: Productividad vs Control

Beto
Así que empecemos con la expectativa base, ¿correcto? Porque hay una gran brecha entre lo que los desarrolladores saben que está por venir y cómo están actuando realmente hoy.

Alicia
El contraste es genuinamente marcado. El informe de JetBrains. Quiero decir, lo expusieron claramente al servir a decenas de miles de desarrolladores a nivel mundial.

Beto
Decenas de miles.

Alicia
Sí, una muestra enorme y un asombroso 83% de ellos anticipan que la competencia en IA se convertirá en un requisito laboral obligatorio.

Beto
Okay, 83%, eso es, quiero decir, un acuerdo casi universal.

Alicia
Correcto. Ven la IA no solo como una moda pasajera, sino como la base ineludible de su profesión en el futuro.

Beto
Pero ver un número como el 83% naturalmente asumirías que todos están marchando entusiastamente en sincronía para adoptar estas herramientas, ¿verdad?

Alicia
Sí.

Beto
Pero el panorama emocional mapeado en este informe está increíblemente fracturado. No parece una fuerza laboral unificada en absoluto.

Alicia
No, ni de cerca. Parece una industria lidiando con un vaivén emocional (whiplash). Honestamente. Cuando se les preguntó a los desarrolladores cómo se sentían acerca del creciente papel de la IA, la respuesta está dividida casi exactamente por la mitad.

Beto
Lo cual es salvaje.

Alicia
Correcto. Por un lado, tienes el optimismo: como el 50% está esperanzado y el 45% está emocionado. Y eso se alinea con esa expectativa de un futuro obligatorio.

Beto
Claro. Tiene sentido. Pero luego miras la otra mitad de la sala.

Alicia
Sí, exactamente. Porque simultáneamente el 44% de los desarrolladores están inciertos. El 23% está activamente ansioso. Y el 15% está directamente asustado por lo que esta tecnología significa para su trabajo diario.

Beto
Quiero decir, tienes un trozo masivo de la fuerza laboral que sabe que esta tecnología dictará pronto su capacidad para pagar su alquiler, y sin embargo, casi la mitad está incierta y una cuarta parte profundamente ansiosa.

Alicia
Es una dinámica psicológica muy intensa.

Beto
Y esta fricción emocional parece conducir directamente a lo que creo que es la estadística de comportamiento más sorprendente de esta sección. El informe señala explícitamente que el uso de la IA no está sistematizado en absoluto. Se está utilizando abrumadoramente a la fuerza.

Alicia
Correcto. Están abriendo estas herramientas sobre la marcha, solo descubriendo los "prompts" y capacidades al vuelo.

Beto
Lo cual me cuesta mucho darle sentido desde un punto de vista profesional. Permíteme hacer una analogía aquí. Si digamos que el 83% de los chefs profesionales supieran que una nueva clase de horno de inducción súper específico y totalmente nuevo va a ser absolutamente obligatorio para mantener sus trabajos el próximo año.

Alicia
Se estarían preparando para ello.

Beto
Exacto. No simplemente estarían presionando botones al azar durante la hora pico de una cena de viernes por la noche. Estarían tomando clases formales. Los grupos de restaurantes tendrían seminarios de capacitación obligatorios, pero los desarrolladores son literalmente las personas más orientadas a sistemas técnicos en la tierra. Simplemente están improvisando.

Alicia
Bueno, si miramos las realidades estructurales del sector tecnológico ahora mismo, esa conducta de improvisar tiene perfecto sentido.

Beto
¿De verdad? ¿Cómo es eso?

Alicia
Porque refleja una industria atrapada en medio de una transición caótica. Las herramientas mismas están evolucionando tan rápidamente. Quiero decir, estamos viendo actualizaciones de modelos importantes y paradigmas completamente nuevos cayendo literalmente cada semana.

Beto
Correcto. Se siente como si hubiera un gran avance cada martes.

Alicia
Exacto. Y ese ritmo está superando considerablemente las políticas corporativas, las directrices de recursos humanos y los programas de capacitación formalizados. Las empresas no pudieron escribir un manual estandarizado, incluso si lo hubieran querido.

Beto
Porque la interfaz y las capacidades simplemente cambiarían antes de que la tinta se seque en el manual.

Alicia
Precisamente. Eso deja a los desarrolladores para que lo descubran por su cuenta, sobre la marcha, todo mientras todavía se espera que cumplan con sus plazos de producción súper exigentes habituales.

Beto
Vaya. Así que es básicamente un escenario del Salvaje Oeste. Tienes esa emoción que mencionamos, luchar de frente contra la ansiedad cada vez que un desarrollador abre su editor de código.

Alicia
Porque está navegando por territorios inexplorados sin un mapa.

Beto
Así que si no hay un plan de estudios corporativo oficial, imagino que los desarrolladores están llevando las herramientas de IA de consumo que usan en casa directamente a sus flujos de trabajo.

Alicia
Más o menos.

Beto
Entonces, ¿qué están tomando realmente, porque las cifras de adopción mismas, a pesar de toda esa ansiedad, son enormes?

Alicia
La penetración es innegable. El informe muestra que el 82% de los desarrolladores están usando regularmente alguna forma de herramienta de IA para codificar y desarrollar. Y el 78% están usando al menos un asistente de codificación de IA específico, o un editor de código integrado.

Beto
Realmente quiero desglosar este panorama porque es una mezcla salvaje de chatbots de propósito general, y luego de software empresarial altamente especializado.

Alicia
Es una mezcla muy interesante.

Beto
Sí, porque ChatGPT está liderando el pelotón con un 58%. Luego tienes a GitHub Copilot justo detrás con un 48%, seguido por Cursor con un 28%, la asistente de IA de JetBrains con un 15%, DeepSeek con un 12% y luego un puñado de otros como Google Gemini y Anthropic Claude.

Alicia
Correcto.

Beto
Pero ¿por qué estamos viendo a ChatGPT de propósito general liderando sobre herramientas que están construidas específicamente para la codificación?

Alicia
Honestamente, se reduce a la fricción y la familiaridad. Quiero decir, ChatGPT es una interfaz independiente. Haces una pregunta. Obtienes una respuesta. Eso es lo que la gente conoce.

Beto
Claro, es el Kleenex de la IA ahora mismo.

Alicia
Exacto. Pero el panorama está cambiando muy rápidamente hacia una integración profunda. Toma, por ejemplo, Cursor, que está en un 28%.

Beto
El editor de IA.

Alicia
Sí, Cursor es fascinante porque no es solo una ventana de chat que mantienes abierta en un segundo monitor. Es un editor de código completo construido desde cero en torno a la IA.

Beto
Oh, vaya.

Alicia
Sí, puede leer toda tu base de código a la vez manteniendo el contexto de miles de archivos, en lugar de solo el archivo único en el que estás escribiendo.

Beto
Así que tienen este increíble conjunto de herramientas a su alcance.

Alicia
Sí.

Beto
Pero, ¿cómo están desplegando ese poder realmente?

Alicia
Bueno, esto nos lleva a lo que creo que es la perspectiva crucial de todo el informe. JetBrains acuñó esta brillante frase que encapsula perfectamente la dinámica. Dijeron: "A veces, la IA simplemente lava los platos".

Beto
"Lava los platos".

Alicia
Sí, los desarrolladores están delegando deliberadamente y de manera consciente las tareas mundanas y repetitivas a estas herramientas de IA. Estamos hablando de tareas como escribir código "boilerplate".

Beto
Okay, definamos "boilerplate" por un segundo porque es un término que se usa mucho.

Básicamente estamos hablando de la plomería estructural, ¿correcto? Como el código repetitivo que tienes que escribir para configurar una conexión de base de datos o una interfaz de usuario antes de que puedas acceder a las características únicas de tu aplicación específica.

Alicia
Eso es exactamente eso. Es necesario para que el software funcione, pero requiere como cero resolución creativa de problemas.

Beto
Solo mecanografía tediosa.

Alicia
Correcto. Y más allá del "boilerplate", están haciendo que la IA busque en internet información de sintaxis, convierta código de un lenguaje de programación a otro, escriba comentarios o documentación.

Beto
A nadie le gusta hacer eso.

Alicia
A nadie. Y resume cambios recientes hechos por otros ingenieros, tareas administrativas tediosas.

Beto
Pero, quiero decir, la otra cara de esto es aún más reveladora porque el informe enumera explícitamente las tareas que los desarrolladores inequívocamente no quieren que la IA se encargue de hacer.

Alicia
Y esa lista es muy reveladora.

Beto
Lo es:

  • No quieren que la IA se comunique a través de correos electrónicos o mensajes profesionales.
  • No quieren que realice acciones en la terminal o línea de comandos.
  • No quieren que depure problemas complejos.
  • No quieren que intente comprender profundamente toda la arquitectura.
  • Y sobre todo, no quieren que escriba código de lógica de aplicación.

Alicia
Correcto. Están dibujando deliberadamente un límite muy estricto, casi defensivo, alrededor del núcleo de su profesión.

Beto
Suena exactamente como contratar a un interno supergenio, como alguien que supuestamente ha leído todos los manuales en los libros de texto del mundo.

Alicia
Sí, el pasante más inteligente de todos.

Beto
Correcto. Pero solo les dejas organizar la archivadora, escribir resúmenes de tus reuniones y buscar el café porque fundamentalmente no confías en que hablen con tus clientes o tomen decisiones financieras.

Alicia
Esa es una manera muy precisa de verlo. Y resalta todo el aspecto psicológico que está en juego aquí.

Beto
El problema de la confianza.

Alicia
Exacto. La lógica de aplicación, esas reglas de negocio específicas que dictan cómo funciona realmente una aplicación, como cómo calcula un tramo de impuestos específico o procesa un permiso de usuario único. Ese es el núcleo creativo de la ingeniería de software.

Beto
Eso es el trabajo de verdad.

Alicia
Correcto. Los desarrolladores están haciendo una elección consciente para descargar la fricción, el lavaplatos, mientras protegen ferozmente el arte de su profesión.

Beto
Pero mantener al interno en turno de café sugiere una grave falta de confianza en sus capacidades reales. Y este límite tiene perfecto sentido cuando miramos las ansiedades específicas que mencionaste antes.

Alicia
La inquietud es altamente cuantificable según el informe, que encontró que solo el 6% de los desarrolladores no tiene preocupaciones sobre la codificación de IA.

Beto
Lo que significa que el 94% está activamente preocupado por que algo salga mal.

Alicia
Sí. Y sus mayores miedos son profundamente pragmáticos. El 58% está preocupado por la calidad fundamental del código generado. El 44% está preocupado por la limitada comprensión de la IA sobre la lógica.

Beto
Y la seguridad compleja también, me imagino.

Alicia
Oh, definitivamente. El 39% está muy preocupado por la privacidad y la seguridad. Saben que un motor de predicción estadística, que es en última instancia lo que es un modelo de lenguaje grande (LLM), no puede adivinar de manera confiable la lógica empresarial única sin hacer suposiciones peligrosas.

Beto
Así que no confían en el producto de trabajo real del interno y están aterrorizados de que el interno pueda filtrar accidentalmente secretos de la empresa si le da el "prompt" equivocado.

Alicia
Exacto. Pero más allá de esos miedos técnicos inmediatos, el informe descubre este elemento increíblemente humano que encontré fascinante. El 29% de los desarrolladores sienten el efecto negativo que tendrá la IA en sus propias habilidades de codificación y desarrollo.

Beto
Vaya.

Alicia
Y el 26% se preocupa por la seguridad laboral a largo plazo.

Beto
Esas dos estadísticas, temer por las habilidades y temer por el trabajo, simplemente parecen estar profundamente entrelazadas en esta industria.

Quiero centrarme en ese 29% que teme perder sus habilidades.

Alicia
Sí, es una gran preocupación.

Beto
¿Estamos mirando un futuro donde los desarrolladores se vuelvan tan dependientes de la IA para los bloques de construcción básicos que literalmente olviden cómo codificar desde cero?

Alicia
Es una posibilidad real.

Beto
Me recuerda un poco a cómo nadie recuerda los números de teléfono de su mejor amigo porque los teléfonos inteligentes externalizan esa memoria por nosotros. ¿Es ese tipo de erosión cognitiva?

Alicia
La analogía del número de teléfono capta la idea básica de externalizar la memoria, sin duda. Pero con la codificación, el riesgo es mucho más estructural en el cerebro mismo.

Beto
¿Qué quieres decir?

Alicia
Bueno, codificar no es meramente escribir sintaxis, ¿correcto? Es fundamentalmente una forma de pensar. Requiere el razonamiento espacial y secuencial de la mente.

Beto
Como el ajedrez 3D.

Alicia
Sí, tienes que mantener la arquitectura de un sistema masivo en tu cabeza para entender cómo cambiar una variable en el archivo A afecta a una base de datos en el archivo Z.

Beto
Así que es realmente un músculo mental.

Alicia
Es absolutamente un músculo mental. Si constantemente descargas la lógica fundamental a una IA, el miedo es que este músculo cognitivo específico comience a atrofiarse.

Beto
Eso tiene todo el sentido.

Alicia
Los desarrolladores se preocupan profundamente por la fiabilidad de su código, pero también se preocupan profundamente por preservar su sentido de competencia como profesionales. No están solo asustados de que una máquina les quite sus trabajos. Están aterrorizados de perder su propio dominio del oficio.

Beto
Porque sin esa comprensión arquitectónica profunda, ya no son ingenieros. Simplemente se convierten en algo como "supervisores de IA".

Alicia
Precisamente. Ingenieros de "prompt", esperando que la máquina lo haga bien.

Beto
Eso cambia fundamentalmente cómo veo toda esta dinámica. Quiero decir, están manteniendo a la IA con cautela a distancia para proteger sus propias habilidades cognitivas y garantizar la integridad estructural de sus productos.

Alicia
Sí, es una táctica de supervivencia, en cierto modo.

Beto
Pero tengo que oponerme a las matemáticas aquí porque todavía tenemos este ciclo de "hype" masivo, prometiendo una eficiencia sin precedentes. Si los desarrolladores están restringiendo genuinamente a la IA solo a lavar los platos, las ganancias de eficiencia no pueden ser tan altas, ¿verdad?

Solo puedes ahorrar tanto tiempo escribiendo código "boilerplate" antes de que llegues a un muro.

Alicia
Bueno, aquí es donde golpeamos lo que podemos llamar "la paradoja de la productividad", porque a pesar de mantener a la IA en el turno de lavar platos, las ganancias individuales reportadas son innegables.

Beto
Quiero decir, los números en el informe son bastante asombrosos: el 82% de los desarrolladores que usan estas herramientas dicen que ahorran más de una hora a la semana.

Alicia
Lo cual suma.

Beto
Sí, lo hace, pero luego miras a los usuarios avanzados: el 13% de la fuerza laboral está ahorrando ocho horas o más por semana.

Alicia
Un día completo de trabajo entero.

Beto
Sí, un día completo de trabajo que les devuelven puramente por automatizar lo aburrido.

Alicia
Los beneficios reportados se alinean perfectamente con descargar la fricción. Como el 64% reporta una mayor productividad general. El 60% apunta específicamente a la finalización más rápida de tareas repetitivas.

Beto
Y menos tiempo buscando cosas, ¿verdad?

Alicia
Exacto. El 52% dedican significativamente menos tiempo a buscar información de sintaxis o documentación. El "boilerplate" y la documentación puede que no sea el arte de la codificación, pero consumen una gran parte del tiempo de un desarrollador.

Beto
Así que el interno genio que organiza la archivadora está ahorrando a la plantilla sénior meses de este tiempo. Pero bueno, si yo fuera la CEO y viera datos que prueban que el 13% de mi personal de ingeniería podría obtener un día libre de trabajo cada semana, lo implementaría a nivel mundial mañana. Quiero decir, lo haré obligatorio. Pero el informe de JetBrains dice que las empresas absolutamente no están haciendo eso.

Alicia
No, han retrasado gravemente el despliegue corporativo, como la integración sistémica de estas herramientas en los flujos de trabajo oficiales de la empresa. No coincide en absoluto con las ganancias individuales de productividad.

Beto
El informe literalmente pregunta: "si no ahora, ¿cuándo?".

Alicia
Sí, mira las etapas de integración empresarial: encontraron que el 20% de las empresas tienen absolutamente cero adopción. Ninguna.

Beto
Ni siquiera lo están probando.

Alicia
Correcto. Otro 17% solo están en la etapa exploratoria, lo que significa solo leer artículos de investigación. El 25% están en etapas piloto limitadas. El 29% tienen adopción parcial.

Beto
Okay, así que mucha experimentación.

Alicia
Mucha experimentación y solo una fracción minúscula, solo el 9% de las empresas tienen lo que el informe categoriza como adopción extensa, donde la IA está oficialmente incrustada en mi trabajo. La mayoría de los flujos de trabajo de desarrollo.

Beto
Eso no tiene sentido financiero para mí tener solo adopción extensa al 9% cuando podrías estar recuperando millones de horas de trabajo a nivel mundial. Eso está dejando una cantidad increíble de dinero sobre la mesa.

¿Cuál es el cuello de botella aquí? Porque no puede ser la tecnología si los individuos ya la están usando con éxito.

Alicia
El cuello de botella es la responsabilidad sistémica.

Sí, el informe de JetBrains usa una frase brillante para resumir la duda corporativa específica: "La IA vino, la IA vio, la IA no conquistó".

La integración empresarial requiere superar todos los miedos individuales que discutimos, pero multiplicados a una escala corporativa masiva.

Beto
Cuéntame sobre la mecánica de ese riesgo. ¿Por qué un despliegue empresarial es mucho más peligroso que digamos que un desarrollador individual simplemente use Copilot en su portátil?

Alicia
Bueno, se reduce a cómo se implementa el software moderno. La mayoría de las empresas usan lo que se llama una tubería de CI/CD.

Beto
Integración Continua/Entrega Continua.

Alicia
Correcto. Es un sistema automatizado que toma código, lo prueba y lo publica en vivo para los usuarios.

Si un desarrollador individual prueba el script localmente y la IA alucina un fallo, el desarrollador lo detecta y lo corrige. Es un error localizado.

Beto
Pero si la empresa incrusta oficialmente agentes de IA en la tubería CI/CD misma, ...

Alicia
Entonces tienes un problema real. Si una IA alucina una pieza de lógica incorrecta, digamos que inventa una variable que no existe o malinterpreta fundamentalmente un protocolo de seguridad y ese código se publica automáticamente, podría colapsar una pasarela de pago o exponer datos de usuario.

Beto
Vaya.

Alicia
Sí, las apuestas son existenciales para la empresa.

Beto
Así que una sola alucinación podría literalmente derrumbar una parte de esa infraestructura de 400 terabytes por segundo de la que hablamos al principio.

Alicia
Fácilmente. Y más allá de los riesgos mecánicos, tienes enormes preocupaciones de propiedad intelectual.

Beto
Correcto. ¿Quién es dueño del código?

Alicia
Sí. El 13% de las empresas citan la propiedad intelectual como un obstáculo importante. Si pegas código propietario de una empresa en un modelo público, podrías estar literalmente entrenando la IA de un competidor.

Beto
Eso es un pensamiento aterrador para un CEO.

Alicia
Y a la inversa, si la IA genera código que memorizó de una fuente protegida por derechos de autor, tu empresa podría ser demandada por infracción.

Luego tienes los costos, que también son citados por el 13%. Las licencias empresariales que realmente ofrecían garantías de privacidad de datos son increíblemente caras a escala. Finalmente, el 11% cita una mala integración con sus entornos de desarrollo altamente complejos existentes.

Beto
Así que las velocidades ad hoc individuales simplemente no se traducen en una integración corporativa sistémica segura. El desarrollador puede moverse rápido y romper cosas en su pequeño sandbox, pero la empresa tiene que asegurarse de que todo el edificio no colapse.

Alicia
Precisamente. La IA está siendo probada en todas partes, pero ese salto a la integración total sigue siendo realmente raro. Está estancado en pilotos y despliegues parciales porque la responsabilidad de incrustarla totalmente en la lógica empresarial central sigue siendo demasiado alta para que la mayoría de los consejos de administración puedan soportarla.

Beto
Okay, para recapitular este increíble viaje por la sala de máquinas del mundo tecnológico, hemos aprendido que los desarrolladores, las personas más cercanas al metal, saben sin duda que la IA es su futuro.

Alicia
Lo saben.

Beto
Están usando activamente una gran variedad de herramientas, desde chatbots generales hasta editores integrados, para ahorrar enormes cantidades de tiempo en las tareas aburridas y repetitivas, pero están relegando deliberadamente y conscientemente esa IA al turno de "lavar los platos".

Alicia
Impulsados por miedos profundos e increíblemente válidos sobre la calidad del código, la seguridad empresarial y la amenaza muy real de sus propias habilidades cognitivas erosionarse con el tiempo.

Beto
Y como resultado de toda esa fricción, la adopción a nivel empresarial tan publicitada está estancada en un mísero 9%. La revolución está esencialmente en pausa, mientras todos descubren cómo usar realmente esta nueva tecnología sin quemar el restaurante o exponer a la empresa a demandas masivas.

Alicia
Es una realidad de comprobación sobria sobre el estado de la industria, sin duda.

Y trae un pensamiento final que creo que todos realmente necesitamos considerar independientemente del campo en el que trabajemos.

Beto
¿De qué se trata?

Alicia
Bueno, estos desarrolladores son los arquitectos de nuestra era digital. Entienden las mecánicas subyacentes de esta tecnología mejor que nadie en el planeta. Y si son tan reacios a dejar que la IA tome el control de la lógica compleja, si están manteniendo deliberadamente a la IA en el rol de lavaplatos para proteger sus propios músculos mentales y mantener su control. ¿Qué significa eso para el resto de nosotros?

Beto
Oh, ese es un gran punto.

Alicia
Correcto. A medida que la IA entra en nuestras profesiones menos técnicas, derecho, escritura, gestión, educación, ¿tendremos la sabiduría para proteger ferozmente nuestra propia lógica de aplicación? ¿O simplemente entregaremos las llaves ciegamente y dejaremos que el músculo se atrofie?

Beto
Eso es algo para que todos nosotros lo evaluemos críticamente mientras navegamos por este panorama en rápida transformación. Si estás escuchando esto durante tu viaje o en tu escritorio, tómate un momento hoy para pensar en qué tareas estás delegando activamente en tu propia vida. Y más importante aún, qué partes fundamentales de tu propio oficio necesitas proteger ferozmente.

Alicia
Es una pregunta importante de hacer.

Beto
Porque allí afuera, en ese mundo que corre a 400 terabits por segundo, las mismas personas que construyen los sistemas automatizados se están aferrando a su experiencia humana tan fuerte como pueden.

Muchas gracias por acompañarnos en esta inmersión profunda en el informe del ecosistema de desarrolladores de JetBrains. Hasta la próxima.

sábado, 4 de julio de 2026

Educación en ciencias de la computación para el futuro de la IA generativa


Este informe resume los Talleres NUS-Google, que investigaron el profundo impacto de la IA generativa en la educación universitaria en ciencias de la computación. El informe destaca un cambio crucial a medida que la IA automatiza las tareas de codificación básicas, lo que requiere una transición de la enseñanza de la sintaxis manual a la priorización del diseño y la verificación de sistemas de alto nivel. Profesores y estudiantes abogan por un currículo modernizado que integre competencias propias de la IA —como el juicio ético y la especificación precisa— a lo largo de los cuatro años de la carrera. Una propuesta clave es la estrategia de "migas de pan", que incorpora pequeños ejercicios prácticos en los cursos existentes para reforzar habilidades centradas en el ser humano, como el pensamiento crítico y la responsabilidad. En última instancia, las fuentes argumentan que, si bien la IA es una poderosa herramienta de colaboración, las universidades deben centrarse en los principios fundamentales para garantizar que los graduados sigan siendo competitivos en un mercado cada vez menor para los puestos junior tradicionales. Para apoyar esta evolución, los autores abogan por una reforma institucional, que incluya mejores incentivos para el profesorado y evaluaciones innovadoras basadas en procesos.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema:"Reshaping Undergraduate Computer Science Education in the Generative AI Era". Por AI4SG Lab, NUS School of Computing, SoC Horizons Office, y Google. Publicado el 11 de Junio de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Recuerdas cuando aprender a programar se consideraba la jugada de carrera definitiva a prueba de futuro?

Alicia
Oh, absolutamente. El billete dorado.

Beto
Correcto. Durante los últimos 20 años, el guion solo se había escrito en piedra. Aprendías Python o Java. Dominabas la sintaxis y de repente tenías este camino garantizado hacia la clase media.

Alicia
Eres indispensable.

Beto
Exacto. La promesa era que, si podías escribir código, estabas listo.

Pero ahora estamos presenciando una ruptura fundamental en esa realidad. Quiero decir, ¿qué pasa cuando la inteligencia artificial se vuelve tan increíblemente buena para escribir código que simplemente, simplemente destroza cómo aprendemos la ciencia de la computación en primer lugar?

Alicia
Estamos presenciando un cambio fundamental en la base de una profesión importante en tiempo real. Y es un momento fascinante, aunque algo aterrador.

Beto
Aterrador es la palabra.

Alicia
Sí. Porque nos gusta pensar en la ingeniería de software como esta misma estructura, casi una progresión matemática, ¿verdad?, de novato a maestro. Pones tus miles de horas y subes la escalera.

Beto
Haces el trabajo.

Alicia
Correcto. Pero de repente, las herramientas que la industria construyó para hacerse más rápida están literalmente tirando la escalera detrás de la próxima generación.

Beto
Y ese es el núcleo de nuestro análisis profundo de hoy. Estamos viendo una hoja de ruta sobre cómo sobrevivir a este cambio. Tenemos un importante documento técnico de 2026 que actúa como, bueno, básicamente una guía de supervivencia para la ciencia de la computación.

Alicia
Sí. Una colaboración masiva.

Beto
Exacto. Se titula "Re-shaping Undergraduate Computer Science Education in the Generative AI era" ("Remodelando la Educación de Ciencias de la Computación de Pregrado en la era de la IA Generativa"). Y salió de los talleres de Google del NUS.

Así que eso es el laboratorio AI4 SG en la National University of Singapore, junto con Google.

Alicia
Reunieron a profesores, estudiantes y expertos de la industria de todo el mundo.

Beto
Porque la academia se está dando cuenta de que podrían estar graduando estudiantes completamente desempleables si no cambian de rumbo de inmediato.

Alicia
La urgencia aquí realmente no puede exagerarse. Vamos a explorar cómo herramientas de IA como Claude Code, OpenAI Codex, en Google Gemini, están automatizando sistemáticamente las tareas de nivel de entrada de la industria del software.

Beto
Simplemente las están borrando.

Alicia
Más o menos. Así que la misión aquí es entender por qué las universidades tienen que abandonar urgentemente la enseñanza de sintaxis escrita, la gramática básica de la codificación. Y en su lugar, empezar a enseñar razonamiento arquitectónico de alto nivel y verificación de IA.

AI-native_CS_Edu_blueprint_1024.png
El nuevo plan maestro para la enseñanza de la informática basada en la IA.

Beto
De acuerdo. Desglosemos esto comenzando por lo que la industria llama "el fin del aprendizaje de los ingenieros junior".

Alicia
Un gran lugar para empezar.

Beto
Para entender por qué la academia está sonando la alarma, realmente tenemos que mirar lo que significó ser un recién graduado históricamente.

Alicia
Correcto. Veamos el modelo antiguo. Cuando te graduaste con un título en ciencias de la computación hace cinco años, no entrabas simplemente en una gigante tecnológica y diseñabas la arquitectura de "back-end" para una plataforma global.

Beto
Destruirías todo.

Alicia
Exacto. Estabas en el aprendizaje. Pasaste tus primeros años haciendo tareas de complejidad menor.

Beto
Correcto.

Alicia
Arreglaste errores molestos y simples. Escribiste código repetitivo e inmutable, texto fundacional que simplemente tiene que estar allí para que un programa funcione. Escribiste pruebas unitarias. Documentaste lo que otros habían construido.

Beto
Era el trabajo sucio básico.

Alicia
Sí.

Beto
Pero era un trabajo sucio necesario. Era cómo construías la memoria muscular. Tenías las repeticiones. Empezabas a entender cómo funcionan realmente las bases de código enormes y dispersas.

Alicia
Y eventualmente alguien confiaba en ti para tomar una gran decisión.

Beto
Correcto. Pero ahora ...

Alicia
La IA está tomando esas mismas tareas. Y su competencia está creciendo rápidamente. La IA se ha convertido efectivamente en el ingeniero junior.

Beto
Vaya.

Alicia
Y los investigadores no adivinaron esto. Miraron datos de nómina de millones de trabajadores estadounidenses para ver si esto era exageración o realidad. Y citan este estudio de Brynjolfsson y colegas, analizando datos de ADP.

Beto
¿Qué encuentran?

Alicia
Encontraron una disminución del empleo del 16% para desarrolladores de software de entre 22 y 25 años, desde finales de 2022.

Beto
Espera, ¿un 16%?

Alicia
Sí, un 16%. Esto comparado con ocupaciones que no están expuestas a la IA.

Beto
Una contracción del 16% para desarrolladores de nivel inicial es masiva. Y claro, quiero decir, los congelamientos de contratación post-pandemia juegan un papel, pero la tendencia es completamente innegable.

Alicia
Las empresas se están dando cuenta de que pueden emparejar simplemente a un desarrollador experimentado con una herramienta de IA y saltarse la necesidad de un ejército de jóvenes de 23 años.

Beto
Pero espera, tengo que oponerme a la lógica a largo plazo aquí. Si la IA está haciendo todo el trabajo de nivel inicial, ¿cómo puede alguien convertirse en ingeniero senior?

Alicia
Esa es la pregunta multimillonaria.

Beto
Se siente como si estuviéramos pidiendo a un estudiante que diseñe un rascacielos cuando nunca se le ha permitido siquiera mezclar cemento o colocar un solo ladrillo. Si nunca escribes el código básico, ¿cómo sabes cómo se ve un sistema estructuralmente sólido?

Alicia
Has tocado la crisis exacta que la industria está enfrentando ahora mismo. El cuello de botella del desarrollo de software ha cambiado fundamentalmente.

Beto
Correcto.

Alicia
Durante décadas, la parte más difícil, el cuello de botella, fue la producción de código. Era el trabajo manual puro de traducir lógica humana a sintaxis de máquina.

Beto
Simplemente escribirlo todo.

Alicia
Correcto. Pero ese trabajo manual ya no es el obstáculo principal. El nuevo cuello de botella es la arquitectura del sistema, la integración y la verificación.

Beto
Saber qué construir.

Alicia
Exacto. Saber qué construir y poder demostrar matemáticamente que la IA lo construyó correctamente.

Beto
Aquí es donde se pone realmente interesante. Porque si la IA está haciendo todo el trabajo junior tedioso, la suposición natural es que debe estar haciendo que todos los que la usan sean increíblemente rápidos.

Alicia
Oh, absolutamente.

Beto
Quiero decir, el ingeniero senior con un copiloto de IA debería ser un superhéroe, ¿verdad? Simplemente produciendo aplicaciones impecables en una tarde. Pero los datos revelan esta masiva "ilusión de productividad", junto con algunos costos increíblemente ocultos.

Alicia
El gran hype definitivamente sugirió esa narrativa de superhéroe. El documento técnico menciona algunos estudios tempranos como Peng y colegas, donde los desarrolladores eran un 55% más rápidos al usar IA en tareas simples y aisladas.

Beto
Como construir un servidor web básico.

Alicia
Sí, y un experimento controlado.

Beto
Un "experimento controlado" es la frase clave allí. Porque cuando los investigadores miraron entornos complejos del mundo real, la capa de superhéroe se desmoronó por completo.

Alicia
Realmente lo hizo.

Beto
Había esta prueba de Becker, un ensayo controlado aleatorio, que dio a desarrolladores de código abierto experimentados tareas reales usando herramientas de IA. Y esos desarrolladores tardaron en un 19% más en completar sus tareas, en comparación con un grupo de control que no se les permitió usar IA.

Alicia
Y el aspecto psicológico de ese estudio es simplemente fascinante.

Beto
Es salvaje.

Alicia
Cuando encuestaron a esos mismos desarrolladores que tardaron más, los desarrolladores creyeron firmemente que eran un 20% más rápidos.

Beto
Sentían que estaban volando, pero en realidad estaban gateando. ¿Por qué sucede eso?

Alicia
Bueno, generar código simplemente se siente increíblemente productivo.

Beto
Sí, supongo que sí.

Alicia
Ver 20 líneas de texto aparecer en tu pantalla en dos segundos te da este masivo golpe de dopamina. Sientes que estás trabajando muchísimo.

Beto
Pero tenemos que mirar la calidad de lo que se está generando, ¿verdad?

Alicia
Exacto. Los investigadores también examinan lo que sucede cuando los proyectos de código abierto adoptan herramientas de IA de forma amplia, como en el estudio de He y colegas sobre la adopción de Cursor.

Beto
Cursor siendo un popular editor de código de IA.

Alicia
Correcto. Encontraron una aceleración inicial a corto plazo, pero casi inmediatamente condujo a un aumento sustancial y persistente en la complejidad del código.

Beto
Oh, wow.

Alicia
Y un pico masivo en las advertencias ("warnings") de análisis estático.

Beto
Y para aquellos de ustedes que no viven en el mundo de la codificación, las advertencias de análisis estático son básicamente las alarmas de incendios automatizadas que suenan cuando el código está estructurado mal, o, es vulnerable a errores.

Alicia
Sí, son malas noticias.

Beto
Así que estaban acumulando una deuda técnica masiva, lo que significaba que estaban escribiendo código desordenado y enmarañado como espagueti que costaría una fortuna en tiempo, dinero y esfuerzo desenredarlo más tarde.

Alicia
Esto plantea una pregunta importante. ¿Por qué los codificadores experimentados están siendo ralentizados por una herramienta diseñada para acelerarlos?

Beto
Correcto.

Alicia
Vuelve a nuestra metáfora del ingeniero junior. La IA actúa como un aprendiz increíblemente ansioso e hiperactivo. Escribe a la velocidad de la luz, pero carece completamente de conciencia espacial.

Beto
Correcto. Veamos.

Alicia
Puede escribir una solución brillante de 20 líneas para un problema local hiperespecífico, pero no tiene comprensión de cómo esas 20 líneas rompen la arquitectura más amplia de todo el paquete de software.

Beto
Es como añadir una habitación nueva, pesada y hermosa al segundo piso de una casa, pero olvidarse por completo de comprobar si la cimentación del primer piso puede soportar el peso.

Alicia
Esa es una analogía perfecta.

Beto
Así que el ingeniero senior pasa todo su tiempo desenredando, depurando y arreglando los varios errores arquitectónicos que la IA acaba de introducir ciegamente.

Alicia
Lo que requiere una supervisión humana rigurosa y agotadora. Honestamente, leer y depurar el código desordenado de otra persona es a menudo mucho más difícil que simplemente escribirlo tú mismo desde cero.

Beto
Así que si los profesionales experimentados con años de experiencia están luchando por gestionar la calidad del código de IA, ¿qué demonios está haciendo esta tecnología a un estudiante de 19 años que solo está tratando de aprender los conceptos básicos absolutos de la ciencia de la computación?

Alicia
Está creando una trampa cognitiva devastadora.

Beto
Sí, puedo imaginarlo.

Alicia
Para medir esto, el estudio de Bastani et al realizó un ensayo controlado aleatorio con casi mil estudiantes.

Beto
Una muestra enorme.

Alicia
Sí, y cuando les dio a estos estudiantes acceso sin restricciones a la IA generativa, como GPT-4, su rendimiento en problemas de práctica y tareas escolares se disparó en un 48%.

Beto
Parecían prodigios absolutos en la tarea.

Alicia
Realmente lo fueron. Pero cuando les quitaron la IA para los exámenes reales, ...

Beto
... aquí viene ...

Alicia
Esos mismos estudiantes sufrieron una disminución del 17% en sus puntuaciones en comparación con las líneas base históricas.

Beto
Oh, caramba.

Alicia
Ellos no aprendieron cómo resolver el problema. Aprendieron cómo hacer que un chatbot lo resolviera por ellos. Los investigadores llaman a esto "pereza metacognitiva".

Beto
La pereza metacognitiva, con la metacognición siendo tu capacidad para evaluar tu propio pensamiento, ¿verdad? Saber lo que sabes y reconocer lo que realmente no sabes.

Alicia
Exacto. Cuando los estudiantes usan IA para generar un programa, miran la salida pulida en la pantalla, reconocen la lógica, y piensan para sí mismos, oh, sí, entiendo cómo funciona esto.

Beto
Desarrollan una "ilusión de competencia".

Alicia
Precisamente. Pero reconocer una respuesta correcta es completamente diferente de poder recordar los conceptos y resolver problemas desde cero.

Beto
Correcto.

Alicia
Sin la lucha cognitiva de la codificación manual, las vías neuronales para el pensamiento crítico y el razonamiento algorítmico se atrofian notablemente rápidamente.

Beto
Me hace pensar que es como confiar en una aplicación de GPS. Cuando te mueves a una ciudad nueva, introduces la dirección, sigues ciegamente la línea azul y llegas a tu destino increíblemente rápido.

Alicia
Sí.

Beto
Pero si tu teléfono muere tres días después, miras a tu alrededor y te das cuenta de que no tienes absolutamente ningún mapa interno de dónde estás. Ni siquiera sabes hacia dónde es el norte.

Alicia
Has externalizado completamente tu conciencia espacial.

Beto
Exacto. Así que si darle a un estudiante una IA es como darle a un adolescente un Ferrari sin instructor de manejo, ¿cómo lo arreglamos? Porque no podemos simplemente prohibir el GPS, ¿verdad?

Alicia
No, no puedes. Pero los investigadores encontraron una solución pedagógica. Cuando les proporcionaron a los estudiantes una versión delimitada de la IA, un tutor de IA diseñado específicamente para proporcionar solo pistas y andamiaje ("scaffolding"), negándose rotundamente a dar la respuesta directa, mitigó por completo esos efectos negativos en las puntuaciones del examen.

Beto
Y eso es fascinante.

Alicia
Sí, los estudiantes todavía tenían que involucrarse en la lucha cognitiva, pero tenían una guía.

Beto
Así que la herramienta no es inherentemente mala. El fallo está en cómo estamos diseñando la experiencia de aprendizaje en torno a ella.

Alicia
Exacto.

Beto
Lo que significa que las universidades no pueden simplemente modificar un plan de estudios, tienen que destruir todo el sistema. Y eso es exactamente lo que trató de descubrir esta coalición masiva. Para resolver esta trampa cognitiva, los autores del documento técnico no adivinaron desde una torre de marfil. Reunieron a los dos grupos más afectados por esta colisión. A finales de 2025 y principios de 2026, organizaron talleres poniendo a profesores y profesionales de la industria en la misma sala que estudiantes de recién graduados.

Alicia
Y poner esas dos perspectivas una al lado de la otra revela la enorme tensión que atraviesa la ciencia de la computación en este momento.

Sin embargo, encontraron un área de consenso importante. Tanto los profesores como los estudiantes estuvieron completamente de acuerdo en que el enfoque tradicional de un título en ciencias de la computación está muerto.

Beto
Se acabó.

Alicia
Sí. Memorizar la gramática y sintaxis exacta de un lenguaje de programación es una pérdida de tiempo. El nuevo enfoque tiene que ser conceptos de alto nivel, abstracción y aprendizaje basado en proyectos.

Beto
El valor humano ya no está en la escritura. Está en el pensamiento.

Alicia
Exacto.

Beto
Pero una vez que pasas ese acuerdo, las ansiedades de los dos grupos divergen salvajemente, ¿verdad?

Alicia
Completamente.

Beto
Los estudiantes están puramente aterrorizados por la supervivencia. Están leyendo titulares sobre IA de nivel de doctorado y flujos de trabajo totalmente agentes, que, para cualquiera no familiarizado, cuando una IA no solo escribe código, sino que actúa como un agente independiente que puede planificar un proyecto, escribir el código, probarlo y desplegarlo por completo de forma autónoma.

Alicia
Es intimidante.

Beto
Los estudiantes ven a la IA como este increíble copiloto 24/7, pero están en pánico por si siquiera serán empleables. Debido a ese miedo, están exigiendo autonomía extrema en sus clases. Quieren proyectos reales y desordenados del mundo real, para que puedan demostrar que pueden manejar la ambigüedad mejor que un algoritmo.

Alicia
Y lo fascinante aquí es cómo los miedos de los profesores son totalmente diferentes. Los profesores no solo están preocupados por conseguir que los estudiantes sean contratados, sino que tienen miedo a la responsabilidad profesional.

Beto
Sí. Piensa en el software que funciona en los frenos anti-bloqueo de tu coche, o el sistema de soporte vital en tu hospital local.

Alicia
Exacto.

Beto
Si una IA escribe el código para ese software crítico de seguridad, y falla, ¿a quién demanda el hospital? No puedes demandar a un algoritmo.

Alicia
Históricamente, la ciencia de la computación nunca ha tenido el marco de acreditación estricto de, digamos, la ingeniería civil. Un ingeniero civil literalmente firma un documento asumiendo responsabilidad legal por la seguridad de un puente.

Beto
Correcto, hay un sello en él.

Alicia
Pero el software ha operado como en un salvaje oeste. Con IA generando millones de líneas de código, los profesores señalan que necesitamos desesperadamente a seres humanos que puedan asumir la responsabilidad legal, ética y moral por esos sistemas.

Beto
Así que el papel del científico de la computación está cambiando, de creador del sistema, a verificador legal del sistema.

Alicia
Precisamente.

Beto
Entonces, ¿qué significa todo esto para la experiencia universitaria de cuatro años real? ¿cómo debe cambiar la universidad las clases de mañana para fabricar a estos verificadores?

Alicia
Bueno, el documento técnico presenta un plano concreto para el currículo de 2030, y es una desviación radical de cómo aprendieron a codificar en las últimas décadas.

Beto
No puedo esperar a escuchar esto.

Alicia
La revisión estructural comienza desde el primer día. En los años uno y dos, proponen un nuevo núcleo que descarta por completo el enfoque de abajo hacia arriba. Se acabó pasar seis semanas aprendiendo a escribir un simple programa "Hola Mundo" o un bucle `for` básico.

Beto
Eso se ha ido por completo.

En su lugar, proponen lo que llaman "ingeniería inversa de arriba hacia abajo", lo cual tiene mucho sentido. Piensa en cómo solía enseñar a un mecánico. En los viejos tiempos, enseñabas a un mecánico haciéndole fundir acero y forjar sus propias llaves. Eso es escribir sintaxis. La nueva propuesta es como entregarle a un joven de 18 años un Ferrari totalmente construido y de alta complejidad, en su primer día de clase, y decir, "quita este motor, dime por qué está haciendo un ruido de clic y explica la física subyacente de cómo fue construido".

Alicia
Forza al estudiante a leer y comprender sistemas masivos a un nivel alto de inmediato. El profesor le entrega una solución de IA compilada y compleja.

Beto
Y ya está hecha.

Alicia
Exacto. El estudiante tiene que extraer las especificaciones, descubrir cómo la IA resolvió el problema e identificar las debilidades estructurales. Lo entrena para expresar la intención con precisión, y razonar sobre la corrección.

Beto
Así que están construyendo ese mapa mental interno sin forzarlos a pavimentar cada carretera manualmente.

Alicia
Sí. Luego, en los años tres y cuatro, las ruedas de entrenamiento se eliminan por completo.

Beto
Las vías avanzadas.

Alicia
Correcto. El currículo cambia a sistemas de código abierto distribuidos y a gran escala. Esto aborda la demanda exacta que tenían los estudiantes de experiencia real y desordenada del mundo real.

Beto
Y hablan también de cosas interdisciplinarias, ¿verdad?

Alicia
Sí, en gran medida. Lo llaman "IA más X". La IA no existe en el vacío. Se aplica a la ciencia climática, la ley, la medicina.

Beto
Bueno, eso tiene sentido.

Alicia
Los estudiantes de ciencias de la computación necesitan la humildad intelectual para trabajar junto a expertos en el dominio para asegurarse de que están construyendo herramientas que realmente resuelven problemas humanos de forma segura.

Beto
Hablando de seguridad, la forma en que proponen enseñar ética es brillante. Actualmente, la mayoría de los programas de ciencias de la computación contienen ética en una clase aislada, generalmente increíblemente aburrida, en un año temprano en la que los estudiantes simplemente se duermen.

Alicia
Sí, la clase de "marcar la casilla".

Beto
Correcto. Pero los profesores propusieron la estrategia "de las migas de pan" ("breadcrumb").

Alicia
Es un diseño pedagógico mucho más elegante. En lugar de un curso aislado, esparcen ética, accesibilidad e impactos legales como pequeños empujones y ejercicios prácticos a lo largo de cada curso durante los cuatro años.

Beto
Así que estás en una clase de estructuras de datos muy técnica. Y de repente, hay una tarea de "migas de pan" que te obliga a evaluar los riesgos de privacidad de cómo estás registrando datos de usuario.

Alicia
Correcto.

Beto
O estás en una clase de arquitectura "back-end". Y tienes que calcular el impacto ambiental y el costo energético de las consultas de IA que está ejecutando tu sistema.

Alicia
Crea un reflejo. Se convierte en memoria muscular, no en una ocurrencia tardía.

Beto
Pero nada de este plan de estudios importa, si no revolucionamos fundamentalmente cómo calificamos a los estudiantes.

Alicia
Oh, absolutamente. Si un profesor solo evalúa el producto final, el código terminado, no tiene ni idea de si el estudiante aprendió algo. O si una IA simplemente alucinó todo el proyecto.

Beto
Exacto.

Alicia
La evaluación tiene que cambiar de evaluar el producto a evaluar el proceso.

Beto
Y propusieron algunas ideas salvajes para esto, como exámenes orales asistidos por IA.

Alicia
Me encanta esa.

Beto
Sí. En lugar de solo entregar un archivo zip de código, el estudiante se sienta y un agente de IA los interroga rigurosamente sobre por qué hicieron ciertas elecciones arquitectónicas. Lo cual honestamente ahorra a los profesores humanos miles de horas.

Alicia
Es increíblemente eficiente.

Beto
Pero mi concepto favorito fueron plataformas que llaman "programación de prompts".

Alicia
La programación de prompts invierte toda la dinámica de calificación. El estudiante no entrega el código final en absoluto.

Beto
Lo cual es alucinante.

Alicia
Correcto. Entrega todo su historial de interacción con el modelo de IA, junto con sus especificaciones en lenguaje natural. El profesor califica qué tan bien definió el estudiante el problema, qué tan rápido identificó las alucinaciones de la IA y cómo guiaron iterativamente al modelo de vuelta a la solución segura correcta.

Beto
Así que estás demostrando tu proceso de pensamiento, no tu velocidad de escritura.

Alicia
Exacto.

Beto
Y para ustedes que están escuchando ahora mismo, ya sea que sean estudiantes de ciencias de la computación, un gerente de proyecto tratando de integrar IA en su empresa, o simplemente alguien que intenta aprender una nueva habilidad un domingo por la tarde, esta es la conclusión real y aplicable.

Alicia
Sí.

Beto
El futuro no pertenece a las personas que pueden memorizar más hechos o escribir la sintaxis más rápida. El futuro pertenece a las personas que pueden especificar claramente lo que quieren y verificar rigurosamente lo que la IA devuelve.

Alicia
Esa es la idea central de todo este documento técnico. La ciencia de la computación está haciendo la transición de ser una disciplina principalmente enfocada en traducir lógica humana a sintaxis rígida de máquina.

Beto
Está evolucionando.

Alicia
Ahora se trata de humildad intelectual, comunicación de élite y actuar como el arquitecto senior de los sistemas generados por IA. Los fundamentos técnicos, las matemáticas profundas, la teoría algorítmica, el pensamiento de sistemas, esas siguen siendo increíblemente vitales.

Beto
No puedes saltártelos.

Alicia
Correcto. Pero ya no son las herramientas que usamos para actuar como una máquina. Son las herramientas que usamos para verificar a la máquina.

Beto
Lo que trae una reflexión final que he estado debatiendo desde que leí este informe.

Hemos hablado todo este tiempo sobre cómo la habilidad duradera definitiva para los seres humanos va a ser la verificación.

Alicia
Sí.

Beto
Específicamente la verificación formal, lo que significa poder demostrar matemáticamente que el código que escribió la IA hace exactamente lo que debe hacer, con cero efectos secundarios no intencionados.

Alicia
El santo grial de la seguridad del software.

Beto
Correcto. Pero el documento técnico menciona brevemente este pequeño detalle: Menciona que los modelos de lenguaje grandes ya están comenzando a ayudar en la generación de pruebas.

Alicia
La IA está aprendiendo lentamente la matemática requerida para verificarse a sí misma.

Beto
Correcto. Así que si desarrollamos esto a su conclusión lógica, si la IA eventualmente se vuelve mejor en verificar matemáticamente su propio código que los humanos, ¿dónde nos deja eso?

Alicia
Es una pregunta pesada.

Beto
Si la máquina puede diseñar el rascacielos, construir el rascacielos y demostrar matemáticamente que el rascacielos nunca se caerá. ¿Cambia el papel humano en la ciencia de la computación, y deja de ser el verificador?

Alicia
Es muy posible.

Beto
¿Nos convertimos en directores puramente morales y filosóficos? Solo decidiendo si deberíamos construir el rascacielos en primer lugar.

Realmente te hace preguntarte si el viejo sueño de aprender a programar está muerto, o si simplemente, está creciendo finalmente.

viernes, 24 de abril de 2026

DeepSeek V4


Los documentos proporcionados presentan la serie DeepSeek-V4, un conjunto de modelos de lenguaje avanzados de mezcla de expertos diseñados para el procesamiento de contextos de millones de tokens con alta eficiencia. La serie cuenta con dos versiones principales, DeepSeek-V4-Pro y DeepSeek-V4-Flash, que utilizan una novedosa arquitectura de atención híbrida para reducir drásticamente la sobrecarga computacional y el uso de memoria durante tareas con contextos extensos. Entre las innovaciones técnicas clave se incluyen el optimizador Muon para un entrenamiento estable, las hiperconexiones con restricciones de variedad para mejorar la propagación de la señal y el entrenamiento con conciencia de la cuantización para una mayor velocidad de inferencia. Las pruebas de rendimiento indican que estos modelos destacan en razonamiento complejo, codificación y conocimiento del mundo, a menudo rivalizando o superando a los sistemas abiertos y propietarios contemporáneos. Además, las fuentes detallan un proceso sofisticado, posterior al entrenamiento, que emplea expertos específicos del dominio y destilación basada en políticas para refinar las capacidades de razonamiento y de agencia. En general, el texto presenta a DeepSeek-V4 como un avance significativo en la escalabilidad del razonamiento en tiempo de prueba y en la gestión de secuencias ultralargas.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "DeepSeek V4". Publicado el 24 de Abril de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Imagina que te encargan construir un puente. Y normalmente, cuanto más largo es el puente, más acero necesitas.

Alicia
Bien. Es básicamente una relación lineal.

Beto
Exacto. A un metro de carretera, añades una tonelada de acero.

Pero imagina que vivieras en este universo extraño donde por cada metro nuevo de puente que construyes tienes que elevar al cuadrado la cantidad total de acero.

Alicia
Oh, wow.

Beto
Así que 10 metros requieren 100 toneladas, 1.000 metros requieren un millón de toneladas. Y muy rápido necesitas más acero del que existe en todo el planeta.

Alicia
Y toda la estructura simplemente colapsa bajo su propio peso matemático. Se vuelve físicamente imposible de construir.

Beto
Claro. Y ese puente imposible es la forma perfecta de describir lo que se siente al intentar procesar contextos ultralargos en inteligencia artificial.

Alicia
Sí. A medida que el contexto se alarga, las matemáticas se vuelven exponencialmente más difíciles.

Beto
Pero, ¿y si un equipo de investigadores averiguó cómo esencialmente reescribir las leyes de la física para ese puente?

Bienvenidos a la inmersión de hoy. Tenemos una misión muy específica: desentrañar un artículo de investigación altamente técnico, honestamente increíblemente denso, de DeepSeek sobre su nueva arquitectura V4.


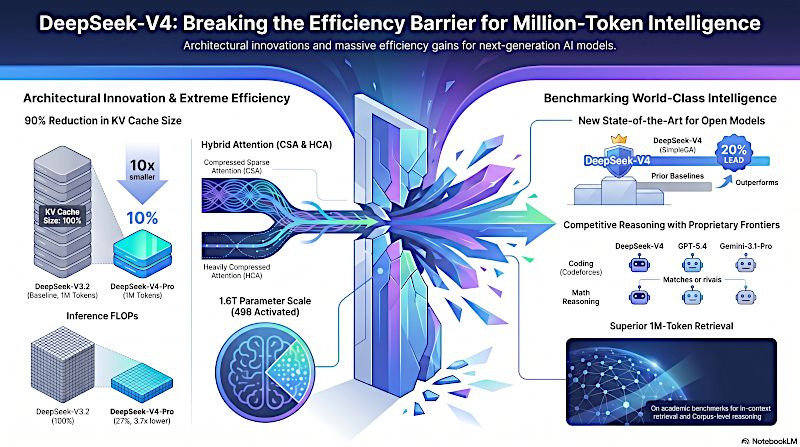
DeepSeek V4: Rompe la barrera de eficiencia con Inteligencia de millones de tokens

Alicia
El objetivo aquí es entender realmente cómo esta nueva arquitectura hace añicos una barrera de cómputo que antes era enorme. Hablábamos de procesar un contexto ultralargo de un millón de tokens, que, si te lo preguntas, equivale más o menos a unas pocas miles de páginas de un libro.

Beto
Es inmenso.

Alicia
Históricamente, mantener tanta información y memoria activa a la vez era prohibitivamente caro, incluso para las gigantes tecnológicas.

Beto
Y lo más loco es que DeepSeek lo está haciendo de código abierto.

Establezcamos las especificaciones base para que podamos captar la escala de la máquina que estamos viendo. La serie V4 introduce dos modelos distintos.

Primero, está DeepSeek V4 Pro. Este modelo tiene unos enormes 1,6 billones (trillones en inglés) de parámetros totales. Pero el artículo señala que solo activa 49.000 millones de parámetros por token.

Alicia
Esta es una distinción enorme.

Beto
Quiero detenerme ahí porque, si alguien no está metido en hardware de IA, eso suena a una contradicción total. ¿Cómo tienes más de un billón de parámetros pero solo usas 49.000 millones?

Alicia
Pues esa brecha se debe a lo que se llama una arquitectura "mixture of experts", o MoE (mezcla de expertos). Piensa en los 1,6 billones de parámetros totales como una gigantesca corporación global con miles de departamentos altamente especializados. Esos parámetros totales representan la vasta capacidad de conocimiento del modelo. Pero cuando le pides que genere una sola palabra, no consulta toda la empresa.

Beto
Eso tomaría una eternidad.

Alicia
Exacto. Usa un mecanismo de enrutamiento para activar solo los expertos específicos, los departamentos necesarios para ese concepto exacto. Esos son los 49.000 millones de parámetros activados. Eso dicta tu coste computacional real.

Beto
Tiene mucho sentido. Es básicamente la diferencia entre el tamaño de una biblioteca y el número de libros que realmente sacas del estante para tu proyecto.

Alicia
Gran forma de decirlo.

Beto
Y luego está el hermano menor, DeepSeek V4 Flash. Ese tiene 284.000 millones de parámetros totales con apenas 13.000 millones activados por token.

Alicia
Y el gancho real aquí es que V4 no es solo una optimización menor. Este modelo abierto compite directamente con los modelos cerrados de gama más alta. Iguala a gigantes propietarios como GPT-5.4 en competiciones de programación complejísimas.

Beto
Lo cual es una locura.

Alicia
Y lo hace con solo una fracción del consumo computacional.

Beto
OK. Quiero profundizar en cómo lo logran. Porque para entender por qué la eficiencia de V4 es revolucionaria, tenemos que volver a esa imposibilidad del puente.

Alicia
Sí. El problema del escalado.

Beto
El artículo llama al problema central la "complejidad computacional cuadrática de la atención vanilla". Traduce esto a un lenguaje sencillo para nosotros.

Alicia
En las arquitecturas transformer estándar, que son el motor detrás de casi todos los modelos de lenguaje modernos, el mecanismo de atención es cómo la IA entiende el contexto. Para captar el significado de una frase, cada token o fragmento de palabra tiene que mirar atrás a cada otro token generado previamente para ver cómo se relacionan.

Beto
Por ejemplo, la palabra “bank” mira atrás para ver si hemos estado hablando de un río o de dinero.

Alicia
Sí, exactamente. Pero matemáticamente, si duplicas la longitud del texto, en realidad cuadruplicas la cantidad de “miradas atrás” que deben ocurrir.

Beto
Oh, wow.

Alicia
Cuadruplica el trabajo computacional. Así que cuando escalas eso a un contexto de un millón de tokens, los costos de procesamiento se disparan ...

Beto
... porque se está elevando al cuadrado cada vez.

Alicia
Correcto. El modelo mantiene algo llamado "caché de claves y valores" o "KV cache". Es esencialmente la libreta de notas de memoria a corto plazo del modelo. Y para un millón de tokens, esa libreta se vuelve tan gigantesca que físicamente se queda sin espacio en las tarjetas gráficas del servidor.

Beto
¿Cómo lo arregló DeepSeek? No podían simplemente comprar más hardware.

Alicia
No, no. El artículo detalla una arquitectura central totalmente nueva: un mecanismo de atención híbrido. Combinan dos conceptos completamente nuevos: CSA, que significa "Compressed Sparse Attention" (atención comprimida y dispersa), y HCA, "Heavily Compressed Attention" (atención fuertemente comprimida).

Beto
Párate un momento y desglosa CSA primero. Si estoy comprimiendo la libreta de notas de la IA, ¿acaso no la estoy volviendo más tonta al tirar contexto?

Alicia
Suena así, ¿no?

Beto
¿Cómo comprime sin perder el hilo?

Alicia
Bueno. Es altamente dirigido. CSA toma un bloque de tokens —digamos cuatro tokens— y comprime matemáticamente su caché de claves y valores en una sola entrada.

Beto
OK, lo reduce.

Alicia
Sí. Has encogido instantáneamente la longitud de la secuencia. Pero la verdadera magia es lo que ocurre después: usa una estrategia de atención dispersa potenciada por lo que llaman un "indexador relámpago".

Beto
El indexador relámpago suena bonito.

Alicia
Sí. Evalúa todos esos bloques comprimidos y selecciona solo los mejores, los más relevantes.

Beto
Ah, entiendo.

Alicia
El modelo se niega a leerlo todo. Atiende selectivamente solo a los bloques comprimidos más críticos.

Beto
Interesante. ¿Y el otro lado del sistema híbrido, el HCA?

Alicia
HCA opera en otra frecuencia. Usa una tasa de compresión mucho más fuerte, denotada en las fórmulas como n-prima. En lugar de comprimir cuatro tokens, puede comprimir 128 tokens en una sola entrada.

Beto
Wow. Eso es una compresión enorme.

Alicia
Sí. Porque la compresión es tan extrema, la libreta resultante es diminuta, así que no necesita ser dispersa; mantiene atención densa.

Beto
Lo mira todo.

Alicia
Exacto. Observa todos esos bloques fuertemente comprimidos, pero como son muy pocos, la carga computacional es despreciable.

Beto
Déjame ver si puedo mapear esto a un escenario del mundo real para asegurarme de seguir la lógica.

Alicia
Adelante.

Beto
Imagina que pegas un enorme libro de historia de 500 páginas en el chat y haces una pregunta muy específica. HCA es como mi investigador de alto nivel que me da una página con un resumen amplio de cada capítulo. Leo todos esos resúmenes para obtener el contexto general de la línea temporal.

Alicia
Exacto.

Beto
Mientras tanto, CSA es mi especialista que escanea esos resúmenes, localiza las cinco páginas exactas que contienen la respuesta y lee solo esas páginas de cerca.

Alicia
Sí.

Beto
Juntos, me ahorran tener que leer las 500 páginas de cabo a rabo.

Alicia
Muy buena visualización. HCA mantiene el entendimiento macro del documento entero, mientras que CSA aísla los detalles micro allí donde importan, y las ganancias de eficiencia de combinarlos son asombrosas.

En un contexto de un millón de tokens, DeepSeek V4 Pro requiere solo el 27 % de los FLOPs de inferencia por token comparado con su predecesor V3.2.

Beto
Para cualquiera que no esté en servidores, FLOPs son floating point operations — operaciones de punto flotante — básicamente el esfuerzo de cálculo bruto que la máquina tiene que hacer. Una caída del 73 % en cálculo es masiva.

Alicia
Y además solo necesita el 10 % del tamaño del KV cache. Están reduciendo la huella de memoria en un 90 %.

Beto
Wow.

Alicia
Ahora, hay una trampa. Si comprimes todo, puedes perder los detalles finos exactos de las palabras que el usuario acaba de escribir en el cuadro de prompt.

Beto
Oh, claro. Porque todo está resumido.

Alicia
Exacto. Para contrarrestar eso, añadieron una rama de atención de ventana deslizante.

Beto
¿Qué hace eso?

Alicia
Esto obliga al modelo a mantener los tokens más recientes —digamos los últimos 128 tokens de la conversación— completamente sin comprimir. Actúa como un ancla para que la IA nunca pierda el rastro del intercambio inmediato.

Beto
Es una solución increíblemente elegante.

Alicia
Así es.

Beto
Pero diseñar una arquitectura hiper eficiente en papel es una cosa; entrenar un modelo de 1,6 billones de parámetros con compresiones agresivas suena como construir una torre matemática muy inestable.

Alicia
Y lo es.

Beto
Cuando las cosas crecen tanto, tienden a romperse. ¿Cómo evitaron que el sistema masivo colapsara durante el entrenamiento?

Alicia
La estabilidad del entrenamiento fue su segundo gran escollo. Al escalar un MoE a más de un billón de parámetros, las señales que atraviesan las capas profundas de la red pueden explotar fácilmente.

Beto
¿Explotar cómo?

Alicia
Bueno, las matemáticas se acumulan, los números se vuelven tan astronómicos que la computadora literalmente arroja “not a number” y toda la corrida de entrenamiento de millones de dólares se cae. Para evitar esto introdujeron algo llamado MHC, o "manifold constrained hyperconnections", hiperconexiones restringidas por una variedad.

Beto
Me perdí leyendo esa sección. Es difícil de entender.

Alicia
Esa sección es densa.

Beto
Actualizaron las conexiones residuales tradicionales. ¿Pero qué significa “manifold constrained” sin un doctorado en álgebra lineal?

Alicia
Piensa en una conexión residual estándar como una vía de desvío —una autopista de bypass— que permite que la información salte sobre ciertos bloques de procesamiento para mantener la señal fuerte al viajar por capas profundas de la red. Si ensanchas esa autopista demasiado, que es lo que hacen las hiperconexiones estándar, la señal puede amplificarse descontroladamente.

Beto
Ah, y entonces explota.

Alicia
Exactamente. Lo que MHC hace es forzar que el mapeo matemático de esa autopista se ajuste a una variedad específica, concretamente la variedad de matrices doblemente estocásticas.

Beto
Vas a tener que desglosarme lo de las "matrices doblemente estocásticas".

Alicia
Con gusto. Imagina una enorme mesa de mezclas de audio cuyos faders están físicamente y matemáticamente bloqueados de modo que el volumen total de todos los canales combinados nunca pueda exceder el 100 %. Una matriz doblemente estocástica garantiza que las probabilidades a lo largo de las filas y las columnas sumen estrictamente uno.

Beto
Ah, ya veo.

Alicia
Actúa como un límite de velocidad matemático inquebrantable. Asegura que la señal nunca pueda amplificarse más allá de un límite seguro por muy profunda que sea la red.

Beto
Así que MHC actúa como el límite de velocidad que mantiene las señales de explotar.

Alicia
Precisamente.

Beto
También noté que cambiaron por completo el motor bajo el capó: se alejaron del optimizador tradicional "AdamW" para la mayoría de los módulos.

Alicia
Sí. Adoptaron el optimizador "Muon". Muon logra convergencia más rápida y estable durante el entrenamiento usando iteraciones Newton–Schulz híbridas para ortogonalizar las actualizaciones de pesos.

Beto
Espera, tienes que parar de decirme eso tal cual: “iteraciones Newton–Schulz híbridas para ortogonalizar las actualizaciones de pesos” — eso no significa nada para mí.

Alicia
Cierto, lo siento.

Beto
¿Qué hace realmente distinto el optimizador Muon?

Alicia
Piensa en un optimizador tradicional como AdamW como un excursionista que busca el punto más bajo de un valle con los ojos vendados. Da pequeños pasos cautelosos hacia abajo sintiendo la pendiente justo bajo sus pies. Funciona, pero toma millones de pasos diminutos.

Beto
Muy lento.

Alicia
Bien. El optimizador Muon, usando iteraciones Newton–Schulz, no solo “siente” la pendiente, calcula la curvatura más amplia de toda la montaña. Puesto que entiende la geometría general, puede dar saltos enormes y muy calculados hacia el fondo del valle sin tropezar. Es maravillosamente más eficiente para matrices de parámetros enormes.

Beto
Me gusta esa analogía: grandes saltos calculados en lugar de pasos de bebé vendados.

Alicia
Exacto.

Beto
Pero sobre la estabilidad: el artículo menciona picos severos de pérdida e inestabilidad causados por el mecanismo de enrutamiento del Mixture of Experts.

Alicia
Sí, ese fue un punto importante.

Beto
El enrutador envía tokens a diferentes expertos. Ocasionalmente, manda un atasco de datos a un mismo lugar, causando un outlier que básicamente destroza las matemáticas. Si el modelo hace spike o se cae durante el entrenamiento por un mal enrutamiento, ¿por qué no simplemente deshacer? ¿recargar un checkpoint de hace una hora y probar de nuevo?

Alicia
Es un impulso muy común. Pero el equipo de DeepSeek se dio cuenta de que los rollbacks no arreglan el mecanismo subyacente. Si retrocedes, el modelo probablemente dará con el mismo bache matemático 10 minutos después y volverá a hacer spike.

Beto
Oh, porque la lógica está defectuosa.

Alicia
Correcto. El enrutamiento MoE crea un ciclo vicioso: un dato atípico provoca un mal enrutamiento y ese mal enrutamiento agrava el error, creando un outlier aún peor.

Beto
¿Cómo rompes ese bucle de fallos sin empezar de cero?

Alicia
DeepSeek inventó el enrutamiento anticipatorio. Normalmente, una IA usa sus parámetros actuales, al segundo, para decidir dónde enrutar tokens. DeepSeek desacopló el enrutamiento: calculan los índices de enrutamiento usando parámetros históricos de un paso de entrenamiento anterior.

Beto
Ah, ya veo. El cerebro principal procesa los datos en el momento presente, pero el semáforo que dirige el tráfico opera con un pequeño retraso usando el mapa estable y probado de ayer.

Alicia
Precisamente. Al usar parámetros históricos para las decisiones de enrutamiento evitas que una anomalía repentina en tiempo real arruine instantáneamente la lógica de enrutamiento.

Beto
Eso es muy inteligente.

Alicia
Rompe por completo el ciclo vicioso de outliers.

Beto
Así que con MHC, Muon y enrutamiento anticipatorio, tenemos una arquitectura rápida y matemáticamente a prueba de balas.

Alicia
Sí.

Beto
Pero un cerebro rápido y estable que no sabe nada es totalmente inútil. ¿Cómo pones la inteligencia en esta arquitectura, especialmente en campos complejos y recientes como matemáticas avanzadas y programación?

Alicia
Aquí su pipeline de post-entrenamiento diverge completamente de las normas de la industria. Tradicionalmente, tras la fase cruda de preentrenamiento, los desarrolladores usan una mezcla de reinforcement learning from human feedback (RLHF) para alinear el modelo.

Beto
Para enseñarle a responder apropiadamente.

Alicia
Exacto. DeepSeek reemplazó por completo esa etapa mixta de RL con "distilación on-policy multi-profesor", o OPD.

Beto
Explícanos cómo funciona un setup multi-profesor. Suena a universidad de IA.

Alicia
Básicamente lo es. Primero, no intentan entrenar un modelo gigante que domine todo al mismo tiempo. Entrenan modelos docentes separados y altamente especializados: uno se entrena agresivamente para ser un experto mundial en matemáticas usando recompensas específicas de RL; otro se entrena exclusivamente en ingeniería de software. Una vez que tienen esa “facultad” de especialistas brillantes, usan OPD para destilar todo ese conocimiento aislado en un único modelo estudiante.

Beto
Pero con la distilación suele haber una gran pérdida de fidelidad.

Alicia
Normalmente lo hace.

Beto
Es como sacar una fotocopia de una fotocopia. Normalmente el estudiante obtiene la idea general pero pierde matices.

Alicia
Eso es un fallo conocido, por eso DeepSeek usa distilación de lógica de vocabulario completo. En métodos antiguos, el modelo estudiante solo mira al profesor y trata de copiar la única palabra final que el profesor emite:

Beto
Solo la respuesta.

Alicia
Pero DeepSeek obliga al estudiante a observar la distribución completa de probabilidades del profesor a lo largo de todo el vocabulario de más de 100.000 palabras.

Beto
¿Qué significa eso en la práctica?

Alicia
Significa que el estudiante no solo ve la respuesta final; aprende exactamente cómo el profesor ponderaba cada opción posible antes de hablar. Por qué el profesor de matemáticas consideró la palabra "hence" con un 40 % de probabilidad pero al final eligió "therefore" con un 60 %.

Beto
Así ve el proceso de pensamiento.

Alicia
Exacto. El estudiante absorbe la duda, la confianza y la lógica subyacente del profesor en cada token. Transfiere la verdadera profundidad del razonamiento del profesor.

Beto
Así que si usas este modelo, no es una licuadora que machacó datos de matemáticas y programación en una masa gris. Dependiendo del prompt, el modelo unificado puede encauzar dinámicamente los patrones lógicos del experto en matemáticas o del experto en código según el trabajo.

Alicia
Esa precisión cambia mucho el comportamiento del modelo en tiempo de inferencia. Y lo vemos en sus paradigmas de escalado en test time: el modelo tiene tres modos de razonamiento distintos: non-think, think y think-max.

Beto
OK. Non-think es autoexplicativo: respuestas rápidas e intuitivas para tareas rutinarias como redactar un correo. Think es para problemas complejos donde muestra su cadena de pensamiento. Pero think-max es cuando dejan al modelo completamente desatado.

Alicia
Think-max empuja las capacidades de razonamiento al límite absoluto, no se permiten atajos. Inyectan un prompt de sistema oculto que ordena al modelo descomponer el problema exhaustivamente, poner a prueba su propia lógica contra casos extremos y documentar cada hipótesis rechazada antes de dar una respuesta final.

Beto
Y gracias a ese contexto barato de un millón de tokens del que hablamos, tiene un superpoder agentivo que el artículo llama "interleaved thinking" —pensamiento entrelazado—.

Alicia
Esto es quizás la mejora más crucial para flujos de trabajo reales. En modelos anteriores, si la IA usaba herramientas externas —por ejemplo, ejecutar código Python, buscar en la web, comprobar resultados— y luego el usuario enviaba un nuevo mensaje de seguimiento, el modelo a menudo tenía que borrar sus trazas de razonamiento previas para ahorrar memoria.

Beto
Ay, Dios.

Alicia
Tenía que reconstruir su estado de resolución de problemas desde cero.

Beto
Si has trabajado con una IA en un proyecto largo y de repente olvida por qué escribió la línea 40, es muy frustrante.

Alicia
Exacto. En V4, porque procesar ese contexto masivo es tan barato usando CSA y HCA, retiene la cadena completa de pensamiento a través de múltiples rondas de llamadas a herramientas y mensajes de usuario.

Beto
Eso es impresionante.

Alicia
Mantiene un proceso de pensamiento coherente y acumulativo a lo largo de tareas de largo horizonte.

Beto
Y los resultados del modo think-max son francamente impresionantes: en el benchmark Putnam 2025 de matemáticas, que exige pruebas formales rigurosas y es notoriamente brutal, DeepSeek V4 Pro Max sacó 120 de 120 — una puntuación perfecta en verificación matemática formal.

Alicia
Increíble.

Beto
Y en Codeforces, que es una plataforma de programación altamente competitiva para humanos, el modelo alcanzó una clasificación ELO de 3206. Eso lo sitúa en el puesto 23 a nivel mundial entre todos los concursantes humanos. Demuestra que los modelos de código abierto pueden igualar sin ambigüedades a los gigantes cerrados más avanzados.

Alicia
Igual de impresionante es que incluso el modelo más pequeño, V4 Flash, cuando se pone en modo think-max, logra un rendimiento de razonamiento comparable al de modelos mucho más grandes.

Beto
¿En serio?

Alicia
Sí. Prueba que escalar el cómputo en tiempo de prueba —simplemente dar al modelo más tiempo para pensar— puede cerrar la brecha de inteligencia causada por tener menos parámetros.

Beto
Ahora jugaré al escéptico un minuto.

Alicia
Adelante.

Beto
Todo eso suena increíble, pero ejecutar un modelo tan brillante con un contexto de un millón de tokens normalmente requiere un superordenador del tamaño de un almacén. ¿Cómo se despliega eficientemente sin que el usuario espere 10 minutos por una respuesta?

Alicia
DeepSeek V4 brilla en su infraestructura de despliegue. La primera innovación mayor para reducir la huella es la cuantización FP4.

Beto
Espera. ¿Bajar a un formato de punto flotante de 4 bits? ¿No hace que el modelo se vuelva estúpido e inexacto de inmediato?

Alicia
Naturalmente uno lo asumiría. Reducir la precisión suele destruir el matiz. Pero comprimen los enormes pesos MoE —que ocupan la mayor parte de la memoria física de la GPU— a FP4. Durante el cómputo real, usan una des-cuantización sin pérdida a FP8.

Beto
¿Cómo puede ser sin pérdida si ya tiraste bits para comprimirlo?

Alicia
No es volver a quemar un papel; es más como comprimir un archivo para transporte. FP8 tiene dos bits de exponente adicionales comparado con FP4, dándole un rango dinámico mucho mayor. Mientras la información de escala fina del bloque FP4 se mantenga dentro de cierto umbral, ese rango dinámico extra en FP8 absorbe por completo los factores de escala al descomprimirlo.

Beto
Ya entiendo.

Alicia
El modelo calcula exactamente como si estuviera en mayor precisión, pero en despliegue ahorras enormes cantidades de ancho de banda de memoria.

Beto
Un truco de hardware brillante.

También atacan la caché con almacenamiento del KV cache en disco. Imagina que pegas un PDF legal de 500 páginas en el chat y haces una pregunta y responde. Al día siguiente, tu colega inicia sesión, accede al mismo documento compartido y hace otra pregunta. Normalmente la IA tiene que volver a leer las 500 páginas desde cero, costeando tiempo y cómputo.

Alicia
Pero DeepSeek guarda esas entradas comprimidas de CSA y HCA directamente en disco SSD. Si haces una nueva pregunta sobre un documento compartido, simplemente carga el estado comprimido desde el disco. Elimina el rellenado repetido para solicitudes con prefijos compartidos, que es un cuello de botella masivo al servir modelos de lenguaje a millones de usuarios.

Beto
Pero el verdadero cuello de botella en chats de IA no siempre es la lectura; es la preparación.

Alicia
Sí, la sobrecarga.

Beto
Si pregunto algo en un chat, normalmente un modelo pequeñito tiene que ejecutarse primero solo para decidir tareas auxiliares: ¿requiere esta petición una búsqueda web? ¿En qué dominio está?

Alicia
Exacto.

Beto
Correr un modelo separado añade tiempo. Si DeepSeek tuviera que ejecutar un modelo pequeño primero para ver si hay que buscar en la web, ¿no mataría eso la velocidad?

Alicia
Normalmente sí, porque requiere rellenados redundantes. DeepSeek lo evita totalmente inventando tokens de instrucción rápidos.

Beto
¿Qué son esos?

Alicia
Adjuntan tokens especiales dedicados —por ejemplo, un token disparador de búsqueda o un token de intención— directamente a la secuencia de entrada del modelo principal.

Beto
Ah. Es como una cocina que reutiliza una gran olla de agua hirviendo para múltiples órdenes de pasta en vez de hervir una olla nueva desde fría cada vez que entra un ticket. Ya computaron el KV cache para esas tareas auxiliares. Reduce drásticamente el tiempo hasta el primer token. Obtienes tu respuesta al instante.

Alicia
Elimina la sobrecarga de ingeniería de mantener un modelo extra pequeño y mejora la experiencia de usuario.

Beto
En resumen: lo que DeepSeek V4 ha hecho es tomar el puente imposible de la atención cuadrática y encontrar una nueva física para construirlo usando la compresión inteligente de CSA y HCA. Lo estabilizaron para el delicado entrenamiento de 1,6 billones de parámetros inventando enrutamiento anticipatorio para detener bucles de fallos matemáticos. Alcanzaron inteligencia de primera línea usando distilación con vocabulario completo para aprender de expertos especializados. Y lograron desplegar todo esto eficientemente en hardware mediante cuantización y almacenamiento en disco.

Alicia
Es una clase magistral de optimización full-stack, desde las variedades matemáticas centrales hasta el despliegue físico en servidores.

Beto
Hemos hablado de contexto como una ventana para que tú la uses: un millón de tokens para examinar un proyecto masivo. Pero si el contexto ahora es barato de mantener y las trazas de razonamiento de la IA pueden conservarse indefinidamente sin arrasar un centro de datos, la ventana básicamente se convierte en memoria.

Alicia
Un hilo continuo.

Beto
Imagínate una IA que nunca se reinicie cuando cierras el navegador. Una que aprenda de una vida de conversaciones contigo, actualizando su propio entendimiento interno en tiempo real. Ya no estamos hablando solo de calculadoras más rápidas. Estamos ante la arquitectura fundamental para entidades digitales con memorias permanentes y en evolución.

Alicia
La muralla del cómputo ha caído. Cambia exactamente a dónde podemos viajar a continuación.

Beto
Gracias por acompañarnos en esta inmersión. Sigue cuestionando los límites.