
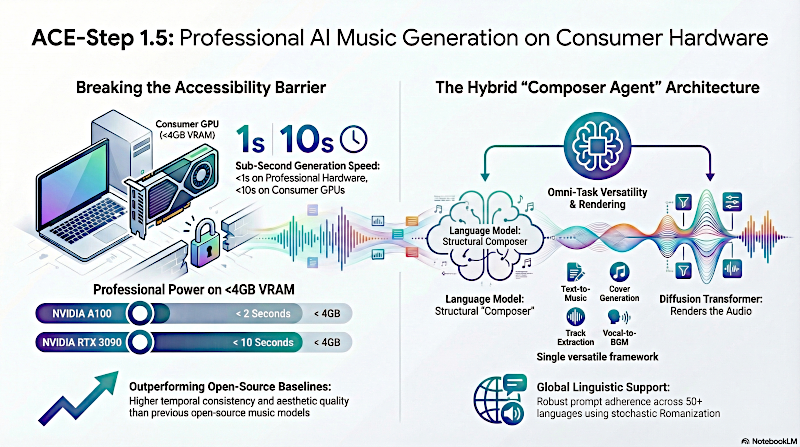
Este texto presenta ACE-Step v1.5, un modelo de base musical de código abierto diseñado para generar audio de calidad profesional en hardware de consumo. Desarrollado en colaboración entre ACE Studio y StepFun, el modelo utiliza una arquitectura híbrida que separa la planificación estructural de alto nivel mediante un Modelo de Lenguaje de la representación acústica detallada mediante un Transformador de Difusión. Este marco admite diversas tareas creativas, como la síntesis de texto a música, la extracción de pistas y la conversión de voz a música de fondo, manteniendo una alta fidelidad y eficiencia. Mediante la implementación de destilación adversaria avanzada, el sistema alcanza velocidades de generación inferiores a un segundo y se ejecuta localmente con requisitos mínimos de memoria. Los autores también detallan un proceso de anotación basado en aprendizaje por refuerzo y una rigurosa lista de verificación de usabilidad para garantizar que el modelo cumpla con los estándares de producción profesional en más de 50 idiomas. En definitiva, el proyecto busca democratizar la producción musical profesional al proporcionar una alternativa accesible y de alto rendimiento a las herramientas propietarias de código cerrado.
Enlace al artículo científico, para aquellos interesados en profundizar en el tema:
- "ACE-Step 1.5: Pushing the Boundaries of Open-Source Music Generation", por Junmin Gong y colegas. Publicado el 6 de Febrero del 2026.
- Ejemplos en GitHub
- Playground en HuggingFace
- Código fuente, en GitHub
El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.
El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.
Resumen
Beto
Bienvenidos al análisis profundo de hoy. Si eres de los que ama aprender, estás constantemente curioso, pero a la vez detestas por completo esa sensación de, ya sabes, sobrecarga de información, estás en el lugar exactamente correcto.
Alicia
De verdad.
Beto
Sí, hemos filtrado el ruido por ti. Y hoy, quiero decir, vas a encontrar este tema increíblemente fascinante.
Alicia
Hoy es realmente algo especial. El material fuente para esta inmersión profunda es un artículo de investigación recién publicado, salido de prensa en febrero de 2026.
Beto
Correcto.
Alicia
Nos llega de los investigadores de ACE Studio y StepFun, y detalla este cambio monumental en la forma en que la inteligencia artificial maneja la generación de audio.
Beto
Para ponerte en situación, quiero que imagines estar sentado frente a tu ordenador, escribiendo un prompt de texto y generando una canción totalmente original, comercialmente viable y de larga duración.
Alicia
Una canción real.
Beto
Sí, una pista estructurada: verso, estribillo, puente, todo el paquete. Ahora imagina hacer eso en menos de 10 segundos.
Alicia
Que ya de por sí es una marca impresionante, pero el contexto de cómo está sucediendo es lo que convierte a este artículo en un verdadero hito.
Beto
Porque aquí es donde se pone realmente interesante. Imagina hacer todo eso completamente en local, en tu propia máquina, usando solo una tarjeta gráfica de consumo estándar.
Alicia
Nada de granjas de servidores masivas.
Beto
Exacto. Sin una suscripción cara a la nube de algún conglomerado tecnológico, sin esperar en una cola de servidor. Ni siquiera necesitarías una conexión activa a internet para que funcione.
Alicia
Suena como una capacidad que debería estar bloqueada detrás de hardware a nivel empresarial. Pero esa es la realidad que presenta ACE Step 1.5.
Beto
Wow.
Alicia
Sí. Es un modelo base musical de código abierto. Está, efectivamente, tendiendo un puente sobre la enorme brecha que existía entre los modelos de IA propietarios y de código cerrado y los creadores cotidianos. Estamos viendo la completa democratización de la producción musical profesional. Lleva la síntesis de calidad de estudio directamente al portátil que tienes sobre la mesa.
Ace-Step 1.5
Beto
Y para entender el salto masivo que representa ACE Step 1.5, tenemos que mirar al problema central que lastraba a los modelos de código abierto anteriores.
Alicia
Correcto, las arquitecturas antiguas.
Beto
Piensa en iteraciones previas como ACE Step versión 1.0, demostraron que el texto a música era posible, pero eran esencialmente una gran caja negra. Tenían muchos problemas con la consistencia semántica.
Alicia
Pedías una pista de jazz animada ...
Beto
... y te devolvían una balada blues lenta.
Alicia
Exacto.
Beto
Y la fidelidad de audio no era de nivel profesional. Parecía que esos modelos intentaban hacer demasiado trabajo pesado al mismo tiempo.
Alicia
Sí, los investigadores diagnosticaron ese cuello de botella mirando la arquitectura fundamental. Los modelos anteriores operaban de extremo a extremo. Introducías un prompt de texto y la IA intentaba producir un archivo de audio finalizado y mezclado en un único paso masivo y enrevesado. Tenía que resolver la teoría musical, la estructura lírica, la instrumentación y el renderizado acústico todo al mismo tiempo.
Beto
Me recuerda a una banda de un solo hombre: alguien intentando componer música compleja, escribir poesía para las letras y, al mismo tiempo, tocar la batería, la guitarra y la armónica en el mismo momento.
Alicia
Es una analogía perfecta.
Beto
Por supuesto que la salida iba a ser un desastre. El ritmo divaga, las letras no tienen sentido o los instrumentos simplemente chocan. Entonces, ¿cómo desenredaron ese lío en la versión 1.5?
Alicia
La solución que desarrollaron se llama arquitectura híbrida de difusión con razonamiento. En lugar de una entidad monolítica intentando manejar todo el proceso creativo, separaron explícitamente la carga de trabajo en dos roles distintos. Desacoplaron la lógica de la música, del renderizado real del sonido.
Beto
Desacoplaron el cerebro de la banda.
Alicia
Exacto. La primera mitad del sistema es el modelo de lenguaje, o LM, que actúa como agente compositor.
Beto
Así que el modelo de lenguaje es el cerebro de la operación. Leí el desglose de cómo funciona este agente compositor, y ni siquiera toca el audio al principio, ¿no? Solo se centra en la estructura.
Alicia
Esa separación de funciones es clave. Cuando le das al modelo un prompt vago, el LM usa razonamiento en "cadena de pensamiento" ("chain-of-thought") para traducir tu idea en planos altamente estructurados.
Beto
Simplemente piensa.
Alicia
Cierto. Piensa en el formato de las letras, calcula la duración total de la pista, determina los BPM exactos, la tonalidad musical y la estructura general de la canción, como dónde entra el estribillo y cuándo se construye el puente.
Beto
Está escribiendo la partitura y organizando la sesión de grabación antes de que se toque una sola nota.
Alicia
Sí. Y al encargarse de toda esa planificación estructural compleja por adelantado, crea un conjunto de instrucciones prístinas y sin ambigüedad. Ese plano estructural se entrega luego a la segunda mitad de la arquitectura: el transformador de difusión, el DIT.
Beto
La banda.
Alicia
El DIT actúa como el renderizador acústico. Dado que el modelo de lenguaje ya resolvió todos los problemas estructurales y lógicos, el DIT queda liberado para centrarse enteramente en el sonido.
Beto
No tiene que pensar en la letra.
Alicia
Exacto. No desperdicia potencia computacional preocupándose por si el estribillo debe repetirse o si el esquema de rimas tiene sentido. Solo se centra en la riqueza acústica, la claridad instrumental y en separar perfectamente las diferentes frecuencias sonoras.
Beto
Vale, desempacemos esa calidad de sonido, porque honestamente ese siempre ha sido mi mayor queja con la música AI de código abierto.
Alicia
Los problemas de fidelidad.
Beto
Sí, recuerdo haber generado canciones rock hace un año y siempre sonaban como si la banda tocara bajo el agua.
Alicia
Correcto, ese sonido “swishy”.
Beto
Todo estaba amortiguado, la batería sonaba como cartón y había un siseo digital extraño sobre todo. ¿Por qué ocurría eso en primer lugar y cómo arregla esta nueva arquitectura ese cuello de botella acústico?
Alicia
Ese artifacto submarino es un síntoma clásico de cómo se representaba el audio matemáticamente. Los modelos antiguos, incluida la primera versión de ACE Step, se basaban en algo llamado espectrogramas Mel en 2D. Un espectrograma Mel traduce las formas de onda de audio en una representación visual 2D. Es básicamente un mapa de impactos de las frecuencias sonoras a lo largo del tiempo. Así, la IA manipulaba esa imagen y luego intentaba volver a traducirla a una forma de onda de audio.
Beto
Eso se parece a tomar un gráfico vectorial nítido, rasterizarlo en un JPEG de baja resolución, editar el JPEG y luego intentar convertirlo de nuevo mágicamente en un vector impecable: en la traducción se pierde información.
Alicia
Esa es una manera brillante de enmarcarlo. El proceso de traducción causa inherentemente lo que los ingenieros de audio llaman pérdida de fase. Difumina los datos de audio. Pierdes los transitorios agudos de alta frecuencia. Por eso la percusión nítida, como el golpe seco de una caja o el punteo cortante de un bajo, terminaba sonando pastoso y completamente arruinado en esos modelos antiguos.
Beto
Pero el artículo menciona que ACE Step 1.5 abandona por completo esos espectrogramas Mel 2D. Pasa al dominio de la forma de onda pura: un autoencoder variacional unidimensional (VAE). Aquí tengo que jugar al escéptico por un segundo: las especificaciones afirman que este VAE 1D toma un archivo de audio estéreo sin comprimir a 48 kHz y lo comprime en un espacio latente pequeñísimo, logrando una tasa de compresión de 1920 veces.
Alicia
Es una cifra asombrosa.
Beto
Lo es. Cualquiera que haya guardado un MP3 sabe que la compresión agresiva suele destruir las frecuencias altas. ¿Realmente afirman una compresión 1920× sin artefactos?
Alicia
Lo clasifican como calidad perceptual casi sin pérdidas. Y la ingeniería detrás es lo que hace viable esa compresión masiva. Al operar directamente sobre la señal de audio 1D, en lugar de traducirla a una imagen 2D, el VAE preserva la información de fase y esas frecuencias altas cruciales.
Beto
Así que no hay traducción tipo JPEG.
Alicia
Correcto. Matemáticamente traduce el audio a un código denso comprimido que la IA puede manipular fácilmente sin descartar los datos transitorios que dan pegada a los instrumentos.
Beto
Si está comprimiendo los archivos a una fracción de su tamaño original mientras retiene esos datos, esa tiene que ser la razón por la que puede funcionar tan rápido en local.
Alicia
Absolutamente.
Beto
Estamos hablando de ejecutar este modelo con menos de cuatro gigabytes de VRAM. Para ponerlo en contexto, los portátiles modernos de gama media suelen tener el doble de memoria. Y está renderizando estas canciones completas en decenas de segundos en hardware empresarial de alto nivel o en menos de 10 segundos en una RTX 3090 de consumo estándar.
Pero otra vez, los modelos de difusión son notoriamente lentos. Por lo general toman docenas de pasos iterativos para esculpir el sonido a partir de ruido estático. ¿Cómo se mueve así de rápido?
Alicia
La trayectoria tradicional de difusión es un proceso muy lento y meticuloso: empiezas desde ruido gaussiano puro y das quizá entre 50 y 100 pequeños pasos para refinar el audio. ACE Step 1.5 sortea ese cuello de botella mediante un proceso especializado llamado destilación adversarial de desplazamiento dinámico.
Beto
Desglosemos la destilación adversarial de desplazamiento dinámico para quien no esté muy metido en arquitecturas de aprendizaje automático:
Alicia
Esencialmente entrenaron un modelo estudiante más pequeño y rápido para imitar al modelo profesor lento y meticuloso, pero lo hicieron de forma agresiva. Comprimieron la trayectoria de generación de esos 50 pasos individuales a solo 4–8 pasos.
Beto
Así que el modelo toma atajos algorítmicos masivos para llegar al archivo de audio final más rápido.
Alicia
Atajos altamente calculados, sí. Al usar un método de entrenamiento adversarial, que enfrenta al modelo generativo contra un modelo crítico que evalúa constantemente la salida y lo fuerza a mantener alta fidelidad, logran una aceleración de 100 veces. El crítico asegura que pasar de 50 pasos a 4 no resulte en ese sonido pastoso submarino que comentamos antes.
Beto
Es ingeniería increíble. Pero un modelo de IA es, en última instancia, tan bueno como los datos con los que se le alimenta.
Alicia
Cierto.
Beto
Los investigadores afirman que ACE Step 1.5 puede manejar más de 50 idiomas diferentes y más de 2000 estilos musicales distintos. ¿Cómo construyes una infraestructura de datos capaz de enseñar a un modelo ese nivel de teoría musical global sin simplemente raspar internet entero en un montón caótico?
Alicia
En realidad estamos viendo un cambio filosófico mayor en el entrenamiento de IA con este artículo. La industria se está alejando del enfoque “primero la cantidad”, donde simplemente vuelcas datos crudos y no curados en un servidor masivo y esperas que la IA encuentre el patrón.
Beto
El viejo método de fuerza bruta.
Alicia
Exacto. ACE Step 1.5 se construyó con un paradigma de alineamiento primero. Los investigadores priorizaron una precisión extrema sobre el volumen bruto.
Beto
Comenzaron usando Gemini 2.5 Pro para anotar cuidadosamente un conjunto dorado de 5 millones de muestras de audio.
Alicia
Sí.
Beto
Y luego usaron ese conjunto dorado prístino y de alta precisión para entrenar sus propios modelos internos especializados, a los que llamaron ACE-Captioner y ACE-Transcriber.
Alicia
Correcto.
Beto
Una vez que esos modelos internos fueron lo suficientemente inteligentes para reconocer matices musicales complejos, los dejaron procesar y anotar un conjunto de datos mucho mayor de 27 millones de muestras.
Alicia
Ese método de entrenamiento jerárquico asegura que los datos estén limpios.
Pero el obstáculo lingüístico sigue siendo enorme. Cuando un modelo necesita cantar en 50 idiomas, particularmente en idiomas no románicos como chino, japonés o tailandés, tiene que aprender miles de caracteres únicos y cómo se correlacionan con las vocalizaciones humanas.
Beto
Eso requiere un vocabulario interno masivo, lo cual ralentiza naturalmente cualquier modelo. Y aquí entra mi parte favorita de la metodología ...
Alicia
... los fonemas.
Beto
Sí. Para resolver la inflación del vocabulario, usaron el ingenioso truco llamado romanización estocástica.
Alicia
Es un brillante ejemplo de cómo una ingeniería de datos astuta puede sortear limitaciones computacionales masivas.
Beto
Para enseñar al modelo idiomas no románicos, tomaron aleatoriamente el 50% de las letras durante la fase de entrenamiento y las convirtieron en fonemas: solo los sonidos fonéticos de las palabras escritos en alfabeto romano. Haciendo esto, el modelo de pronto se da cuenta de que el sonido físico de la boca requerido para cierta sílaba en japonés se pronuncia exactamente igual que esta otra sílaba en español.
Alicia
Conecta los puntos.
Beto
Permitió al IA compartir reglas de pronunciación entre familias lingüísticas completamente distintas.
Alicia
Reduce drásticamente el vocabulario que el modelo necesita memorizar mientras mejora en realidad su pronunciación en general.
Pero más allá de la lingüística, también tuvieron que asegurar que el modelo realmente siguiera las instrucciones a la perfección, lo cual es notoriamente difícil cuando se trata de arte subjetivo.
Beto
Muy cierto.
Alicia
El método tradicional es el aprendizaje por refuerzo con retroalimentación humana, donde humanos califican la salida de la IA. Pero los humanos tienen sesgos inherentes. Preferimos ciertos géneros, o no detectamos errores de tempo sutiles. Para solucionar esto, los investigadores implementaron aprendizaje por refuerzo intrínseco.
Beto
Es decir, la IA se califica a sí misma. Elude por completo el cuello de botella humano.
Alicia
Sí. Se apoya en sus propias mecánicas internas para evaluar su desempeño. Por ejemplo, para asegurarse de que las letras coincidan con el ritmo de la música desarrollaron una puntuación de alineación de atención.
Beto
Interesante.
Alicia
El modelo literalmente revisa su propio trabajo para verificar que los picos de energía física en la forma de onda de audio, las partes más fuertes y contundentes del sonido, coincidan perfectamente con las sílabas de las letras que se le pidió cantar.
Beto
Así que sabe dónde están los golpes.
Alicia
Exacto. Si canta una palabra enfática en un momento fuera de pulso en el acompañamiento instrumental, se penaliza. Obliga a su propio mecanismo de atención a alinear el texto con la energía acústica.
Beto
Bueno, hemos cubierto el motor, la arquitectura y los datos de entrenamiento. Cambiemos y hablemos de lo que esto significa para ti, el oyente.
Alicia
La aplicación práctica.
Beto
Si eres un creador de contenido, editor de vídeo, músico aspirante o desarrollador indie de juegos, ¿por qué este modelo específico cambia tu flujo de trabajo? Porque esto va mucho más allá de simplemente escribir un prompt y obtener una pista de fondo.
Alicia
El artículo introduce lo que llaman un marco generativo con máscara, que transforma a ACE Step 1.5 en un modelo Omni-task. Es la navaja suiza creativa definitiva. No solo genera música desde cero. Edita, manipula y expande audio existente de forma quirúrgica.
Beto
Recorramos algunas de estas aplicaciones prácticas, empezando por la generación de covers. Puedes alimentar al modelo con una pista existente y éste mapeará el esqueleto melódico de esa canción. Mantiene la melodía central intacta, pero puede sustituir totalmente los instrumentos, el género y el timbre vocal.
Alicia
Es increíble.
Beto
Imagina que estás editando un vídeo y tienes una canción folk acústica con licencia, pero la escena requiere energía alta. Puedes indicarle al modelo que convierta esa misma melodía folk en un himno heavy metal o en una pista synth-pop, ajustando el ritmo exactamente al montaje de tu edición.
Alicia
Las implicaciones en el flujo de trabajo son enormes, y eso se extiende a ediciones quirúrgicas con una función llamada "repainting". Piensa en esto como edición no destructiva avanzada de imágenes, pero aplicada a una forma de onda. Supongamos que generas una pista de jazz fenomenal, pero el solo de saxofón en el minuto dos desafina o no encaja con la vibra.
Beto
Antes tenías que tirar la canción entera y volver a generar con suerte mejor.
Alicia
Exacto. Pero con repainting, marcas solo esos diez segundos de solo de saxofón, pides al modelo que lo cambie por una trompeta apagada y fusiona sin fisuras el nuevo audio con la pista existente sin alterar una sola nota del entorno.
Beto
También introducen extracción de pistas y capacidades tipo Lego. La extracción de pistas es esencialmente separación de stems a nivel microscópico. Puedes pedir al modelo que te saque únicamente la voz principal o que aisle una línea de bajo compleja de una mezcla totalmente masterizada y densa.
Alicia
Y la función Lego es el inverso.
Beto
Sí, y es un cambio de juego para creadores independientes. Piensa en un desarrollador indie que compró un loop de piano sencillo barato online. Le sirve para la pantalla del menú, pero ahora necesita un arreglo orquestal épico completo alrededor de esa misma melodía de piano para una batalla jefe.
Alicia
No tienen presupuesto para contratar a un compositor.
Beto
Correcto. Solo alimentan esa sola capa de piano al modelo y le piden que orqueste una pieza sinfónica completa a partir de ella, capa por capa, construyendo la pista como ladrillos Lego.
Alicia
Ese nivel de control granular es sin precedentes para un modelo local. Y ni siquiera hemos hablado de la clonación de timbre cero-shot.
Esto es la herramienta máxima para la personalización. Si quieres que el modelo cante una canción nueva con tu voz exacta, o emule el estilo de mezcla crudo de tu productor underground favorito, puedes entrenar un LoRA ligero, un pequeño archivo personalizable.
Beto
O basta con usar un clip de referencia, ¿verdad?
Alicia
Sí, puedes proporcionar simplemente un clip de referencia de 30 segundos. El modelo analiza ese breve fragmento y captura a la perfección el tono vocal o la huella estilística para cualquier nueva generación.
Beto
Esto nos lleva a una crítica mayor que los propios investigadores hacen de la industria actual de IA: argumentan que las métricas tradicionales de evaluación de música AI como AudioBox o SongEval están fundamentalmente mal diseñadas para aplicaciones prácticas del mundo real.
Alicia
Esas métricas tradicionales básicamente prueban si una canción suena agradable en el vacío. Miden calidad de audio cruda y alineación básica con el texto, pero no capturan la fricción de lo que realmente se siente al sentarse y usar esta IA en un entorno profesional de alta presión. Un puntaje alto en AudioBox es inútil para un productor si el modelo se cae cada vez que el prompt está un poco confuso, o si tarda cinco minutos en generar una sola iteración.
Beto
Así que para abordar esto, los investigadores crearon un paradigma de evaluación completamente nuevo: la lista de verificación de 17 puntos de usabilidad. Me encanta esta lista porque lee como un silbido de frustración de productores musicales profundamente frustrados. Resaltemos algunos criterios para mostrar cómo esto cambia el flujo de trabajo diario.
Primero está el "coeficiente de casualidad".
Alicia
El coeficiente de casualidad mide la capacidad del modelo para producir rápidamente un alto volumen de candidatos diversos en un flujo creativo cuando tienes bloqueo del escritor. Rara vez sabes exactamente lo que quieres hasta que lo escuchas.
Beto
Solo necesitas opciones.
Alicia
Exacto. Debido a que ACE Step 1.5 genera pistas en menos de 10 segundos, puedes generar por lotes decenas de variaciones al instante. Está diseñado matemáticamente para maximizar los accidentes creativos felices. Podrías tropezarte con una línea de bajo sincopada que nunca habrías pensado conscientemente escribir, puramente porque la herramienta te permite explorar el espacio latente tan rápidamente.
Beto
Otro punto crucial en la lista es la robustez del prompt, que subtitularon como "el requisito anti-goture".
Alicia
Oh, eso es grande.
Beto
Si alguna vez has usado modelos antiguos, conoces el dolor del colapso de modo. Parecía jugar a una máquina traga-monedas: si tu prompt era un poco vago, o tenía una falta de ortografía, el modelo esencialmente tenía un ataque de pánico y devolvía basura chirriante.
Alicia
Audio completamente inutilizable.
Beto
Correcto. Pero ACE Step 1.5 es robusto. No fallará ni se bloqueará porque tu formato no sea perfecto. El cerebro del modelo de lenguaje que discutimos antes interviene, deduce lo que querías decir por contexto y estructura un track viable.
Alicia
Y para los profesionales, quizás la métrica más importante en la lista es el estar basado en la terminología profesional. Muchos modelos convencionales generan aproximaciones genéricas de un estado de ánimo. Si pides una canción triste obtienes un piano lento con mucho reverb.
Beto
Muy básico.
Alicia
Pero ACE Step 1.5 entiende la jerga técnica profunda.
Beto
El artículo especifica que si escribes instrucciones utilizando términos como "modo frigio", "compresión sidechain" o "un barrido resonante de un sintetizador 303 vintage", el modelo no se limita a adivinar.
Alicia
No. Lo sabe.
Beto
Traduce esa jerga técnica exacta en fenómenos acústicos altamente precisos. Sabe exactamente cómo debe sonar el barrido resonante chirriante de un sintetizador Roland TB-303 y lo renderiza impecablemente dentro de la mezcla. Responde a la dirección técnica como un músico de sesión con experiencia.
Alicia
Lo que observamos con ACE Step 1.5 es un salto increíble para la comunidad de código abierto. Finalmente tenemos una herramienta que es de calidad comercial, altamente controlable, extremadamente rápida y capaz de ejecutarse localmente en hardware de consumo.
Beto
Está todo ahí.
Alicia
Al separar la lógica de la composición del renderizado del sonido y arreglar los cuellos de botella acústicos de las arquitecturas anteriores, han proporcionado un conjunto de herramientas de edición que rivalizan con el software de estudio de primer nivel.
Beto
Reescribe fundamentalmente la barrera de entrada. Si la ejecución, el renderizado físico real de audio de calidad profesional, baja a costo cero y requiere nada más que un portátil, el paisaje de quién puede ser creador se expande exponencialmente.
Alicia
Democratiza por completo el medio, pero también nos obliga a reconsiderar el valor de las habilidades que tradicionalmente hemos celebrado en la industria musical.
Beto
Te deja preguntándote: si un modelo de código abierto ejecutándose en un portátil estándar puede clonar perfectamente un timbre vocal, repintar quirúrgicamente un solo de guitarra e interpretar instantáneamente jerga compleja como compresión sidechain en audio impecable, ¿qué pasa con nuestra definición tradicional de talento musical?
Alicia
Esa es la verdadera pregunta.
Beto
Si la barrera técnica para una ejecución impecable desaparece, quizá lo único que separa una pista brillante de una mediocre sea el gusto humano. ¿Estamos entrando en una era donde el rasgo definitorio de un gran músico ya no es la maestría física de tocar notas, sino puramente tener el gusto visionario para curarlas, dirigirlas y comandarlas?
Alicia
Es un cambio de paradigma enorme.
Beto
Es, sin duda, algo para pensar la próxima vez que escuches una pista bellamente producida.
Gracias por acompañarnos en esta inmersión profunda y sigue explorando.


 Entradas


