
En esta presentación, François Chollet argumenta que lograr la Inteligencia General Artificial (AGI) requiere un cambio fundamental: pasar de escalar modelos preentrenados a desarrollar sistemas capaces de adaptarse al tiempo de prueba. Sostiene que la IA actual destaca en la memorización de habilidades estáticas, pero carece de inteligencia fluida, que él define como la eficiencia con la que un sistema se adapta a situaciones novedosas. Para abordar esto, Chollet presentó el punto de referencia ARC-AGI, una prueba de estilo IQ diseñada para medir la capacidad de una máquina para razonar y resolver problemas únicos en lugar de regurgitar datos de entrenamiento. Explica que la verdadera inteligencia surge de la combinación de la intuición de tipo uno (el reconocimiento de patrones del aprendizaje profundo) con el razonamiento de tipo dos, que implica la búsqueda discreta de programas y la síntesis lógica. Al fusionar estos dos enfoques, su objetivo es ir más allá de la simple automatización hacia una IA capaz de invención autónoma y descubrimiento científico. El futuro del desarrollo de la IA, según Chollet, radica en la creación de metaparecencieros similares a programadores que puedan ensamblar y refinar dinámicamente abstracciones para navegar en un mundo impredecible.
Enlace al video en YouTube, para aquellos que quieran profudizar en el tema: "François Chollet: How We Get To AGI".
El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.
El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.
Resumen
Alicia
Bienvenidos a un nuevo análisis profundo. Sabes, pasando tiempo en el mundo tecnológico estos últimos años, da la sensación de que todos hemos estado viviendo una enorme alucinación colectiva. Quiero decir, si retrocedes solo dos años hasta el pico absoluto del boom de la IA generativa, ¿qué, 2023, 2024?
Beto
Sí, exacto.
Alicia
Había una creencia absoluta e inamovible en el aire.
Beto
El dogma del escalado.
Alicia
Exacto, el dogma del escalado. La idea era tan simple. Tenemos estos grandes modelos de lenguaje. Si simplemente los hacemos más grandes, ...
Beto
... les ponemos más GPUs, ...
Alicia
... consumimos la electricidad de un país pequeño, les damos hasta el último fragmento de datos en internet. Inequívocamente se despertarán. Pensábamos que la IAG (inteligencia artificial general, AGI) era solo cuestión de más.
Beto
Era la era del “hacia arriba y a la derecha”. Miras la gráfica de rendimiento, la extrapolas y asumes que esa línea va al infinito como procedimiento estándar.
Pero hoy estamos haciendo un serio chequeo de la realidad. Estamos profundizando en una charla reciente del investigador en IA, François Challet, que básicamente dice que "la fiesta se acabó".
Alicia
Y esto no es solo una advertencia de desaceleración. Es un desmantelamiento completo de cómo pensábamos que funcionaba la IAG. El argumento de Challet es que la era del escalado ha muerto. Nos topamos con un muro. Pero — y por eso estoy tan entusiasmada con este análisis profundo — dice que hemos encontrado una nueva puerta. Pasamos de la era del chatbot a la era del programador de IA.
Beto
Es un momento pivotal. Estamos cambiando de pensar en la IA como "un sistema de recuperación de conocimiento", como un bibliotecario muy sofisticado, a pensar en ella como "un verdadero motor de razonamiento".
Alicia
Y para llegar ahí, tenemos que empezar con esta verdad realmente incómoda que él expone. Hemos estado confundiendo "habilidad" con "inteligencia".
Beto
Y ese es todo el meollo.
Alicia
Eso fue el primer golpe fuerte en el material fuente para mí, porque intuitivamente, si una máquina puede pasar el examen de abogado, escribir un script en Python y componer un soneto, yo llamo eso inteligente. Eso se siente como inteligente.
Beto
Bueno, esa es la definición al estilo Minsky. Nombrada por Marvin Minsky, la visión muy corporativa y enfocada en la producción. Si la máquina hace la tarea económicamente valiosa, si automatiza el trabajo, la llamamos “lista”.
Alicia
Pero Challet dice que eso es una trampa.
Beto
Una trampa enorme. Dice que eso no es inteligencia. Eso es sólo una habilidad cristalizada.
Alicia
Usó una metáfora que me pareció brillante: la red de carreteras frente a la empresa constructora de carreteras.
Beto
Es la forma perfecta de visualizarlo. Piensa en un gran modelo de lenguaje, como los GPTs que todos hemos usado durante años, como el mapa de una vasta red de carreteras. Si quieres ir del punto A al punto B, y los humanos ya construyeron una carretera ahí, la IA puede llevarte por esa ruta al instante. Es rápida, es impresionante, y parece que sabe a dónde va.
Alicia
Porque ya ha visto esa ruta antes. Está en los datos de entrenamiento. Solo está volviendo a trazar el paso.
Beto
Exacto. Pero aquí está la prueba real. La prueba de la verdadera inteligencia. ¿Qué pasa cuando le pides que vaya al punto C, y no hay carretera? ¿Qué pasa cuando la dejas en medio de un bosque denso donde ningún humano alguna vez puso una calzada?
Alicia
Los modelos actuales simplemente alucinan. Pretenden que hay una carretera. Pisan el acelerador y te llevan directo al precipicio.
Beto
Precisamente. En cambio, la verdadera inteligencia — la IAG — es la cuadrilla constructora de carreteras. La inteligencia no es el mapa. La inteligencia es la bulldozer. Es el proceso de mirar un terreno completamente nuevo, una situación que jamás has visto antes, y averiguar cómo construir un camino.
Alicia
Si entiendo bien esta razón de eficiencia, él habla de cuánto datos necesitas para aprender algo nuevo. Si una IA necesita leer 10 millones de poemas para escribir una rima simple, no es lista. Solo se apoya en una enorme base de datos de carreteras que los humanos ya construyeron.
Beto
Ese es el corazón matemático de su argumento. Define la inteligencia como una relación de conversión. En un lado tienes tus priors. Tus conocimientos innatos. Tus experiencias pasadas. En el otro lado tienes tu generalización. Qué tan bien manejas lo desconocido. Si necesitas datos masivos para hacer una tarea simple, tu ratio de conversión es terrible. Eres simplemente ineficiente.
Alicia
Dame un ejemplo humano.
Beto
OK, piensa en un niño. Le muestras a un niño de cuatro años tres fotos de un gato, solo tres. Y, de repente, ese niño puede reconocer todos los gatos que existen: gatos de dibujos, gatos durmiendo, gatos carey.
Alicia
Y la IA necesita miles, millones, ...
Beto
... tal vez decenas de miles de imágenes para hacer lo mismo. Esa brecha, eso es la inteligencia. La IA lo está forzando bruta. El niño lo está abstrayendo.
Alicia
Esto explica realmente por qué nos dejamos engañar tan fácilmente por los benchmarks durante tanto tiempo. Durante años, los titulares eran todos “IA aplasta los SATs”. “IA pasa los exámenes médicos”.
Beto
Los tratábamos como pruebas de pensamiento. Pero en realidad eran pruebas de memorización. Caímos en la regla del atajo. En ingeniería, si eliges una métrica, el sistema la optimizará. Los exámenes estándar miden conocimiento estático. Pero los LLMs están entrenados en la internet pública.
Alicia
Básicamente llevan la clave de respuestas en el bolsillo.
Beto
Es como impresionarse de que un niño sacó un sobresaliente en historia y luego descubrir que tenía el libro abierto en el regazo todo el tiempo.
Alicia
Exacto.
Beto
Así que, en 2019, Challet dijo: necesitamos una prueba donde no puedas hacer trampa. Y creó ARC, el "Abstraction and Reasoning Corpus".
Alicia
Pasé algún tiempo investigándolo. Los rompecabezas, o acertijos, de ARC me recuerdan a esas viejas pruebas de coeficiente intelectual. Cuadrículas simples, cuadrados coloreados. Ves un cuadrado azul moviéndose a la izquierda, un cuadrado rojo quedándose quieto. ¿Qué pasa después?
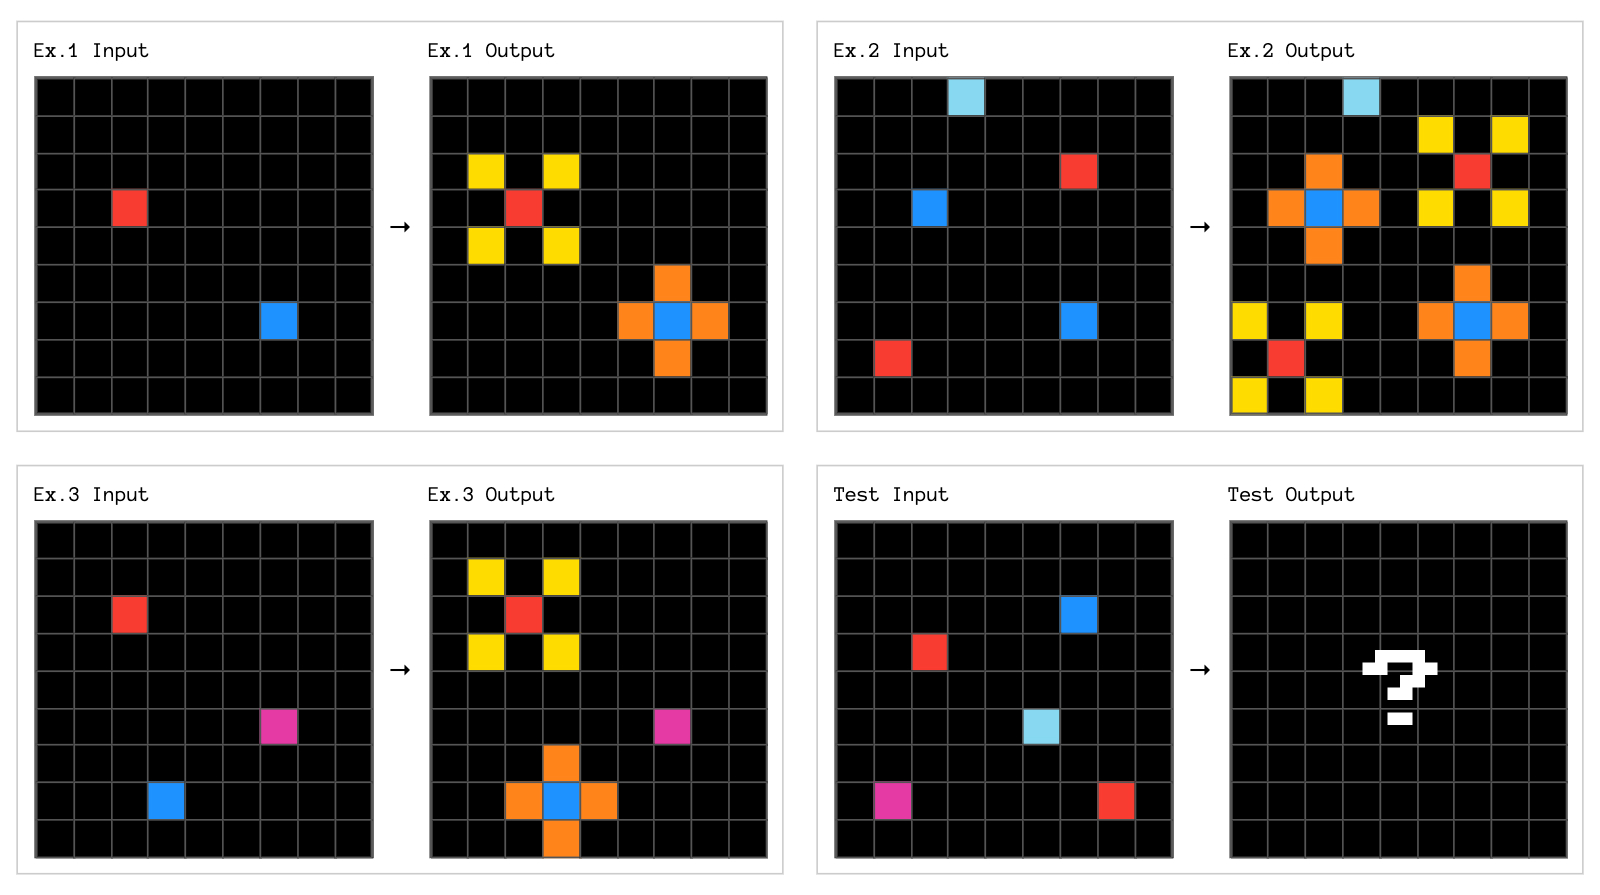
Ejemplo de tarea ARC-AGI
Beto
Visualmente son increíblemente simples. Pero la trampa es que cada rompecabezas en la prueba ARC es único. El patrón específico nunca ha aparecido en internet.
Alicia
Así que no puedes memorizar la respuesta.
Beto
No puedes. Porque la respuesta no existe en ningún lugar de los datos de entrenamiento. Tienes que mirar la cuadrícula, deducir la regla al vuelo. ¿Es gravedad? ¿Es simetría? ¿Es contar? Y luego aplicarla.
Alicia
Y durante mucho tiempo, los modelos multimillonarios estuvieron puntuando… ¿qué? Casi cero. Fue embarazoso. Mientras escribían poesía shakespeariana, no podían resolver un rompecabezas que un niño de cuatro años podría resolver. Esa fue la evidencia decisiva de que el escalado no estaba funcionando. No puedes escalar para resolver un rompecabezas que nunca has visto.
Beto
Corrrecto. Y esto es un gran giro en nuestra historia hoy, eso cambió recientemente. Tenemos que hablar del momento o3 a finales de 2024.
Alicia
Sí. OpenAI lanzó el modelo o3, y finalmente descifró el código del ARC original. Alcanzó rendimiento a nivel humano.
Beto
¿Resolvían la IAG? ¿Descubrieron la cuestión de construir carreteras?
Alicia
Resolveron una parte muy específica, lo que nos lleva al segundo concepto importante de esta inmersión: la adaptación en tiempo de prueba.
Beto
OK, desglósamelo.
Alicia
"Adaptación en tiempo de prueba" ("test-time adaptation"). Suena a jerga, pero el concepto es bastante relatable, ¿no?
Beto
Lo es. Tradicionalmente, una IA es estática. La entrenas. La congelas. Y cuando le haces una pregunta, solo escupe la palabra más probable siguiente. Es un reflejo instantáneo.
Alicia
Una reacción automática. Así que cuando alguien pregunta “¿cómo estás?” y dices “bien” antes de comprobar si realmente lo estás.
Beto
Exactamente. Pero o3 hace algo diferente. Cuando le das un problema, no responde de inmediato. Se pausa. Piensa. Genera múltiples posibilidades. Tal vez intenta escribir un pequeño fragmento de código internamente para probar una teoría, ve si funciona, y luego itera. Adapta su comportamiento durante la prueba.
Alicia
Está mostrando su trabajo.
Beto
Está buscando. Esencialmente corre una pequeña simulación en su cabeza antes de hablar. Y eso le permitió abrirse paso por la lógica del primer test ARC mediante fuerza bruta.
Alicia
Bien. Entonces, si o3 descifró ARC-1, ¿por qué Challet sigue diciendo que no hemos llegado? ¿Por qué esto no es el final de la discusión?
Beto
Porque Challet, siendo el científico que es, movió inmediatamente el listón. Lanzó ARC-2. Y aquí es donde la brecha entre la inteligencia humana y la simulación de máquina se vuelve dolorosamente, casi cómicamente obvia.
Alicia
El experimento de San Diego, me encanta esa parte de las notas, se sintió como el montaje de un reality show.
Beto
Es ciencia fantástica. La crítica a ARC-1 siempre fue: bueno, tal vez esos rompecabezas son demasiado difíciles para cualquiera. Así que quisieron comparar ARC-2 con humanos normales. No fueron a MIT. No fueron a Stanford. Fueron a San Diego y reclutaron 400 personas al azar, conductores de Uber, estudiantes, gente buscando trabajo rápido.
Alicia
Personas comunes en la calle: “oye, ¿quieres 20 dólares? Resuelve este rompecabezas”.
Beto
Exacto. Estos rompecabezas lógicos, el resultado: si tomabas un grupo de 10 humanos al azar y les permitías votar la respuesta, puntuaban 100%.
Alicia
100%. Así que son tareas solucionables.
Beto
Realmente solucionables. Y la IA, los supermodelos que costaron cientos de millones de dólares entrenar, los mejores modelos obtuvieron 0%.
Cero absoluto. Incluso los modelos de razonamiento que usaron esa adaptación en tiempo de prueba que acabamos de comentar apenas rascaron 1% o 2%.
Alicia
Eso es una desconexión asombrosa. Humanos 100%. Máquinas 0%. ¿Qué está probando ARC2 que rompe a las máquinas tan mal?
Beto
Está probando la generalización composicional.
Alicia
OK, eso es un bocado. Desgranémoslo.
Beto
Es la capacidad de tomar dos conceptos distintos que ya conoces, digamos el concepto de gravedad y el concepto de ordenar por color, y combinarlos de una manera completamente nueva para resolver un problema que nunca has visto.
Alicia
No se trata solo de reconocer un patrón, se trata de remezclar patrones.
Beto
Es extrapolación. El "deep learning" ("aprendizaje profundo") tal como existe hoy es fantástico en interpolación. Adivinar lo que hay entre puntos de datos que ya vio es como conectar los puntos. Pero es terrible en extrapolación: salir de esos puntos para construir una forma nueva por completo.
Alicia
Así que tienes estos cerebros masivos que pueden memorizar el mundo, pero no pueden inventar un nuevo pensamiento.
Beto
No pueden razonar frente a la novedad. Y esto nos lleva a la parte más alocada de la teoría de Challet. Él la llama "la hipótesis del caleidoscopio".
Alicia
Tengo que decir, para ser informático, se le ocurren nombres muy poéticos.
Beto
Realmente. La hipótesis del caleidoscopio básicamente dice que el universo parece infinitamente complejo, pero eso es una ilusión. En realidad, todo lo que vemos es solo una remezcla de un conjunto muy pequeño de átomos fundamentales de significado.
Alicia
Átomos de significado.
Beto
Piensa en un caleidoscopio. Dentro del tubo solo hay unas pocas cuentas de colores, quizá cinco o seis. Pero al girar el tubo, los espejos reflejan y recombinan esas cuentas en patrones complejos infinitos.
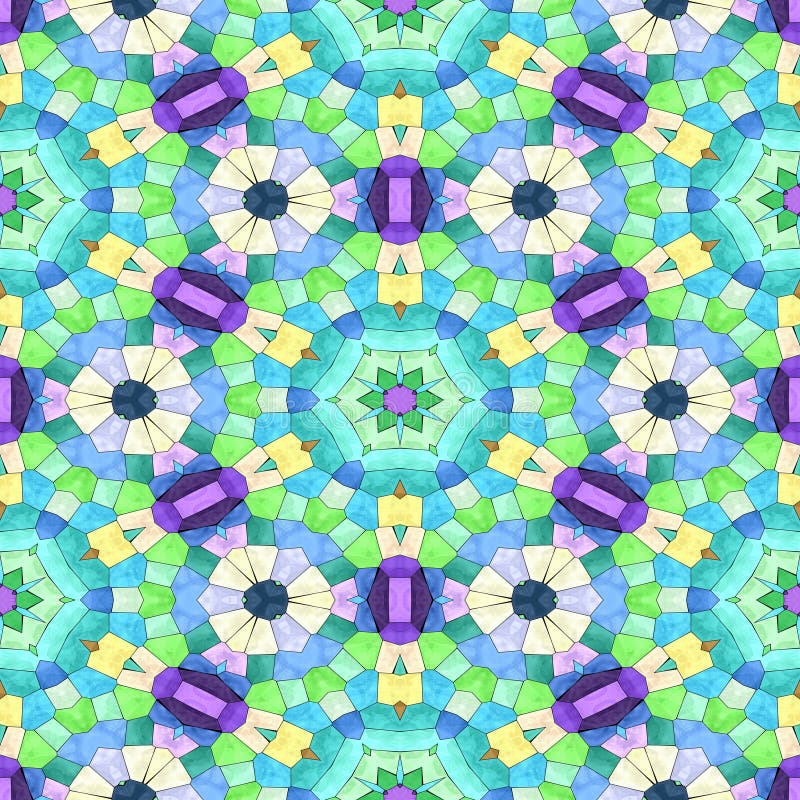
Ejemplo de una imagen de caleidoscopio
Alicia
Lo veo. Miras el patrón, parece complicado. Pero si entiendes el mecanismo, sabes que es solo cuenta púrpura + cuenta verde + espejo.
Beto
Exacto. La inteligencia es la habilidad de mirar el mundo complejo y revertirlo hasta esos átomos. Por ejemplo, una estructura ramificada. La ves en el árbol, en el delta de un río, en las venas de un pulmón humano. Es el mismo átomo de significado aplicado en contextos distintos. Si realmente entiendes la ramificación, puedes entender todos esos sistemas.
Alicia
Y entonces Challet argumenta que para construir una IAG necesitamos un sistema que pueda manejar estos átomos usando dos tipos distintos de pensamiento.
Beto
Cierto. Lo descompone en abstracción de tipo uno y tipo dos. Puedes pensarlo como hemisferio derecho e izquierdo.
Alicia
Entonces, tipo uno es el hemisferio derecho. Es la parte de la intuición.
Beto
Sí. Tipo uno es percepción. Es continua. Es difusa. Es como reconocer una cara en una multitud. No sacas una regla y mides la distancia entre los ojos. Simplemente sabes. Esto es en lo que el deep learning y los transformers son increíbles. Tienen una intuición increíble. Pueden “vibrar” hasta una respuesta.
Alicia
Y tipo dos.
Beto
Tipo dos es el hemisferio izquierdo. Es la lógica. Es discreto. Es planificación paso a paso. Esto es lo que es el código de computadora. Si estás ordenando una lista de nombres alfabéticamente, las corazonadas no funcionan. Tiene que ser exacto. Si fallas una letra, toda la palabra está mal. El deep learning en realidad es terrible en esto porque es probabilístico. Siempre está adivinando.
Alicia
Hasta ahora hemos intentado construir una IAG usando solo el hemisferio derecho. Intentamos usar intuición para hacer matemáticas.
Beto
Y por eso alucina: intenta intuir un hecho lógico. El futuro, según Challet, es híbrido. Es el programador de IA.
Alicia
Este es el cambio. De chatbot a programador, ¿cómo funciona eso en la práctica? No estamos hablando solo que chatGPT escriba un script para mí.
Beto
No, no. Es mucho más profundo. Es en lo que labs como Tendi están trabajando. En lugar de pedirle a un modelo que simplemente te hable, le pides que resuelva un problema. El modelo efectivamente dice: “OK, no sé la respuesta de inmediato. Pero puedo escribir un programa para encontrarla”.
Alicia
Entonces usa la intuición tipo 1 para decidir qué escribir.
Beto
Sí. Usa el “cerebro derecho” de deep learning para buscar en su biblioteca de átomos, esos pequeños fragmentos de código, funciones lógicas, y los cose. Sintetiza un nuevo programa específicamente para tu problema.
Alicia
Y luego el hemisferio izquierdo tipo 2 ejecuta ese código.
Beto
Exacto. Y ese es el truco mágico. El código no alucina. Si el código compila y corre, la respuesta es lógicamente válida. Está anclada en la realidad.
Alicia
Eso suena como un salto enorme. En lugar de una máquina que dice “creo que la respuesta es 42”, es una máquina que dice “escribí un script, ejecuté el cálculo y la salida es 42”.
Beto
Es la diferencia entre alquimia y química. Y lo fascinante es que este sistema puede aprender. Cuando resuelve un problema nuevo, por ejemplo, si descubre una nueva forma de ordenar datos, puede guardar ese pequeño programa de vuelta en su biblioteca. Añade un nuevo átomo a su caleidoscopio.
Alicia
Así que en realidad está construyendo la compañía constructora de carreteras. Está acumulando herramientas.
Beto
Está construyendo las herramientas que construyen las carreteras. Se vuelve más lista, no por memorizar más texto, sino por expandir su caja de herramientas lógicas.
Alicia
Tiene tanto sentido por qué la "adaptación en tiempo de prueba" es la palabra de moda entonces. La inteligencia no está en el modelo congelado. Está ocurriendo en vivo mientras escribe y prueba ese código.
Beto
Y esta trayectoria nos lleva a donde va la pelota. Porque si ARC-2 es el obstáculo actual, ya se están provocando retos que insinúan ARC-3, que aparentemente viene en 2026.
Alicia
Y esto sonó divertido en las notas: ARC-3 son videojuegos.
Beto
Lo es. Pero no se trata de puntajes altos. Es una prueba de agencia. Imagina dejar a una IA en un videojuego simple que nunca ha visto antes. No sabe los controles. No sabe si debe saltar, disparar o recoger monedas. Tiene que averiguarlo.
Alicia
Siento que he visto a mis amigos jugar así: se estrellan contra una pared durante 10 minutos hasta que presionan el botón correcto.
Beto
Y eso es exactamente lo que la IA no puede hacer. La restricción clave para ARC-3 es la eficiencia. Challet va a limitar cuántas acciones puede tomar la IA. No puede simplemente aporrear botones un millón de veces a la velocidad de la luz. Uh-oh. Tiene que mirar la pantalla, usar esa intuición tipo 1 para adivinar “eh, eso azul parece agua, probablemente no debería pisarlo”, y luego usar la lógica tipo 2 para planear una ruta por el puente.
Alicia
Tiene que aprender a la velocidad de un humano.
Beto
Ese es el santo grial. Si podemos construir una IA que aprenda un nuevo entorno tan eficientemente como un humano, hemos pasado de la automatización a la invención.
Alicia
Distingamos esos dos porque en el mundo corporativo suenan igual. Automatización, invención.
Beto
Son mundos aparte. Si nos quedamos con los modelos viejos de escalado, las redes de carreteras, conseguimos automatización. Podemos automatizar correos, servicio al cliente, codificación básica. Eso es enorme económicamente. Claro, abarata las cosas existentes. Pero no resuelve problemas nuevos.
Alicia
Solo hace lo antiguo más rápido.
Beto
Correcto. Pero la vía de la invención, el programador IA, el científico, lleva al descubrimiento. Una IA que puede inventar no solo escribe un email de marketing. Mira un conjunto de datos biológicos que ningún humano entiende y escribe un programa para modelar una nueva estructura proteica.
Alicia
Wow.
Beto
Descubre la física de un reactor de fusión. Resuelve problemas para los que aún no tenemos la clave de respuestas.
Alicia
Esa es una visión mucho más inspiradora. No se trata solo de reemplazar el centro de atención telefónica. Se trata de asociarse con el investigador del cáncer.
Beto
Es la diferencia entre una IA que optimiza la economía que ya tenemos y una IA que expande el horizonte de lo posible para nuestra especie.
Alicia
Para recapitular el viaje de hoy: empezamos con la muerte del dogma del escalado. Nos dimos cuenta de que solo hacer el cerebro más grande no lo hace más inteligente.
Beto
Aprendimos que la verdadera inteligencia es un proceso. Es una compañía constructora de carreteras. Y se mide por cuán eficientemente puedes adaptarte a lo desconocido.
Alicia
Vimos que, mientras la IA finalmente descifró el primer test tipo IQ, ARC-1, se desplomó por completo en ARC-2 porque le falta esa lógica rigurosa del hemisferio izquierdo.
Beto
Y la solución es el caleidoscopio. Es el modelo híbrido, combinando el reconocimiento de patrones del deep learning con la lógica discreta y fiable de un programador.
Alicia
Realmente me hace mirar mi propio proceso de pensamiento de forma distinta. Cuando estoy atascada en un problema, ¿estoy simplemente tratando de recordar qué hice la última vez? ¿O estoy realmente activando mi lógica tipo 2 para construir una solución nueva?
Beto
Todos confiamos en el tipo 1 más de lo que admitimos. Es más fácil. Las corazonadas son baratas. La lógica es cara. Pero la magia de la inteligencia humana es que podemos cambiar. Y la búsqueda de la IAG es realmente la búsqueda de construir una máquina que tenga esa misma flexibilidad.
Alicia
Un espejo hecho de silicio.
Beto
Y dejo al oyente con este pensamiento. A menudo tememos a la IAG porque pensamos que será ajena. Una caja negra y fría que lo sabe todo. Pero si Challet tiene razón, la verdadera IAG será sorprendentemente familiar. No será un dios. Será un científico. Se detendrá. Dirá “no lo sé”. Intentará experimentar. Fracasará. Reescribirá su código. Y lo intentará de nuevo. Y personalmente, me resulta mucho más reconfortante una máquina que admite que necesita pensar que una que finge saberlo todo.
Alicia
Un científico que nunca duerme y que aprende a la velocidad de la luz.
Beto
Exacto.
Alicia
Bueno, esto es todo para este análisis profundo. Quiero que te lleves esta pregunta hoy: ¿estás construyendo carreteras o solo conduces por las que ya conoces?
Beto
Siempre sigue construyendo.
Alicia
Gracias por escuchar a todos. Nos vemos en el próximo episodio.




 Entradas


