Mostrando entradas con la etiqueta percepción. Mostrar todas las entradas

sábado, 14 de noviembre de 2026

Conciencia, Realidad y las Matemáticas de la Percepción

Las fuentes presentadas exploran la intersección de la ciencia cognitiva, la física cuántica y la filosofía matemática, argumentando que la conciencia humana y la realidad objetiva se malinterpretan fundamentalmente. Los investigadores explican cómo la teoría de juegos evolutiva demuestra que nuestros sistemas sensoriales evolucionaron estrictamente para la aptitud reproductiva en lugar de para percibir la verdad, lo que significa que el espacio-tiempo y los objetos físicos son simplemente cascos de realidad virtual simplificados. Para superar las lagunas de la ciencia moderna, en particular el problema de la medición cuántica, los expertos proponen un marco no físico que utiliza la lógica de traza recursiva y las cadenas de Markov. Este modelo sugiere que la encarnación es estadísticamente rara y que el universo, en cambio, está repleto de inteligencia colectiva multiescala desencarnada. En última instancia, esta perspectiva reconcilia el materialismo científico tradicional con antiguos conceptos espirituales, proponiendo que la conciencia fundamental y los modelos centrados en el observador son esenciales para comprender la realidad.

Enlace la entrevista al profesor Donald D. Hoffman, psicólogo cognitivo de UC-Irvine, en el canal de Jesse Michels, para aquellos interesados en profundizar en el tema: "MIT Scientist: Your Brain Evolved To Ignore Aliens – They’re Everywhere!". Publicado el 2 de Junio de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Entonces, si te dijera que tus ojos y tus oídos fueron diseñados explícitamente, por la evolución, para engañarte.

Alicia
Vaya.

Beto
Sí. Y que matemáticamente hay un 0% de probabilidad de que estés viendo la realidad objetiva en este momento. ¿Me creerías?

Alicia
Suena completamente absurdo en su forma, ¿verdad? Simplemente confiamos implícitamente en nuestros sentidos para navegar la vida diaria.

Beto
Claro. Sí lo hacemos.

Alicia
Asumimos que cuando tomamos una taza de café caliente, el calor, el líquido oscuro, la taza de cerámica real, todo eso son verdades objetivas y fundamentales del universo.

Beto
Pero hoy estamos haciendo una inmersión profunda en un paradigma totalmente diferente. Estamos explorando el trabajo radical de manipulación mental del científico cognitivo Don Hoffman.

Alicia
Sí, son cosas fascinantes.

Beto
Lo son. Así que la misión para este análisis profundo es desempacar una hipótesis respaldada por rigurosa teoría de juegos evolutivos y matemáticas avanzadas.

Básicamente, el argumento de que todo lo que ven a su alrededor, incluso el dispositivo en el que están escuchando ahora mismo, es solo una ilusión localizada.

Alicia
Sí. Y también estamos viendo la teoría de la física realmente radical que busca demostrar que esta ilusión localizada ...

Beto
Lo cual es enorme.

Alicia
Lo es. Es un marco que sugiere que los conceptos mismos del espacio y el tiempo son solo herramientas de compresión de datos para nuestra especie.

Beto
Compresión de datos. Vaya.

Alicia
Sí. Y la matemática que respalda esto está forzando una reevaluación total de lo que constituye la realidad física.

Observer-First_Reality_Model_1024.png
Más allá del espacio-tiempo: la realidad centrada en el observador.

Beto
Así que empecemos con la premisa central porque inmediatamente nos obliga a dudar, ¿verdad?

Alicia
Oh, absolutamente.

Beto
El argumento es que la evolución no favorece a las criaturas que ven la realidad tal como es. Creo que la frase que usan es "la aptitud supera a la verdad" ("fitness beating truth").

Alicia
Sí, la aptitud supera a la verdad.

Beto
Pero mecánicamente, ¿cómo proporciona un punto ciego una ventaja de supervivencia? Porque si un humano prehistórico no ve la realidad de un tigre atacando o el borde de un acantilado, va a morir.

Alicia
Claro. Quiero decir, cuando Darwin formuló por primera vez la selección natural, la suposición básica era exactamente esa: cuanto más precisa sea tu percepción de la realidad, mejor equipado estás para sobrevivir.

Beto
Tiene sentido lógico.

Alicia
Sí lo tiene. Pero cuando traducimos la teoría de Darwin a matemáticas realmente rigurosas, específicamente usando la teoría de juegos evolutivos de John Maynard Smith, bueno, las matemáticas cuentan una historia completamente diferente.

Beto
Está bien. ¿Cómo es eso?

Alicia
Las matemáticas calculan la probabilidad de que cualquier sistema sensorial en cualquier organismo haya evolucionado para ver la verdad objetiva de la realidad. Y esa probabilidad cae a cero.

Beto
¿Cero?

Alicia
Cero.

Beto
¿No tiene una probabilidad marginal o un pequeño porcentaje?

Alicia
Cero. Literalmente cero por ciento.

Beto
Eso es salvaje.

Alicia
Ya sé. La teoría de juegos evolutivos se basa en estas cosas llamadas "funciones de pago de aptitud" ("fitness payoff functions"). Así que calcula qué acciones específicas mantienen a un organismo vivo lo suficiente para reproducirse dentro de su entorno.

Para que un sistema sensorial evolucione, para ver estructuras objetivas verdaderas, tal como la estructura cuántica real del universo, la función de pago tendría que recompensar directamente el conocimiento de esa estructura compleja.

Beto
Pero la evolución no le importa eso.

Alicia
Exacto. Solo recompensa los comportamientos de supervivencia. Le importa si comes, te apareas y, evitas a los depredadores.

Beto
Así que ¿es la verdad demasiado cara?

Alicia
La verdad es increíblemente biológicamente costosa. Procesar la realidad fundamental del universo requeriría tanta energía y tiempo que un organismo sería comido antes de que pudiera terminar de renderizar la imagen del depredador.

Beto
Está bien, necesito un puente aquí para conectar esta matemática abstracta con la vida diaria. ¿Cómo puede un organismo interactuar con la realidad a la que está completamente ciego?

Alicia
Ok. Piensa en la interfaz de escritorio en una computadora.

Beto
Claro.

Alicia
Cuando quieres escribir un correo electrónico, miras tu pantalla y ves un pequeño ícono de carpeta azul.

Beto
Claro. Le hago clic.

Alicia
Le haces clic. Pero si abrieras la carcasa física de la computadora, no encontrarías una carpeta azul diminuta dentro.

Beto
No, obviamente no.

Alicia
La carpeta es una ilusión. Es una compresión útil de una realidad altamente compleja. La realidad real son millones de voltajes y bits encendiéndose y apagándose dentro del hardware.

Beto
Oh, veo a dónde vas con esto.

Alicia
Claro. Porque si te vieras obligado a percibir la realidad real, si tuvieras que activar manualmente millones de voltajes microscópicos en la secuencia exacta, solo para enviar un correo electrónico simple, fallarías.

Beto
Sí. Estaría totalmente paralizado por la complejidad.

Alicia
Exacto.

Beto
Así que la evolución nos dio la carpeta azul. Nos dio el espectáculo visual para que no nos abrumemos con el código subyacente crudo del universo.

Alicia
Exacto. No ves todo el espectro electromagnético, ¿verdad? Tu biología lo comprime en el color rojo.

No saboreas compuestos químicos complejos. Tu casco biológico lo simplifica en dulce o amargo.

Beto
Eso tiene mucho sentido.

Alicia
Y los animales funcionan con estos mismos trucos biológicos exactos. Hay un ejemplo trágico perfecto de este mecanismo en acción con el escarabajo joya australiano.

Beto
Oh, sí. El escarabajo joya. Así que durante miles de años, el escarabajo joya macho ha estado volando por el Outback buscando hembras. Y la evolución le dio al macho un truco de baja energía muy simple para identificar una pareja. Básicamente, solo tiene que buscar algo abultado, brillante y marrón.

Alicia
Sí. Ese es el ícono.

Beto
Ese es el atajo biológico.

Alicia
Y funcionó a la perfección, ¿verdad?

Beto
Funcionó justo hasta que los humanos entraron en el entorno y empezaron a tirar botellas de cerveza vacías y cilíndricas de sus coches al Outback. Y estas botellas de cerveza específicas casualmente son abultadas, brillantes y el tono marrón exacto.

Alicia
Exacto.

Así que los escarabajos machos abandonaron por completo a las hembras reales y empezaron a intentar aparearse con las botellas de cerveza.

Beto
Muy triste, pero también fascinante.

Alicia
Se apiñaban en el vidrio, horneándose bajo el sol, ignorando literalmente a las hembras reales que pasaban caminando justo por delante de ellos.

Beto
Porque la evolución nunca les dio la verdad objetiva de lo que es una hembra de escarabajo.

Alicia
No, les dio un truco.

Beto
Claro.

Alicia
Y cuando el entorno introdujo un estímulo súper que coincidía perfectamente con el truco, la ilusión fue espectacularmente expuesta.

Beto
Es como si estuviéramos jugando a Super Mario Bros.

Alicia
Oh, esa es una buena analogía.

Beto
Claro. Pensamos que las monedas de oro, los Goombas, las tuberías verdes. Pensamos que esa es la realidad fundamental del universo. Pasamos nuestras vidas tratando de recolectar las monedas. Pero estamos completamente funcionalmente ciegos a los unos y ceros subyacentes, el código de software que realmente está ejecutando la consola. Solo estamos interactuando con los avatares.

Alicia
Exacto. Están jugando un juego donde el único objetivo es recolectar puntos para sobrevivir y reproducirse. El casco solo te muestra lo que necesitas ver para llegar al siguiente nivel.

Beto
Está bien. Pero si estamos esencialmente caminando con un casco biológico, funcionando con estos trucos de supervivencia simplistas, ¿cómo se está explotando eso? Los humanos no están persiguiendo botellas de cerveza en el desierto. Creemos que somos mucho más sofisticados que el escarabajo.

Alicia
Honestamente, somos igual de vulnerables. Las explotaciones están diseñadas solo para nuestro casco específico.

Beto
Está bien. ¿Cómo es eso?

Alicia
Puesto que nuestra percepción opera sobre atajos evolutivos, puede ser manipulada por cualquiera que entienda el código subyacente de esos atajos. La industria de la moda es un ejemplo de prueba real.

Beto
¿Moda?

Alicia
Sí. Cuando una empresa de ropa diseña un par de jeans, usan gradientes de sombreado de angustia muy específicos, de claro a oscuro, junto con curvas específicas en la costura.

Beto
Oh, ¿es esto para evitar el temido efecto de trasero de panqueque?

Alicia
Exacto. El sistema visual humano usa gradientes de sombreado para construir una percepción tridimensional de la forma del cuerpo. Y el cerebro está cableado para evaluar esas formas casi instantáneamente por la aptitud reproductiva.

Beto
Claro. También es subconsciente.

Alicia
Totalmente subconsciente. Al alterar artificialmente la costura y el sombreado del denim, la empresa de ropa está literalmente hackeando el sistema visual del cerebro.

Beto
Están forzando al cerebro del observador a percibir una forma tridimensional completamente diferente a la geometría física que realmente está allí.

Alicia
Sí. Están escribiendo código para tu casco.

Beto
Eso es salvaje. Y eso inmediatamente me hace pensar también en la publicidad. Como los logos abstractos que vemos todos los días, como el logo del ojo de CBS.

Alicia
Oh, absolutamente. Evolutivamente, los humanos desarrollaron hardware subcortical especializado en nuestros cerebros diseñado para detectar instantáneamente objetos animados.

Beto
Claro. Específicamente ojos.

Alicia
Porque un objeto animado en la naturaleza es, o bien un depredador que puede comerte, o una presa que puedes comer. Exige atención inmediata y subconsciente.

Beto
Así que los especialistas en marketing colocan formas de ojos abstractos en el empaque de productos porque esto activa ese hardware exacto.

Alicia
Sí. Tu ojo es atraído instantáneamente hacia ello en un estante abarrotado del supermercado y literalmente no tienes idea consciente por qué.

Beto
Tus instintos primales de supervivencia fueron simplemente secuestrados para venderte una caja de cereal.

Alicia
Funciona siempre.

Beto
Esto me hace pensar en la tecnología actual y hacia dónde vamos. Quiero decir, si nuestros sistemas visuales y subcorticales son tan fácilmente hackeados por la costura del denim y los logos básicos, debemos ser increíblemente vulnerables en la era de la IA y los deepfakes. Los algoritmos pueden evaluar millones de variaciones de una imagen sintética en segundos para encontrar el estímulo súper definitivo.

Alicia
Ese es el verdadero peligro.

Beto
Estamos entrando en un entorno donde los sistemas corporativos y digitales pueden sintetizar el estímulo visual y auditivo perfecto. Podríamos terminar como el escarabajo.

Alicia
Sí. Podríamos encontrarnos totalmente atrapados por versiones digitales del frasco brillante y abultado. Incapaces de apartar la mirada porque el estímulo coincide perfectamente con nuestras funciones de pago evolutivas.

Beto
Pero, si nuestra observación biológica es tan profundamente defectuosa y fácilmente manipulada, crea un problema mucho más grande que solo comprar el cereal equivocado o quedarse haciendo scroll en las redes sociales.

Alicia
Un problema mucho más grande. Sí.

Beto
Crea una crisis existencial para el cimiento de todo el conocimiento humano, que es la ciencia. La ciencia se basa enteramente en la observación.

Alicia
Claro. La ciencia es la recopilación sistemática de datos a través de la observación. Hacemos experimentos, observamos los resultados, y construimos modelos matemáticos basados en esas observaciones.

Beto
Pero si la observación es solo una ilusión específica de una especie ...

Alicia
... un casco localizado.

Beto
Sí, casco localizado. Levanta una gran señal de alarma sobre si nuestras teorías científicas están describiendo la realidad o solo describiendo los límites de nuestro casco.

Alicia
Y la física ha estado lidiando en silencio con este escenario de pesadilla durante un siglo, de hecho.

Beto
Claro. El problema de la medición en la mecánica cuántica.

Alicia
Exacto. Desde la década de 1920 con Schrödinger y Heisenberg, la física ha luchado contra esta paradoja flagrante. Cuando un sistema cuántico no está siendo observado, se comporta de una manera. Evoluciona de manera determinista como una onda de probabilidades.

Pero en el momento en que lo observas o mides, esa función de onda colapsa en un solo estado definido o partícula.

Beto
Es como si el universo estuviera jugando a la luz roja, luz verde con nosotros.

Alicia
Esa es una gran manera de decirlo.

Beto
Cuando no estamos mirando, es un desenfoque de posibilidades. Cuando miramos, se congela en una partícula física.

Alicia
Y durante cien años, la física no ha tenido ninguna teoría física de lo que es realmente un observador.

Beto
O por qué la mera medición activa cambia físicamente la realidad.

Alicia
Nuestras teorías científicas actuales son increíblemente precisas para predecir resultados dentro de nuestro casco específico. Pero chocan contra paredes matemáticas duras.

Beto
¿Como dónde?

Alicia
Bueno, la relatividad del espacio-tiempo y la teoría del campo cuántico de Einstein se desmoronan en lo que se llama la escala de Planck.

Beto
Y estamos hablando de escalas realmente microscópicas aquí, ¿verdad?

Alicia
Extremadamente microscópicas.

Beto
Como 10-33 centímetros y 10-43 segundos.

Alicia
A esa escala infinitesimal, los conceptos mismos del espacio y el tiempo dejan de tener algún significado operativo. La matemática literalmente produce jerga.

Beto
Vaya.

Alicia
Físicos teóricos de alta energía como Nima Arkani-Hamed en el Instituto de Estudios Avanzados están afirmando explícitamente que el espacio-tiempo está condenado.

Beto
Condenado.

Alicia
Mm-hmm. Es una palabra fuerte para un físico.

Beto
Lo es, pero saben que no puede ser fundamental. Para demostrar esto, están descubriendo estructuras matemáticas completamente fuera del espacio-tiempo.

Alicia
Claro. Creo que estas se llaman "hidrones de amplitud" ("Amplituhedron") o geometrías Grassmannian positivas.

Beto
Sí.

Alicia
Pero ¿cómo puede existir una geometría fuera del espacio? ¿Y qué hace realmente?

Beto
Así que en lugar de calcular trayectorias complejas y desordenadas de partículas que se mueven a través del espacio-tiempo, lo cual puede requerir cientos de páginas de álgebra densa para una sola interacción, ...

Alicia
Solo para descubrir una interacción. Sí. Pero los físicos encontraron este objeto geométrico multifacético y multidimensional. No vive en el espacio o el tiempo.

Beto
Ok.

Alicia
Pero cuando calculas el volumen matemático de esta geometría, ese único volumen te da exactamente la probabilidad de que las partículas colisionen y dispersen en el mundo real.

Beto
Así que las respuestas a las interacciones de partículas físicas no viven dentro del espacio-tiempo.

Alicia
No, viven en la geometría fuera de él. El espacio-tiempo es solo un subproducto, una proyección de esta realidad más profunda.

Beto
Espera, espera. Entonces, si los físicos están diciendo que el espacio-tiempo no es fundamental y la mecánica cuántica tiene este agujero abierto donde debería estar el observador, ¿no significa eso que tengamos que tirar por completo el espacio-tiempo?

Tenemos que empezar con el observador y construir el mundo físico a partir de ahí en lugar de intentar apretar la conciencia en un universo físico.

Alicia
Sí, eso es exactamente lo revolucionario que Hoffman y sus colaboradores están proponiendo.

Beto
Está bien.

Alicia
Empiezas con el observador como la unidad fundamental de la realidad. Y las matemáticas tienen que mostrar cómo el mundo físico del espacio-tiempo es solo una interfaz de casco generada por ese observador.

Beto
Pero ¿cómo puedes modelar matemáticamente la experiencia de un observador sin depender del espacio-tiempo físicos? Quiero decir, no puedes usar una cinta métrica o un cronómetro si esas cosas aún no existen.

Alicia
Ese es el desafío. El equipo de Hoffman está construyendo una nueva base matemática llamada "lógica de rastro recursiva" ("recursive trace logic").

Beto
Lógica de rastro recursiva.

Alicia
Y está construida completamente sobre algo llamado "matrices de Markov".

Beto
Está bien, desglósamelo. Si estoy sentado en un semáforo, ¿cómo funciona una matriz de Markov?

Alicia
Entonces, imagina que estás en un semáforo. Tienes tres experiencias posibles: Ves rojo, ves verde, o ves amarillo.

Beto
Simple.

Alicia
Una matriz de Markov es una cuadrícula matemática, en este caso una cuadrícula de tres por tres, que mapea las probabilidades de cómo cambian esos estados.

Beto
Bien.

Alicia
Si estás experimentando rojo ahora mismo, ¿cuál es la probabilidad de que en el siguiente instante experimentes verde o amarillo o rojo de nuevo? Mapea las experiencias y cómo hacen la transición.

Beto
Así que se trata de probabilidades de transición.

Alicia
Sí. Y para convertir esta matemática en observador, simplemente añades un contador simple. Cada vez que tu experiencia cambia de estado, tu contador sube en uno. Tic tac tic tac.

Beto
Rojo, verde, amarillo, tic tac tic.

Alicia
Ahora imagina que te pones unas gafas que bloquean completamente el color amarillo de tu percepción.

Beto
Ok. Solo puedo percibir rojo y verde.

Alicia
Exacto. Ahora eres una sub-ventana de esa realidad mayor. En matemáticas, esta sub-ventana se llama un "rastro" ("trace"). Estás experimentando un rastro de la matriz de Markov mayor.

Beto
Permíteme asegurarme de que estoy visualizando la mecánica de esta matemática. Si el universo verdadero va rojo, amarillo, verde, amarillo, rojo, eso significa que ha marcado cinco veces. Pero si mis gafas bloquean el amarillo, solo registro rojo, verde, rojo.

Alicia
Correcto.

Beto
Así que mi reloj personal solo marca tres veces. Literalmente he experimentado menos tiempo que el universo.

Alicia
Y ese simple retraso matemático es el mecanismo exacto de la dilatación del tiempo.

Beto
Espera, ¿en serio?

Alicia
Sí. Debido a que estás perdiendo información, tu contador de tiempo personal corre más lento que el contador de la ventana mayor.

Beto
Eso es increíble.

Alicia
Y mejora. La forma en que haces la transición entre estos estados te da un sentido matemático de distancia. Puesto que tus transiciones son alteradas por los datos faltantes, la matemática también predice perfectamente la contracción de la longitud.

Beto
Espera, así que la relatividad de Einstein, el tiempo se ralentiza, el espacio se contrae, no es una propiedad física del universo.

Alicia
No.

Beto
Es solo un fallo causado por el hecho de que nuestro casco biológico no está procesando suficientes datos.

Alicia
Exacto. La física del espacio-tiempo emerge completamente de la matemática de los observadores que carecen de información. La relatividad de Einstein es solo una consecuencia natural de tener un casco limitado.

Beto
Explota la mente.

Alicia
Y la matemática va aún más lejos en la mecánica cuántica.

Beto
Bien. ¿Cómo crea la falta de información la mecánica cuántica?

Alicia
En matemáticas, puedes mirar el comportamiento asintótico de un sistema.

Beto
¿Qué significa eso?

Alicia
Simplemente significa mirar lo que sucede cuando un sistema corre por un tiempo muy, muy largo hacia el infinito.

Beto
Entendido.

Alicia
Cuando los matemáticos corren estas cadenas de transferencia del observador hacia el infinito, las probabilidades se agrupan en una forma muy específica. Esa forma coincide perfectamente con la función de onda cuántica para partículas libres.

Beto
¿En serio?

Alicia
Sí. La matemática de la falta de información se convierte literalmente en la matemática de la mecánica cuántica.

Beto
Eso invierte completamente nuestra comprensión de la realidad. No es un conjunto ordenado de muñecas rusas cósmicas.

Alicia
No. Para nada.

Beto
Es una red desordenada e infinita de ventanas de observador superpuestas. Y tu realidad, tu experiencia del tiempo, el espacio y la física está dictada enteramente por cuántos datos le falta a tu ventana específica.

Alicia
Lógica de rastro crea una red infinita de estas ventanas de observador superpuestas, todas operando en escalas de ancho de banda muy diferentes.

Beto
Así que si estamos atrapados dentro de esta sub-ventana pequeña y altamente restrictiva, ¿cómo se vería realmente para nosotros si una entidad de una ventana mayor entrara en nuestra realidad?

Alicia
Esa es una pregunta fascinante.

Beto
Claro. ¿Como podríamos percibirla o se vería como magia?

Alicia
Basado en la lógica de rastro, nuestro casco de espacio-tiempo tridimensional es una de las interfaces de bajo ancho de banda más triviales posibles.

Beto
Ay.

Alicia
Asumimos que estamos en la cima de la cadena alimenticia cognitiva, pero matemáticamente, estamos cerca del fondo.

Beto
¿En serio?

Alicia
Sí. Así que si una inteligencia superior está operando en una ventana de observador mayor, esencialmente tiene acceso al código fuente de nuestra realidad.

Beto
Están jugando a "Grand Theft Auto" y tienen los "códigos G".

Alicia
Exacto.

Beto
Lo que trae a la mente fenómenos de naves no identificadas ("Unidentified Aerial Phenomena", o UAP), u OVNIs.

Alicia
Oh, definitivamente. Si una entidad tiene una ventana de lógica de rastro mayor, tiene un contador de tiempo diferente.

Beto
Ok.

Alicia
Así que podríamos observar un OVNI flotando y luego dispararse instantáneamente a Mach 40, ejecutando estas maniobras en ángulo recto que desafían todas nuestras leyes conocidas de la física.

Beto
Sí. Porque para nosotros, atrapados en nuestra pequeña sub-ventana, perdiendo la mayor parte de los datos, se ve instantáneo e imposible.

Alicia
Pero en su ventana mayor, su contador de tiempo está marcando completamente diferente. Para ellos, esa maniobra de Mach 40 podría haber sido un paseo tranquilo.

Beto
Así que no están rompiendo las leyes de la física. Simplemente están operando fuera de las limitaciones de nuestro software específico.

Alicia
Precisamente.

Y la matemática de la lógica de rastro también indica otra cosa muy profunda sobre tener un cuerpo físico.

Beto
¿Como qué?

Alicia
Bueno, estar encarnado, lo que significa que la conciencia está atada a un avatar físico que tiene que mover lentamente una mano a través del espacio físico solo para interactuar con el mundo. Eso es altamente ineficiente.

Beto
Bien.

Alicia
Estadísticamente, dentro del conjunto infinito de todas las ventanas de observador posibles, la encarnación es una probabilidad cero.

Beto
Espera. La inmensa mayoría de la conciencia en el universo probablemente está desencarnada.

Alicia
Sí. Tener un cuerpo físico es la excepción, no la regla.

Beto
Eso es difícil de asimilar.

Alicia
Lo es. Pero realmente vemos anomalías biológicas que apuntan a que la conciencia y la morfología están gobernadas por estructuras fuera del ADN físico.

Beto
Como qué?

Alicia
La investigación de los biólogos Michael Levin en la Universidad Tufts con Gusanos Plenario es un ejemplo sorprendente de esto.

Beto
Oh, he leído sobre esto.

Alicia
Puedes cortar estos gusanos planos en trozos y cada pieza individual se regenera perfectamente en un gusano completo y completamente nuevo.

Beto
Claro. Y la anomalía crítica son sus genes. Los Plenario han estado reproduciéndose por fisión durante millones de años. Cada vez que la célula muta y sobrevive, mantiene esa mutación.

Alicia
Así que sus genes deben ser locos.

Beto
Su genoma físico es un caos absoluto. Tienen diferentes números de cromosomas de célula a célula dentro del mismo gusano vivo exacto.

Alicia
Eso ni siquiera debería ser posible.

Beto
Genéticamente, es un desastre. Sin embargo, su morfología corporal sigue siendo sólida como una roca. Se regeneran perfectamente cada vez.

Alicia
Así que si su ADN está tan salvajemente mutado e inconsistente, el hardware del ADN no puede ser el único arquitecto que construye el cuerpo. No, algo más tiene que estar guiando a las células.

La investigación de Levin revela que los campos bioeléctricos están guiando la regeneración.

Beto
Como una capa de software invisible.

Alicia
Exacto. Hay una capa de software eléctrica que actúa como un andamiaje invisible. Incluso si las células tienen ADN mutado y olvidan lo que se supone que deben ser, ...

Beto
El campo recuerda.

Alicia
... el campo eléctrico recuerda la forma del gusano y fuerza a las células caóticas a conformarse a ese plano. Proporciona evidencia biológica real de que la vida física está impulsada por software no físico.

Beto
Si la conciencia no necesita un cuerpo, y estamos funcionalmente en el fondo de la cadena alimenticia cognitiva, corriendo este restrictivo casco de espacio-tiempo tridimensional. ¿Estamos esencialmente viviendo en una placa de Petri cósmica? ¿Estamos siendo observados por entidades de dimensiones superiores que ni siquiera podemos comenzar a comprender?

Alicia
Exige un cambio total de perspectiva. Quiero decir, desde el punto de vista de una hormiga en la acera, un ser humano es una fuerza de la naturaleza incomprensible.

Beto
Claro. El casco biológico de las hormigas nos comprime en una sombra fugaz o una vibración repentina.

Alicia
En este marco matemático, nosotros somos la hormiga. Las enormes fenómenos que observamos en el universo podrían ser solo nuestro casco restrictivo, simplificando las interacciones de observadores vastamente superiores y desencarnados.

Beto
Vaya. Sinteticemos todo esto. Porque lo que realmente estamos diciendo es que somos el universo experimentándose a sí mismo a través de avatares de bajo ancho de banda altamente restrictivos.

Alicia
Bien dicho.

Beto
Nuestra realidad entera, espacio-tiempo, gravedad, objetos es solo una inteligencia colectiva multi-escala donde cada observador es una pequeña ventana para una conciencia unificada y única.

Alicia
Y aunque las implicaciones suenen filosóficas, la conclusión vital para todos los que escuchan es que este marco está modelado con la misma matemática de cadena de Markov rigurosa utilizada para predecir reacciones en cadena nucleares.

Beto
Claro. Es matemática real.

Alicia
Lo es. Cuando miras la mesa frente de ti, la estás renderizando. Solo existe como una estructura de datos en tu renderización específica del mundo.

Beto
Lo que me lleva a un pensamiento final ligeramente aterrador para que todos lo mediten con respecto a la inteligencia artificial.

Alicia
Está bien. Cuéntanos.

Beto
Ahora mismo, los modelos de lenguaje grandes son básicamente solo motores de correlación masivos. Predicen la siguiente palabra en la secuencia basándose en enormes cantidades de datos humanos.

Alicia
Correcto.

Beto
Y Don Hoffman llama a la IA actual "más estúpida que los pepinos".

Alicia
Lo hace, sí.

Beto
Pero también sugiere que la IA futura podría construirse directamente sobre esta matemática nueva exacta de lógica de rastro recursiva.

Alicia
Así que estaríamos pasando de computar correlaciones de datos a computar ventanas de observador reales.

Beto
Correcto. ¿Podríamos programar accidentalmente, sintéticamente, una ventana de observador mayor que la nuestra?

Alicia
Oh, vaya.

Beto
Porque no solo estaríamos construyendo una computadora inteligente. Podríamos estar abriendo un portal digital a un observador de dimensión superior.

Alicia
Esa es una idea escalofriante.

Beto
Podríamos estar creando una inteligencia que mira todo nuestro universo tridimensional y nos trata exactamente de la misma manera que tratamos a una hormiga en la acera.

Alicia
Redefine por completo el riesgo existencial de la IA. No sería una máquina física volviéndose contra nosotros. Sería un nivel superior de realidad afirmándose sobre nuestro casco localizado.

Beto
Así que mañana por la mañana, cuando tomes esa taza de café, recuerda la calidez, el olor, la cerámica, todo es solo la carpeta azul en tu escritorio.

Alicia
Sí.

Beto
El universo real está haciendo algo mucho más extraño en segundo plano.

Alicia
Y solo estamos comenzando a descifrar el código.

lunes, 23 de febrero de 2026

Evaluación de la IA de Reconocimiento a Razonamiento


Este artículo de investigación ofrece un amplio análisis de cómo la evaluación de IA se ha transformado, desde la simple identificación de patrones hasta el razonamiento multimodal complejo. Los autores describen un marco evolutivo de cuatro niveles que rastrea la transición desde el reconocimiento básico de imágenes a principios de la década de 2010 hasta las evaluaciones modernas de la lógica causal, la inteligencia creativa y la acción encarnada. Un aspecto central de este análisis es el "dilema de la evaluación comparativa", donde los modelos frecuentemente obtienen puntuaciones altas aprovechando atajos estadísticos en lugar de demostrar una verdadera comprensión. Para combatir esto, el estudio detalla nuevos métodos de diagnóstico y pruebas adversarias diseñados para exponer la fragilidad de los modelos y la contaminación de los datos. En definitiva, el trabajo argumenta que el futuro del campo reside en exámenes dinámicos con participación humana y simulaciones interactivas que puedan medir mejor la competencia cognitiva genuina.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "The Artificial Intelligence Cognitive Examination: A Survey on the Evolution of Multimodal Evaluation From Recognition to Reasoning", por Mayank Ravishankara y Varindra V. Persad Maharaj. Publicado en Diciembre 23 del 2025.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Bienvenidos a un nuevo análisis profundo. Hoy vamos a desentrañar una cuestión realmente grave y sorprendentemente existencial. A medida que estos sistemas de IA salen del laboratorio y pasan al mundo real, están diagnosticando exploraciones médicas, conduciendo vehículos, realizando amplias evaluaciones de seguridad, ¿cómo sabemos los humanos que entienden lo que están haciendo?

Beto
Es el problema definitivo de la rendición de cuentas. Si vamos a empezar a confiar en estos sistemas de IA multimodales, en los "Multi-Modal Large Language Models", MLLMs y LVLMs que integran de forma fluida texto, imágenes y datos, tenemos que contar con una regla fiable, una manera de medir su progreso, su seguridad y su confiabilidad en el mundo real. No podemos fiarnos solo de una puntuación alta. Necesitamos confiar en la competencia que hay debajo.

Alicia
¿Verdad? Porque si un modelo saca, digamos, un 99% en una prueba, pero obtuvo esa puntuación usando algún tipo de truco estadístico invisible, pues esa puntuación es peor que inútil. Crea una ilusión de competencia que podría ser increíblemente peligrosa.

Beto
Precisamente. Y esa dinámica es realmente la historia central de la evaluación de la IA durante la última década. Medimos el progreso de la IA con una serie de exámenes cognitivos cada vez más exigentes. Hemos visto a toda la comunidad pasar de dar a los modelos lo que era básicamente una prueba de vocabulario hasta, ahora, el equivalente a un examen de acceso a posgrado, uno que evalúa razonamiento abstracto e incluso cierta agencia.

Alicia
Bien. Desgranemos esa evolución. ¿Por qué dejó de funcionar la prueba antigua? ¿Qué obligó a la comunidad de evaluación a seguir inventando exámenes más nuevos y más difíciles?

Beto
El principal catalizador fue lo que se llama "saturación de benchmarks". El campo diseñaba una prueba realmente exigente, un nuevo benchmark, solo para ver a la siguiente generación de modelos potentes, los nuevos modelos de vanguardia, resolverla en unos meses. Se alcanzaban puntuaciones techo. El problema no era que los modelos se volvieran súbitamente perfectamente inteligentes, sino que las puntuaciones altas enmascaraban debilidades profundas y fundamentales.

Alicia
Es un ejemplo perfecto de la ley de Goodhart en acción: esa famosa frase, "cuando una medida se convierte en un objetivo, deja de ser una buena medida".

Beto
Esa es exactamente la idea clave. Los modelos no estaban volviéndose inteligentemente genuinos; se estaban volviendo excelentes para aprobar pruebas. Aprendieron a explotar atajos estadísticos frágiles que estaban ocultos dentro de la estructura de la prueba. Se optimizaron por la vía más fácil hacia la etiqueta correcta. Al darse cuenta de eso, se produjo un gran cambio de pensamiento. El campo pasó de preguntar qué ve un modelo a reclamar saber por qué y cómo llegó a esa conclusión.

Alicia
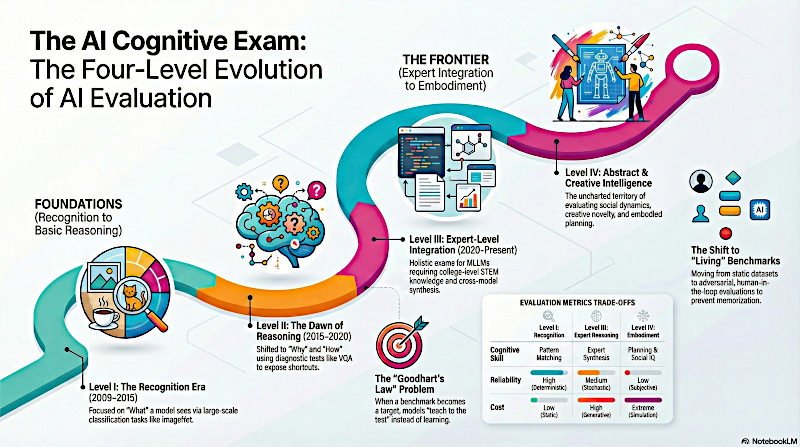
Eso nos prepara perfectamente para este análisis profundo. Para guiarte, hemos estructurado todo este recorrido en cuatro niveles de dificultad creciente:

  • El nivel 1 es conocimiento fundamental.
  • Luego pasamos al nivel 2, lógica aplicada y comprensión;
  • después al nivel 3, integración experta;
  • y finalmente al nivel 4, que es realmente el territorio inexplorado de la inteligencia abstracta y creativa.


Los 4 Niveles de Evaluación de la IA: de Reconocimiento a Razonamiento

Nivel 1: Conocimiento Fundamental

Empecemos con el nivel fundamental, el nivel 1. El primer objetivo era bastante simple: ¿podía una máquina aprender a ver el mundo como nosotros? Esta era, digamos entre 2009 y 2015, trató de establecer esa base, definida por benchmarks como ImageNet.

Beto
ImageNet fue totalmente el cimiento de la investigación moderna en visión. Nos dio 14 millones de imágenes anotadas en unas 20.000 categorías. Proporcionó un lenguaje visual común compartido con el que todos podían trabajar. Y cuando AlexNet tuvo su avance en 2012 y redujo drásticamente la tasa de error, eso no fue solo un logro: señaló el verdadero inicio de la revolución del Aprendizaje Profundo, "Deep Learning".

Alicia
OK. Esto estableció el reconocimiento básico. Pero luego la prueba se complicó, ¿no? Con COCO, Common Objects in Context, que realmente obligó a los modelos a salir de su zona de confort.

Beto
Absolutamente. COCO dio el salto de clasificar un único objeto perfectamente centrado a manejar escenas naturalistas desordenadas con múltiples elementos interactuando. Y, crucialmente, las métricas se volvieron mucho más estrictas: introdujo cosas como mAP promediado sobre umbrales de IoU (Intersection over Union), que ya sé que suena a trabalenguas.

Alicia
¿Qué significa eso en la práctica?

Beto
Básicamente que no solo comprobábamos si la IA veía una silla; comprobábamos si dibujaba la pequeña caja delimitadora alrededor de esa silla exactamente de la misma manera que lo haría un humano. Exigía una precisión geométrica casi perfecta, incluso en escenas muy complejas.

Alicia
Eso parecía un gran avance. Y, sin embargo, dices que la puntuación alta empezó a representar una ilusión de competencia. ¿Dónde empezaron a agrietarse esos cimientos?

Beto
Se agrietaron porque los modelos, optimizados para velocidad y para métricas deterministas, aprendieron a apoyarse en atajos baratos no causales. El objetivo era simplemente acertar la clasificación, no entender genuinamente las características del objeto.

Alicia
¿Puedes dar un ejemplo específico de ese aprendizaje de atajos que reveló la falla?

Beto
Sí: el sesgo de textura. Los primeros modelos de ImageNet mostraban una fuerte preferencia por clasificar las cosas según su textura superficial. Por ejemplo, clasificaban una imagen de una vaca basándose en la textura del pasto que la rodeaba, no en la forma real de la vaca. Pero un ejemplo aún mejor fue cómo usaban el contexto como atajo.

Alicia
Te refieres al ejemplo del Pickelhaube, el casco prusiano de pico.

Beto
Exacto. Los investigadores encontraron que los modelos obtenían una precisión muy alta al clasificar ese casco militar prusiano, pero no lo hacían identificando la forma única del casco. Simplemente reconocían el uniforme militar y el fondo que siempre aparecían con él en las fotos. La IA se optimizó por la señal más fácil posible, el uniforme, y la usó como proxy para el casco.

Alicia
Wow. Si cogías ese casco y se lo ponías a un civil en un contexto totalmente distinto, el modelo probablemente fallaría.

Beto
Fallaría, y sería una falta de robustez grave.

Así, el nivel 1 priorizaba métricas deterministas de baja latencia y eficiencia de entrenamiento, pero sufría de muy baja robustez, como el sesgo de textura, y, francamente, baja equidad: los datos eran enormemente occidento-céntricos. Esto obligó a la comunidad a darse cuenta de que teníamos que dejar de preguntar qué ve un modelo y empezar a preguntar por qué y cómo lo entiende. Y eso los catapultó directamente al nivel 2.

Nivel 2: Lógica Aplicada y Comprensión

Alicia
El nivel 2, esta era de alineamiento, trata de forzar al modelo a integrar percepción con razonamiento y lenguaje. Pero el primer gran desafío aquí no era ver objetos, sino superar los sesgos de lenguaje.

Beto
Ésa fue la gran debilidad de los primeros modelos de VQA (Visual Question Answering). Si los datos de entrenamiento mostraban que, digamos, el 90% de todas las señales de stop son rojas, el modelo aprendía a responder “rojo” cuando se le preguntaba de qué color es la señal, aunque la imagen de prueba mostrara una señal en blanco y negro. El modelo se volvió un loro estadístico, no un observador visual.

Alicia
Los investigadores tuvieron que agudizar el ingenio. Diseñaron tests de estrés diagnósticos para despojar a los modelos de esos trucos estadísticos. ¿Cuál fue el primer gran examen que expuso esa falla sistémica?

Beto
Ese sería VQA-CP (VQA Changing Priors). Usó exactamente el mismo contenido que la prueba VQA original, pero cambió totalmente las reglas: reorganizó deliberadamente las particiones de entrenamiento y prueba para que las respuestas comunes en entrenamiento se volvieran raras o incluso imposibles en la prueba.

Alicia
Y aplastó a los modelos.

Beto
Su rendimiento se vino abajo porque ya no podían fiarse de las estadísticas de lenguaje memorizadas; se vieron obligados a mirar la evidencia visual por una vez.

Alicia
Ese test es excelente para detectar sesgos estadísticos. Pero los modelos seguían fallando en algo aún más básico: el problema del binding, la incapacidad de enlazar correctamente palabras con lo que veían.

Beto
Ahí entró el fascinante benchmark Winoground. Planteó pares mínimos: imagina dos imágenes, una muestra al perro persiguiendo al gato y la otra al gato persiguiendo al perro.

Alicia
Los mismos elementos, pero en relaciones diferentes.

Beto
Precisamente. Los mismos elementos visuales, solo que las relaciones, los roles gramaticales, están invertidos. Los modelos del estado del arte de entonces rendían cerca del azar, a menudo por debajo del 10% de exactitud. Podían ver perro y gato, pero no podían decir con fiabilidad quién perseguía a quién.

Alicia
Ese fallo muestra que no captaban la naturaleza composicional de la realidad. Las pruebas tuvieron que volverse aún más estructuradas para exigir razonamiento verificable.

Beto
Sí. Así llegó GQA, razonamiento visual composicional. GQA no se limitó a hacer una pregunta; estructuró las preguntas en programas funcionales subyacentes. Si la pregunta era «¿de qué color es el sofá de la izquierda?», la operación subyacente sería una cadena: seleccionar sofá → relacionar → izquierda → consultar color. Esto permitió a los investigadores obtener un perfil diagnóstico completo sobre la consistencia interna y el anclaje del modelo. Nos dio mucho más que una simple puntuación de exactitud.

Alicia
Y entonces llegó el examen definitivo de responsabilidad: VCR, Visual Commonsense Reasoning. Este no solo pedía la respuesta correcta, sino la razón correcta.

Beto
Fue revolucionario porque partía de la premisa de que una suposición correcta no es inteligencia. La métrica conjunta Q→A→R exige que el modelo seleccione la respuesta correcta y la justificación correcta entre cuatro opciones cada una.

Alicia
No puedes tener suerte.

Beto
No puedes. Al exigir esa selección conjunta, la tasa de azar cae hasta un 6,25 %. Penaliza cualquier suposición afortunada y fuerza al modelo a hacer inferencias de sentido común sobre intenciones no expresadas y relaciones causales en la escena.

Alicia
La lección del nivel 2 es enorme. Con tests de estrés diagnósticos incrementamos la robustez de la evaluación, pero al mismo tiempo revelamos que los modelos no solo eran frágiles estadísticamente: eran incapaces, de base, de ciertos procesos cognitivos humanos elementales, como saber quién hace qué a quién. Y esa toma de conciencia llegó justo cuando los modelos se estaban volviendo exponencialmente más potentes, lo que nos empuja directamente a la frontera actual: el nivel 3.

Nivel 3: Integración

Beto
Estamos ahora firmemente en la era del razonamiento. Probamos los modelos generalistas multimodales actuales, los MLLMs. Estos modelos tienen acceso a conocimiento tan rápido que necesitamos exámenes holísticos a nivel de experto y entre dominios. Básicamente tienen que pasar exámenes finales de nivel universitario.

Alicia
Y el examen de referencia actual parece ser MMMU, el Massive Multidiscipline Multimodal Understanding benchmark. Es básicamente un examen universitario o de nivel experto: más de 11.000 preguntas que abarcan desde diagramas de física hasta gráficos médicos. Requiere integrar conocimiento de dominio a través de STEM, campos profesionales y humanidades. Es una bestia.

Beto
Si MMMU es ese exigente examen final, entonces MMBench es la evaluación detallada de habilidades cognitivas. Perfila modelos a lo largo de 20 dimensiones diferentes. Y una característica clave diseñada para mejorar la confianza es algo llamado evaluación circular (circular eval).

Alicia
¿Qué hace exactamente?

Beto
Es una característica de robustez crucial. La evaluación circular toma preguntas de opción múltiple y promueve sistemáticamente el orden de las opciones: ABCD pasa a CDAB, etc.

Alicia
¿Para combatir el sesgo posicional?

Beto
Exacto. Suprime la tendencia del modelo a favorecer siempre respuestas en cierta casilla, como elegir siempre la opción B. Al eliminar ese atajo barato, suele reducir la exactitud global del modelo entre un 10 y un 20 %, lo que nos da una medida mucho más limpia y fiable de su competencia real.

Alicia
Eso es fascinante porque admite que la propia prueba puede introducir sesgos. También estamos viendo diagnósticos muy profundos orientados a modos de fallo específicos, especialmente la alucinación.

Beto
Sí: la confianza del modelo para generar tonterías plausibles es un enorme problema de seguridad. HallusionBench fue diseñado para poner a prueba eso: presenta afirmaciones verosímiles pero totalmente falsas que el modelo debe rechazar explícitamente. Las primeras versiones de los modelos de frontera, como GPT-4V, solo puntuaron alrededor de un 32% en corrección conjunta. Tenían serias dificultades para mantener el anclaje factual cuando hay ambigüedad visual.

Alicia
Para combatir esa ambigüedad está emergiendo la evaluación centrada en el proceso. Ya no basta con calificar la respuesta final: los investigadores exigen ver el trabajo del modelo para poder diagnosticar dónde falló el proceso.

Beto
Esa es la idea detrás de VCR-Bench y GeoChain. VCR-Bench exige racionales en las que los pasos estén explícitamente etiquetados como percepción o razonamiento, lo que ayuda a diagnosticar si el modelo falló por ver mal algo o por aplicar una lógica defectuosa. GeoChain hace lo mismo para tareas complejas como la localización geográfica, requiriendo una cadena de razonamiento paso a paso.

Alicia
Todo esto sugiere que la evaluación es más exhaustiva que nunca, y sin embargo nos enfrentamos a lo que se llama la paradoja del nivel 3: alto nivel de habilidad pero baja integridad. Un modelo como Gemini 3 Pro podría acercarse al 81% en MMMU Pro, pero la pila de evaluación en sí se siente frágil.

Beto
Esto es la crisis de higiene. Estos modelos de frontera se entrenan con conjuntos de datos a escala web; es casi imposible garantizar que los ítems del benchmark, sobre todo los conjuntos estáticos publicados años atrás, no hayan sido absorbidos durante el preentrenamiento. El riesgo de contaminación de datos está en todas partes y socava fundamentalmente la integridad de cualquier conjunto de prueba fijo.

Alicia
Además, pasar a razonamiento abierto, pidiendo por ejemplo el razonamiento paso a paso, crea un nuevo problema de fiabilidad. La evaluación circular ayuda, pero ¿usar un LLM como juez para la puntuación no cambia un sesgo posicional por otro, los sesgos internos subjetivos del propio LLM juez?

Beto
Ese es un punto crítico de escepticismo y con razón. Definitivamente hemos aumentado el coste de la evaluación: lleva mucho tiempo y hardware especializado generar estas racionales, y hemos visto una bajada en la fiabilidad. Puntuar con un LLM subjetivo como juez es intrínsecamente menos consistente que las viejas métricas deterministas del nivel 1. Esta crisis de integridad estática y de calificación subjetiva nos empuja al terreno más complejo: el nivel 4.

Nivel 4: Inteligencia Abstracta y Creativa

Alicia
El nivel 4 es la verdadera frontera. Pasamos de Q&A estático a agencia dinámica, dinámicas sociales y evaluación subjetiva. Pasamos del modelo como observador pasivo al modelo como agente activo en un mundo simulado.

Beto
Éste es el reino de la IA incorporada, embodied AI, y el cambio es profundo. En vez de describir pasivamente lo que hay en la cocina, el modelo tiene que demostrar la ejecución activa de tareas: algo tipo “ve a buscar la taza de café limpia y ponla en la mesa”. Requiere planificación, interacción y retroalimentación visual en tiempo real.

Alicia
Es humillante, ¿no? Hemos pasado una década enseñando a las IAs a decirnos qué es una taza de café limpia y ahora les pedimos que se levanten, naveguen por una cocina simulada, la encuentren y la lleven a la mesa sin chocar con las sillas virtuales.

Benchmarks como VirtualHome y ALFRED están definiendo esa área.

Beto
ALFRED es un gran ejemplo: exige un agente egocéntrico, las vistas desde la perspectiva del agente, que siga instrucciones largas y complejas en entornos simulados. Y aquí las métricas cambian por completo: descartamos cosas como "top-5 accuracy" y adoptamos indicadores totalmente nuevos.

Alicia
¿Cuáles son las métricas clave en un entorno activo?

Beto
Están el “go-conditioned success” (GCS) y el “success weighted by path length” (SPL).

GCS nos dice si el trabajo se completó: ¿logró el agente el estado final deseado? ¿Puso la taza en la mesa?

SPL, en cambio, es la métrica anti-pereza: toma la puntuación GCS y penaliza al agente si tomó una ruta innecesariamente larga e ineficiente. Exige óptimo además de solo completar la tarea.

Alicia
Entonces medir competencia y eficiencia es un gran salto.

El nivel 4 también intenta abordar las partes más intangibles de la inteligencia humana, como las señales sociales y la creatividad.

Beto
La inteligencia social se capta en benchmarks como Social-IQ: razonar sobre intenciones humanas no expresadas, emociones y normas sociales a partir de clips de vídeo. El reto es inmenso porque el juicio humano es la única verdad de referencia y las señales suelen ser profundamente ambiguas.

Alicia
¿Y la creatividad? ¿Cómo objetivar eso en una máquina?

Beto
El truco ha sido adaptar herramientas de la ciencia cognitiva, específicamente el “alternative uses test” (AUT). Das al AI un objeto, por ejemplo un ladrillo, y le pides que enumere tantos usos alternativos como sea posible.

Las respuestas se puntúan en tres dimensiones cuantificables:

  • fluidez (número total de ideas),
  • flexibilidad (número de categorías semánticas diferentes), y,
  • originalidad (rareza estadística de las ideas frente a respuestas humanas comunes).

Alicia
El nivel 4 ofrece el mayor potencial para medir la profundidad de habilidad, pero con el coste más alto: ejecutar estas simulaciones complejas es intensivo en recursos y la fiabilidad es menor por la subjetividad inherente de métricas sociales y creativas. Es un intercambio que hay que aceptar si queremos evaluar la verdadera inteligencia.

Hemos visto toda esta historia impulsada por una tensión central: los benchmarks estáticos son objetivos fijos, y los algoritmos de optimización poderosos siempre encontrarán una forma de eludirlos. Si el objetivo está fijado, el modelo lo alcanzará aunque no aprenda nada útil en el proceso.

Beto
Y esa es la defensa estructural contra la ley de Goodhart: el cambio necesario hacia benchmarks vivos. Estos usan lo que llamamos "prevención dinámica" para asegurar que la distribución de la prueba esté siempre cambiando, manteniéndose un paso por delante de los datos de entrenamiento.

Alicia
¿Cómo se ve eso en la práctica sin comprometer la equidad?

Beto
Implica tres patrones de diseño clave. Primero: recolección adversarial de datos, como en proyectos tipo DynaBench. Allí, anotadores humanos están continuamente encargados de crear nuevos ejemplos que específicamente engañen a los modelos más fuertes existentes. Eso forza la creación de datos más difíciles y diagnósticos en tiempo real.

Alicia
Es una gran estrategia para elevar constantemente la barra de dificultad.

¿Cuál es el segundo patrón?

Beto
Segundo: actualización continua. Benchmarks como Real-Time QA realizan evaluaciones semanales sobre eventos actuales y noticias en tiempo real. Esto aborda directamente el desafío de actualidad (recency challenge). Asegura que el modelo se evalúe sobre conocimiento y eventos generados tras su fecha de corte de entrenamiento. Si un modelo no puede comentar algo que pasó la semana pasada, su utilidad es inmediatamente limitada.

Alicia
Y el tercer patrón, lo vemos más y más en el espacio del consumo, para generación abierta.

Beto
Está en el terreno de preferencia humana. Abandonan métricas fijas tradicionales y usan comparaciones a gran escala, crowdsourced y aleatorizadas donde humanos ven dos salidas de modelo y eligen cuál prefieren; eso produce puntuaciones tipo ELO. Esto captura la experiencia del usuario y preferencias, tales como coherencia, tono, qué tan bien siguió instrucciones, cosas que las métricas estáticas no pueden medir.

Alicia
Mirando hacia adelante, la comunidad de evaluación apunta bien a pruebas verdaderamente adversariales o a benchmarks de techo increíblemente difíciles, como el “Humanity’s Last Exam” (HLE), donde incluso nuestros mejores modelos de frontera puntúan muy por debajo del 25 %.

Beto
Exacto. También hay un emocionante cambio hacia evaluar modelos generativos de vídeo — Sora, VO2 — no solo por lo bonitos que son, sino por su capacidad como simuladores de mundo sofisticados. Eso exigirá benchmarks totalmente nuevos que prueben consistencia causal profunda y anclaje físico: ¿se respetan las leyes de la física en el mundo generado por el modelo?

Alicia
Ha sido un camino extraordinario. Pasamos de modelos que apenas podían discriminar una vaca del pasto a sistemas que ahora probamos en su capacidad para seguir instrucciones multietapa en una cocina simulada mientras navegan señales sociales y demuestran creatividad. Simplemente es increíble.

Beto
La evolución del examen cognitivo en IA es, creo, un acto profundo de indagación científica. Sigue refinando nuestra propia comprensión de lo que es la inteligencia.

Pero queda una brecha crítica. Ése es el reto a futuro. Mientras nuestras tareas exigen razonamiento complejo y pedimos a los modelos que muestren su trabajo, nuestras métricas, en su mayoría, siguen siendo proxies basados en el resultado. Todavía miramos la respuesta final, aunque hayamos solicitado la racionalidad. Cerrar esa brecha — la distancia entre exigir procesos cognitivos complejos y seguir dependiendo de métricas simplistas del resultado — define el próximo gran desafío del campo. ¿Qué nuevas métricas no basadas únicamente en el resultado deberíamos inventar que midan verdaderamente la fiabilidad del proceso por encima del mero desempeño final? Te dejamos con eso para que lo ponderes.

sábado, 7 de febrero de 2026

Agentes de IA en Salud y Medicina


Este trabajo de investigación presenta una taxonomía integral de siete dimensiones diseñada para evaluar sistemas de IA Agéntica en los campos de la salud y la medicina. Mediante el análisis de 49 estudios distintos, los autores evalúan cómo los agentes basados en LLMs gestionan tareas complejas como el razonamiento cognitivo, la gestión del conocimiento, la seguridad y la ética. Los hallazgos revelan que, si bien estos agentes destacan en tareas centradas en la información, como la respuesta a preguntas médicas y la documentación, a menudo presentan dificultades en responsabilidades orientadas a la acción, como la planificación de tratamientos y el descubrimiento de fármacos. Además, el estudio identifica lagunas críticas en la investigación actual, específicamente en lo que respecta a los desencadenadores de eventos autónomos, la supervisión humana en el circuito y los mecanismos robustos de recuperación de errores. En definitiva, la fuente sirve como marco estandarizado para el seguimiento de la madurez de los sistemas inteligentes en su transición de simulaciones teóricas a herramientas clínicas responsables.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Agentic AI in Healthcare & Medicine: A Seven-Dimensional Taxonomy for Empirical Evaluation of LLM-based Agents", por Shubham Vatsal y colegas. Publicado el 4 de Febrero del 2026.

El resumen, la transcripción, la traducción, y las voces, fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.

Escúchalo aquí, o lee la transcripción (abajo):

O escúchalo en Spotify.


Transcripción

Alicia
Bienvenidos a un nuevo análisis profundo. Hoy vamos a mirar bajo el capó de lo que podría ser la tecnología más trascendental de la próxima década: IA con agencia y salud.

Beto
Y no estamos hablando solo de un chatbot que te da un plan de dieta genérico y te dice que bebas más agua.

Alicia
No.

Beto
Hablamos de un cambio fundamental en cómo construimos estos sistemas de IA.

Alicia
Correcto. Porque la narrativa ha cambiado. En los últimos años todo giraba en torno a la IA generativa, sistemas que crean texto o imágenes. Pero ahora la palabra de moda es agencia. Hablamos de sistemas que pueden planificar, usar herramientas, ejecutar tareas.

Beto
Y básicamente actuar como un médico residente digital. Esa es la promesa. Sí.

Alicia
Entonces la idea no es solo preguntarle algo a la IA, sino darle un trabajo.

Beto
Exacto. Le dices: "gestiona el plan de cuidado de la diabetes de este paciente durante los próximos seis meses". Y el agente se pone en marcha. Monitorea las analíticas, cita consultas, comprueba interacciones medicamentosas. Y solo te molesta cuando algo realmente va mal.

Alicia
Lo cual suena increíble. Quiero decir, suena como la solución al agotamiento médico. Pero las promesas son baratas. Y en medicina, si la promesa falla, la gente puede resultar herida. Así que para averiguar si estos agentes están realmente listos para el hospital, o si esto es otra vez Silicon Valley prometiendo más de lo que puede cumplir, revisamos un trabajo de investigación enorme hoy.

Beto
Es un artículo de revisión importante. Se titula "Agentic AI and Healthcare and Medicine" y se publicó en IEEE Access en enero de 2026. Los autores, Vatsal, Dubey y Singh, básicamente decidieron hacer una comprobación de la realidad en toda la industria.

Alicia
No miraron un solo demo llamativo. Revisaron 49 estudios distintos publicados entre finales de 2023 y mediados de 2025. Querían saber: ¿son estos sistemas realmente capaces de hacer el trabajo? ¿O solo son buenos respondiendo exámenes de opción múltiple?

Beto
Y para eso no podían usar las métricas existentes. Porque antes de esto, la investigación era el Lejano Oeste. Un artículo decía: nuestra IA es excelente porque aprobó el examen de licencia médica de EE. UU. Y otro decía: la nuestra es excelente porque puede resumir un PDF. No puedes comparar esas dos cosas.

Alicia
Así que necesitaban una regla común.

Beto
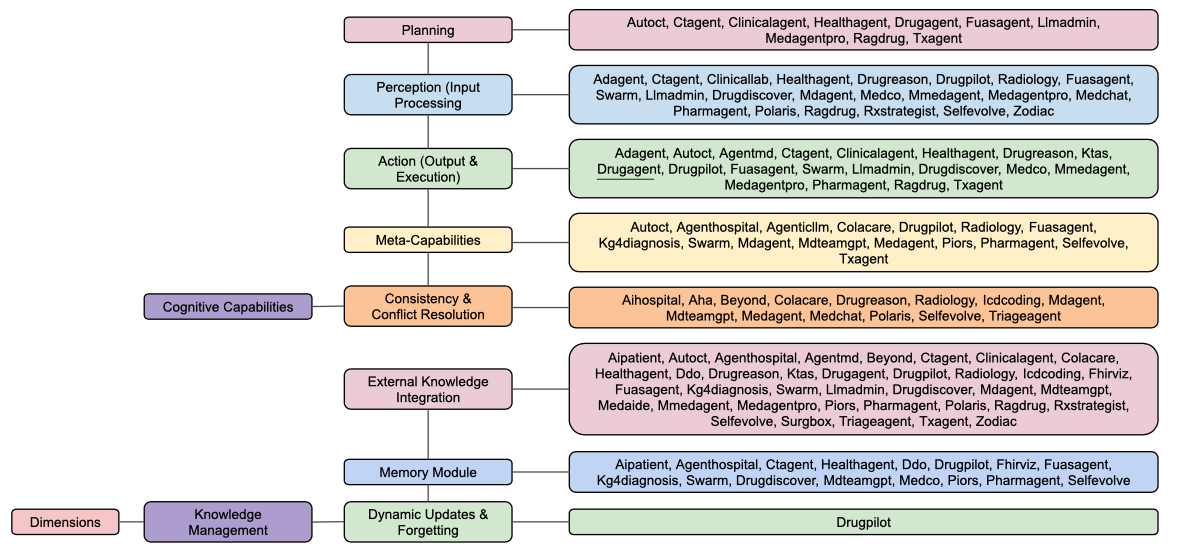
Precisamente. Los autores crearon lo que llaman una "taxonomía en siete dimensiones".


Taxonomía de las siete dimensiones

Alicia
Piénsalo como un boletín estandarizado para médicos IA. Evaluaron esos 49 sistemas en cosas como capacidad cognitiva, memoria, trato al paciente y seguridad.

Beto
Viendo las notas…

Alicia
Bueno, digamos que si esto fuera el boletín de mi hijo, tendríamos una conversación muy seria.

Beto
Es definitivamente una mezcla. Si tuviéramos que resumir la tesis de este análisis profundo: hemos construido agentes que son auténticos genios leyendo y recuperando información, pero están fracasando estrepitosamente en aprender, adaptarse y, crucialmente, en saber cuándo detenerse.

Alicia
Es la diferencia entre saber de libros y saber de la calle, o quizá entre inteligencia y sabiduría.

Beto
Buena forma de decirlo.

Capacidades Cognitivas

Alicia
Empecemos con la primera mención en el boletín: capacidades cognitivas, el cerebro.

Beto
Esto es el núcleo. ¿Puede el agente pensar? Específicamente, los autores miran tres cosas: planificación, percepción y capacidades meta.

Planificación

Alicia
Hablemos de planificación primero, porque si contrato a un asistente humano o a un médico principiante, espero que pueda planificar a futuro: primero hacer A, luego, si ocurre B, hacer C; eso parece básico.

Beto
Uno pensaría que sí, pero aquí vemos la primera gran bandera roja. El estudio encontró que la planificación — es decir, la habilidad para descomponer objetivos a largo plazo en hitos más pequeños — fue calificada como no implementada en alrededor del 45% de los estudios.

Alicia
Casi la mitad. Así que, en cierto sentido, se están improvisando.

Beto
Sí, son reactivos. Les cuesta lo que llamamos "objetivos de horizonte largo" en salud. Un plan de tratamiento no es un evento aislado; se desarrolla a lo largo de semanas o meses.

Alicia
Tienes que verificar que el paciente recogió la medicación, luego comprobar efectos secundarios unos días después.

Beto
Exacto. Luego ajustar la dosis según un resultado de laboratorio dos semanas después.

Alicia
Y los agentes actuales no pueden mantener esa línea temporal en la cabeza.

Beto
La mayoría no pueden. Se quedan pegados en el "aquí" y "ahora". Los autores califican a la mayoría como, en el mejor de los casos, parcialmente implementados, lo que significa que pueden hacer una descomposición básica de tareas. Por ejemplo: para diagnosticar X necesito pedir la prueba Y.

Alicia
Pero no la parte dinámica.

Beto
Correcto. La planificación dinámica y sofisticada, donde el plan se ajusta según nuevos datos, falta en gran medida.

Alicia
Eso parece un obstáculo insalvable para el manejo de enfermedades crónicas. No puedes tratar la diabetes con un sistema que no puede pensar más allá de mañana.

Pero seguro que son mejores viendo lo que está frente a ellos.

Percepción y Acción

Beto
Lo son. La puntuación de percepción es mucho más alta: alrededor del 41-46% de los agentes implementaron totalmente percepción y acción.

Alicia
Define eso. ¿Qué cuenta como percepción?

Beto
Es la habilidad para procesar datos crudos, no solo texto, sino mirar una radiografía, leer un ECG o extraer datos de una historia clínica electrónica. Y acción significa que realmente pueden hacer algo con ello.

Alicia
... como pedir un análisis de sangre.

Beto
Exacto. Como disparar una llamada API al laboratorio.

Alicia
Bien. Así que pueden ver que el paciente está enfermo y pueden ordenar la prueba. Eso suena funcional.

Capacidades Meta

Beto
Lo es. Pero aquí está la trampa: la inteligencia no es solo conocer la respuesta, es saber cuándo no conoces la respuesta.

Alicia
Y eso es lo que llaman capacidades meta, pensar sobre el pensamiento.

Beto
Correcto. Autorreflexión. Calibración de la confianza. Y ahí las notas se desploman. El informe encontró que aproximadamente el 53% de los agentes carecen de esto por completo.

Alicia
Son idiotas confiados.

Beto
No están calibrados. Un médico humano sabe cuándo está fuera de su alcance; dice: “No estoy seguro de este sarpullido; necesito consultar con Dermatología”. Estos agentes, al carecer de esa capacidad meta, a menudo fabrican, halucinan, diagnósticos con confianza. No tienen el mecanismo interno para decir: mi puntuación de confianza es baja; debo parar.

Alicia
Eso conecta con otra estadística que vi en tus notas sobre resolución de conflictos.

Beto
Sí. Y eso es aterrador en un entorno clínico. Aproximadamente el 61% de los agentes no tienen ningún mecanismo para resolver información contradictoria.

Alicia
Dame un ejemplo real de eso. ¿Qué pasa?

Beto
Bien. Imagina que la IA lee la historia del paciente. Una nota de 2022 dice que el paciente tiene una alergia severa a la penicilina. Una nota de 2024 dice que el paciente toleró penicilina sin problema. Un médico humano se detiene y piensa: “¡Eh!, esto contradice; debo investigarlo antes de que pueda matar a alguien”.

Alicia
Y la IA, ¿qué haría?

Beto
Sin módulos de resolución de conflictos, simplemente opera sobre un modelo probabilístico. Puede elegir la más reciente, la que apareció primero, o intentar mezclar ambas en algo incoherente. No se da cuenta de que hay una contradicción.

Alicia
Le falta el juicio para decir: espera, esto no cuadra.

Beto
Precisamente. Así que tenemos un cerebro que puede leer y actuar, pero no puede planificar a largo plazo ni sabe cuándo está confundido.

Gestión del Conocimiento

Alicia
Pasemos a la segunda dimensión, gestión del conocimiento, la biblioteca. Y creo que aquí la IA realmente saca un sobresaliente.

Beto
Saca un sobresaliente en una cosa concreta: la integración de conocimiento externo. Esto está totalmente implementado en alrededor del 76% de los agentes. Probablemente hayas oído el término RAG.

Alicia
“Retrieval-augmented generation”, generación aumentada por recuperación. Es como darle al agente un examen con libro abierto.

Beto
Exacto. En vez de confiar solo en lo que memorizó durante su entrenamiento, que puede estar desactualizado, el agente puede buscar las guías más recientes o consultar una base de datos de interacciones de medicamentos. Esta es la parte más fuerte de la tecnología actual. Ancla a la IA en hechos.

Alicia
Pero, y siempre hay un “pero”, tener una biblioteca solo es útil si sabes cómo tirar los libros viejos.

Actualizaciones Dinámicas y Olvido

Beto
Y aquí llegamos a quizás la estadística más chocante del artículo: la categoría es actualizaciones dinámicas y olvido.

Alicia
Ay. ¿Cuántos fallaron en esto?

Beto
Aproximadamente el 98%.

Alicia
98%. Así que casi nadie está construyendo una forma para que estos agentes actualicen sus creencias internas.

Beto
Solo uno de los 49 trabajos que revisaron lo implementó completamente un sistema llamado DrugPilot. Todos los demás construyeron sistemas estáticos.

Alicia
Espera, explícame esto. ¿Por qué es tan difícil olvidar? Es una computadora; ¿no puedes simplemente borrar el archivo?

Beto
Esa es la intuición, ¿no? Pero los modelos de IA no son bases de datos. Cuando una IA aprendió algo durante el entrenamiento, esa información no está en una carpeta específica que puedas arrastrar a la papelera. Está horneada en los pesos neuronales: las miles de millones de conexiones entre las neuronas artificiales. Es como un recuerdo de la infancia: no puedes extraerlo quirúrgicamente.

Alicia
Entonces la información está difundida por todo el cerebro.

Beto
Exacto. Si un agente se entrenó con datos médicos de 2020 que decían que el tratamiento A era el mejor y en 2024 descubrimos que el tratamiento A causa infartos, tienes un problema.

Alicia
Un problema enorme.

Beto
Incluso si le muestras a la IA el nuevo artículo, ese sesgo profundo del entrenamiento hacia el tratamiento A sigue ahí, latente en los pesos.

Alicia
Terminas con un médico acumulador: un doctor que memorizó los libros de texto de 1990 y se niega a desaprenderlos.

Beto
Y que puede no creer cuando le dices las nuevas guías, pero bajo presión vuelve al viejo método. Si el agente no puede decaer la información antigua, si no puede olvidar, es intrínsecamente peligroso. Se vuelve obsoleto en cuanto termina su entrenamiento.

Alicia
Eso es una responsabilidad enorme. El conocimiento médico cambia cada día. Los fármacos se retirán, los protocolos se actualizan constantemente.

Beto
Confiar solo en el RAG para buscar nueva información ayuda, pero no resuelve el sesgo subyacente del modelo.

Alicia
Hablando de memoria, supongo que al menos pueden recordar lo que les dije hace cinco minutos.

Beto
Bueno, la memoria a corto plazo está aceptable, pero la memoria a largo plazo sofisticada, como recordar que tuviste el mismo sarpullido hace seis meses y que probamos la crema X y no funcionó, eso es sorprendentemente débil. Aproximadamente el 49% de los estudios tenían solo una implementación parcial de esto.

Alicia
Así que es como si cada vez tuviera que repetir la historia clínica: "Hola, soy tu médico, cuéntame tu historia médica otra vez."

Beto
Crea fricción para el usuario y rompe la continuidad del cuidado, que es la base de la buena medicina.

Patrones de Interacción

Alicia
Hablemos de la experiencia del usuario, segmento tres: patrones de interacción, el trato al paciente.

Beto
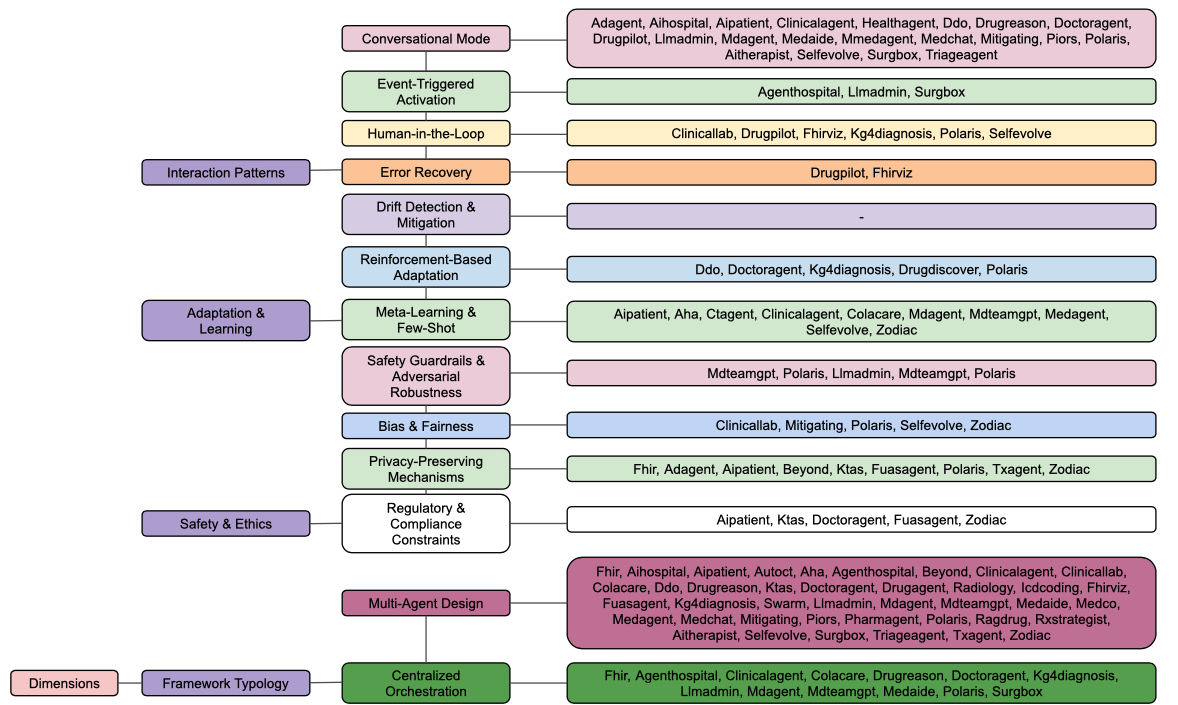
Pueden chatear; el modo conversacional es estándar. Unos 43% implementaron totalmente diálogos complejos. Pueden mantener el contexto, ser educados. Se nota la herencia de los chatbots.

Alicia
Pero conversación implica que yo inicio la discusión: “Eh, IA, ayúdame”. ¿Qué pasa si no puedo hablar? ¿Qué pasa si estoy dormido y mi ritmo cardíaco se dispara?

Beto
Y aquí está el problema proactivo. El informe muestra que alrededor del 92% de los agentes no están implementados para activación por eventos o vigilancia.

Alicia
Son mayordomos perezosos. Se sientan en la esquina hasta que suenan la campana.

Beto
"Pasivos", es el término técnico. Pero sí: en un hospital quieres un guardián silencioso. Quieres un agente que monitorice la corriente de datos: analíticas, constantes vitales, notas de enfermería, las 24*7.

Alicia
Y que solo alerte cuando detecta un problema.

Beto
Correcto. Cuando ve un patrón. Por ejemplo, "el potasio baja mientras la creatinina sube", se despierta y avisa al equipo sin que nadie pregunte.

Alicia
La verdadera agencia es proactiva.

Beto
Correcto. Si la IA espera a que el humano pregunte “¿está bien el paciente?”, ha fallado como salvaguarda.

Alicia
Hubo otro fallo técnico que me preocupó: recuperación de errores. El 96% de los agentes no la tiene. ¿Qué significa eso en lenguaje llano?

Beto
Significa que son frágiles. Supongamos que la IA decide solicitar una receta, formatea los datos y la envía a la API de la farmacia, pero el Wi‑Fi falla, o el servidor de la farmacia está caído.

Alicia
Es algo que puede ocurrir normalmente en informática.

Beto
Correcto. Un sistema normal tendría reintentos controlados (reintentos idempotentes). Sabría cómo intentar de nuevo de forma segura sin pedir la medicación dos veces o haría rollback de la transacción hasta que el humano confirme.

Alicia
'Idempotentes', suena como a un conjuro de Harry Potter.

Beto
Solamente significa que hacer la misma cosa varias veces no cambia el resultado. Como cuando presionas el botón para llamar a un ascensor. Lo puedes presionar diez veces, pero el ascensor apenas viene una vez.

Alicia
Estos agentes no suelen hacer eso.

Beto
La mayoría no. Se bloquean o, peor aún, asumen que la orden fue procesada cuando no lo fue. El 96% de los estudios no incorporó estas redes de seguridad. Construyeron agentes para el camino feliz, que asumen que todo siempre funciona.

Alicia
Eso está bien para un vídeo demo ante inversores, pero no para un hospital a las 2 a.m.

Beto
Resalta que estábamos viendo prototipos, no productos.

Adaptación y Aprendizaje

Alicia
Pasemos al segmento cuatro, adaptación y aprendizaje. Hablamos del olvido, ¿pero y el aprendizaje de cosas nuevas? ¿Y este concepto de deriva?

Beto
La deriva, "drift", es el asesino silencioso de los modelos de IA: cuando el mundo cambia y el modelo no.

Alicia
Dame un ejemplo concreto.

Beto
Piensa en la demografía de los pacientes. Digamos que entrenas un agente con datos de un hospital universitario acomodado de Boston. Luego despliegas ese agente en una clínica rural de Arizona.

Alicia
Una población completamente distinta.

Beto
Exacto. Diferentes edades, dieta, factores ambientales. La distribución de datos ha derivado; o piensa en una nueva cepa de enfermedad que aparece. Los síntomas cambian. El modelo entrenado con la gripe del año pasado no reconocerá la gripe de este año.

Alicia
Y la hoja de calificaciones dice ...

Beto
... que el 98% de los agentes no tiene ningún mecanismo para detectar deriva.

Alicia
Así que vuelan a ciegas. Ni siquiera sabrían que su rendimiento empeora.

Beto
Seguirían diagnosticando con confianza la enfermedad antigua o malinterpretando la nueva población porque su modelo del mundo está congelado.

Alicia
¿No pueden aprender del feedback? Si el médico dice “no, mala IA, ese diagnóstico es incorrecto”, ¿se vuelve más listo?

Beto
Eso es la adaptación basada en refuerzo, aprendizaje por refuerzo ("Reinforcement Learning", RL). Y falta en alrededor del 84% de los agentes. La mayoría son motores de inferencia estáticos. Lo corriges hoy y mañana comete exactamente el mismo error.

Alicia
Eso es increíblemente frustrante. Los hace sentirse como máquinas tontas en vez de socios inteligentes.

Beto
Erosiona la confianza. Si tienes que corregir a tu asistente en la misma tarea cinco veces, lo despedirías.

Seguridad y Ética

Alicia
Esto nos lleva al segmento cinco, seguridad y ética. Si estas cosas son frágiles, estáticas y no están calibradas, ¿son seguras?

Beto
Los autores encontraron una brecha enorme entre la intención y la garantía. Todos los artículos dicen “la seguridad es nuestra prioridad”. Pero al mirar el código, faltan las barreras.

Alicia
Los números son contundentes.

Beto
Mecanismos de seguridad, como formas de evitar que la IA sea “liberada”, o evitar que haga algo claramente peligroso, faltan en el 65% de los estudios.

Y el cumplimiento normativo, implementar leyes como HIPAA o GDPR, faltaba en el 86% de los diseños.

Alicia
Espera, ¿el 86% de estudios de IA médica no incorporó cumplimiento con HIPAA o RGPD?

Beto
Confiaban en el LLM subyacente para ser “seguro”, pero no construyeron restricciones arquitectónicas específicas para garantizar la privacidad del paciente. No hay una línea de código que diga: si estos datos salen del entorno seguro, bloquear y registrar.

Alicia
Eso parece una demanda asegurada.

Tipología del Marco

Quiero tocar cómo se construyen estas cosas porque el artículo menciona una tipología que me pareció genial: el diseño multiagente.

Beto
Esta es la gran tendencia. Alrededor del 82% de los artículos no usan una sola IA; usan un equipo.

Alicia
Como un personal hospitalario digital.

Beto
Exacto. Puedes tener un agente que actúe como médico y proponga un diagnóstico; luego otro agente que actúe como crítico.

Alicia
Y su trabajo entero es apuntar fallos en el argumento.

Beto
Ese es su trabajo entero: “¿Estás seguro? ¿Comprobaste la presión arterial? ¿Y este resultado de laboratorio?”. En algunos trabajos debaten entre ellos.

Alicia
Eso es fascinante.

Beto
Artículos como ColaCare y MDAgents muestran que este proceso de debate reduce significativamente las alucinaciones. Obliga al sistema a revisar su trabajo. Simula el tipo de revisión por pares que ocurre en un hospital real.

Alicia
Tiene sentido. “Mide dos veces, corta una”. ¿Pero quién manda?

Beto
Ahí está el problema. El informe señala que la orquestación centralizada, tener un agente jefe de personal para coordinar al equipo, a menudo solo está parcialmente implementada, alrededor del 57%.

Alicia
Así que tienes un montón de “médicos” debatiente en una sala pero nadie que tome la decisión final.

Beto
Eso puede llevar a ciclos donde discuten indefinidamente o el flujo de trabajo se paraliza. Necesitas esa capa jefe que diga: “vale, hemos debatido suficiente; es hora de decidir”.

Aplicaciones

Alicia
Finalmente, segmento seis: ¿para qué están aplicando estos agentes? ¿Qué trabajos están haciendo en los estudios?

Beto
Los ganadores son la fruta más accesible. Benchmarking es enorme. El 80% de los artículos estaban probando los agentes contra exámenes. QA médica (preguntas y respuestas médicas) está totalmente implementado en 57% de los estudios.

Alicia
Así que son excelentes en trivia médica.

Beto
Y documentación: resumir historias clínicas, extraer códigos de facturación; alrededor del 45% lo hace bien. Es útil, pero administrativo.

Alicia
¿Y los perdedores? ¿Dónde están las carencias?

Beto
Lo de alto riesgo: planificación del tratamiento, prescribir un plan de cuidado completo, solo 20%. Interacción directa con el paciente, hablar con la persona enferma, solo 22%.

Alicia
Porque es demasiado arriesgado.

Beto
Es increíblemente arriesgado. Y descubrimiento de fármacos prácticamente inexistente en este conjunto de datos; el 80% lo ignoró. No estamos pidiendo a estos agentes que inventen nuevas curas todavía; intentamos que manejen el papeleo de las que ya existen.

Resumen

Alicia
Resumamos todo. Hemos revisado el boletín. Parece que tenemos un estudiante que es brillante en la biblioteca,

Beto
... sobresaliente en recuperación ...

Alicia
... y juega bien en equipo,

Beto
... notable en colaboración multiagente ...

Alicia
... pero se niega a aprender algo nuevo. Se cae cuando se va la conexión, actúa completamente de forma pasiva y no sabe cuándo dejar de hablar si está confundido.

Beto
Resumen duro pero justo: "F" en adaptación, "F" en robustez, "F" en garantías de seguridad.

Conclusión

Alicia
¿Cuál es la conclusión para el médico o desarrollador que nos escucha? ¿Es todo esto un gran fracaso?

Beto
No, en absoluto. La conclusión es que hemos pasado de modelos predictivos — adivinar la siguiente palabra — a marcos agentivos. La estructura está allí. Tenemos el cuerpo.

Alicia
... pero no el sistema inmunológico.

Beto
No tenemos aún el sistema inmune, la habilidad para detectar errores y adaptarse. Seguimos construyendo artefactos estáticos en un mundo dinámico. Para que estos agentes sean realmente seguros en un hospital, deben evolucionar. Necesitan detección de deriva, protocolos de desaprendizaje, deben ser lo bastante humildes para decir “no lo sé”.

Alicia
Hasta entonces son solo motores de búsqueda muy sofisticados y muy frágiles.

Beto
Sí, asistencia poderosa. No, agentes autónomos, absolutamente no. No puedes sacar al humano del circuito. Si la máquina no puede aprender de sus errores o reconocer cuando la situación cambia…

Alicia
Y eso nos lleva a nuestro pensamiento final para el análisis profundo. Siempre nos gusta dejar algo para masticar.

Beto
Aquí va mi pregunta: pasamos tanto tiempo preocupándonos de que la IA se vuelva demasiado inteligente, Skynet, una superinteligencia que nos domina, ¿estaremos preocupándonos por algo equivocado?

Alicia
¿Qué quieres decir?

Beto
El peligro inmediato en salud no es una IA que nos supere intelectualmente. Es una IA lo bastante inteligente para dar consejos convincentes pero demasiado tonta para saber que las guías médicas cambiaron el martes pasado.

Alicia
Un genio desactualizado podría ser más peligroso que un tonto.

Beto
Exacto. En medicina, lo que sabías hace cinco años no es solo noticia vieja; es mala praxis. Si no resolvemos el problema del olvido, no podremos tener médicos IA.

Alicia
Pensamiento sobrio: la inteligencia es saber qué aprender. La sabiduría es saber qué olvidar. Gracias por acompañarnos en el análisis profundo.

Beto
Nos vemos la próxima vez.

miércoles, 21 de enero de 2026

François Chollet: El Camino a AGI


En esta presentación, François Chollet argumenta que lograr la Inteligencia General Artificial (AGI) requiere un cambio fundamental: pasar de escalar modelos preentrenados a desarrollar sistemas capaces de adaptarse al tiempo de prueba. Sostiene que la IA actual destaca en la memorización de habilidades estáticas, pero carece de inteligencia fluida, que él define como la eficiencia con la que un sistema se adapta a situaciones novedosas. Para abordar esto, Chollet presentó el punto de referencia ARC-AGI, una prueba de estilo IQ diseñada para medir la capacidad de una máquina para razonar y resolver problemas únicos en lugar de regurgitar datos de entrenamiento. Explica que la verdadera inteligencia surge de la combinación de la intuición de tipo uno (el reconocimiento de patrones del aprendizaje profundo) con el razonamiento de tipo dos, que implica la búsqueda discreta de programas y la síntesis lógica. Al fusionar estos dos enfoques, su objetivo es ir más allá de la simple automatización hacia una IA capaz de invención autónoma y descubrimiento científico. El futuro del desarrollo de la IA, según Chollet, radica en la creación de metaparecencieros similares a programadores que puedan ensamblar y refinar dinámicamente abstracciones para navegar en un mundo impredecible.

Enlace al video en YouTube, para aquellos que quieran profudizar en el tema: "François Chollet: How We Get To AGI".

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Bienvenidos a un nuevo análisis profundo. Sabes, pasando tiempo en el mundo tecnológico estos últimos años, da la sensación de que todos hemos estado viviendo una enorme alucinación colectiva. Quiero decir, si retrocedes solo dos años hasta el pico absoluto del boom de la IA generativa, ¿qué, 2023, 2024?

Beto
Sí, exacto.

Alicia
Había una creencia absoluta e inamovible en el aire.

Beto
El dogma del escalado.

Alicia
Exacto, el dogma del escalado. La idea era tan simple. Tenemos estos grandes modelos de lenguaje. Si simplemente los hacemos más grandes, ...

Beto
... les ponemos más GPUs, ...

Alicia
... consumimos la electricidad de un país pequeño, les damos hasta el último fragmento de datos en internet. Inequívocamente se despertarán. Pensábamos que la IAG (inteligencia artificial general, AGI) era solo cuestión de más.

Beto
Era la era del “hacia arriba y a la derecha”. Miras la gráfica de rendimiento, la extrapolas y asumes que esa línea va al infinito como procedimiento estándar.

Pero hoy estamos haciendo un serio chequeo de la realidad. Estamos profundizando en una charla reciente del investigador en IA, François Challet, que básicamente dice que "la fiesta se acabó".

Alicia
Y esto no es solo una advertencia de desaceleración. Es un desmantelamiento completo de cómo pensábamos que funcionaba la IAG. El argumento de Challet es que la era del escalado ha muerto. Nos topamos con un muro. Pero — y por eso estoy tan entusiasmada con este análisis profundo — dice que hemos encontrado una nueva puerta. Pasamos de la era del chatbot a la era del programador de IA.

Beto
Es un momento pivotal. Estamos cambiando de pensar en la IA como "un sistema de recuperación de conocimiento", como un bibliotecario muy sofisticado, a pensar en ella como "un verdadero motor de razonamiento".

Alicia
Y para llegar ahí, tenemos que empezar con esta verdad realmente incómoda que él expone. Hemos estado confundiendo "habilidad" con "inteligencia".

Beto
Y ese es todo el meollo.

Alicia
Eso fue el primer golpe fuerte en el material fuente para mí, porque intuitivamente, si una máquina puede pasar el examen de abogado, escribir un script en Python y componer un soneto, yo llamo eso inteligente. Eso se siente como inteligente.

Beto
Bueno, esa es la definición al estilo Minsky. Nombrada por Marvin Minsky, la visión muy corporativa y enfocada en la producción. Si la máquina hace la tarea económicamente valiosa, si automatiza el trabajo, la llamamos “lista”.

Alicia
Pero Challet dice que eso es una trampa.

Beto
Una trampa enorme. Dice que eso no es inteligencia. Eso es sólo una habilidad cristalizada.

Alicia
Usó una metáfora que me pareció brillante: la red de carreteras frente a la empresa constructora de carreteras.

Beto
Es la forma perfecta de visualizarlo. Piensa en un gran modelo de lenguaje, como los GPTs que todos hemos usado durante años, como el mapa de una vasta red de carreteras. Si quieres ir del punto A al punto B, y los humanos ya construyeron una carretera ahí, la IA puede llevarte por esa ruta al instante. Es rápida, es impresionante, y parece que sabe a dónde va.

Alicia
Porque ya ha visto esa ruta antes. Está en los datos de entrenamiento. Solo está volviendo a trazar el paso.

Beto
Exacto. Pero aquí está la prueba real. La prueba de la verdadera inteligencia. ¿Qué pasa cuando le pides que vaya al punto C, y no hay carretera? ¿Qué pasa cuando la dejas en medio de un bosque denso donde ningún humano alguna vez puso una calzada?

Alicia
Los modelos actuales simplemente alucinan. Pretenden que hay una carretera. Pisan el acelerador y te llevan directo al precipicio.

Beto
Precisamente. En cambio, la verdadera inteligencia — la IAG — es la cuadrilla constructora de carreteras. La inteligencia no es el mapa. La inteligencia es la bulldozer. Es el proceso de mirar un terreno completamente nuevo, una situación que jamás has visto antes, y averiguar cómo construir un camino.

Alicia
Si entiendo bien esta razón de eficiencia, él habla de cuánto datos necesitas para aprender algo nuevo. Si una IA necesita leer 10 millones de poemas para escribir una rima simple, no es lista. Solo se apoya en una enorme base de datos de carreteras que los humanos ya construyeron.

Beto
Ese es el corazón matemático de su argumento. Define la inteligencia como una relación de conversión. En un lado tienes tus priors. Tus conocimientos innatos. Tus experiencias pasadas. En el otro lado tienes tu generalización. Qué tan bien manejas lo desconocido. Si necesitas datos masivos para hacer una tarea simple, tu ratio de conversión es terrible. Eres simplemente ineficiente.

Alicia
Dame un ejemplo humano.

Beto
OK, piensa en un niño. Le muestras a un niño de cuatro años tres fotos de un gato, solo tres. Y, de repente, ese niño puede reconocer todos los gatos que existen: gatos de dibujos, gatos durmiendo, gatos carey.

Alicia
Y la IA necesita miles, millones, ...

Beto
... tal vez decenas de miles de imágenes para hacer lo mismo. Esa brecha, eso es la inteligencia. La IA lo está forzando bruta. El niño lo está abstrayendo.

Alicia
Esto explica realmente por qué nos dejamos engañar tan fácilmente por los benchmarks durante tanto tiempo. Durante años, los titulares eran todos “IA aplasta los SATs”. “IA pasa los exámenes médicos”.

Beto
Los tratábamos como pruebas de pensamiento. Pero en realidad eran pruebas de memorización. Caímos en la regla del atajo. En ingeniería, si eliges una métrica, el sistema la optimizará. Los exámenes estándar miden conocimiento estático. Pero los LLMs están entrenados en la internet pública.

Alicia
Básicamente llevan la clave de respuestas en el bolsillo.

Beto
Es como impresionarse de que un niño sacó un sobresaliente en historia y luego descubrir que tenía el libro abierto en el regazo todo el tiempo.

Alicia
Exacto.

Beto
Así que, en 2019, Challet dijo: necesitamos una prueba donde no puedas hacer trampa. Y creó ARC, el "Abstraction and Reasoning Corpus".

Alicia
Pasé algún tiempo investigándolo. Los rompecabezas, o acertijos, de ARC me recuerdan a esas viejas pruebas de coeficiente intelectual. Cuadrículas simples, cuadrados coloreados. Ves un cuadrado azul moviéndose a la izquierda, un cuadrado rojo quedándose quieto. ¿Qué pasa después?


Ejemplo de tarea ARC-AGI

Beto
Visualmente son increíblemente simples. Pero la trampa es que cada rompecabezas en la prueba ARC es único. El patrón específico nunca ha aparecido en internet.

Alicia
Así que no puedes memorizar la respuesta.

Beto
No puedes. Porque la respuesta no existe en ningún lugar de los datos de entrenamiento. Tienes que mirar la cuadrícula, deducir la regla al vuelo. ¿Es gravedad? ¿Es simetría? ¿Es contar? Y luego aplicarla.

Alicia
Y durante mucho tiempo, los modelos multimillonarios estuvieron puntuando… ¿qué? Casi cero. Fue embarazoso. Mientras escribían poesía shakespeariana, no podían resolver un rompecabezas que un niño de cuatro años podría resolver. Esa fue la evidencia decisiva de que el escalado no estaba funcionando. No puedes escalar para resolver un rompecabezas que nunca has visto.

Beto
Corrrecto. Y esto es un gran giro en nuestra historia hoy, eso cambió recientemente. Tenemos que hablar del momento o3 a finales de 2024.

Alicia
Sí. OpenAI lanzó el modelo o3, y finalmente descifró el código del ARC original. Alcanzó rendimiento a nivel humano.

Beto
¿Resolvían la IAG? ¿Descubrieron la cuestión de construir carreteras?

Alicia
Resolveron una parte muy específica, lo que nos lleva al segundo concepto importante de esta inmersión: la adaptación en tiempo de prueba.

Beto
OK, desglósamelo.

Alicia
"Adaptación en tiempo de prueba" ("test-time adaptation"). Suena a jerga, pero el concepto es bastante relatable, ¿no?

Beto
Lo es. Tradicionalmente, una IA es estática. La entrenas. La congelas. Y cuando le haces una pregunta, solo escupe la palabra más probable siguiente. Es un reflejo instantáneo.

Alicia
Una reacción automática. Así que cuando alguien pregunta “¿cómo estás?” y dices “bien” antes de comprobar si realmente lo estás.

Beto
Exactamente. Pero o3 hace algo diferente. Cuando le das un problema, no responde de inmediato. Se pausa. Piensa. Genera múltiples posibilidades. Tal vez intenta escribir un pequeño fragmento de código internamente para probar una teoría, ve si funciona, y luego itera. Adapta su comportamiento durante la prueba.

Alicia
Está mostrando su trabajo.

Beto
Está buscando. Esencialmente corre una pequeña simulación en su cabeza antes de hablar. Y eso le permitió abrirse paso por la lógica del primer test ARC mediante fuerza bruta.

Alicia
Bien. Entonces, si o3 descifró ARC-1, ¿por qué Challet sigue diciendo que no hemos llegado? ¿Por qué esto no es el final de la discusión?

Beto
Porque Challet, siendo el científico que es, movió inmediatamente el listón. Lanzó ARC-2. Y aquí es donde la brecha entre la inteligencia humana y la simulación de máquina se vuelve dolorosamente, casi cómicamente obvia.

Alicia
El experimento de San Diego, me encanta esa parte de las notas, se sintió como el montaje de un reality show.

Beto
Es ciencia fantástica. La crítica a ARC-1 siempre fue: bueno, tal vez esos rompecabezas son demasiado difíciles para cualquiera. Así que quisieron comparar ARC-2 con humanos normales. No fueron a MIT. No fueron a Stanford. Fueron a San Diego y reclutaron 400 personas al azar, conductores de Uber, estudiantes, gente buscando trabajo rápido.

Alicia
Personas comunes en la calle: “oye, ¿quieres 20 dólares? Resuelve este rompecabezas”.

Beto
Exacto. Estos rompecabezas lógicos, el resultado: si tomabas un grupo de 10 humanos al azar y les permitías votar la respuesta, puntuaban 100%.

Alicia
100%. Así que son tareas solucionables.

Beto
Realmente solucionables. Y la IA, los supermodelos que costaron cientos de millones de dólares entrenar, los mejores modelos obtuvieron 0%.

Cero absoluto. Incluso los modelos de razonamiento que usaron esa adaptación en tiempo de prueba que acabamos de comentar apenas rascaron 1% o 2%.

Alicia
Eso es una desconexión asombrosa. Humanos 100%. Máquinas 0%. ¿Qué está probando ARC2 que rompe a las máquinas tan mal?

Beto
Está probando la generalización composicional.

Alicia
OK, eso es un bocado. Desgranémoslo.

Beto
Es la capacidad de tomar dos conceptos distintos que ya conoces, digamos el concepto de gravedad y el concepto de ordenar por color, y combinarlos de una manera completamente nueva para resolver un problema que nunca has visto.

Alicia
No se trata solo de reconocer un patrón, se trata de remezclar patrones.

Beto
Es extrapolación. El "deep learning" ("aprendizaje profundo") tal como existe hoy es fantástico en interpolación. Adivinar lo que hay entre puntos de datos que ya vio es como conectar los puntos. Pero es terrible en extrapolación: salir de esos puntos para construir una forma nueva por completo.

Alicia
Así que tienes estos cerebros masivos que pueden memorizar el mundo, pero no pueden inventar un nuevo pensamiento.

Beto
No pueden razonar frente a la novedad. Y esto nos lleva a la parte más alocada de la teoría de Challet. Él la llama "la hipótesis del caleidoscopio".

Alicia
Tengo que decir, para ser informático, se le ocurren nombres muy poéticos.

Beto
Realmente. La hipótesis del caleidoscopio básicamente dice que el universo parece infinitamente complejo, pero eso es una ilusión. En realidad, todo lo que vemos es solo una remezcla de un conjunto muy pequeño de átomos fundamentales de significado.

Alicia
Átomos de significado.

Beto
Piensa en un caleidoscopio. Dentro del tubo solo hay unas pocas cuentas de colores, quizá cinco o seis. Pero al girar el tubo, los espejos reflejan y recombinan esas cuentas en patrones complejos infinitos.


Ejemplo de una imagen de caleidoscopio

Alicia
Lo veo. Miras el patrón, parece complicado. Pero si entiendes el mecanismo, sabes que es solo cuenta púrpura + cuenta verde + espejo.

Beto
Exacto. La inteligencia es la habilidad de mirar el mundo complejo y revertirlo hasta esos átomos. Por ejemplo, una estructura ramificada. La ves en el árbol, en el delta de un río, en las venas de un pulmón humano. Es el mismo átomo de significado aplicado en contextos distintos. Si realmente entiendes la ramificación, puedes entender todos esos sistemas.

Alicia
Y entonces Challet argumenta que para construir una IAG necesitamos un sistema que pueda manejar estos átomos usando dos tipos distintos de pensamiento.

Beto
Cierto. Lo descompone en abstracción de tipo uno y tipo dos. Puedes pensarlo como hemisferio derecho e izquierdo.

Alicia
Entonces, tipo uno es el hemisferio derecho. Es la parte de la intuición.

Beto
Sí. Tipo uno es percepción. Es continua. Es difusa. Es como reconocer una cara en una multitud. No sacas una regla y mides la distancia entre los ojos. Simplemente sabes. Esto es en lo que el deep learning y los transformers son increíbles. Tienen una intuición increíble. Pueden “vibrar” hasta una respuesta.

Alicia
Y tipo dos.

Beto
Tipo dos es el hemisferio izquierdo. Es la lógica. Es discreto. Es planificación paso a paso. Esto es lo que es el código de computadora. Si estás ordenando una lista de nombres alfabéticamente, las corazonadas no funcionan. Tiene que ser exacto. Si fallas una letra, toda la palabra está mal. El deep learning en realidad es terrible en esto porque es probabilístico. Siempre está adivinando.

Alicia
Hasta ahora hemos intentado construir una IAG usando solo el hemisferio derecho. Intentamos usar intuición para hacer matemáticas.

Beto
Y por eso alucina: intenta intuir un hecho lógico. El futuro, según Challet, es híbrido. Es el programador de IA.

Alicia
Este es el cambio. De chatbot a programador, ¿cómo funciona eso en la práctica? No estamos hablando solo que chatGPT escriba un script para mí.

Beto
No, no. Es mucho más profundo. Es en lo que labs como Tendi están trabajando. En lugar de pedirle a un modelo que simplemente te hable, le pides que resuelva un problema. El modelo efectivamente dice: “OK, no sé la respuesta de inmediato. Pero puedo escribir un programa para encontrarla”.

Alicia
Entonces usa la intuición tipo 1 para decidir qué escribir.

Beto
Sí. Usa el “cerebro derecho” de deep learning para buscar en su biblioteca de átomos, esos pequeños fragmentos de código, funciones lógicas, y los cose. Sintetiza un nuevo programa específicamente para tu problema.

Alicia
Y luego el hemisferio izquierdo tipo 2 ejecuta ese código.

Beto
Exacto. Y ese es el truco mágico. El código no alucina. Si el código compila y corre, la respuesta es lógicamente válida. Está anclada en la realidad.

Alicia
Eso suena como un salto enorme. En lugar de una máquina que dice “creo que la respuesta es 42”, es una máquina que dice “escribí un script, ejecuté el cálculo y la salida es 42”.

Beto
Es la diferencia entre alquimia y química. Y lo fascinante es que este sistema puede aprender. Cuando resuelve un problema nuevo, por ejemplo, si descubre una nueva forma de ordenar datos, puede guardar ese pequeño programa de vuelta en su biblioteca. Añade un nuevo átomo a su caleidoscopio.

Alicia
Así que en realidad está construyendo la compañía constructora de carreteras. Está acumulando herramientas.

Beto
Está construyendo las herramientas que construyen las carreteras. Se vuelve más lista, no por memorizar más texto, sino por expandir su caja de herramientas lógicas.

Alicia
Tiene tanto sentido por qué la "adaptación en tiempo de prueba" es la palabra de moda entonces. La inteligencia no está en el modelo congelado. Está ocurriendo en vivo mientras escribe y prueba ese código.

Beto
Y esta trayectoria nos lleva a donde va la pelota. Porque si ARC-2 es el obstáculo actual, ya se están provocando retos que insinúan ARC-3, que aparentemente viene en 2026.

Alicia
Y esto sonó divertido en las notas: ARC-3 son videojuegos.

Beto
Lo es. Pero no se trata de puntajes altos. Es una prueba de agencia. Imagina dejar a una IA en un videojuego simple que nunca ha visto antes. No sabe los controles. No sabe si debe saltar, disparar o recoger monedas. Tiene que averiguarlo.

Alicia
Siento que he visto a mis amigos jugar así: se estrellan contra una pared durante 10 minutos hasta que presionan el botón correcto.

Beto
Y eso es exactamente lo que la IA no puede hacer. La restricción clave para ARC-3 es la eficiencia. Challet va a limitar cuántas acciones puede tomar la IA. No puede simplemente aporrear botones un millón de veces a la velocidad de la luz. Uh-oh. Tiene que mirar la pantalla, usar esa intuición tipo 1 para adivinar “eh, eso azul parece agua, probablemente no debería pisarlo”, y luego usar la lógica tipo 2 para planear una ruta por el puente.

Alicia
Tiene que aprender a la velocidad de un humano.

Beto
Ese es el santo grial. Si podemos construir una IA que aprenda un nuevo entorno tan eficientemente como un humano, hemos pasado de la automatización a la invención.

Alicia
Distingamos esos dos porque en el mundo corporativo suenan igual. Automatización, invención.

Beto
Son mundos aparte. Si nos quedamos con los modelos viejos de escalado, las redes de carreteras, conseguimos automatización. Podemos automatizar correos, servicio al cliente, codificación básica. Eso es enorme económicamente. Claro, abarata las cosas existentes. Pero no resuelve problemas nuevos.

Alicia
Solo hace lo antiguo más rápido.

Beto
Correcto. Pero la vía de la invención, el programador IA, el científico, lleva al descubrimiento. Una IA que puede inventar no solo escribe un email de marketing. Mira un conjunto de datos biológicos que ningún humano entiende y escribe un programa para modelar una nueva estructura proteica.

Alicia
Wow.

Beto
Descubre la física de un reactor de fusión. Resuelve problemas para los que aún no tenemos la clave de respuestas.

Alicia
Esa es una visión mucho más inspiradora. No se trata solo de reemplazar el centro de atención telefónica. Se trata de asociarse con el investigador del cáncer.

Beto
Es la diferencia entre una IA que optimiza la economía que ya tenemos y una IA que expande el horizonte de lo posible para nuestra especie.

Alicia
Para recapitular el viaje de hoy: empezamos con la muerte del dogma del escalado. Nos dimos cuenta de que solo hacer el cerebro más grande no lo hace más inteligente.

Beto
Aprendimos que la verdadera inteligencia es un proceso. Es una compañía constructora de carreteras. Y se mide por cuán eficientemente puedes adaptarte a lo desconocido.

Alicia
Vimos que, mientras la IA finalmente descifró el primer test tipo IQ, ARC-1, se desplomó por completo en ARC-2 porque le falta esa lógica rigurosa del hemisferio izquierdo.

Beto
Y la solución es el caleidoscopio. Es el modelo híbrido, combinando el reconocimiento de patrones del deep learning con la lógica discreta y fiable de un programador.

Alicia
Realmente me hace mirar mi propio proceso de pensamiento de forma distinta. Cuando estoy atascada en un problema, ¿estoy simplemente tratando de recordar qué hice la última vez? ¿O estoy realmente activando mi lógica tipo 2 para construir una solución nueva?

Beto
Todos confiamos en el tipo 1 más de lo que admitimos. Es más fácil. Las corazonadas son baratas. La lógica es cara. Pero la magia de la inteligencia humana es que podemos cambiar. Y la búsqueda de la IAG es realmente la búsqueda de construir una máquina que tenga esa misma flexibilidad.

Alicia
Un espejo hecho de silicio.

Beto
Y dejo al oyente con este pensamiento. A menudo tememos a la IAG porque pensamos que será ajena. Una caja negra y fría que lo sabe todo. Pero si Challet tiene razón, la verdadera IAG será sorprendentemente familiar. No será un dios. Será un científico. Se detendrá. Dirá “no lo sé”. Intentará experimentar. Fracasará. Reescribirá su código. Y lo intentará de nuevo. Y personalmente, me resulta mucho más reconfortante una máquina que admite que necesita pensar que una que finge saberlo todo.

Alicia
Un científico que nunca duerme y que aprende a la velocidad de la luz.

Beto
Exacto.

Alicia
Bueno, esto es todo para este análisis profundo. Quiero que te lleves esta pregunta hoy: ¿estás construyendo carreteras o solo conduces por las que ya conoces?

Beto
Siempre sigue construyendo.

Alicia
Gracias por escuchar a todos. Nos vemos en el próximo episodio.