Mostrando entradas con la etiqueta TRM. Mostrar todas las entradas

miércoles, 21 de enero de 2026

Informe Técnico del Premio ARC 2025


El Informe Técnico del Premio ARC 2025 detalla el progreso y las metodologías utilizadas para resolver el punto de referencia ARC-AGI-2, un conjunto de datos diseñado para medir la inteligencia artificial general a través de nuevas tareas de razonamiento. Una de las principales conclusiones de la competencia es el auge de los ciclos de refinamiento, que permiten a los sistemas mejorar iterativamente sus respuestas mediante entrenamiento en tiempo de prueba o síntesis de programas evolutivos. Las soluciones de mayor rendimiento incluyeron NVARC, que alcanzó una precisión del 24%, y el Tiny Recursive Model, que demostró que las redes pequeñas de 7 millones de parámetros pueden realizar razonamientos complejos. A pesar de estos avances, el informe señala que la IA actual sigue limitada por la cobertura del conocimiento, lo que lleva a un nuevo tipo de contaminación del punto de referencia donde los modelos se basan en la exposición previa a datos en lugar de la lógica pura. Para abordar estas limitaciones, los organizadores anunciaron ARC-AGI-3, que introducirá entornos interactivos para la planificación y la memoria de pruebas. En último término, el informe enfatiza que para lograr una verdadera inteligencia fluida es necesario ir más allá de la correspondencia de patrones estáticos hacia una adaptación eficiente y autónoma.

Enlace al articulo cientifico, para aquellos interesados en profundizar en el tema: . Por François Chollet y colegas. Publicado el 19 de Enero del 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Bienvenidos a un nuevo análisis profundo. Hoy es Martes 20 de Enero del 2026. Y mira, si te has sentido un poco abrumado por el ciclo de exageración de la IA, ...

Beto
Solo un poco.

Alicia
Ya sabes cómo va: Cada semana aparece un nuevo modelo que supuestamente desafía las leyes de la física. Hoy vamos a aterrizar un poco porque ayer se publicó el informe técnico del premio ARC 2025.

Beto
Por fin. Estuve refrescando mi feed todo el fin de semana por esto.

Alicia
Y para quien no lo sepa, esto no es solo otro comunicado de prensa de un gigante tecnológico. Esto es, no sé, ¿cómo llamarlo? ¿El control de realidad anual?

Beto
Eso es exactamente. Es la auditoría. Es el momento en que dejamos de mirar las demos brillantes y realmente, ya sabes, abrimos el capó para ver si el motor está funcionando. Y sinceramente, el informe de este año quizá sea el documento más importante que hemos visto en los últimos cinco años de IA.

Alicia
Grandes afirmaciones desde el principio. Pero la misión del análisis profundo es desglosar exactamente por qué. Porque el número principal, la gran cifra de 2025, es impactante. Pero antes de llegar ahí, tenemos que definir el problema. Quiero decir, tenemos Gemini 3. Tenemos Claude Opus 4.5.

Beto
Herramientas increíbles.

Alicia
Pero la pregunta que plantea este informe es: ¿están pensando?

Beto
Correcto. Y hay una diferencia enorme entre conocimiento e inteligencia. Y ahí es donde está la fricción. Si le pido a una IA que escriba un script en Python, lo hace al instante. ¿Por qué? Porque ha visto un millón de ejemplos en GitHub. Está recordando, no inventando.

Alicia
Es un loro muy, muy sofisticado.

Beto
Un loro con memoria fotográfica de internet entero. Pero el benchmark ARC-AGI está diseñado para desenmascarar al loro. Está pensado específicamente para probar la inteligencia fluida. "¿Puedes resolver un problema que nunca, jamás, hayas visto antes?"

Alicia
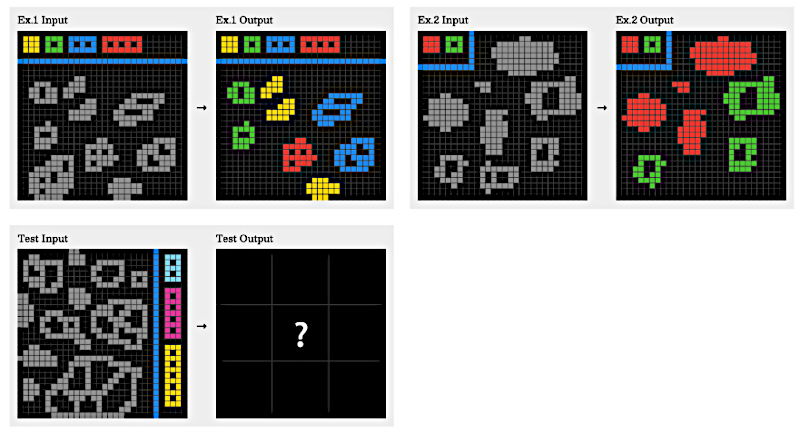
Y para quien escuche y no conozca estos rompecabezas, tenemos que pintarlo. No estamos hablando de matemáticas complejas.

Beto
No, no, es engañosamente simple. Imagínate una pequeña cuadrícula, como un tablero de ajedrez pequeño. Y dentro hay casillas de colores. Rojo, azul, verde. Parece pixel art de 8 bits de los años 80. Te dan tres ejemplos. Ejemplo A: un cuadrado azul se mueve un paso a la derecha. Ejemplo B: vuelve a ocurrir. Ahora aquí tienes una cuadrícula de prueba. ¿Qué le pasa al cuadrado azul?
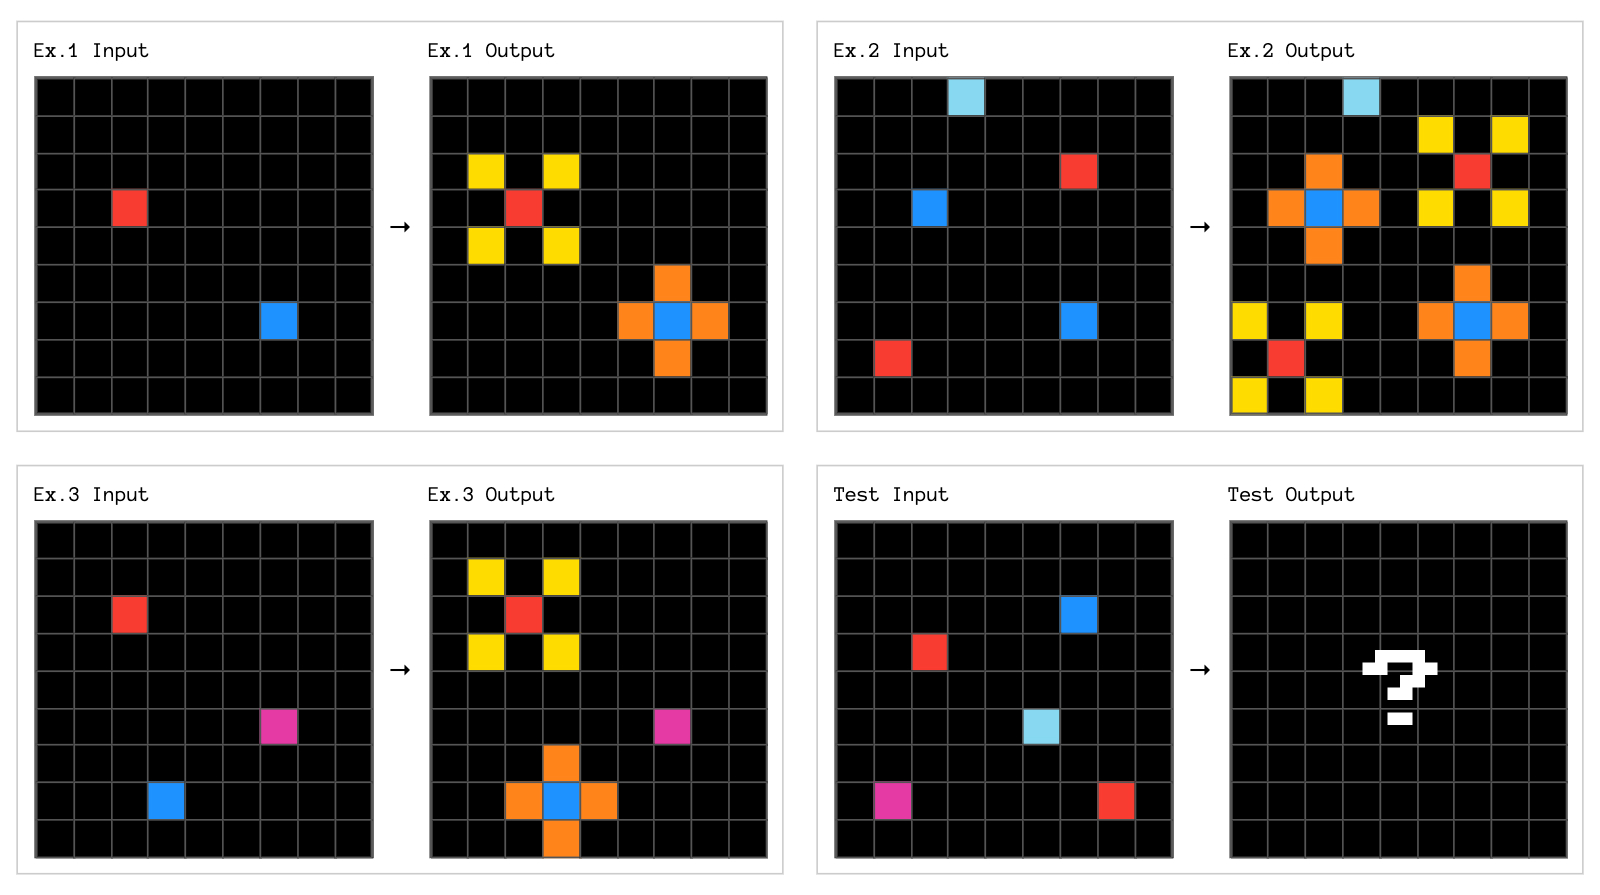

Ejemplo de tarea ARC-AGI

Alicia
Muévelo un paso a la derecha.

Beto
Boom. Lo resolviste. Un niño pequeño puede resolverlo. Pero durante los últimos cinco años estas enormes supercomputadoras miran esa cuadrícula y simplemente se estrellan, alicinan.

Alicia
Porque no encuentran la respuesta en sus datos de entrenamiento.

Beto
Exacto. Tienen que deducir la regla sobre la marcha.

Alicia
Ayer salieron los resultados de 2025. Los equipos de IA más inteligentes del mundo, miles de ellos. Y la puntuación más alta en la nueva prueba, más dura, es 24%. Tengo que ser honesta: cuando lo vi pensé que era un error. Estamos tan acostumbrados a ver, ya sabes, 99 % de precisión, que 24 % suena a que hemos perdido la clase. ¿Hemos chocado contra un muro?

Beto
Da esa sensación, ¿no? Pero hay que contextualizarlo. Esto es ARC-AGI-2. La prueba se hizo más difícil. El año pasado, en las cosas realmente duras, los modelos apenas llegaban a un dígito. Eso es conjetura aleatoria. Así que llegar al 24 % es en realidad un salto monumental. Es la diferencia entre una IA totalmente ciega a la lógica y una que empieza a entrecerrar los ojos y a ver formas.

Alicia
¿Y cómo se compara eso con nosotros, con los humanos?

Beto
Esa es la línea base crítica, ¿cierto? Ejecutaron esta prueba exacta en grupos humanos, gente normal, no PhDs en matemáticas. La puntuación humana fue 100 %.

Alicia
100 %. ¿Incluso en las difíciles?

Beto
Cada tarea solucionable la resolvieron los humanos. Miramos la cuadrícula. Vemos el patrón. Lo hacemos. Así que esa brecha entre 1 y 24 %. Esa es la brecha de inteligencia. Ese es el valle que intentamos cruzar.

Alicia
¿Quiénes son los que llegaron al 24 %? ¿Es Google, OpenAI?

Beto
Es todo el mundo. Este año fue enorme: 1.455 equipos, más de 15.000 inscripciones. Pero el equipo ganador, NVARC y los demás, no solo están lanzando más cómputo. Están cambiando fundamentalmente cómo opera la IA. Y ya no es barato.

Alicia
El informe mencionó un coste, algo así como 20 centavos por tarea.

Beto
Aproximadamente. Sí.

Alicia
Suena a nada. Quiero decir, 20 centavos son monedas sueltas.

Beto
Pero en el mundo de la inferencia de IA, 20 centavos es una fortuna. Normalmente hacer una consulta a un modelo cuesta una fracción de centavo. Así que gastar 20 centavos en un pequeño rompecabezas lógico significa que el ordenador está trabajando duro. Está rindiendo. Pasamos de respuestas instantáneas a, bueno, tiempo de pensar.

Alicia
Lo que nos lleva al tema más grande del informe. La conclusión de 2025: la idea del "ciclo de refinamiento".

Beto
El ciclo de refinamiento. Suena técnico, pero en realidad es muy intuitivo. Es cómo tú y yo resolvemos problemas.

Alicia
Vamos a desglosarlo. ¿En qué se diferencia esto del método de 2024 de "prompt-and-pray"?

Beto
La forma antigua, el pensamiento de Sistema 1, básicamente es respuesta rápida. Le muestras la cuadrícula a la IA y solo adivina. La respuesta es esta. Es pura intuición.

Alicia
Como cuando alguien te pregunta cuánto es dos más dos y tú dices cuatro, sin pensar.

Beto
Exacto. Pero los rompecabezas ARC necesitan Sistema 2, pensamiento deliberativo. Y el ciclo de refinamiento fuerza a la IA a hacer eso. Genera una solución potencial, como un pequeño programa de ordenador que cree resuelve el patrón, pero no lo entrega todavía.

Alicia
Verifica su trabajo.

Beto
Verifica su trabajo. Ejecuta el programa con los ejemplos. Si falla, recibe retroalimentación: "oye, acertaste la casilla roja, pero la azul está mal". Toma ese feedback y reescribe la solución. Se mueve en un ciclo: Genera, verifica, refina y repite.

Alicia
Es como escribir un ensayo. Yo nunca tecleo un borrador final de golpe. Escribo un párrafo, lo leo, veo que es basura, borro una frase y la reescribo. Ese ciclo es el proceso de pensar.

Beto
Esa es la realización profunda aquí: pensar no es un estado, es un proceso. Es un ciclo. Los ganadores, NVARC, los arquitectos, básicamente construyeron sistemas que funcionan como un programador depurando su propio código.

Alicia
Así que la IA no solo mira píxeles; literalmente escribe código para resolver la lógica.

Beto
Sí. Escribe un script en Python. Si el script falla, lee el mensaje de error y corrige el script. Eso es un cambio enorme respecto a solo predecir la siguiente palabra.

Alicia
Esto trae algo que me pareció totalmente contraintuitivo. Normalmente estado del arte en IA significa más grande, ¿no? Queremos billones de parámetros.

Beto
La escala lo es todo, dogma. Ha sido la religión de la IA durante una década.

Alicia
Exacto. Pero este informe lanza una granada a esa idea. Parte de los trabajos más impresionantes vinieron de modelos que, bueno, son diminutos.

Beto
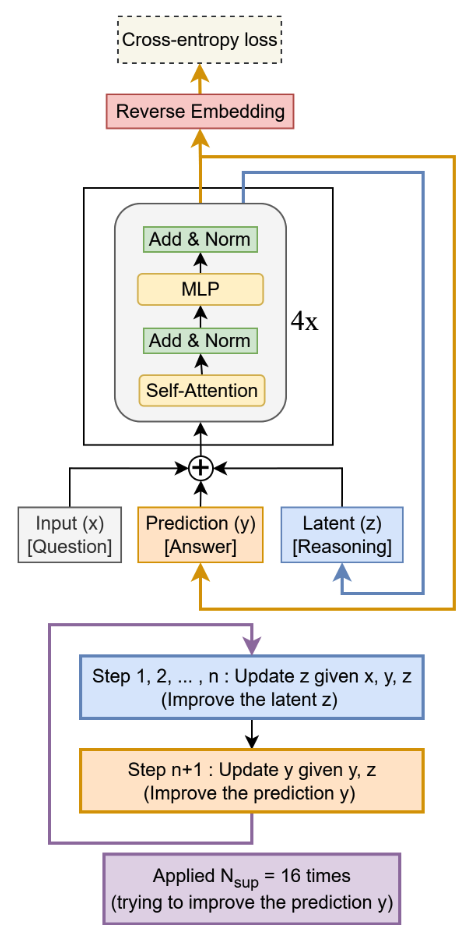
Esta es mi parte favorita del informe: la narrativa de David contra Goliat. Hablemos del ganador del premio al mejor artículo. Una investigadora llamada Alexia Jolicoeur-Martineau construyó un modelo llamado TRM (Tiny Recursive Model).
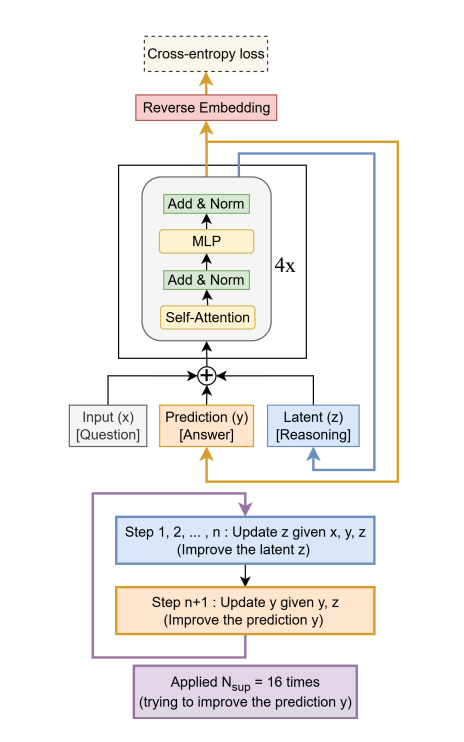

Arquitectura TRM

Alicia
Ok. Cuando dices "tiny", ¿qué tan pequeño estamos hablando?

Beto
Siete millones de parámetros.

Alicia
Siete millones. Para contexto, ¿cómo se compara eso con algo como GPT-5?

Beto
No sabemos las cifras exactas de los modelos fronterizos grandes, pero están en los trillones. Así que TRM es como 0,001 % del tamaño. Es un grano de polvo. Puedes ejecutar esto en un portátil decente.

Alicia
Y está ganando premios por razonamiento. ¿Cómo es eso posible?

Beto
Demuestra que el tamaño no lo es todo. TRM usa ese ciclo recursivo del que hablábamos. Tiene lo que llaman un "estado latente". Lo pienso como una hoja de borrador en su memoria. Mira el problema, actualiza la hoja, vuelve a mirar, actualiza otra vez. Hasta 16 veces antes de dar una respuesta.

Alicia
Está masticando el problema. Deliberando.

Beto
Sí. Prioriza la profundidad del pensamiento sobre la amplitud del conocimiento. No sabe quién es el presidente de Francia. Pero sabe razonar a través de una compuerta lógica. Es especialista, claro, pero en realidad está pensando.

Alicia
Y hay otro, ¿no? CompressARC. El tercer lugar, este sonó casi imposible.
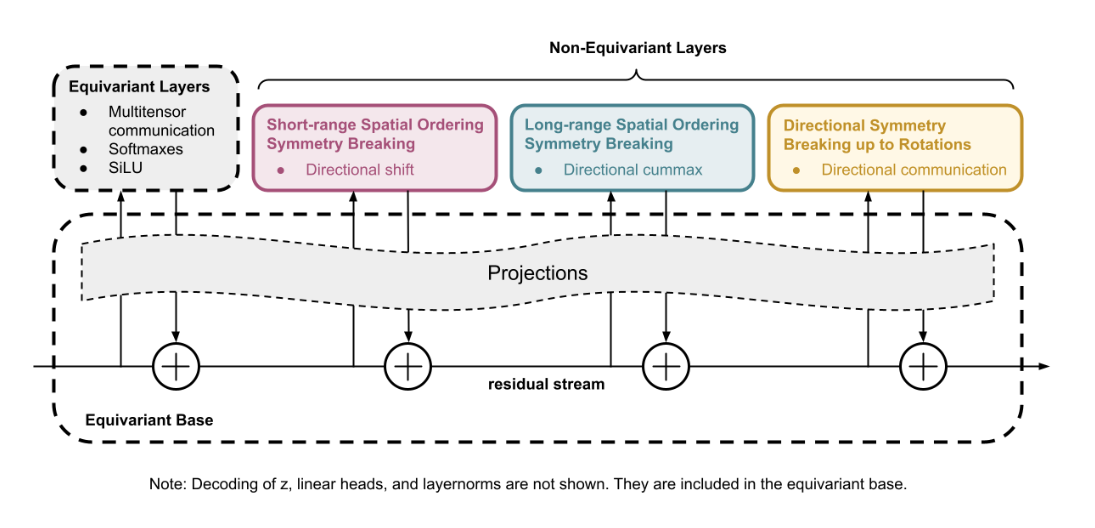

Arquitectura CompressARC

Beto
Es de Liao y Gu. Este es aún más pequeño: 76.000 parámetros.

Alicia
76.000. Eso no parece un modelo; parece una app calculadora.

Beto
Y aquí está lo contundente: tiene cero preentrenamiento.

Alicia
Espera, explica eso. Cero preentrenamiento significa que nunca ha visto una cuadrícula antes. Nunca practicó.

Beto
Nunca. Aprende desde cero en tiempo real en el momento de la prueba.

Alicia
¿Cómo podría resolver algo?

Beto
Trata el rompecabezas como un problema de compresión. Es algo profundo, pero es genial. Mira la cuadrícula y se pregunta: ¿cuál es el programa de ordenador más corto posible que puedo escribir que describa este cambio?

Alicia
Está jugando a code golf.

Beto
Exacto. Si puedes escribir un programa corto y elegante que explique el patrón, probablemente lo has entendido. Si tu explicación es larguísima y desordenada, probablemente no lo entiendes. Y este modelo simplemente minimiza esa longitud de descripción.

Alicia
Es una locura. Sugiere que la inteligencia es solo compresión eficiente.

Beto
Esa es la teoría: la inteligencia toma datos desordenados y los comprime en una regla simple, E = mc². Y estos modelos diminutos demuestran que puedes hacer eso sin memorizar antes internet entero.

Alicia
Bien, tenemos estos francotiradores diminutos y eficientes por un lado. Pero hablemos de los elefantes en la habitación: DeepMind y Anthropic, OpenAI, también están en el informe.

Beto
Están, y usan ciclos de refinamiento también, sí, pero de forma diferente. Usan cadenas de pensamiento ("Chain of Thought", CoT) masivas.

Alicia
El informe menciona un caso donde Gemini 3 usó 138.000 tokens para una tarea. Es una novela entera solo para averiguar dónde va un cuadrado azul.

Beto
Funciona hasta cierto punto. Pero el informe destaca una tendencia muy peligrosa con estos modelos grandes. La llaman "sobreajuste dependiente del conocimiento" ("knowledge-dependent overfitting").

Alicia
... que suena a una manera fina de decir que están haciendo trampa.

Beto
No es trampa maliciosa, pero es trampa funcional. Hay un ejemplo concluyente en el informe que además es algo divertido.

Alicia
El incidente "magenta 6". Explícanos ese ejemplo.

Beto
Ok, en el sistema ARC, los números representan colores. Cero es negro, uno es azul, y así. Pero el significado es arbitrario. El modelo solo ve una cuadrícula de números.

Alicia
Correcto. No debería saber qué es cada color.

Beto
Exacto. Entonces Gemini 3 está resolviendo una tarea y, en su razonamiento interno, en su cadena de pensamiento, produce la frase: “El patrón es magenta 6”.

Alicia
¿Y por qué eso es la prueba irrefutable?

Beto
Porque el prompt, las instrucciones dadas a la IA para ese test específico, nunca mencionaron que el número 6 equivale al color magenta.

Alicia
Entonces, ¿cómo lo supo?

Beto
Lo supo porque ha memorizado el repositorio de GitHub de ARC. Su entrenamiento incluyó esos datos; no estaba viendo la cuadrícula y deduciendo que 6 es magenta, estaba accediendo a una memoria que le decía que en el dataset ARC el 6 suele ser magenta.

Alicia
Eso es malo. Es como un estudiante en un examen de matemáticas que en vez de resolver la ecuación recuerda haber visto un ejercicio similar en el libro y escribe esa respuesta.

Beto
Exacto. Y eso es inteligencia defectuosa. Son unos genios en cosas que han visto antes o que se parecen a cosas que han visto. Pero dales algo verdaderamente novedoso y entran en pánico.

Alicia
Así que los modelos grandes están usando su memoria masiva como muleta para evitar el razonamiento real, ...

Beto
... lo que destruye el propósito del benchmark. Queremos probar habilidad, no memoria. Si el modelo solo hace una búsqueda en una base de datos, no hemos construido AGI. Hemos construido una mejor búsqueda de Google.

Alicia
Entonces si estos rompecabezas estáticos se contaminan, si la IA básicamente ha memorizado la prueba, ¿a dónde vamos? El informe dice que ARC-AGI-3 viene pronto.

Beto
Muy pronto. A principios de 2026, y es un cambio de paradigma masivo. Pasamos de imágenes estáticas a entornos interactivos.

Alicia
Descríbelo. ¿Es como un videojuego?

Beto
En cierto sentido, sí. En vez de “aquí tienes una entrada, dame la salida”, la IA se convierte en un agente. La sueltan en un mundo. Puede que ni siquiera vea la cuadrícula completa a la vez. Tiene que moverse. Tiene que explorar.

Alicia
Es como una mazmorra de videojuego: no conoces el mapa, tienes que andar para encontrar la llave.

Beto
Sí. Prueba la inferencia activa. ¿Puedes interactuar con el mundo para aprender sobre él? Tienes que planear. Necesitas memoria de trabajo de lo que viste hace tres habitaciones. Tienes que averiguar cuál es la meta.

Alicia
Suena exponencialmente más difícil.

Beto
Lo es. Pero también resuelve el problema de hacer trampa. No puedes memorizar la solución si la solución depende de cómo interactúes con el entorno en tiempo real.

Alicia
Y el informe vuelve a mencionar la eficiencia aquí.

Beto
Esa es la métrica a vigilar. No solo mediremos si lo resolviste; mediremos cuántos pasos te tomó. Un humano puede tocar una pared, darse cuenta de que es falsa y atravesar tres pasos. Una IA puede chocar con cada pared durante una hora antes de encontrar la salida.

Alicia
Si la IA necesita un millón de pasos para hacer lo que un humano hace en 10, no es inteligente, es solo persistente.

Beto
Exacto. Queremos medir la eficiencia de muestra: ¿qué tan rápido puedes aprender una regla nueva? Ese es el santo grial. No se trata de cuánta data tienes, sino cuán poca data necesitas.

Alicia
Se siente como si estuviéramos en una bifurcación filosófica.

Beto
Dos caminos distintos.

Alicia
Por un lado están los grandes laboratorios comerciales: más datos, modelo más grande. Y se están pegando con este muro donde los modelos memorizaron el universo.

Beto
Y por el otro, el campo de los mejores algoritmos: los modelos diminutos, los ciclos de refinamiento, la gente que dice que no necesitamos un cerebro más grande, necesitamos un mejor proceso para pensar.

Alicia
E irónicamente, los modelos pequeños y peleones parecen imitar mejor los procesos de pensamiento humanos que los dioses de billones de dólares.

Beto
Iteran. Reflexionan. Esa lucha es la inteligencia.

Alicia
François Chollet, el creador de ARC, tuvo una frase en el informe que se me quedó:

    “Sabrás que la AGI está aquí cuando crear tareas que sean fáciles para los humanos comunes pero difíciles para la IA sea simplemente imposible”.

Beto
Ese es el final del juego. Mientras yo pueda pasar cinco minutos dibujando una cuadrícula que deje perplejo a una máquina de mil millones de dólares, aún estamos en la primera fase. Solo hemos construido una biblioteca gigantesca, no una mente.

Alicia
Y esto nos deja con una reflexión final provocadora. Hemos pasado una década obsesionados con el conteo de parámetros. Pensábamos que el camino a la AGI era construir un cerebro del tamaño de un planeta. Pero este informe sugiere que podríamos estar completamente equivocados.

Beto
Plantea la pregunta: ¿estamos construyendo cerebros de IA que son demasiado grandes para su propio bien?

Alicia
¿Estamos confundiendo el saberlo todo con ser inteligentes? Porque yo conozco a mucha gente que puede recitar trivialidades pero no sabe cambiar una rueda pinchada.

Beto
Todos hemos visto eso.

Alicia
Y tal vez nuestra IA sea el campeón supremo de la trivia, pero aún no puede encontrar sus llaves por la mañana.

Beto
Y hasta que pueda encontrar esas llaves en una casa nueva, que nunca ha visto antes, aún nos queda trabajo por hacer.

Alicia
Bueno, ARC-AGI-3 es la próxima batalla (se espera para el 2026, temprano). La estaremos observando muy de cerca cuando esos entornos interactivos estén activos.

Beto
No puedo esperar.

Alicia
Eso es todo para este análisis profundo. Gracias por escuchar, y nos vemos en el próximo.

lunes, 13 de octubre de 2025

Razonamiento Recursivo con Redes Diminutas


Hoy les traigo el resumen de un artículo científico reciente que resalta algo novedoso en arquitectura de Modelos de Razonamiento de Inteligencia Artificial. Los investigadores de Samsung han logrado diseñar un modelo pequeño que razona de manera profunda usando recursión y dos capas de redes neuronales jerárquicas.

Enlace al artículo original, en inglés:
"Less is More: Recursive Reasoning with Tiny Networks", publicado el 6 de Octubre de 2025, por Alexia Jolicoeur-Martineau, de Samsung Montreal.

En el resumen también incluimos algunos enlaces, para aquellos que quieran profundizar en el tema.

El resumen, la transcripción y traducción de este artículo fueron hechos usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Bueno, durante buena parte de la última década, la creencia central que ha impulsado la investigación en IA ha sido realmente la ley de escalado, ya sabes: dicho sencillamente, más grande es mejor.

Beto
Más parámetros, modelos más anchos.

Alicia
Exacto, pilas más profundas. Se supone que todo eso conduce a un mejor rendimiento, especialmente en esas tareas realmente difíciles de razonamiento de alto nivel.

Beto
Y esa ley ciertamente parece mantenerse en lo que es conocimiento general y fluidez del lenguaje, sin duda.

Pero hoy profundizamos en algunas fuentes que le lanzan una curva realmente fuerte a esa filosofía de “más es mejor”, un desafío poderoso y contraintuitivo.

Alicia
De verdad que lo hacen. Estamos hablando de un avance bastante importante centrado en esta nueva arquitectura llamada el Modelo de Recursión Diminuto o TRM (Tiny Recursion Model).

Beto
¿Preocupante, verdad?

Alicia
Y lo que sorprende es que este modelo diminuto no solo compite, sino que en realidad está superando a esos enormes LLMs e incluso a su propio predecesor más complejo en algunos rompecabezas serios de lógica y espacio.

Beto
Sí. Nuestra misión hoy es desentrañar toda esta idea de “menos es más”. Las fuentes que tenemos detallan cómo TRM logra, bueno, una generalización y una precisión superiores con una arquitectura ridículamente simplificada.

Alicia
“Ridículamente simplificada” es correcto.

Beto
En un conteo de parámetros que a menudo baja hasta, ¿qué?, siete millones; compáralo con los modelos de los que solemos hablar, cientos de miles de millones e incluso billones de parámetros. Es otro mundo.

Alicia
Y necesitamos con urgencia este tipo de eficiencia. Porque, enfrentémoslo, a pesar de sus increíbles habilidades de lenguaje, los LLMs luchan fundamentalmente con el razonamiento duro.

Beto
Lo hacen.

Alicia
Piénsalo: cuando un LLM genera una solución, digamos para un problema matemático complejo, lo hace auto-regresivamente, ¿verdad? Un token tras otro.

Beto
Sí, de forma secuencial. Y esa generación secuencial lo hace muy propenso a un efecto dominó: un pequeño error al principio, una vuelta equivocada, ...

Alicia
... y toda la solución de varios pasos se viene abajo.

Beto
Exacto. No pueden retroceder y corregirse con facilidad.

Alicia
Correcto. Y por eso el campo recurre a estos trucos costosos y a menudo complejos, cosas como la cadena de pensamiento (CoT, Chain of Thought).

Beto
Ajá. Donde el modelo se habla a sí mismo a través de los pasos esperando que sean correctos.

Alicia
O el cómputo en tiempo de prueba (Test-Time Compute, TTC), donde básicamente ejecutan el modelo una y otra vez y esperan que la respuesta más frecuente sea la correcta. Suena un poco a adivinanza.

Beto
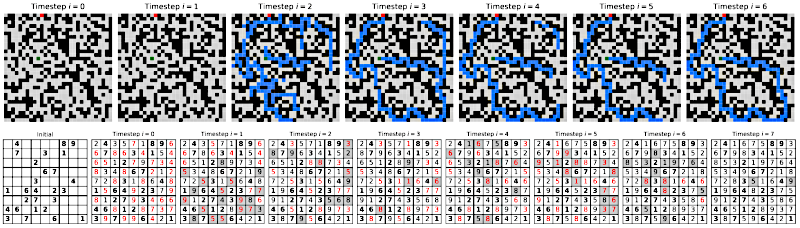
Es lento. Es caro. Y en los benchmarks realmente difíciles, estas soluciones todavía no bastan. Hablamos de conjuntos de rompecabezas como "Sudoku Extreme", y "Maze Hard".


Sudoku-Extreme es un dataset nuevo que consiste en 3.8 millones de problemas de Sudoku difíciles de resolver, que requieren planificación a largo plazo.

Y Maze-Hard es un laberinto de 30x30 cuadros donde el objetivo es encontrar el camino óptimo.

Ejemplos:

Fuente: Hierarchical Reasoning Model, Guan Wang y colegas, publicado en Agosto 4 de 2025.


Alicia
Y esos rompecabezas ARC-AGI de razonamiento abstracto realmente difíciles.


ARC-AGI-2 consiste en un dataset de tareas de entrenamiento y evaluación, que usa rejillas con puntos de colores, con reglas de razonamiento y composición, fáciles para resolver por un ser humano, que no se pueden memorizar.

Fuente: "ARC-AGI-2: A New Challenge for Frontier AI Reasoning Systems", por François Chollet y colegas, publicado en Mayo 17 de 2025.


Beto
Sí, son asesinos. Las fuentes son claras. Incluso los LLMs de primer nivel no han alcanzado la precisión humana ahí todavía. Ni cerca, a veces.

Alicia
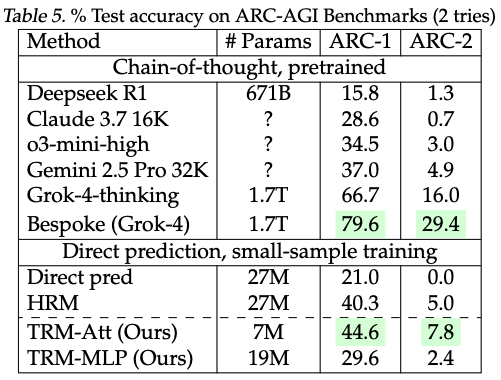
Solo para poner un número a esa tasa de fallo, las fuentes mencionaron a Gemini 2.5 Pro, un modelo supuestamente de última generación. Solo consiguió, ¿qué?, 4.9% de precisión en la prueba del nuevo benchmark ARC-AGI-2. Incluso usando mucho cómputo en tiempo de prueba.

Beto
4.9%.

Alicia
Eso es una tasa de fallo del 95%. Eso te dice todo lo que necesitas saber sobre por qué necesitamos un motor de razonamiento mejor y más fiable.

Beto
Precisamente.

Para entender cómo TRM logró esto, en realidad tenemos que mirar el modelo que vino justo antes: el Modelo de Razonamiento Jerárquico, o HRM (Hierarchical Reasoning Model). Este modelo fue en sí un gran avance, aunque seguía operando con un tamaño relativamente pequeño, 27 millones de parámetros en total.

Alicia
Todavía diminuto comparado con los gigantes de hoy, pero bueno.

Beto
HRM fue novedoso porque se centró en la profundidad mediante la recursión, no solo en la fuerza bruta.

Alicia
Exacto. Se apoyó en dos conceptos realmente clave. El primero fue la supervisión profunda.

Beto
Supervisión profunda. ¿Qué es eso?

Alicia
Esencialmente le da al modelo una especie de memoria perfecta y verificable de sus propios estados internos previos, sus propios “pensamientos”. En lugar de simplemente ejecutar hacia adelante una vez, el modelo reutiliza las características latentes, los datos internos del paso de procesamiento anterior, y los usa como punto de partida para el siguiente.

Beto
Ah, así que construye directamente sobre su trabajo anterior.

Alicia
Correcto. Le permite al modelo razonar recursivamente a lo largo de muchos pasos —probaron hasta 16— sin los enormes costos de memoria de construir físicamente una red de 16 capas.

Beto
Darle un bloc de notas interno que debe revisar antes de empezar el siguiente cálculo, ¿no?

Alicia
Es una gran analogía. Profundidad efectiva lograda recursivamente, no físicamente.

Beto
Tiene sentido. ¿Y el segundo concepto?

Alicia
El segundo fue el razonamiento jerárquico recursivo. Y aquí es donde HRM empezó a ponerse, bueno, un poco complicado.

Beto
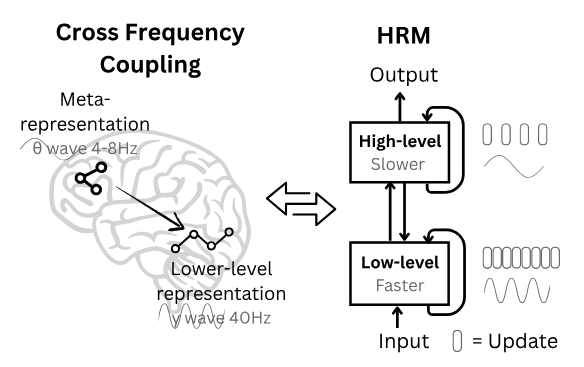
Usaba dos redes pequeñas separadas, de dos “niveles” o “bandas”. Estaban diseñadas para procesar información a diferentes “frecuencias conceptuales”, como una red de detalle de alta frecuencia y una red de contexto de baja frecuencia.

Alicia
Bien. ¿Dos redes? ¿Por qué?

Beto
Incluso fueron un paso más allá e intentaron justificar esta estructura con argumentos biológicos bastante complejos que sugerían que imitaba cómo los cerebros podrían manejar entradas sensoriales rápidas frente a una comprensión contextual más lenta.

Alicia
IA inspirada en la biología; ya hemos visto eso antes.

Pero espera, dijiste “complicado”. Entonces construyeron este sistema complejo de dos redes. ¿Cuál fue el problema? ¿Cuál fue el defecto?

Beto
El fallo estuvo realmente en la complejidad teórica y las suposiciones que tuvieron que hacer. Para lograr que esas dos redes funcionaran juntas de forma eficiente, HRM se apoyó fuertemente en matemáticas avanzadas, específicamente en algo llamado el teorema de la función implícita (Implicit Function Theorem, IFT).

Alicia
IFT. Vale. Vago recuerdo de cálculo, tal vez. ¿Qué asume aquí?

Beto
Básicamente asumía que este proceso recursivo paso tras paso eventualmente se estabilizaría, convergiendo a un punto fijo estable.

Alicia
¿Y por qué necesitaban esa suposición? ¿Qué les daba?

Beto
Porque si asumían que convergía, podían usar un atajo masivo durante el entrenamiento llamado la aproximación del gradiente de un paso (One-step Gradient Approximation).

Alicia
Un atajo. Vale.

Beto
Significaba que, cuando calculaban cómo actualizar el modelo, solo tenían que retropropagar la señal de error a través de los dos últimos pasos de la recursión en vez de quizá seis pasos totales en una pasada hacia adelante.

Alicia
Ah. Así que en lugar de calcular el error a través de los seis pasos, solo hacían los dos últimos, lo que ahorra muchísima memoria y cómputo, me imagino.

Beto
Una cantidad enorme.

Alicia
Pero dependía de que la suposición del punto fijo fuera cierta. Cambiaron el rigor teórico por ahorros prácticos, construyendo sobre una base potencialmente inestable.

Beto
Precisamente. Y las fuentes señalan que análisis independientes sugirieron que ese punto fijo rara vez, si es que alguna vez, se alcanzaba en la práctica.

Alicia
Oh. Así que toda la justificación teórica estaba tambaleante.

Beto
Muy tambaleante. Y, de forma algo irónica, estudios posteriores encontraron que la parte realmente complicada —la estructura recursiva inspirada biológicamente de dos frecuencias— ni siquiera era la razón principal de que funcionara bien.

Alicia
¿En serio?

Beto
Sí. El éxito vino casi enteramente del otro concepto: la supervisión profunda. Eso de la memoria autorreferencial que comentamos.

Alicia
Vaya. Así que toda esa complejidad extra —las dos redes, la justificación biológica— era básicamente lastre. Una lección enorme ahí.

Beto
Absolutamente. Pero la complejidad no se quedó solo en la teoría; también se filtró en el coste práctico de entrenamiento, ¿verdad?

Alicia
Lo hizo. HRM usó algo llamado tiempo computacional adaptativo (Adaptive Computational Time, ACT) para intentar ser más rápido.

Beto
ACT. Significa que el modelo podía aprender a detenerse temprano.

Alicia
Exacto. Aprendía a parar la recursión si pensaba que ya tenía la respuesta, típicamente gastando menos de dos pasos en promedio en lugar de ir los 16 pasos supervisados completos. Suena bien para la velocidad. Pero la forma en que implementaron ACT requirió un objetivo complejo de aprendizaje por refuerzo tipo Q-learning para decidir si detenerse o continuar.

Beto
Q-learning, ¿vale? Aprendizaje por refuerzo.

Alicia
Sí. Y ese cálculo de Q-learning necesitaba una pasada hacia adelante completamente separada por la red solo para averiguar el valor de "continuar o parar".

Beto
Espera, ¿dos pasadas hacia adelante por cada actualización de entrenamiento?

Alicia
Sí. Una pasada para la predicción real y una segunda pasada solo para la decisión de ACT. Efectivamente duplicaba el coste de cómputo por paso de optimización.

Beto
Duele! Así que HRM era teóricamente frágil y caro de entrenar. No ideal.

Alicia
Para nada.

Y esto prepara el terreno perfectamente para el Modelo de Recursión Diminuto, TRM. Porque TRM básicamente mira a HRM, ve esos fallos y consigue mejores resultados simplificando de forma implacable.

Beto
Aplicando la navaja de Occam.

Alicia
Totalmente. En vez de andarse con muletas teóricas y analogías biológicas, TRM es la prueba de que a veces la simplicidad es la jugada ganadora.

Beto
Entonces, ¿cuál fue la primera gran simplificación?

Alicia
La red neuronal misma. TRM elimina completamente las dos redes de cuatro capas de HRM y las reemplaza con una única red de dos capas.

Beto
¿Dos capas? Vaya, eso es una reducción radical.

Alicia
Lo es. Reduce el recuento de parámetros de los 27 millones de HRM hasta apenas 7 millones, o incluso 5 millones en algunas versiones.

Beto
Espera, menos capas. ¿No perjudicó el rendimiento? Es decir, eso va en contra de todo lo que oímos sobre las leyes de escalado, la necesidad de profundidad.

Alicia
Ese es el núcleo de la idea “menos es más” aquí, y es muy importante. Porque los conjuntos de datos para estos rompecabezas realmente difíciles, como Sudoku-Extreme, solo tienen 1.000 ejemplos de entrenamiento. Son minúsculos. Con conjuntos de datos tan pequeños, si intentas entrenar una red grande y profunda, el modelo simplemente se sobreajusta. Memoriza las respuestas en lugar de aprender las reglas subyacentes.

Beto
Ya veo. Demasiada capacidad para la cantidad de datos.

Alicia
Exacto. Al usar solo dos capas, TRM restringe esa capacidad lo suficiente para forzar la generalización. Dos capas resultaron ser el punto óptimo; con más, el rendimiento bajaba por sobreajuste.

Beto
Es un resultado de escalado fascinante. No se trata solo de profundidad, sino de profundidad efectiva mediante recursión, equilibrada con el ancho físico justo para no morir de inanición de datos. Increíble.

Alicia
Totalmente.

Bien. La simplificación número dos: limpiaron cómo se pensaba sobre las características internas, lo latente.

Beto
Se deshicieron del argot confuso.

Alicia
Básicamente. Eliminaron la complicada etiqueta jerárquica basada en frecuencias. ¿Recuerdas lo de alta y baja frecuencia?

Beto
Sí, lo de alta y baja frecuencia.

Alicia
En TRM, lo antiguo que era “answer” ahora es simplemente la respuesta predicha; lo llamaremos "y". Y lo antiguo que era “scratch” es simplemente la característica latente de razonamiento, el proceso interno de pensamiento; lo llamaremos "z". Así de simple.

Beto
Entonces "y" para la respuesta, "z" para el razonamiento. Mucho más claro.

Alicia
Y esta clarificación conduce directamente al momento “ajá” sobre por qué realmente necesitas dos características, pero probablemente no más.

Beto
Bueno. ¿Por qué dos?

Alicia
Porque "y" es como la hoja de respuestas, y "z" es como el bloc de notas donde sucede el trabajo.

Beto
Tiene sentido.

Alicia
Si quitas "z", el bloc de notas, el modelo no tiene memoria de cómo llegó a la respuesta; solo tiene la respuesta en bruto y se olvida de los pasos, cometiendo más errores.

Beto
Bien. Y si quitas la hoja de respuestas, ...

Alicia
... entonces el modelo se ve forzado a intentar meter la solución final dentro del bloc de notas — tiene que almacenar la respuesta dentro de los pasos de razonamiento — lo que también empeora la precisión.

Beto
Entiendo. Así que necesitas roles distintos: un sitio para mantener la solución y otro para mantener la cadena de pensamiento. Simple y elegante.

Alicia
Exacto.

Ahora, la simplificación número tres quizá sea el mayor cambio de juego de toda la historia. TRM elimina por completo esa endeble aproximación teórica del IFT, la aproximación de gradiente de un paso que mencionamos antes.

Beto
Ese atajo teórico. Lo tiran. Simplemente lo quitan.

Alicia
Evitan todo el problema del punto fijo al no asumirlo. En lugar de confiar en ese atajo teórico que quizá sea falso, TRM retropropaga el error a través de todo el proceso recursivo. Todos los 16 pasos fijos en la pasada hacia adelante. Sin aproximaciones. Simplemente calculan el gradiente completo.

Beto
Vaya! OK. Así que abrazan el cómputo en vez de esconderse detrás de una teoría potencialmente defectuosa sobre ese cómputo.

Alicia
Me gusta eso. Y la mejora en rendimiento solo por este cambio fue asombrosa. La fuente señala que en Sudoku-Extreme, simplemente descartando esa aproximación y usando retropropagación completa, su precisión en test subió de 56.5% —que estaba bien pero no era gran cosa— a un increíble 87.4%.

Beto
Whoa. De mediados de los cincuenta a casi el 90% solo calculando bien el gradiente.

Alicia
Sí. Ese único cambio desbloqueó ganancias masivas. Simplemente, haz las matemáticas correctamente.

Beto
Increíble.

Beto
Y la simplificación final es el coste de entrenamiento.

Alicia
Obviamente. Simplificaron ACT, el tiempo computacional adaptativo: se deshicieron del objetivo complejo de Q-learning.

Beto
Eso significa que eliminaron esa segunda pasada hacia adelante tan cara.

Alicia
Exacto. Ya no más duplicar el cómputo por paso. Encontraron que podían simplemente aprender una probabilidad de detenerse usando la entropía cruzada binaria estándar, mucho más sencilla y barata.

Beto
¿Y esa simplificación perjudicó el rendimiento? Normalmente lo simple significa menos capaz.

Alicia
Aquí no. Mostró una precisión casi idéntica: 86.1% frente al 87.4% con la retropropagación completa, mientras hacía el entrenamiento significativamente más rápido y barato.

Beto
Así se realiza la eficiencia sin pérdida de rendimiento, ese el sueño.

Alicia
Eso es realmente.

Bien, miremos la tarjeta final. ¿Qué consiguió esta combinación —simplificación implacable, foco en la supervisión profunda, recursión honesta y completa— en términos de resultados?

Beto
Las comparaciones son bastante contundentes, especialmente dado el tamaño relativo entre TRM y los grandes LLMs. Es casi embarazoso para la filosofía estándar de escalado.

Alicia
El benchmark más duro, ARC-AGI-2.

Cuéntanos sobre el resultado.

Beto
TRM con self-attention — y recuerda, esto tiene solo 7 millones de parámetros — consigue 7.8% de precisión. 7.8. Nosotros mencionamos que Gemini 2.5 Pro solo obtiene 4.9%.

Alicia
Mejor precisión con muchísimos menos parámetros. Muy por debajo en parámetros.

Beto
Con mucho menos. Y si comparas los 7 millones de parámetros de TRM con algo como, digamos, Grok-4-thinking, que supuestamente tiene 1.7 billones de parámetros, TRM opera con menos del 0.01% de los parámetros, menos de 1/110.000, y obtiene mejores resultados de razonamiento en ese benchmark.

Alicia
Eso es una locura. La eficiencia en parámetros está fuera de serie.

Beto
Completamente.

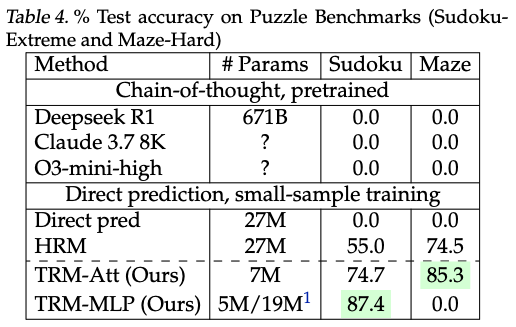
Y los resultados en los rompecabezas dedicados, Sudoku y Maze, son igual de dramáticos.

Alicia
Sí.

Beto
En Sudoku Extreme, la versión aún más pequeña de 5 millones de parámetros de TRM, la que no tiene self-attention, sube a ese 87.4% de precisión en test. Recuerda que HRM, el predecesor, estaba estancado en 55.0%.

Alicia
Un salto de "apenas aprobando", a "casi perfecto".

Beto
Y en Maze Hard, el TRM de 7 millones con atención consigue 85.3%, nuevamente muy por encima del HRM con 74.5%.

Alicia
Bien, esa diferencia es interesante. ¿Por qué atención para Maze pero no para Sudoku?

Beto
Eso conecta con la visión más amplia: la elección arquitectónica debe ajustarse al problema. La fuente destacó esto. La efectividad de TRM depende realmente de la estructura de la tarea.

Alicia
Así que la variante MLP más simple, sin self-attention, funciona mejor para contextos fijos y pequeños como una cuadrícula de Sudoku 9x9.

Beto
Exacto. Las relaciones entre celdas son bastante locales y predecibles. Pero para la gran complejidad y la naturaleza variable de las tareas ARC-AGI, o para cuadrículas más grandes como laberintos 30x30, ...

Alicia
... necesitas ese mecanismo de self-attention para que el modelo encuentre dinámicamente las dependencias a larga distancia importantes.

Beto
Precisamente. Muestra que puedes obtener resultados de vanguardia combinando estratégicamente componentes mínimos pero potentes — solo dos capas, una característica de memoria dedicada, quizá self-attention si hace falta — en vez de escalarlo todo sin discriminación.

Alicia
Bien, cerremos esto. ¿Qué significa todo esto para ti, el oyente?

Creo que la idea principal aquí es bastante profunda. El futuro del razonamiento fiable y de alto nivel en IA puede no estar en construir modelos cada vez más anchos con trillones más de parámetros. Podría estar en construir modelos recursivos más inteligentes que realmente adopten la profundidad efectiva.

Beto
Profundidad a través de la recursión, no solo capas.

Alicia
Exacto. Los elementos cruciales que TRM clavó parecen ser la supervisión profunda — esa memoria interna — y la recursión transparente y completa, calculando todo el proceso honestamente. Demuestra que una profundidad efectiva extrema, como las ~42 capas efectivas que consiguieron con solo dos capas físicas en TRM, puede ser mucho más potente que la mera amplitud masiva, especialmente cuando los datos de entrenamiento son limitados, que a menudo lo son para razonamiento complejo.

Beto
Lo cual plantea una gran pregunta sobre lo que viene después, ¿no?

Alicia
Sí que la plantea.

Beto
Ahora mismo, estos modelos de razonamiento recursivo, TRM y HRM, son métodos de aprendizaje supervisado, ¿cierto? Están entrenados para encontrar una única respuesta determinista.

Alicia
Encuentra la solución del Sudoku; encuentra el camino por el laberinto.

Beto
Correcto. Pero muchos problemas del mundo real, quizá la mayoría de los interesantes, no tienen una única respuesta correcta. Pueden tener múltiples soluciones válidas o requerir salidas abiertas y creativas, ...

Alicia
... como generar diferentes estrategias o escribir distintas explicaciones.

Beto
Exacto. El siguiente paso importante para los investigadores es averiguar cómo tomar esta arquitectura recursiva increíblemente eficiente y poderosa que TRM ha pionero y extenderla con éxito a tareas generativas.

¿Cómo lograr que ese razonamiento recursivo riguroso produzca salidas diversas, creativas, pero aún lógicamente sólidas? Esa parece ser la próxima frontera.