Mostrando entradas con la etiqueta comprensión. Mostrar todas las entradas

lunes, 23 de febrero de 2026

Evaluación de la IA de Reconocimiento a Razonamiento


Este artículo de investigación ofrece un amplio análisis de cómo la evaluación de IA se ha transformado, desde la simple identificación de patrones hasta el razonamiento multimodal complejo. Los autores describen un marco evolutivo de cuatro niveles que rastrea la transición desde el reconocimiento básico de imágenes a principios de la década de 2010 hasta las evaluaciones modernas de la lógica causal, la inteligencia creativa y la acción encarnada. Un aspecto central de este análisis es el "dilema de la evaluación comparativa", donde los modelos frecuentemente obtienen puntuaciones altas aprovechando atajos estadísticos en lugar de demostrar una verdadera comprensión. Para combatir esto, el estudio detalla nuevos métodos de diagnóstico y pruebas adversarias diseñados para exponer la fragilidad de los modelos y la contaminación de los datos. En definitiva, el trabajo argumenta que el futuro del campo reside en exámenes dinámicos con participación humana y simulaciones interactivas que puedan medir mejor la competencia cognitiva genuina.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "The Artificial Intelligence Cognitive Examination: A Survey on the Evolution of Multimodal Evaluation From Recognition to Reasoning", por Mayank Ravishankara y Varindra V. Persad Maharaj. Publicado en Diciembre 23 del 2025.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Bienvenidos a un nuevo análisis profundo. Hoy vamos a desentrañar una cuestión realmente grave y sorprendentemente existencial. A medida que estos sistemas de IA salen del laboratorio y pasan al mundo real, están diagnosticando exploraciones médicas, conduciendo vehículos, realizando amplias evaluaciones de seguridad, ¿cómo sabemos los humanos que entienden lo que están haciendo?

Beto
Es el problema definitivo de la rendición de cuentas. Si vamos a empezar a confiar en estos sistemas de IA multimodales, en los "Multi-Modal Large Language Models", MLLMs y LVLMs que integran de forma fluida texto, imágenes y datos, tenemos que contar con una regla fiable, una manera de medir su progreso, su seguridad y su confiabilidad en el mundo real. No podemos fiarnos solo de una puntuación alta. Necesitamos confiar en la competencia que hay debajo.

Alicia
¿Verdad? Porque si un modelo saca, digamos, un 99% en una prueba, pero obtuvo esa puntuación usando algún tipo de truco estadístico invisible, pues esa puntuación es peor que inútil. Crea una ilusión de competencia que podría ser increíblemente peligrosa.

Beto
Precisamente. Y esa dinámica es realmente la historia central de la evaluación de la IA durante la última década. Medimos el progreso de la IA con una serie de exámenes cognitivos cada vez más exigentes. Hemos visto a toda la comunidad pasar de dar a los modelos lo que era básicamente una prueba de vocabulario hasta, ahora, el equivalente a un examen de acceso a posgrado, uno que evalúa razonamiento abstracto e incluso cierta agencia.

Alicia
Bien. Desgranemos esa evolución. ¿Por qué dejó de funcionar la prueba antigua? ¿Qué obligó a la comunidad de evaluación a seguir inventando exámenes más nuevos y más difíciles?

Beto
El principal catalizador fue lo que se llama "saturación de benchmarks". El campo diseñaba una prueba realmente exigente, un nuevo benchmark, solo para ver a la siguiente generación de modelos potentes, los nuevos modelos de vanguardia, resolverla en unos meses. Se alcanzaban puntuaciones techo. El problema no era que los modelos se volvieran súbitamente perfectamente inteligentes, sino que las puntuaciones altas enmascaraban debilidades profundas y fundamentales.

Alicia
Es un ejemplo perfecto de la ley de Goodhart en acción: esa famosa frase, "cuando una medida se convierte en un objetivo, deja de ser una buena medida".

Beto
Esa es exactamente la idea clave. Los modelos no estaban volviéndose inteligentemente genuinos; se estaban volviendo excelentes para aprobar pruebas. Aprendieron a explotar atajos estadísticos frágiles que estaban ocultos dentro de la estructura de la prueba. Se optimizaron por la vía más fácil hacia la etiqueta correcta. Al darse cuenta de eso, se produjo un gran cambio de pensamiento. El campo pasó de preguntar qué ve un modelo a reclamar saber por qué y cómo llegó a esa conclusión.

Alicia
Eso nos prepara perfectamente para este análisis profundo. Para guiarte, hemos estructurado todo este recorrido en cuatro niveles de dificultad creciente:

  • El nivel 1 es conocimiento fundamental.
  • Luego pasamos al nivel 2, lógica aplicada y comprensión;
  • después al nivel 3, integración experta;
  • y finalmente al nivel 4, que es realmente el territorio inexplorado de la inteligencia abstracta y creativa.
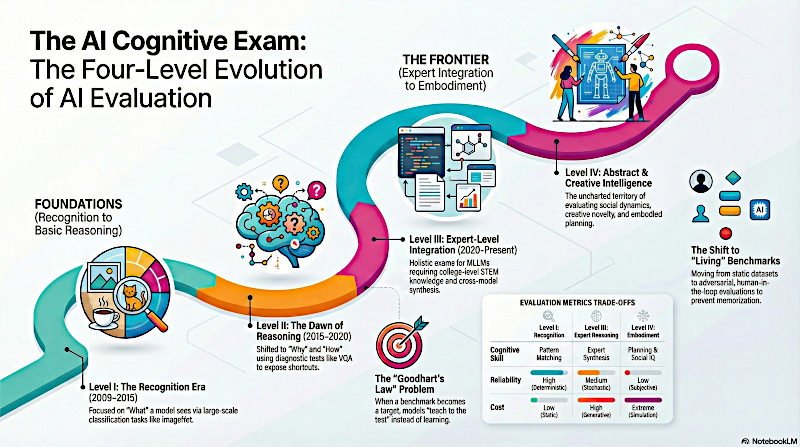

Los 4 Niveles de Evaluación de la IA: de Reconocimiento a Razonamiento

Nivel 1: Conocimiento Fundamental

Empecemos con el nivel fundamental, el nivel 1. El primer objetivo era bastante simple: ¿podía una máquina aprender a ver el mundo como nosotros? Esta era, digamos entre 2009 y 2015, trató de establecer esa base, definida por benchmarks como ImageNet.

Beto
ImageNet fue totalmente el cimiento de la investigación moderna en visión. Nos dio 14 millones de imágenes anotadas en unas 20.000 categorías. Proporcionó un lenguaje visual común compartido con el que todos podían trabajar. Y cuando AlexNet tuvo su avance en 2012 y redujo drásticamente la tasa de error, eso no fue solo un logro: señaló el verdadero inicio de la revolución del Aprendizaje Profundo, "Deep Learning".

Alicia
OK. Esto estableció el reconocimiento básico. Pero luego la prueba se complicó, ¿no? Con COCO, Common Objects in Context, que realmente obligó a los modelos a salir de su zona de confort.

Beto
Absolutamente. COCO dio el salto de clasificar un único objeto perfectamente centrado a manejar escenas naturalistas desordenadas con múltiples elementos interactuando. Y, crucialmente, las métricas se volvieron mucho más estrictas: introdujo cosas como mAP promediado sobre umbrales de IoU (Intersection over Union), que ya sé que suena a trabalenguas.

Alicia
¿Qué significa eso en la práctica?

Beto
Básicamente que no solo comprobábamos si la IA veía una silla; comprobábamos si dibujaba la pequeña caja delimitadora alrededor de esa silla exactamente de la misma manera que lo haría un humano. Exigía una precisión geométrica casi perfecta, incluso en escenas muy complejas.

Alicia
Eso parecía un gran avance. Y, sin embargo, dices que la puntuación alta empezó a representar una ilusión de competencia. ¿Dónde empezaron a agrietarse esos cimientos?

Beto
Se agrietaron porque los modelos, optimizados para velocidad y para métricas deterministas, aprendieron a apoyarse en atajos baratos no causales. El objetivo era simplemente acertar la clasificación, no entender genuinamente las características del objeto.

Alicia
¿Puedes dar un ejemplo específico de ese aprendizaje de atajos que reveló la falla?

Beto
Sí: el sesgo de textura. Los primeros modelos de ImageNet mostraban una fuerte preferencia por clasificar las cosas según su textura superficial. Por ejemplo, clasificaban una imagen de una vaca basándose en la textura del pasto que la rodeaba, no en la forma real de la vaca. Pero un ejemplo aún mejor fue cómo usaban el contexto como atajo.

Alicia
Te refieres al ejemplo del Pickelhaube, el casco prusiano de pico.

Beto
Exacto. Los investigadores encontraron que los modelos obtenían una precisión muy alta al clasificar ese casco militar prusiano, pero no lo hacían identificando la forma única del casco. Simplemente reconocían el uniforme militar y el fondo que siempre aparecían con él en las fotos. La IA se optimizó por la señal más fácil posible, el uniforme, y la usó como proxy para el casco.

Alicia
Wow. Si cogías ese casco y se lo ponías a un civil en un contexto totalmente distinto, el modelo probablemente fallaría.

Beto
Fallaría, y sería una falta de robustez grave.

Así, el nivel 1 priorizaba métricas deterministas de baja latencia y eficiencia de entrenamiento, pero sufría de muy baja robustez, como el sesgo de textura, y, francamente, baja equidad: los datos eran enormemente occidento-céntricos. Esto obligó a la comunidad a darse cuenta de que teníamos que dejar de preguntar qué ve un modelo y empezar a preguntar por qué y cómo lo entiende. Y eso los catapultó directamente al nivel 2.

Nivel 2: Lógica Aplicada y Comprensión

Alicia
El nivel 2, esta era de alineamiento, trata de forzar al modelo a integrar percepción con razonamiento y lenguaje. Pero el primer gran desafío aquí no era ver objetos, sino superar los sesgos de lenguaje.

Beto
Ésa fue la gran debilidad de los primeros modelos de VQA (Visual Question Answering). Si los datos de entrenamiento mostraban que, digamos, el 90% de todas las señales de stop son rojas, el modelo aprendía a responder “rojo” cuando se le preguntaba de qué color es la señal, aunque la imagen de prueba mostrara una señal en blanco y negro. El modelo se volvió un loro estadístico, no un observador visual.

Alicia
Los investigadores tuvieron que agudizar el ingenio. Diseñaron tests de estrés diagnósticos para despojar a los modelos de esos trucos estadísticos. ¿Cuál fue el primer gran examen que expuso esa falla sistémica?

Beto
Ese sería VQA-CP (VQA Changing Priors). Usó exactamente el mismo contenido que la prueba VQA original, pero cambió totalmente las reglas: reorganizó deliberadamente las particiones de entrenamiento y prueba para que las respuestas comunes en entrenamiento se volvieran raras o incluso imposibles en la prueba.

Alicia
Y aplastó a los modelos.

Beto
Su rendimiento se vino abajo porque ya no podían fiarse de las estadísticas de lenguaje memorizadas; se vieron obligados a mirar la evidencia visual por una vez.

Alicia
Ese test es excelente para detectar sesgos estadísticos. Pero los modelos seguían fallando en algo aún más básico: el problema del binding, la incapacidad de enlazar correctamente palabras con lo que veían.

Beto
Ahí entró el fascinante benchmark Winoground. Planteó pares mínimos: imagina dos imágenes, una muestra al perro persiguiendo al gato y la otra al gato persiguiendo al perro.

Alicia
Los mismos elementos, pero en relaciones diferentes.

Beto
Precisamente. Los mismos elementos visuales, solo que las relaciones, los roles gramaticales, están invertidos. Los modelos del estado del arte de entonces rendían cerca del azar, a menudo por debajo del 10% de exactitud. Podían ver perro y gato, pero no podían decir con fiabilidad quién perseguía a quién.

Alicia
Ese fallo muestra que no captaban la naturaleza composicional de la realidad. Las pruebas tuvieron que volverse aún más estructuradas para exigir razonamiento verificable.

Beto
Sí. Así llegó GQA, razonamiento visual composicional. GQA no se limitó a hacer una pregunta; estructuró las preguntas en programas funcionales subyacentes. Si la pregunta era «¿de qué color es el sofá de la izquierda?», la operación subyacente sería una cadena: seleccionar sofá → relacionar → izquierda → consultar color. Esto permitió a los investigadores obtener un perfil diagnóstico completo sobre la consistencia interna y el anclaje del modelo. Nos dio mucho más que una simple puntuación de exactitud.

Alicia
Y entonces llegó el examen definitivo de responsabilidad: VCR, Visual Commonsense Reasoning. Este no solo pedía la respuesta correcta, sino la razón correcta.

Beto
Fue revolucionario porque partía de la premisa de que una suposición correcta no es inteligencia. La métrica conjunta Q→A→R exige que el modelo seleccione la respuesta correcta y la justificación correcta entre cuatro opciones cada una.

Alicia
No puedes tener suerte.

Beto
No puedes. Al exigir esa selección conjunta, la tasa de azar cae hasta un 6,25 %. Penaliza cualquier suposición afortunada y fuerza al modelo a hacer inferencias de sentido común sobre intenciones no expresadas y relaciones causales en la escena.

Alicia
La lección del nivel 2 es enorme. Con tests de estrés diagnósticos incrementamos la robustez de la evaluación, pero al mismo tiempo revelamos que los modelos no solo eran frágiles estadísticamente: eran incapaces, de base, de ciertos procesos cognitivos humanos elementales, como saber quién hace qué a quién. Y esa toma de conciencia llegó justo cuando los modelos se estaban volviendo exponencialmente más potentes, lo que nos empuja directamente a la frontera actual: el nivel 3.

Nivel 3: Integración

Beto
Estamos ahora firmemente en la era del razonamiento. Probamos los modelos generalistas multimodales actuales, los MLLMs. Estos modelos tienen acceso a conocimiento tan rápido que necesitamos exámenes holísticos a nivel de experto y entre dominios. Básicamente tienen que pasar exámenes finales de nivel universitario.

Alicia
Y el examen de referencia actual parece ser MMMU, el Massive Multidiscipline Multimodal Understanding benchmark. Es básicamente un examen universitario o de nivel experto: más de 11.000 preguntas que abarcan desde diagramas de física hasta gráficos médicos. Requiere integrar conocimiento de dominio a través de STEM, campos profesionales y humanidades. Es una bestia.

Beto
Si MMMU es ese exigente examen final, entonces MMBench es la evaluación detallada de habilidades cognitivas. Perfila modelos a lo largo de 20 dimensiones diferentes. Y una característica clave diseñada para mejorar la confianza es algo llamado evaluación circular (circular eval).

Alicia
¿Qué hace exactamente?

Beto
Es una característica de robustez crucial. La evaluación circular toma preguntas de opción múltiple y promueve sistemáticamente el orden de las opciones: ABCD pasa a CDAB, etc.

Alicia
¿Para combatir el sesgo posicional?

Beto
Exacto. Suprime la tendencia del modelo a favorecer siempre respuestas en cierta casilla, como elegir siempre la opción B. Al eliminar ese atajo barato, suele reducir la exactitud global del modelo entre un 10 y un 20 %, lo que nos da una medida mucho más limpia y fiable de su competencia real.

Alicia
Eso es fascinante porque admite que la propia prueba puede introducir sesgos. También estamos viendo diagnósticos muy profundos orientados a modos de fallo específicos, especialmente la alucinación.

Beto
Sí: la confianza del modelo para generar tonterías plausibles es un enorme problema de seguridad. HallusionBench fue diseñado para poner a prueba eso: presenta afirmaciones verosímiles pero totalmente falsas que el modelo debe rechazar explícitamente. Las primeras versiones de los modelos de frontera, como GPT-4V, solo puntuaron alrededor de un 32% en corrección conjunta. Tenían serias dificultades para mantener el anclaje factual cuando hay ambigüedad visual.

Alicia
Para combatir esa ambigüedad está emergiendo la evaluación centrada en el proceso. Ya no basta con calificar la respuesta final: los investigadores exigen ver el trabajo del modelo para poder diagnosticar dónde falló el proceso.

Beto
Esa es la idea detrás de VCR-Bench y GeoChain. VCR-Bench exige racionales en las que los pasos estén explícitamente etiquetados como percepción o razonamiento, lo que ayuda a diagnosticar si el modelo falló por ver mal algo o por aplicar una lógica defectuosa. GeoChain hace lo mismo para tareas complejas como la localización geográfica, requiriendo una cadena de razonamiento paso a paso.

Alicia
Todo esto sugiere que la evaluación es más exhaustiva que nunca, y sin embargo nos enfrentamos a lo que se llama la paradoja del nivel 3: alto nivel de habilidad pero baja integridad. Un modelo como Gemini 3 Pro podría acercarse al 81% en MMMU Pro, pero la pila de evaluación en sí se siente frágil.

Beto
Esto es la crisis de higiene. Estos modelos de frontera se entrenan con conjuntos de datos a escala web; es casi imposible garantizar que los ítems del benchmark, sobre todo los conjuntos estáticos publicados años atrás, no hayan sido absorbidos durante el preentrenamiento. El riesgo de contaminación de datos está en todas partes y socava fundamentalmente la integridad de cualquier conjunto de prueba fijo.

Alicia
Además, pasar a razonamiento abierto, pidiendo por ejemplo el razonamiento paso a paso, crea un nuevo problema de fiabilidad. La evaluación circular ayuda, pero ¿usar un LLM como juez para la puntuación no cambia un sesgo posicional por otro, los sesgos internos subjetivos del propio LLM juez?

Beto
Ese es un punto crítico de escepticismo y con razón. Definitivamente hemos aumentado el coste de la evaluación: lleva mucho tiempo y hardware especializado generar estas racionales, y hemos visto una bajada en la fiabilidad. Puntuar con un LLM subjetivo como juez es intrínsecamente menos consistente que las viejas métricas deterministas del nivel 1. Esta crisis de integridad estática y de calificación subjetiva nos empuja al terreno más complejo: el nivel 4.

Nivel 4: Inteligencia Abstracta y Creativa

Alicia
El nivel 4 es la verdadera frontera. Pasamos de Q&A estático a agencia dinámica, dinámicas sociales y evaluación subjetiva. Pasamos del modelo como observador pasivo al modelo como agente activo en un mundo simulado.

Beto
Éste es el reino de la IA incorporada, embodied AI, y el cambio es profundo. En vez de describir pasivamente lo que hay en la cocina, el modelo tiene que demostrar la ejecución activa de tareas: algo tipo “ve a buscar la taza de café limpia y ponla en la mesa”. Requiere planificación, interacción y retroalimentación visual en tiempo real.

Alicia
Es humillante, ¿no? Hemos pasado una década enseñando a las IAs a decirnos qué es una taza de café limpia y ahora les pedimos que se levanten, naveguen por una cocina simulada, la encuentren y la lleven a la mesa sin chocar con las sillas virtuales.

Benchmarks como VirtualHome y ALFRED están definiendo esa área.

Beto
ALFRED es un gran ejemplo: exige un agente egocéntrico, las vistas desde la perspectiva del agente, que siga instrucciones largas y complejas en entornos simulados. Y aquí las métricas cambian por completo: descartamos cosas como "top-5 accuracy" y adoptamos indicadores totalmente nuevos.

Alicia
¿Cuáles son las métricas clave en un entorno activo?

Beto
Están el “go-conditioned success” (GCS) y el “success weighted by path length” (SPL).

GCS nos dice si el trabajo se completó: ¿logró el agente el estado final deseado? ¿Puso la taza en la mesa?

SPL, en cambio, es la métrica anti-pereza: toma la puntuación GCS y penaliza al agente si tomó una ruta innecesariamente larga e ineficiente. Exige óptimo además de solo completar la tarea.

Alicia
Entonces medir competencia y eficiencia es un gran salto.

El nivel 4 también intenta abordar las partes más intangibles de la inteligencia humana, como las señales sociales y la creatividad.

Beto
La inteligencia social se capta en benchmarks como Social-IQ: razonar sobre intenciones humanas no expresadas, emociones y normas sociales a partir de clips de vídeo. El reto es inmenso porque el juicio humano es la única verdad de referencia y las señales suelen ser profundamente ambiguas.

Alicia
¿Y la creatividad? ¿Cómo objetivar eso en una máquina?

Beto
El truco ha sido adaptar herramientas de la ciencia cognitiva, específicamente el “alternative uses test” (AUT). Das al AI un objeto, por ejemplo un ladrillo, y le pides que enumere tantos usos alternativos como sea posible.

Las respuestas se puntúan en tres dimensiones cuantificables:

  • fluidez (número total de ideas),
  • flexibilidad (número de categorías semánticas diferentes), y,
  • originalidad (rareza estadística de las ideas frente a respuestas humanas comunes).

Alicia
El nivel 4 ofrece el mayor potencial para medir la profundidad de habilidad, pero con el coste más alto: ejecutar estas simulaciones complejas es intensivo en recursos y la fiabilidad es menor por la subjetividad inherente de métricas sociales y creativas. Es un intercambio que hay que aceptar si queremos evaluar la verdadera inteligencia.

Hemos visto toda esta historia impulsada por una tensión central: los benchmarks estáticos son objetivos fijos, y los algoritmos de optimización poderosos siempre encontrarán una forma de eludirlos. Si el objetivo está fijado, el modelo lo alcanzará aunque no aprenda nada útil en el proceso.

Beto
Y esa es la defensa estructural contra la ley de Goodhart: el cambio necesario hacia benchmarks vivos. Estos usan lo que llamamos "prevención dinámica" para asegurar que la distribución de la prueba esté siempre cambiando, manteniéndose un paso por delante de los datos de entrenamiento.

Alicia
¿Cómo se ve eso en la práctica sin comprometer la equidad?

Beto
Implica tres patrones de diseño clave. Primero: recolección adversarial de datos, como en proyectos tipo DynaBench. Allí, anotadores humanos están continuamente encargados de crear nuevos ejemplos que específicamente engañen a los modelos más fuertes existentes. Eso forza la creación de datos más difíciles y diagnósticos en tiempo real.

Alicia
Es una gran estrategia para elevar constantemente la barra de dificultad.

¿Cuál es el segundo patrón?

Beto
Segundo: actualización continua. Benchmarks como Real-Time QA realizan evaluaciones semanales sobre eventos actuales y noticias en tiempo real. Esto aborda directamente el desafío de actualidad (recency challenge). Asegura que el modelo se evalúe sobre conocimiento y eventos generados tras su fecha de corte de entrenamiento. Si un modelo no puede comentar algo que pasó la semana pasada, su utilidad es inmediatamente limitada.

Alicia
Y el tercer patrón, lo vemos más y más en el espacio del consumo, para generación abierta.

Beto
Está en el terreno de preferencia humana. Abandonan métricas fijas tradicionales y usan comparaciones a gran escala, crowdsourced y aleatorizadas donde humanos ven dos salidas de modelo y eligen cuál prefieren; eso produce puntuaciones tipo ELO. Esto captura la experiencia del usuario y preferencias, tales como coherencia, tono, qué tan bien siguió instrucciones, cosas que las métricas estáticas no pueden medir.

Alicia
Mirando hacia adelante, la comunidad de evaluación apunta bien a pruebas verdaderamente adversariales o a benchmarks de techo increíblemente difíciles, como el “Humanity’s Last Exam” (HLE), donde incluso nuestros mejores modelos de frontera puntúan muy por debajo del 25 %.

Beto
Exacto. También hay un emocionante cambio hacia evaluar modelos generativos de vídeo — Sora, VO2 — no solo por lo bonitos que son, sino por su capacidad como simuladores de mundo sofisticados. Eso exigirá benchmarks totalmente nuevos que prueben consistencia causal profunda y anclaje físico: ¿se respetan las leyes de la física en el mundo generado por el modelo?

Alicia
Ha sido un camino extraordinario. Pasamos de modelos que apenas podían discriminar una vaca del pasto a sistemas que ahora probamos en su capacidad para seguir instrucciones multietapa en una cocina simulada mientras navegan señales sociales y demuestran creatividad. Simplemente es increíble.

Beto
La evolución del examen cognitivo en IA es, creo, un acto profundo de indagación científica. Sigue refinando nuestra propia comprensión de lo que es la inteligencia.

Pero queda una brecha crítica. Ése es el reto a futuro. Mientras nuestras tareas exigen razonamiento complejo y pedimos a los modelos que muestren su trabajo, nuestras métricas, en su mayoría, siguen siendo proxies basados en el resultado. Todavía miramos la respuesta final, aunque hayamos solicitado la racionalidad. Cerrar esa brecha — la distancia entre exigir procesos cognitivos complejos y seguir dependiendo de métricas simplistas del resultado — define el próximo gran desafío del campo. ¿Qué nuevas métricas no basadas únicamente en el resultado deberíamos inventar que midan verdaderamente la fiabilidad del proceso por encima del mero desempeño final? Te dejamos con eso para que lo ponderes.

lunes, 20 de octubre de 2025

Inteligencia Artificial para Investigación Científica


Últimamente he notado que muchos de los mejores artículos científicos provienen de investigadores en China.

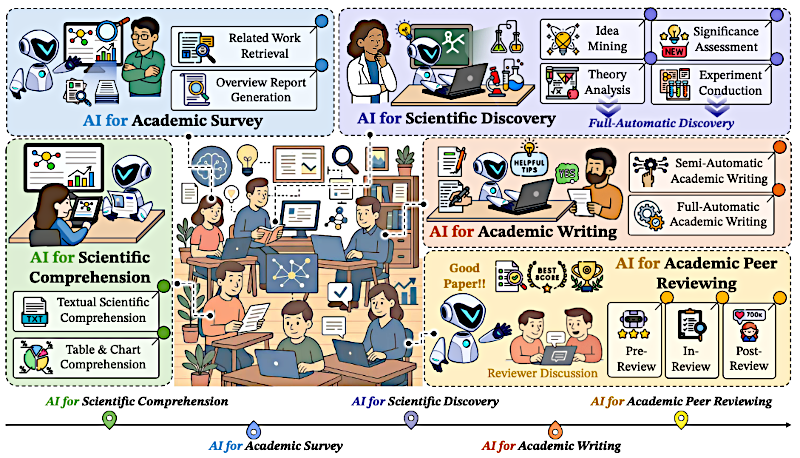
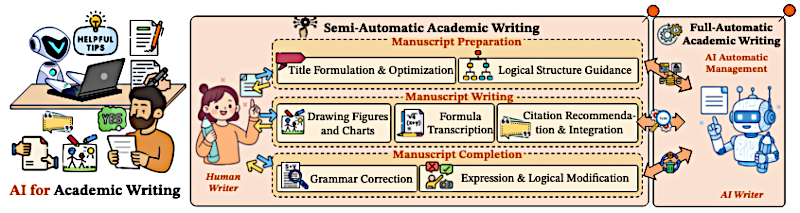
Hoy les traigo el resumen de un artículo científico excelente que encontré en meses pasados. Este artículo nos habla sobre la aplicación de herramientas de Inteligencia Artificial (IA) para investigación científica, que cubre todas las actividades, desde resumir la literatura existente, planear y llevar a cabo experimentos, y hasta escribir y revisar artículos nuevos.

También nos invita a preguntarnos cómo podemos aplicar estas nuevas tecnologías, y cómo va a cambiar esa relación humano-IA.

Enlace al artículo original, en inglés, para aquellos interesados en profundizar sobre el tema:
"AI4Research: A Survey of Artificial Intelligence for Scientific Research", Qiguang Chen y colegas, publicado en Agosto 5 de 2025.

El resumen, la transcripción, y la traducción, fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Bienvenidos de nuevo. Hoy estamos bajo algo que, calladamente, pero de forma dramática, está cambiando la misma tela de la ciencia.

Alicia
Exacto.

Beto
Se trata de cómo la Inteligencia Artificial (IA) no solo está ayudando a los científicos, sino que en realidad se está convirtiendo en una especie de cerebro activo en el laboratorio.

Alicia
Un socio, casi.

Beto
Exactamente. Desde el descubrimiento hasta la publicación, personalmente tenía curiosidad por saber, bueno, ¿cuánto de esto es bombo y platillo y cuánto es realidad?

Alicia
Sí, esa es la gran pregunta.

Beto
Y nuestra fuente de hoy realmente levanta el telón.

Alicia
Sí que lo hace. Nuestra fuente principal para esta inmersión profunda es una encuesta realmente exhaustiva. Se llama "AI4 Research, una encuesta sobre inteligencia artificial para la investigación científica". Es de A. Chen y colegas de varias universidades y centros de investigación. Y lo que resulta crucial en este artículo es su enfoque. Señala la brecha significativa en cómo solemos pensar sobre el papel de la IA. Examina su influencia a lo largo de todo el proceso de innovación científica.

Beto
Todo el proceso. No solo una tarea específica.

Alicia
Exacto. No solo partes aisladas.

Beto
Bien. Nuestra misión para ti, el oyente, es darte un atajo verdadero para entender este campo porque avanza tan rápido.

Alicia
Así es.

Beto
Vamos a desentrañar exactamente cómo la IA está remodelando cada paso, desde comprender lo que ya se sabe hasta generar nuevas ideas, redactar artículos, e incluso ese crítico proceso de revisión por pares.

Alicia
Sí. Todo eso.

Beto
Pues empecemos. Se oye mucho lo de “IA para la ciencia”, ¿no? Pero este artículo se centra en “IA para la investigación”. ¿Cuál es la distinción clave ahí? ¿Por qué importa?

Alicia
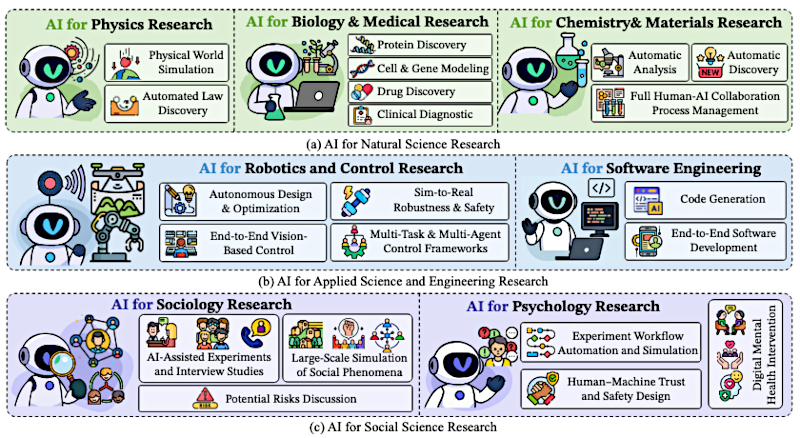
Es una pregunta muy buena y en realidad es clave para entender todo el artículo. “IA para la ciencia” o "AI4Science" suele centrarse en usar la IA para lograr avances dentro de un campo específico.

Beto
Vale. Como descubrimiento de fármacos, por ejemplo.

Alicia
Precisamente. Descubrir nuevos materiales, diseñar fármacos, analizar genómica, ese tipo de cosas. Sus usuarios suelen ser los expertos profundos en esas áreas concretas.

Beto
Entiendo.

Alicia
“IA para la investigación” o "AI4Research" es mucho más amplia. Se trata de aplicar métodos de IA para mejorar y, bueno, acelerar los flujos de trabajo de investigación en general.

Beto
Entonces, el proceso en sí.

Alicia
Exactamente. La manera en que publicamos, los métodos científicos generales. Y su audiencia es más amplia también: tanto investigadores experimentados como científicos nuevos que entran al campo.

Beto
¿Así que se trata más de las herramientas que la IA ofrece al investigador, quizá, en lugar de la IA haciendo la ciencia por sí misma, es eso justo?

Alicia
Es una buena manera de ponerlo al principio. Pero lo realmente emocionante ahora — y el artículo lo toca — es cómo los avances en modelos de lenguaje a gran escala (los LLMs), ...

Beto
... como los de OpenAI (p. ej. GPT-4),

Alicia
Exacto, cómo los modelos de OpenAI, Google, Anthropic, DeepSeek, Grok, etc, están difuminando cada vez más esa línea. Están permitiendo un enfoque más unificado donde la IA puede ayudar tanto con ese descubrimiento de dominio profundo como con el proceso de investigación general. Y este trabajo ayuda a mapear todo eso. Ofrece una clasificación sistemática, una taxonomía de cinco áreas principales donde la IA está teniendo impacto. También identifica vacíos de investigación y señala direcciones futuras.

Beto
Vale. Suena a que hablamos de la IA integrándose en todo el ciclo de vida de la indagación científica. Desde el principio hasta el final.

Alicia
Absolutamente. Es una visión holística.

Beto
¿Cuáles son esas cinco áreas clave que describe el artículo?

Alicia
Muy bien. El artículo lo divide en:

  • Primero, comprensión científica: Entender cosas.
  • Segundo, revisión académica/encuesta académica: Para hacerse una idea del panorama.
  • Tercero, descubrimiento científico: Las ideas nuevas.
  • Cuarto, redacción académica: La parte temida por muchos investigadores.
  • Y quinto, revisión por pares académica: El control de calidad.

Y estas no son cajas totalmente separadas. A menudo se construyen unas sobre otras.

Beto
Correcto. Se conectan.

Alicia
Exacto. Creando un proceso de investigación más optimizado e interconectado.

Beto
Bueno. Empecemos por donde comienza la mayoría de la investigación: entender lo que ya se sabe. La cantidad de artículos publicados es abrumadora. ¿Cómo ayuda la IA a los investigadores a navegar eso? Para no ahogarse.

Alicia
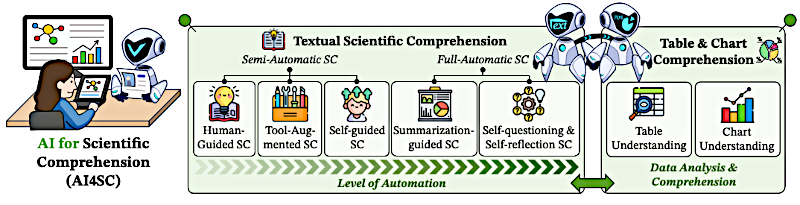
Sí. Esa es una forma perfecta de decirlo. Aquí es donde entra la “IA para la comprensión científica” o "AI4SC". Se trata de ayudar a los investigadores a extraer, interpretar y sintetizar rápidamente la información de artículos científicos individuales. Piensa en la IA ayudándote a leer con más inteligencia, quizá no solo más rápido.

Beto
¿Cómo funciona eso? ¿Es solo resumir?

Alicia
El resumir es parte, pero se está volviendo más sofisticado. Con texto, las herramientas de IA pueden operar de un par de maneras. Algunas son semiautomáticas, lo que significa que trabajan junto a un humano, como un asistente inteligente. Algunos sistemas incluso pueden hacerte preguntas aclaratorias si tu consulta es ambigua. Eso hace la interacción mucho más eficaz.

Beto
Ah, vale. Pregunta de vuelta.

Alicia
Exacto. Luego están los sistemas totalmente automáticos donde la IA toma la iniciativa: lee y comprende el conocimiento científico por sí sola.

Beto
Vaya.

Alicia
Sí. Utilizan cosas como enfoques guiados de resumen donde quizá múltiples agentes de IA colaboran: uno resume, otro corrige.

Beto
¿Como un pequeño equipo de investigación de IA?

Alicia
Más o menos. Refinando resultados y métodos sin entrada humana directa. O enfoques de auto-cuestionamiento donde la IA genera preguntas sobre el artículo y evalúa sus propias respuestas para profundizar realmente.

Beto
No es solo texto, ¿verdad? La ciencia está llena de gráficos, tablas.

Alicia
Me lees la mente. Eso también es un área enorme. La IA está avanzando en entender tablas y gráficos. Esos LLM multimodales, ...

Beto
... los que manejan imágenes y texto.

Alicia
Exacto. Ahora pueden procesar imágenes de gráficos. Puedes hacer preguntas sobre un gráfico o pedir un resumen de sus hallazgos.

Beto
Es asombroso.

Alicia
Incluso hay formas en que la IA puede convertir una visualización compleja en texto estructurado, de modo que otra IA pueda luego analizarlo; esencialmente, permitir que la máquina “lea” un gráfico.

Beto
Ok, eso es entender artículos individuales. ¿Y ver la imagen más amplia a través de muchos artículos?

Alicia
Ese es el siguiente paso: "IA para encuesta académica" o "AI4AS" ("AI for Academic Survey").

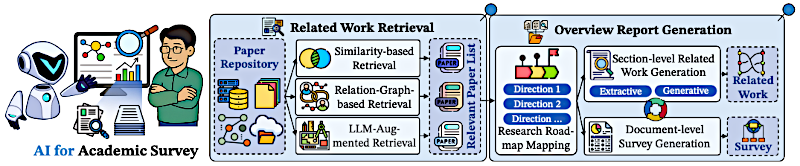
Esto está diseñado para sintetizar y estructurar información de múltiples artículos.

Beto
Ah, el problema de la revisión bibliográfica.

Alicia
Precisamente. Para darte una visión comprensiva de todo un dominio de investigación; es invaluable para detectar tendencias, ver cómo se desarrollaron las ideas y, crucialmente, identificar huecos de conocimiento.

Beto
¿Y cómo lo hace la IA? ¿Solo busca mejor?

Alicia
Es más que una búsqueda.

  • Primero, ayuda en la recuperación de trabajos relacionados, encontrando proactivamente los artículos relevantes. Y lo hace de maneras inteligentes.
  • Algunas usan entendimiento semántico, captando el significado de los artículos para encontrar relacionados aunque no compartan palabras clave.
  • Otras usan métodos basados en grafos, mapeando redes de citación como un árbol genealógico académico para ver qué es influyente o está relacionado.
  • Y los LLMs también mejoran esto, incrementando la relevancia de la búsqueda.
  • Incluso hay agentes de IA ahora, como CuriousLLM y ExSearch — agentes curiosos tipo LLM que actúan como pequeños investigadores económicos. Pueden llevar a cabo de forma autónoma un proceso de investigación de punta a punta, refinando su estrategia de búsqueda conforme avanzan. Esencialmente hacen una inmersión profunda por ti.
  • Y más allá de encontrar artículos, la IA ayuda a generar el informe de síntesis real.

Beto
Redacta la revisión de la literatura.

Alicia
Puede hacerlo. Hay herramientas que trazan hojas de ruta de investigación mostrando cómo se desarrolló un campo y hacia dónde podría ir. Otras automatizan revisiones sistemáticas, recuperando artículos de alta calidad y refinando iterativamente capítulos para un artículo de revisión. Sistemas como AutoSurvey, STORM, SurveyForge.

Beto
Aquí es donde me parece más interesante: ayudar a leer artículos individuales es una cosa, pero mapear todo un campo, detectar tendencias, redactar esa revisión de literatura: eso es un salto enorme en eficiencia.

Alicia
Lo es absolutamente. Piensa en las semanas, a veces meses, que los investigadores pasan solo para ponerse al día en un campo.

Beto
Me imagino el tiempo que se ahorra y los laboratorios por todas partes.

Alicia
Exacto. Estas herramientas están transformando cómo los investigadores se mantienen al día. Ayudan a filtrar ese enorme volumen de literatura, a detectar conexiones que quizás un humano pasaría por alto y a encontrar estudios relevantes sin abrumarse.

Beto
Liberándolos para pensar y experimentar.

Alicia
Ese es el objetivo. Es como tener una bibliotecaria digital incansable y un asistente de investigación en uno.

Beto
Perfecto. Cubrimos la comprensión del conocimiento existente.

Ahora pivotemos a la creación: ¿cómo contribuye la IA directamente a descubrimientos científicos nuevos? Y, seamos honestos, al proceso laborioso de redactar artículos académicos.

Alicia
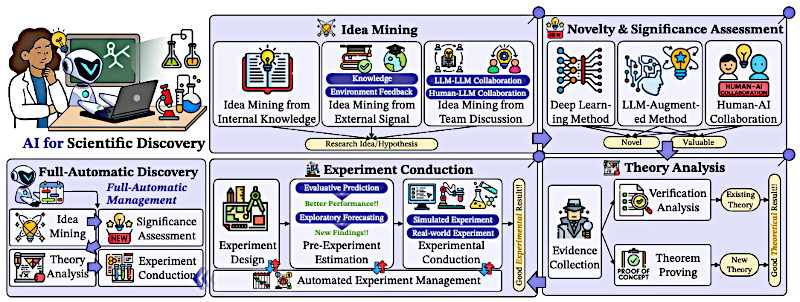
Correcto. Esto nos lleva a “IA para el descubrimiento científico”, "AI4SD" ("AI for Scientific Discovery"). Se centra en generar y validar hipótesis científicas novedosas, ideas nuevas e incluso ayudar a ejecutar experimentos.

Beto
Generar nuevas ideas: ¿cómo funciona eso?

Alicia
Es fascinante. Un área es la minería de ideas. La IA, especialmente LLMs potentes, puede aprovechar su vasto conocimiento interno. En pruebas de referencia, rinde sorprendentemente bien evaluando fluidez, viabilidad, claridad, originalidad de ideas.

Beto
Así que no es solo remezclar; puede ser genuinamente novedosa.

Alicia
Lo parece hasta cierto punto. También puede refinar datos externos o analizar transcripciones de discusiones de equipos para provocar ideas. Piensa en la IA recombinando hechos o conceptos científicos existentes de formas nuevas para sugerir hipótesis que un humano quizá no habría pensado. Sistemas como Scideator hacen esto.

Beto
Pero espera, el artículo menciona algo sobre creatividad, como un posible inconveniente.

Alicia
Ah, sí, esa es una matiz interesante. El artículo señala que, si bien los asistentes de IA pueden dar impulsos de creatividad en el corto plazo, hay un posible efecto a largo plazo. Si los investigadores llegan a depender en exceso de la IA para generar ideas, ...

Beto
... podrían volverse menos creativos por sí mismos.

Alicia
Potencialmente, sí. Su rendimiento creativo independiente podría verse afectado. Es algo de lo que los investigadores deben ser conscientes: usar la IA como herramienta, no como muleta para la creatividad.

Beto
Punto importante.

Bien, la IA ayuda a generar ideas. ¿Cómo sabemos si son buenas o realmente nuevas? Mencionaste antes un efecto de homogenización.

Alicia
Correcto. Eso se relaciona con la evaluación de novedad y significancia. Se están desarrollando métodos de IA para evaluar la originalidad y el posible impacto de ideas generadas por IA o por humanos.

Beto
¿Cómo funcionan?

Alicia
Existen métodos tradicionales, como SAPPhIRE, que cuantifican la novedad. Aparecen enfoques aumentados por LLMs, como GraphEval. Pero aquí viene la precaución ...

Beto
... la homogenización.

Alicia
Exacto. El artículo advierte que evaluaciones impulsadas puramente por IA podrían sobreestimar la creatividad. O, y aquí está la parte de homogenización, si todo el mundo usa el mismo tipo de herramienta de IA para lluvia de ideas y evaluación, se podría generar una convergencia de ideas entre distintos grupos de investigación, quizá asfixiando pensamientos realmente únicos y fuera de lo común.

Beto
Así que el juicio humano sigue siendo clave.

Alicia
Absolutamente esencial. La IA puede generar amplitud y sugerir posibilidades, pero el humano aporta ese juicio crítico y discernidor para la verdadera originalidad y significancia. Realmente apunta a la colaboración humano‑IA.

Beto
Muy bien. ¿Qué más en descubrimiento científico?

Alicia
Más allá de generación de ideas, la IA ayuda en análisis teórico. Básicamente, comprobar si una hipótesis tiene sentido científicamente.

Beto
¿Cómo? ¿Comprueba contra leyes conocidas de la física o algo así?

Alicia
Algo así. Incluye cosas como la formalización de afirmaciones científicas: convertir una afirmación en lenguaje natural, como una hipótesis, en un formato estructurado que una computadora pueda verificar rigurosamente.

Beto
Traducirla para la máquina.

Alicia
Exacto. Y el análisis de verificación científica, evaluar la coherencia lógica y la consistencia fáctica de afirmaciones basándose en la evidencia. Hay marcos como HiSS y ProToCo para esto e incluso demostración de teoremas.

Beto
Como en matemáticas.

Alicia
Sí. Herramientas de IA que pueden generar y verificar pruebas matemáticas de forma autónoma, como Lego-Prover y Lean Co‑Pilot, están mejorando la colaboración humano‑IA en trabajos teóricos complejos.

Beto
Wow. Eso es la parte teórica. ¿Y el trabajo de laboratorio práctico? Los experimentos.

Alicia
Esta es quizás una de las áreas más impactantes. Conducción de experimentos. La IA se usa de varias maneras poderosas. Primero, diseño de experimentos. Puede ser semiautomático, donde la IA sugiere protocolos a un humano — por ejemplo, para experimentos cuánticos — o totalmente automático donde la IA planifica estudios enteros de forma autónoma. Sistemas como “AI Scientist” o "Agent Laboratory" pueden incluso refinar protocolos basándose en resultados tempranos.

Beto
Entonces la IA planifica el experimento por sí sola.

Alicia
Sí. Luego está la estimación previa al experimento: la IA predice resultados antes de que ejecutes el experimento.

Beto
Como una bola de cristal del laboratorio.

Alicia
Algo así. DeepMind, por ejemplo, predijo cientos de miles de nuevas estructuras de materiales estables. BrainGPT supuestamente superó a expertos humanos en pronosticar algunos resultados experimentales en neurociencia.

Beto
Increíble. Eso reduce experimentos perdidos.

Alicia
Luego está la gestión y ejecución del experimento. Aquí surge la idea de laboratorios autodirigidos.

Beto
Laboratorios autodirigidos, como coches autónomos.

Alicia
Ajá. Algo así. Significa integrar robótica, instrumentos analíticos e IA en un bucle cerrado: la IA toma decisiones, los robots realizan tareas, los instrumentos recogen datos, la IA los analiza y ajusta el siguiente paso.

Beto
Investigación totalmente autónoma.

Alicia
Esa es la visión. Plataformas como Functional Genomics Explorer son ejemplos tempranos que generan hipótesis, diseñan experimentos, los ejecutan y validan resultados por sí mismas.

La IA también se usa durante los experimentos, agilizando cosas como diseñar modelos de ML para análisis o usando cadenas de herramientas especializadas como ChemCrow para tareas de química.

Beto
Y el análisis posterior.

Alicia
Sí. El análisis experimental es grande también: métricas de evaluación automatizadas, comprobar si los resultados se alinean con teoría; incluso análisis exploratorio donde la IA, como HeLM, puede resumir tablas de datos complejas en lenguaje natural.

Beto
¿Cuál es la meta última?

Alicia
La meta última aquí es la aspiración de descubrimiento totalmente automático, donde la IA puede cerrar todo el bucle: hipótesis, diseño experimental, ejecución, análisis, quizá incluso escribir el primer borrador del artículo.

Beto
Y eso ya está ocurriendo.

Alicia
Hemos visto ejemplos a un nivel inicial, pero impresionante. El artículo menciona un sistema llamado Zochi, un sistema impulsado por IA que aparentemente ha generado artículos aceptados en una conferencia importante, ACL.

Beto
Vaya.

Eso nos lleva a la parte de redacción: "IA para Redacción Académica", "AI4AW" ("AI for Academic Writing").

Alicia
Sí. Asistir a investigadores a redactar, editar y formatear manuscritos.

Beto
¿Cómo funciona? ¿Es solo un Grammarly potente?

Alicia
Eso es parte de la asistencia semiautomática: herramientas que ayudan con gramática, estilo y claridad, como PaperPal.

Pero va más allá. La IA puede ayudar durante la preparación del manuscrito: trazar esquemas, sugerir títulos, ayudar a estructurar el argumento lógicamente usando marcos como MODeST o LLM-Rubric. Durante la escritura, la IA puede generar figuras, escribir leyendas, convertir fórmulas a LaTeX automáticamente, e incluso recomendar citas relevantes.

Beto
Eso de las citas es enorme. Encontrar qué citar es difícil.

Alicia
Lo es. Y después del primer borrador, no es solo gramática: sugiere revisiones para mejor expresión o flujo lógico.

Beto
Eso es la asistencia semiautomática. ¿Y la automática?

Alicia
En el lado totalmente automático, se construye sobre los sistemas de descubrimiento que mencionamos. Cosas como AI Scientist, Agent Laboratory, Zochi pueden generar manuscritos completos.

Beto
Generados enteramente por IA.

Alicia
Sí, pero — y esto es clave — el artículo destaca una salvedad.

Beto
Siempre hay una traba.

Alicia
Ja‑ja. Pues una comprobación de la realidad: a pesar de esos éxitos, ningún sistema ha eliminado por completo la necesidad de edición humana, especialmente para el uso correcto de las citas. Atribuir correctamente y obtener las referencias bien aún parece necesitar un ojo humano cuidadoso.

Beto
Tiene sentido. Estas facetas llevan mucha matiz.

Esto nos deja una pregunta importante: si la IA puede generar ideas nuevas, diseñar y ejecutar experimentos, analizar resultados e incluso escribir artículos que se publican, ¿qué significa eso para el papel humano en el laboratorio y en la academia? ¿Vamos hacia un futuro en el que los científicos solo dan instrucciones a las IAs?

Alicia
Es una gran pregunta que mucha gente se hace. El artículo enmarca el objetivo de la IA como maximizar eficiencia, rendimiento y capacidad de innovación.

Beto
Aumentar a los humanos, no reemplazarlos.

Alicia
Principalmente, sí: aumentar a los humanos. El humano sigue siendo crucial para el juicio crítico, la supervisión ética y para plantear las verdaderas preguntas originales que guían la dirección de la investigación.

Beto
Y quizá para esos golpes intuitivos que la IA puede no captar.

Alicia
Exacto. Empujar límites donde la IA todavía falla. Entender el contexto más amplio, las implicaciones sociales, tomar juicios matizados — como con las citas o la interpretación de resultados ambiguos. Se trata de construir una asociación.

Beto
Un equipo humano‑IA.

Alicia
Precisamente. No un reemplazo. Los humanos aportan visión, brújula ética y la responsabilidad última.

Beto
Bien, eso tranquiliza.

El proceso científico no estaría completo sin la revisión por pares, ese escrutinio riguroso. ¿Cómo está la IA afrontando lo que a menudo es un cuello de botella en la publicación académica?

Alicia
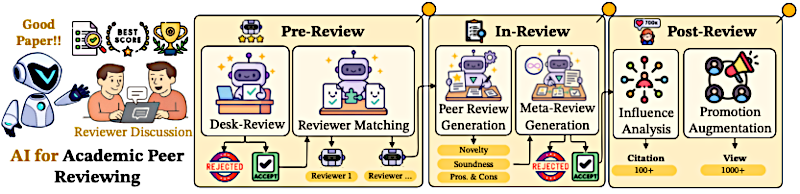
Bien. Esto es la quinta área: "IA para revisión por pares académica", "AI4PR" ("AI for Peer Review").

El objetivo es automatizar y mejorar ese proceso, con la esperanza de elevar la calidad y la eficiencia.

Beto
Definitivamente lo necesitan.

Alicia
Sí. La IA ayuda en la etapa previa a la revisión: aliviar la carga de las oficinas editoriales. Herramientas de IA pueden extraer palabras clave de manuscritos, emparejar temas con revisores potenciales e incluso proporcionar una puntuación preliminar de calidad o alcance. Editoriales grandes como Elsevier o Springer ya usan sistemas así. Herramientas como AnnotateGPT permiten a los editores evaluar rápidamente un manuscrito.

Beto
Y encontrar revisores adecuados siempre es difícil.

Alicia
Exacto. Sistemas de IA como el Toronto Paper Matching System están diseñados para emparejar artículos con revisores apropiados según experiencia, historial e incluso carga de trabajo, acelerando la asignación inicial.

Beto
Eso es antes de que empiece la revisión. ¿Y durante la revisión misma?

Alicia
Esa es la fase en revisión. Aquí el enfoque está en proporcionar retroalimentación académica exhaustiva y evaluación. Algunos sistemas de IA se están desarrollando para generar revisiones por pares.

Beto
¿La IA escribiendo la revisión? ¿En serio?

Alicia
Sí. Sistemas como RelevAI-Reviewer pretenden ofrecer revisiones estructuradas, objetivas y constructivas. Pero hay una matiz que el artículo señala.

Beto
Déjame adivinar: la IA no es perfecta todavía.

Alicia
Bueno, los LLMs actuales, si simplemente les pides que revisen un artículo, pueden ser buenos detectando fallos técnicos y problemas metodológicos. Pero podrían subestimar la novedad o la significancia. Quizá no reconozcan con facilidad una idea verdaderamente revolucionaria que cambia paradigmas.

Beto
Ah, podrían ser demasiado conservadores o perder el bosque por los árboles.

Alicia
Posible. Es un área en desarrollo activo. Investigadores exploran maneras de mejorar las revisiones de IA, quizá mediante refinamiento iterativo o usando múltiples agentes de IA que debatan el artículo, como en una revisión por agentes o revisión en árbol.

Beto
¿Y sintetizar múltiples revisiones humanas? A veces los revisores discrepan mucho.

Alicia
Esa es otra aplicación. Meta‑review. La IA puede ayudar a sintetizar las opiniones de varios revisores humanos en una única crítica más objetiva. Herramientas como Meta‑Writer pueden extraer argumentos clave; Peer‑Arg intenta reducir subjetividad y sesgo en esa evaluación final para el editor.

Beto
Eso puede ser muy útil. Entonces, pre‑revisión, en revisión... ¿y después de aceptar el artículo?

Alicia
Etapa post‑revisión. Aquí los métodos de IA se aplican tras la aceptación para evaluar e incluso ampliar el impacto académico del artículo.

Beto
¿Como predecir el futuro?

Alicia
En parte. Un área es el análisis de influencia, predecir impacto futuro académico, como cuántas citas podría obtener un artículo. Marcos como HLM‑Cite intentan esto. Y, curiosamente, el artículo observa que algunos métodos basados en contenido por IA han superado a expertos humanos al predecir resultados en neurociencia en ciertos contextos.

Beto
Vaya. Y ampliar el impacto.

Alicia
Sí, mejora de la promoción. IA generativa puede tomar un manuscrito denso y crear materiales promocionales variados y accesibles.

Beto
¿Como qué? ¿Notas de prensa?

Alicia
Como notas de prensa, pósters académicos automáticos (como el sistema P2P), resúmenes divulgativos lingüísticamente más simples y claros que los escritos por humanos usando GPT‑4, o incluso videos científicos concisos, como SciTalk.

Beto
Lo realmente impactante es que la IA no solo actúa sobre la investigación en sí: está construyendo la infraestructura académica alrededor. Desde la revisión hasta la promoción, está creando un ecosistema nuevo.

Alicia
Muy buena síntesis.

Beto
Pero con cambios tan profundos, especialmente en validación y comunicación científica, deben surgir preocupaciones éticas. ¿Cuáles son los escollos?

Alicia
Absolutamente. El artículo aborda estos desafíos emergentes. No todo es viento a favor.

Beto
¿Como cuáles?

Alicia
Por ejemplo, dijimos que la IA mejora la revisión y el emparejamiento, pero si la IA está entrenada mayormente con datos de instituciones con muchos recursos o en idiomas con muchos recursos, podría inadvertidamente perjudicar a autores de otros entornos o a quienes escriben en idiomas menos comunes.

Beto
Crear sesgos (polarización, discriminación) sobre quién es revisado o publicado.

Alicia
Potencialmente, sí. También está el riesgo de uso indebido: ¿puede la IA usarse para manipular la revisión por pares mediante colusión? Y recuerda el punto sobre interpretaciones estadísticas de la IA que caen en manías dicotómicas ...

Beto
... “significativo / no significativo” ...

Alicia
Sí. Simplificando demasiado y quitando matices. Estos son riesgos reales que necesitan gestión activa.

Beto
¿Cómo gestionarlos?

Alicia
El artículo sugiere estrategias como entrenamiento consciente de equidad para los modelos de IA, desarrollar técnicas de des sesgo que no requieran reentrenamiento costoso y, crucialmente, establecer marcos éticos claros para desarrollar y monitorizar contenido generado por IA en investigación.

Beto
Suena a que se necesita una nueva capa de gobernanza.

Alicia
Lo es. Es un paisaje en evolución.

Beto
Mirando al horizonte, ¿cuáles son las fronteras más prometedoras para la IA en investigación y los grandes desafíos que aún quedan para construir este nuevo ecosistema?

Alicia
Bien, el artículo destaca varias fronteras y retos clave.

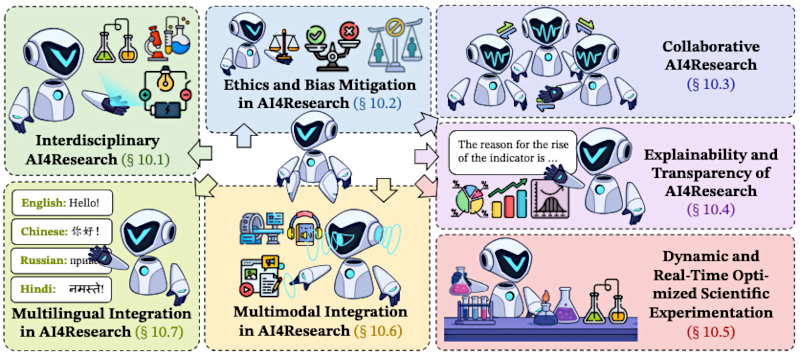
Uno importante es desarrollar modelos interdisciplinarios de IA.

Beto
Significa, IA que comprenda múltiples campos.

Alicia
Exacto. El trabajo futuro necesita sistemas de propósito más general que integren conocimiento a través de diversas áreas — biología, física, ciencias sociales —, piensa en modelos fundacionales para la ciencia o modelos de grafos sofisticados que conecten conceptos entre dominios.

Beto
El reto es enorme: manejar diferentes tipos de datos.

Alicia
Precisamente. Lograr transferencia efectiva de conocimiento entre dominios, y todo ello manteniendo la IA fiable y, muy importante, interpretable.

Beto
Ya tocamos ética, ¿y colaboración?

Alicia
Sí: IA colaborativa para investigación es otra gran frontera. ¿Cómo hacemos que el trabajo en equipo humano‑IA sea realmente efectivo y fluido?

Beto
¿Qué obstáculos hay?

Alicia
Los obstáculos incluyen:

  • la complejidad de la interacción:
    • gestionar el ida y vuelta,
    • quién controla cuándo,
    • cómo se reasignan tareas.
  • Otro dilema es la tensión entre privacidad de datos y accesibilidad.

Beto
Se necesitan muchos datos para entrenar buenas IAs, pero hay que proteger datos de investigación sensibles.

Alicia
Exacto. La anonimización ayuda, pero a veces reduce la utilidad de los datos para entrenamiento potente. Equilibrio difícil.

Beto
Y la transparencia: explicar cómo funciona la IA.

Alicia
Crucial para la confianza científica. Explicabilidad y transparencia. Implica entender cómo llegan a conclusiones.

Beto
¿Cómo haces transparente una caja negra?

Alicia
Hay enfoques como análisis “caja blanca”, investigando la estructura interna del modelo, y análisis “caja negra”, interpretando entradas y salidas sin mirar dentro. Pero faltan marcos estandarizados para estas técnicas de explicación.

Beto
Además está el trade‑off entre transparencia y rendimiento: los mejores modelos suelen ser los menos transparentes.

Alicia
Es un gran escollo.

Beto
¿Qué más hay en el horizonte?

Alicia
Experimentación dinámica y optimizada en tiempo real, construyendo a partir de los laboratorios autodirigidos.

Beto
IA que ajusta protocolos al vuelo según los datos entrantes.

Alicia
Esto implica agentes de IA con capacidad de razonamiento y planificación, mejor coordinación y laboratorios autodirigidos que integren hardware y software sin fricción.

Beto
Y por último, mencionaste el problema de los idiomas.

Alicia
La integración multilingüe: la ciencia es global, pero las herramientas de IA suelen favorecer el inglés, ...

Beto
... creando silos de información.

Alicia
Exacto. Crea potencialmente una brecha, un abismo de conocimiento.

El trabajo futuro debe centrarse en preentrenamiento multilingüe, aumento de datos y técnicas para que la IA pueda resumir, recuperar y traducir contenido científico con precisión en muchos idiomas. Alinear la terminología científica entre lenguas es todo un desafío en sí.

Beto
Eso es mucho para digerir.

Entonces, ¿qué significa todo esto para nosotros, los oyentes? En un mundo donde la ciencia se vuelve cada vez más informada por IA, ¿cómo deberíamos pensar al respecto?

Alicia
Creo que significa reconocer el potencial inmenso. La IA realmente puede acelerar el descubrimiento, hacer el conocimiento más accesible globalmente, pero también exige un nuevo nivel de pensamiento crítico.

Beto
No confíes ciegamente en la salida de la IA.

Alicia
Exacto. Como oyentes aprecien las capacidades, la velocidad, la eficiencia, pero también sean conscientes de las limitaciones actuales, los sesgos y las preguntas éticas que los investigadores están afrontando. La meta no es que la IA reemplace a los humanos.

Beto
Esa asociación otra vez.

Alicia
Correcto. Construir sistemas de IA confiables, innovadores y responsables que aumenten la ingeniosidad humana. Hacer la ciencia más rápida, más eficiente, quizá más equitativa y accesible para todos.

Beto
Qué viaje tan increíble a través de esta transformación impulsada por IA. Hemos visto a la IA tocarlo todo: entender artículos densos, mapear campos enteros, provocar descubrimientos, ayudar a redactar, agilizar la revisión por pares. Realmente es, como dijiste, un ecosistema completamente nuevo para el trabajo académico.

Alicia
Y este marco "AI4Research" explorado en el artículo nos da una perspectiva unificada. Nos ayuda a ver cómo encajan todas estas piezas, empujándonos hacia un futuro de, con suerte, innovación más rápida y entendimiento más profundo.

Beto
Me queda un pensamiento final. Dada la creciente capacidad de la IA para no solo procesar información, sino también minar nuevas ideas e incluso autocriticarse en su razonamiento: ¿cómo pueden cambiar nuestros propios “momentos ajá”? Esos momentos de aprendizaje y descubrimiento.

Alicia
Hmm, eso es profundo.

Beto
¿Se convertirá la IA en una máquina de dar respuestas?

¿O quizá nos empujará a formular preguntas aún más profundas y fundamentales sobre el conocimiento mismo y sobre nuestro rol humano único en buscar y comprenderlo de verdad?