Mostrando entradas con la etiqueta ingenieria. Mostrar todas las entradas

miércoles, 1 de julio de 2026

IA en la Educación en Ingeniería


En este artículo, Olya Kudina investiga la integración de los Modelos de Lenguaje a Gran Escala (LLM) en la educación en ingeniería mediante una encuesta a 100 estudiantes y una revisión de la literatura actual. La investigación destaca cómo los estudiantes utilizan estas herramientas para la redacción académica, la asistencia en programación y la clarificación de conceptos, manteniendo la cautela ante problemas como las alucinaciones y los sesgos. Kudina analiza la percepción popular de la IA como un "oráculo" autoritario o un "tutor" personalizado, sugiriendo que estas metáforas a menudo exageran las capacidades reales de los generadores probabilísticos. Un hallazgo clave es el concepto de "optimismo cruel", donde la eficiencia prometida de la IA en realidad requiere un alto nivel de conocimientos que los estudiantes aún no dominan. En última instancia, la autora aboga por una alfabetización crítica en IA y un enfoque pedagógico orientado a un propósito que equilibre la innovación con la responsabilidad ética y ambiental. Este trabajo ofrece una visión general de cómo la disrupción tecnológica está transformando los valores y las prácticas de la educación superior.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Using AI in engineering education: a balancing act, driven by clear purpose", por Olya Kudina, de la universidad North-West en SudÁfrica. Publicado el 15 de Junio de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Si te dijera que generar una lista de lluvia de ideas simple de cinco puntos para su próximo ensayo consumió suficiente agua física para llenar un vaso. Y quemar exactamente la misma cantidad de electricidad es solo dejar una bombilla encendida en su casa. Podrías detenerte antes de escribir esa siguiente instrucción.

Alicia
Definitivamente lo piensas dos veces.

Beto
Exacto. Tendemos a pensar en la inteligencia artificial como esta magia sin peso viviendo en la nube en algún lugar. Pero bienvenidos a este análisis profundo.

Hoy, vamos a mirar mucho más allá de esas cajas de texto minimalistas y prístinas para examinar la realidad increíblemente desordenada, intensiva en recursos y psicológicamente compleja de lo que sucede cuando intentamos usar esta tecnología para aprender de verdad.

Alicia
Sí, es una imagen completamente diferente detrás de la pantalla.

Beto
Totalmente. Y nuestro material fuente hoy es un artículo realmente perspicaz de Olya Kudina, titulado "Usando IA e ingeniería educativa, un acto de equilibrio impulsado por un propósito claro".

Alicia
Y el valor de esta investigación específica es que evita completamente la exageración de marketing teórico. No estamos hablando de lo que los CEOs de tecnología afirman que hará el software en 10 años.

Beto
Claro. Lo de la ciencia ficción.

Alicia
Exacto. Estamos examinando lo que están haciendo realmente los estudiantes universitarios con ello en este momento. Y las trampas invisibles en las que están cayendo, sin siquiera darse cuenta.

Beto
Así que la misión de este análisis profundo es desglosar exactamente cómo los estudiantes de educación superior están percibiendo y utilizando los modelos de lenguaje grandes, o LLM. Queremos exponer las trampas psicológicas y epistémicas ocultas en las que están cayendo y, explorar cómo ustedes, ya sean estudiantes o profesionales, pueden navegar pragmáticamente toda esta disrupción.

AI_in_Engineering_Education_1024.png
La Balanza de la IA: Navegando LLMs en Educación para Ingenieros

Alicia
Bien, desglosémoslo. ¿Cómo podemos tender un puente entre las promesas mágicas de la IA y la realidad desordenada del aula?

Beto
Bueno, realmente tenemos que empezar con los datos crudos sobre el comportamiento del usuario. Así que el estudio de Kudina encuestó a 100 estudiantes de educación superior. Y debo señalar que estos no son novatos.

Alicia
Claro. Son bastante avanzados.

Beto
Sí. Predominantemente están en ingeniería, robótica y diseño. Así que son personas profundamente familiarizadas con sistemas complejos. Y la encuesta desglosa sus casos de uso principales.

Alicia
¿Qué encuentran?

Beto
El 27% está utilizando LLM para escritura y edición académica. Lo cual me encanta. Uno de los estudiantes del estudio incluso lo llamó "Grammarly en esteroides".

Alicia
Es una gran descripción, de verdad. Y luego tienen al 20% utilizándolo para la comprensión de conceptos, básicamente tratándolo como un explicador interactivo.

Y otro 17% lo están usando directamente para codificación y depuración ("debugging").

Beto
Así que en papel, todo suena genial, ¿verdad? Como un asistente multifuncional perfecto.

Alicia
Claro. Pero aquí está el giro. Los datos cualitativos, los comentarios reales de estos estudiantes, revelan esta inmensa corriente subterránea de ansiedad. A pesar del uso intensivo, de esas 100 respuestas, 53 señalaron específicamente preocupaciones graves sobre la calidad de la salida.

Beto
El 53%, vaya.

Alicia
Sí. Usan términos como "mentir" ("bullshitting"), se quejan de las alucinaciones y de cómo el sistema simplemente inventa hechos. Y el 34 señalaron lo que el artículo señala como "carga de verificación" ("verification burden").

Beto
La carga de verificación. Profundicemos en eso porque parece ser el punto central de fricción ahora mismo.

Alicia
Absolutamente lo es. Los estudiantes están tratando a estos LLM como asistentes perfectos, pero se encuentran totalmente abrumados por la necesidad constante de revisar literalmente todo.

Beto
Es como, contratar a un interno increíblemente entusiasta e increíblemente rápido que simplemente te miente con confianza.

Alicia
Eso es prácticamente lo que es.

Beto
Como si el interno entrara a tu oficina, te entregara este informe de 50 páginas bellamente formateado y dijera: "aquí están esos cálculos de termodinámica". Pero la mitad de las matemáticas están totalmente fabricadas. Quiero decir, si tenemos que pasar todo nuestro tiempo verificando el trabajo del interno, línea por línea, ¿estamos ahorrando tiempo, o simplemente estamos cambiando nuestra carga de trabajo?

Alicia
Definitivamente solo la estamos trasladando. Y la carga cognitiva de ser un gerente, verificarlo todo, es agotador.

Beto
Entonces, ¿por qué siguen confiando en este interno defectuoso en primer lugar? Quiero decir, estos son estudiantes de ingeniería inteligentes.

Alicia
Bueno, se reduce a las metáforas que usan para entender la tecnología. Y la primera metáfora importante que identifica el artículo es "el oráculo".

Beto
El oráculo, como si supiera todo.

Alicia
Exactamente. Los estudiantes ven a los LLM como un narrador de la verdad omnisciente o como, según un estudiante, un "Google sobrepotenciado".

Beto
Pero llamarlo un Google sobrepotenciado implica que está extrayendo hechos duros de una base de datos, lo cual no ocurre.

Alicia
Correcto. No es un sistema de recuperación de hechos, en absoluto. Lo fascinante aquí es cómo la interfaz de diseño desalienta activamente el pensamiento crítico.

Beto
¿Cómo es eso?

Alicia
Bueno, piensa en la ventana de chat. Es totalmente libre de fricción, visualmente limpia. No te pide que pares o cuestiones la fuente. Simplemente te da la salida fluida y continua que imita el tono de un experto.

Beto
Así crea una ilusión de inteligencia, que enmascara la realidad técnica de que es solo un generador de texto probabilístico, que adivina la siguiente palabra.

Alicia
Exacto. Y esto lleva a una profunda vulnerabilidad epistémica. Un ejemplo perfecto de esto es cuando la IA genera fuentes fantasma ("ghost sources").

Beto
Oh, he visto esto donde te da una URL o una cita de un artículo que simplemente no existe.

Alicia
Claro. Alucinó la fuente porque estadísticamente, una cita parecía pertenecer allí, pero está completamente fabricada.

Beto
Lo que realmente me hace cuestionar el consejo estándar que dan los educadores. Siempre dicen: "confía, pero verifica". Pero el estudio señala que los usuarios a menudo carecen del conocimiento del dominio para detectar los errores.

Alicia
Sí, ese es el problema central.

Beto
Es como decirle a un estudiante que verifique una explicación de física compleja de un LLM. Es como pedirle a un piloto novato que verifique las matemáticas complejas del sistema de piloto automático de un avión. Quiero decir, ¿cómo puedes verificar un concepto que ni siquiera has aprendido todavía?

Alicia
No puedes. Simplemente no tienes las herramientas. Y esa ilusión del oráculo naturalmente conduce a una metáfora aún más íntima y quizás más peligrosa, sobre "el tutor".

Beto
Aquí es donde se pone realmente interesante, creo. Porque si sabe todo, seguramente puede enseñarte.

Alicia
Esa es la suposición. Los estudiantes están usando los LLM para este aprendizaje conversacional individualizado. Pero el problema es que los LLM usan todo este lenguaje adulador y afirmativo hacia el usuario.

Beto
Como 'gran pregunta'. O 'eres tan inteligente por preguntar eso'.

Alicia
Exacto. Aumenta la confianza percibida, pero falla en rastrear tu comprensión o proporcionar andamiaje pedagógico real como lo haría un tutor humano.

Beto
Y esto corre el riesgo de lo que el artículo llama "deuda cognitiva" ("cognitive debt"), descalificación ("de-skilling"), porque elimina totalmente la lucha productiva.

Alicia
Sí. Y la investigación muestra que la lucha proactiva es esencial para la retención a largo plazo. Si la máquina simplemente te da la respuesta, no estás construyendo esas vías neuronales.

Beto
Además, fallan tan mal en matemáticas complejas y física conceptual profunda de todos modos.

Alicia
Realmente lo hacen.

Y hay otra capa crucial aquí con respecto a la imparcialidad. El artículo señala que los LLM perpetúan sesgos ocultos.

Beto
Oh, cierto. El estudio demográfico.

Alicia
Sí. Un estudio reciente mostró que los LLM adaptan las explicaciones de STEM basándose en el género percibido por los usuarios. Así que usa metáforas domésticas para las mujeres y explicaciones enfocadas en el proceso técnico para los hombres.

Beto
Simplemente está reflejando silenciosamente sesgos sociales sin que nadie se dé cuenta. Vaya.

Pero volviendo a esa cosa de la descalificación, realmente cuestiono el valor final del aprendizaje sin fricción.

Alicia
Es una gran preocupación para los educadores ahora mismo.

Beto
Quiero decir, es como usar un LLM para generar automáticamente un esquema estructural para un ensayo similar a tomar un helicóptero hasta la cima de una montaña, y afirmar que la escalaste.

Alicia
Esa es una gran manera de decirlo.

Beto
Obtuviste la vista, pero no construiste ningún músculo en las piernas. Simplemente saltaste toda la escalada.

Alicia
Y eventualmente vas a caminar y no tendrás los músculos para ello.

Así que habiendo desmantelado las metáforas del oráculo y el tutor, realmente tenemos que mirar el núcleo psicológico.

Beto
Claro. ¿Por qué los estudiantes siguen volviendo a estas herramientas a pesar de las fuentes fantasma, los sesgos, la falta de aprendizaje real?

Alicia
El artículo introduce este concepto por Lauren Berlant llamado "Optimismo Cruel".

Beto
Optimismo Cruel. Me encanta esa frase, pero ¿qué significa realmente aquí?

Alicia
Es un estado en el que lo que deseas es en realidad un obstáculo para tu florecimiento. Los estudiantes desean desesperadamente un atajo para manejar sus abrumadoras cargas de trabajo.

Beto
Simplemente quieren aprender de manera eficiente.

Alicia
Claro. Pero la crueldad es que extraer cualquier valor real de un LLM requiere un inmenso trabajo cognitivo, emocional y moral para verificar esas salidas.

Beto
Porque tienes que cuidar al interno.

Alicia
Exacto. La paradoja es que hacer que los LLM funcionen de manera efectiva requiere exactamente el conocimiento disciplinario, la humildad epistémica y las habilidades de validación de fuentes que los estudiantes están adquiriendo en la universidad, para empezar.

Beto
Si conectamos esto con la imagen más grande, están siendo esencialmente obligados a convertirse en gerentes de un sistema defectuoso.

Alicia
Si conectamos esto con la imagen más grande, exactamente. Están asumiendo la responsabilidad por la precisión de afirmaciones que no están totalmente equipados para evaluar.

Beto
Me recuerda que es como comprar un gimnasio casero motorizado increíblemente complejo para ahorrar tiempo. Solo para darte cuenta de que necesitas un título literal en kinesiología solo para usarlo de forma segura sin lastimarte.

Alicia
Correcto. La herramienta exige la experiencia exacta que esperabas que reemplazara.

Beto
Así que armados con todo esto, estas trampas psicológicas, estas trampas prácticas, ¿cómo deberían ustedes, los oyentes y cómo deberían los educadores manejar esto sin simplemente prohibirlo por completo?

Alicia
Bueno, la conversación pivota hacia soluciones y comienza con un factor crítico, a menudo ignorado: el costo ambiental.

Beto
Volvamos a esa estadística de agua y energía de la introducción.

Alicia
Sí, una sola consulta a ChatGPT utiliza alrededor de 0.34 vatios hora. Eso es como alimentar una taza de té helado por unos minutos. Y utiliza cinco gotas de agua solo para enfriar.

Beto
Lo que no suena mucho hasta que lo escalas.

Alicia
Exacto. Anualmente, un ChatGPT consume 310 gigavatios hora. Eso es comparable al consumo de electricidad de tres millones de personas en Etiopía.

Beto
Eso es asombroso.

Alicia
Y para 2027, la demanda de agua de la IA superará el total anual de extracción de Dinamarca.

Beto
Realmente quiero llevar eso directamente a ustedes, quien están escuchando ahora mismo. Dado que generar una lista de "lluvia de ideas" genérica requiere agua y energía del mundo real equivalente a encender una bombilla, no debería eso por sí solo hacernos hacer una pausa y preguntarnos si la energía vale la pena para tareas triviales.

Alicia
Absolutamente debería hacerlo. Y esta realidad ambiental combinada con los riesgos educativos conduce al marco AAA para educadores: "Against, Avoid, Adapt" ("contra evitar, adoptar").

Beto
Desglósalo para mí.

Alicia

  • "Contra" es para habilidades de orden inferior, como la recuperación básica. Tienes que forzar la lucha productiva allí.
  • "Evitar" es para habilidades de orden superior que necesitan contexto personal, como escribir sobre tu propia experiencia vivida. No quieres que una máquina haga eso.
  • Y "adoptar" es para la crítica intencional, como tener la IA generando código defectuoso y la tarea es que el estudiante encuentre los errores y los corrija.

Beto
Así que estás convirtiendo el defecto en la lección.

Alicia
Precisamente. Y un gran ejemplo de esto es una herramienta matemática llamada "Waterproof". Combina la IA basada en reglas tradicional con IA generativa para proporcionar una interfaz de chat amigable, pero el motor basado en reglas evita que alucine las matemáticas.

Beto
Así que es seguro.

Alicia
Correcto. Esta es una pregunta importante con respecto a lo que se llama "el dilema de Collingridge".

Beto
El dilema de Collingridge, ¿me recuerdas lo que es?

Alicia
Es la idea de que cuando una tecnología es nueva, puedes cambiarla, pero aún no conoces las consecuencias. Para cuando conoces las consecuencias negativas, la tecnología está tan arraigada que no puedes cambiarla.

Beto
Lo que se siente exactamente como estamos con la IA generativa ahora mismo.

Alicia
Exacto. Así que el autor argumenta que necesitamos mantener la limitación tecnológica, básicamente manteniendo un espacio intermedio donde experimentamos, pero no arraigamos completamente la tecnología en nuestros sistemas antes de comprender las consecuencias.

Beto
Tenemos que mantener nuestras opciones abiertas.

Alicia
Tenemos que hacerlo.

Beto
Entonces, ¿qué significa todo esto? Sinteticemos rápidamente este viaje. Pasamos, de la realidad de cómo los estudiantes están usando realmente la IA, a través de las ilusiones del oráculo, y la metáfora del tutor, ...

Alicia
... hasta la trampa del optimismo cruel.

Beto
Claro. Y finalmente, las realidades ambientales y marcos prácticos como "contra", "evitar", "adoptar". Y quería recordarles directamente a los oyentes que si bien estas herramientas son increíblemente seductoras, ustedes son quienes todavía tienen que hacer el trabajo pesado del verdadero aprendizaje y la verificación.

Alicia
No pueden subcontratar el proceso de aprendizaje.

Beto
Realmente no pueden.

Y eso me lleva a un pensamiento final provocador que quiero dejarles para que lo exploren ustedes mismos.

Pasamos todo este tiempo hablando del peligro de que la IA alucine y se equivoque. Pero si las empresas de tecnología eventualmente tienen éxito en hacer que la IA sea perfectamente fluida, es decir, que simplemente deje de cometer errores obvios de alucinación, ¿nuestros músculos críticos de verificación se atrofiarán por completo?

Alicia
Eso es un pensamiento aterrador.

Beto
Correcto. Quizás el estado actual profundamente defectuoso de la IA, este interno que tenemos que cuidar, es en realidad un regalo oculto que nos obliga a mantenernos escépticos.

Tal vez el verdadero peligro no sea cuando la IA está equivocada, sino el día en que se vuelve casi siempre correcta.

domingo, 12 de abril de 2026

La Adopción de IA en Programación Científica


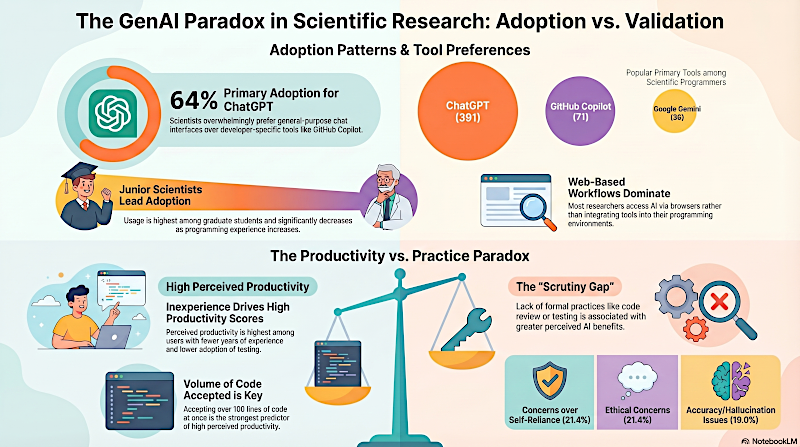
Este artículo de investigación examina cómo los científicos utilizan la IA generativa para facilitar las tareas de programación, analizando específicamente las tasas de adopción y la productividad percibida. Basado en una encuesta a 868 investigadores, el estudio revela que los científicos noveles y aquellos con menos experiencia en programación son los usuarios más frecuentes de estas herramientas. La mayoría de los participantes prefiere las interfaces conversacionales de propósito general, como ChatGPT, a los programas especializados para desarrolladores integrados en sus entornos de programación. Los datos sugieren un riesgo potencial de dependencia excesiva, ya que quienes no siguen prácticas de validación estándar —como las pruebas de código o la revisión por pares— reportaron la mayor sensación de productividad. La alta eficiencia percibida también se relacionó fuertemente con la aceptación de grandes bloques de código a la vez, lo que indica que los usuarios pueden valorar más el volumen de resultados que la verificación. En definitiva, los autores destacan la tensión existente entre el atractivo de la IA para ahorrar tiempo y la necesidad crítica de precisión en el software científico.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "A survey of generative AI adoption and perceived productivity among scientists who program", por Gabrielle O’Brien y colegas. Publicado el 9 de Abril de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Imagina el complejo software científico que predice nuestros modelos climáticos globales. O el código que analiza esos enormes ensayos contra el cáncer que salvan vidas.

Alicia
Ajá.

Beto
O incluso esos guiones realmente intrincados que se usan para descubrir física completamente nueva a nivel cuántico.

Alicia
Lo realmente fundamental.

Beto
Exacto. Cuando te imaginas a las personas que escriben ese código, probablemente piensas en salas llenas de ingenieros de software veteranos tecleando meticulosamente en entornos de desarrollo altamente especializados.

Alicia
Sí, esa es la imagen habitual.

Beto
Pero cada vez más, ese código en realidad está siendo generado por ChatGPT.

Alicia
Sí.

Beto
Y lo están pidiendo estudiantes de posgrado con una formación formal mínima en programación.

Así que hoy vamos a mirar algo que afecta la base literal del conocimiento humano moderno, incluso si nunca escribes ni una sola línea de código tú mismo.

Alicia
Porque el software del que hablamos forma los bloques de construcción de la investigación científica moderna. Quiero decir, antes los artículos científicos eran solo teoría y experimentos físicos.

Beto
Correcto. Tubos de ensayo y pizarras.

Alicia
Exacto. Pero hoy, casi cada gran avance está respaldado por miles de líneas de código a medida. Y, si ese código tiene fallos, la ciencia está fallada. Estamos en medio de esta transición masiva, totalmente descoordinada, sobre cómo se construye realmente esa infraestructura científica crítica.

Beto
Es un cambio enorme. Y nuestro texto fundacional para entender este cambio es este reciente artículo en arXiv de O’Brien, Parker, Icede y Carver.

Alicia
Sí, es un gran estudio.

Beto
De verdad que lo es. Realizaron una encuesta exhaustiva a 868 personas que clasifican como "científicos que programan".

Alicia
Lo cual es una distinción importante.

Beto
Muy importante. Así que nuestra misión en este análisis profundo es descubrir cómo la IA generativa está transformando la investigación científica desde sus cimientos. Vamos a ver qué significa para la calidad de los descubrimientos en los que confiamos. Y por qué sentirse increíblemente productivo en el trabajo podría en realidad ser una enorme señal de alarma.

La Paradoja de la IA en Programación Científica

Alicia
Oh, absolutamente. Porque históricamente, la comunidad científica ha tenido muchos problemas con la validación del software. Es un punto débil bien documentado.

Beto
Porque son científicos, no desarrolladores.

Alicia
Claro. Los incentivos en la ciencia están estructurados en torno a publicar artículos, no a mantener repositorios de software robustos. Así que estamos tomando una población que ya tiene dificultades para probar sistemáticamente su código. Y les estamos entregando una herramienta capaz de generar enormes cantidades de código, no probado, en cuestión de segundos.

Beto
Bien, vamos a desenmarañar esto mirando quién sostiene exactamente esa herramienta. Cuando los investigadores dicen “científicos que programan”, las demografías de la encuesta muestran una distribución increíblemente diversa.

Alicia
Sí, no es solo informática.

Beto
Para nada. Hablamos de gente de las ciencias de la vida, ingeniería, ciencias sociales. Lo crucial a entender aquí es que la gran mayoría de estas personas no son ingenieros de software profesionales.

Alicia
No, no lo son.

Beto
Son asistentes de investigación de posgrado, postdocs y docentes que usan el código puramente como un medio para un fin.

Alicia
Pues la demanda de procesamiento de datos en la ciencia moderna ha superado por completo la formación real que reciben estos científicos. Quiero decir, piensa en un biólogo marino hoy. Podría recopilar terabytes de datos acústicos del fondo del océano. Para darle sentido, literalmente tiene que enseñarse Python o R.

Beto
Porque no lo aprendió en la clase de biología.

Alicia
Exacto. Informan educación formal y desarrollo de software inadecuados. Porque su experiencia principal es la biología. No la informática. Básicamente están parchando scripts solo para poner sus datos en un formato legible.

Beto
Así que si queremos entender el impacto de la IA generativa en la ciencia, realmente tenemos que mirar las herramientas específicas que estos expertos de dominio están adoptando. Y los datos muestran que el uso es muy heterogéneo, pero está fuertemente sesgado hacia científicos en etapas tempranas de su carrera.

Alicia
Oh, por lo menos sesgado.

Beto
Sí, los asistentes de investigación de posgrado son los adoptantes más numerosos. La encuesta reveló una relación inversa directa entre la experiencia en programación y el uso de IA.

Alicia
Lo cual es muy revelador.

Beto
Exacto. Es decir, cuantos menos años de experiencia programando tiene alguien, con más frecuencia depende de las herramientas de IA generativa.

Alicia
Pues claro, cuanta menos competencia tenga alguien con la mecánica real de codificar, más atractivo es externalizar esa carga cognitiva, ¿no?

Beto
Tiene todo el sentido.

Alicia
Y las elecciones que hacen sobre qué herramientas de IA usar son profundamente reveladoras. Hay una enorme preferencia por los chatbots de propósito general frente a herramientas realmente construidas y optimizadas para desarrolladores de software.

Beto
Y esta es la parte que cambió completamente mi visión de todo el asunto. Tenemos un 77.5% de estos científicos confiando en herramientas como ChatGPT.

Alicia
Que es simplemente un chatbot web estándar.

Beto
Exacto. Y es el favorito abrumador con un 64.2%. También están usando Google Gemini y Claude. Y acceden a estos modelos de IA a través de un navegador web estándar.

Alicia
Sí. Simplemente una pestaña en Chrome o Safari.

Beto
Sí. Solo el 14.4% de estos científicos están usando herramientas integradas dedicadas para desarrolladores, como GitHub Copilot o Cursor.

Alicia
Y la demografía de esa división cuenta una historia profunda sobre la computación científica.

Beto
Oh, totalmente.

Alicia
Y porque ese 14.4% que usa herramientas dedicadas para desarrolladores, son predominantemente hombres en casi un 73%.

Beto
Sí.

Alicia
Poseen altos niveles de experiencia en programación y están muy concentrados en informática y servicios de información.

Beto
Básicamente, gente de software usando herramientas de software.

Alicia
Exacto. Mientras tanto, los usuarios de los chatbots de propósito general están mucho más repartidos por género. Tienen muchos menos años de experiencia programando y están distribuidos en campos como ciencias de la vida, psicología, química.

Beto
Honestamente es como hacer una cirugía delicada usando una navaja suiza. Solo porque está en tu bolsillo y ya sabes cómo abrirla.

Alicia
Esa es una gran metáfora.

Beto
Exacto. En lugar de usar un bisturí quirúrgico especializado, simplemente porque el bisturí requiere formación especializada para saber siquiera cómo sostenerlo.

Alicia
Exacto. Tienes que aprender primero a usar el IDE.

Beto
Exacto. Tienes biólogos copiando y pegando código de análisis de datos muy complejo entre ventanas del navegador. En lugar de tener una IA integrada directamente en su entorno de programación real, donde podría ver las estructuras de datos.

Alicia
Lo fascinante aquí es que estos científicos dependen de herramientas que por casualidad soportan programación en lugar de herramientas diseñadas específicamente para ella.

Un chatbot web está fundamentalmente diseñado para mantener una conversación. Quiero decir, claro, puede generar código en Python, pero no está integrado en el sistema de archivos del usuario.

Beto
No puede ver los archivos reales.

Alicia
Cierto. No puede ejecutar comandos de terminal de forma nativa para probar si el código funciona. No entiende la arquitectura más amplia del proyecto de investigación de la forma en que lo hace un entorno de desarrollo integrado (IDE).

Beto
¿Así que está ciego al contexto?

Alicia
Totalmente ciego. Pero si miramos el contexto más amplio de cómo se forman los científicos, este comportamiento tiene perfecto sentido. Si nunca recibiste formación formal en arquitectura de software, ni siquiera pensarías en buscar una herramienta diseñada para integrarse con esa arquitectura.

Beto
Cierto. No sabes lo que no sabes.

Alicia
Exacto. Solo quieres una ventana de chat que escupa un script para finalmente ejecutar tus datos e irte a casa.

Beto
Pero si estás sacando código de un chatbot construido para conversación, ¿cómo validas que el código realmente procesa los datos correctamente? Quiero decir, estábamos hablando de programadores inexpertos que dependen de bots de propósito general.

Alicia
Que es una combinación arriesgada.

Beto
Extremadamente. Y esto nos lleva a un hallazgo contraintuitivo en el artículo sobre cómo estos científicos perciben su propia productividad.

Alicia
Sí, la productividad percibida es clave aquí. Para medir esa percepción, los investigadores utilizan la escala SPACE.

Beto
Cierto.

Alicia
Es un marco establecido para medir la productividad percibida en diferentes dimensiones. Entonces "satisfacción" ("Satisfaction"), "desempeño" ("Performance"), "actividad" ("Activity"), "comunicación" ("Communication") y "eficiencia" ("Efficiency").

Beto
Entendido.

Alicia
Exacto. Querían una forma estandarizada de ver quién se sentía más productivo al introducir la IA generativa en su flujo de trabajo.

Beto
Pero antes de poder medir el impacto de la IA en la productividad, realmente tuvieron que establecer una línea de base sobre cómo estos científicos escriben código en primer lugar.

Alicia
Cierto. ¿Cuáles son sus hábitos?

Beto
Sí. Así que miraron la adopción de prácticas formales de desarrollo de software. Hablamos de cosas como control de versiones, revisión de código y pruebas sistemáticas del código. Específicamente, pruebas unitarias, pruebas de regresión, y pruebas del sistema.

Alicia
Y la adopción de esas redes de seguridad fundamentales es alarmantemente baja en la comunidad científica.

Beto
Da miedo.

Alicia
Así es. Aproximadamente el 65% de los científicos encuestados estaba familiarizado con control de versiones, como usar GitHub, para rastrear cambios en sus scripts, a lo largo del tiempo.

Beto
Bueno, eso no está mal.

Alicia
No, pero aquí está el problema. Casi una quinta parte de todo el grupo no estaba familiarizado con ninguna práctica formal de desarrollo. Ninguna.

Beto
¿En serio, un 20%?

Alicia
Sí. Y la integración continua es el ejemplo más claro aquí. En la industria tecnológica comercial, la integración continua es una práctica estándar. Es donde el código se prueba automáticamente en una canalización cada vez que se hace un cambio.

Beto
Cada vez.

Alicia
Claro. Pero entre los científicos, solo el 26.3% siquiera había oído hablar del concepto.

Beto
Vaya. Así que tienes a toda una generación de investigadores básicamente volando sin red.

Alicia
Prácticamente.

Beto
Y los investigadores descubrieron esta paradoja central en los datos. La productividad percibida con la IA generativa está negativamente asociada, tanto con la experiencia en programación, como con el uso de esas prácticas formales de desarrollo.

Alicia
Sí, esa es la parte salvaje.

Beto
Exacto. Las personas que se sienten más productivas usando IA son las que tienen menos experiencia y utilizan menos controles de seguridad.

Alicia
El efecto de interacción en los datos lo ilustra de forma preciosa, honestamente. Para los científicos que utilizan intensamente pruebas y revisiones de código obligatorias, su nivel de experiencia no cambia drásticamente cómo se sienten productivos con la IA.

Beto
Porque aún tienen que hacer todas las pruebas.

Alicia
Exacto. El gráfico de su productividad percibida se mantiene relativamente plano independientemente de su formación. Pero para los científicos que omiten por completo los controles de seguridad, tener menos experiencia conduce a un pico vertical masivo en la sensación de productividad.

Beto
¿Entonces qué significa todo esto? Quiero decir, ¿estos científicos junior realmente están desbloqueando algún secreto para hacer tres veces más ciencia? ¿O estamos viendo simplemente el efecto Dunning-Kruger traducido a código Python?

Alicia
Esa es la pregunta del millón.

Beto
Porque mi sospecha es que se sienten súper productivos simplemente porque están saltándose la parte más dura y que consume más tiempo de la programación. Que es el proceso agonizante de asegurarse de que el código realmente hace lo que matemáticamente se supone que debe hacer.

Alicia
Pues el artículo tiende fuertemente hacia tu sospecha.

Beto
Lo sabía.

Alicia
Sí. Referencian investigaciones previas de Prather y colegas para contextualizar esto. Introducen este concepto llamado "la ilusión de competencia".

Beto
La ilusión de competencia. Me gusta eso.

Alicia
Sí. Básicamente, cuando un programador novato lucha con un problema y un chatbot escupe al instante un bloque de código limpio y bien formateado, se ve increíblemente autoritario.

Beto
Parece magia.

Alicia
Exacto. Se siente como una victoria enorme. Entonces el novato sobreestima su propia comprensión de ese código generado. Y, en consecuencia, sobreestima su propia habilidad para programar.

Beto
Vaya.

Alicia
Sí. Las prácticas formales como las pruebas unitarias o las revisiones de código obligatorias introducen la fricción necesaria en el flujo de trabajo.

Beto
Te ralentizan.

Alicia
Te obligan a disminuir el ritmo y proporcionan una comprobación de la realidad rigurosa. Sin esos bucles de retroalimentación, un usuario puede confundir sin esfuerzo la generación rápida de código con un progreso riguroso y científicamente sólido.

Beto
Y esa fricción es, literalmente, lo único que separa una idea teórica de un error publicado.

Entonces si saltarse esos controles de seguridad, hace que la gente se sienta muy productiva, ¿qué interacción específica con el bot de IA está provocando esa sensación eufórica? La encuesta señaló que en realidad se reduce al volumen puro de código que el usuario está dispuesto a tragarse de una vez.

Alicia
Sí. El predictor más fuerte de una puntuación alta de productividad percibida en toda la encuesta fue el volumen de código generado aceptado de una sola vez.

Beto
Aquí es donde se pone realmente interesante. Los usuarios que reportaron aceptar más de 100 líneas de código a la vez del IA reportaron las puntuaciones de productividad absolutas más altas.

Alicia
Más de 100 líneas.

Beto
Más de 100 líneas. Quiero decir, aceptar más de 100 líneas de código de golpe sin un marco robusto de pruebas es como firmar a ciegas un contrato legal de 100 páginas. Solo porque el abogado parecía simpático y la fuente se veía profesional.

Alicia
Es una analogía aterradora, pero es precisa.

Beto
Te sientes increíblemente eficiente hasta el momento en que te demandan.

Alicia
En la literatura de interacción humano-computadora, este comportamiento se denomina "sesgo de automatización".

Beto
Sesgo de automatización.

Alicia
Sí. Es un fenómeno psicológico bien documentado. Es cuando los usuarios humanos aceptan sin crítica decisiones automatizadas o contenido generado sin verificarlo simplemente porque una computadora sofisticada lo produjo.

Beto
Porque se supone que la computadora es más lista que nosotros.

Alicia
Exacto. Y los riesgos severos en el contexto de la investigación científica no se pueden subestimar aquí. En el desarrollo de software estándar, normalmente tienes un resultado conocido.

Beto
Cierto. Sabes lo que se supone que debe hacer.

Alicia
Exacto. Si estás codificando una app móvil, un botón o se pone azul cuando lo clicas o no. El fallo es inmediatamente visible para cualquiera.

Beto
Pero el código científico no es así.

Alicia
No, a menudo explora territorio inexplorado. Carece de lo que llamamos una "verdad de referencia".

Beto
Porque no sabes lo que dirán los datos del cáncer hasta que el código realmente los analiza. Si supieras la respuesta de antemano, no estarías corriendo el experimento.

Alicia
Exacto. No sabes lo que buscas hasta que lo encuentras. Así que si el código generado por la IA contiene un error lógico muy sutil, es muy probable que no haga caer el programa.

Beto
Simplemente funciona.

Alicia
Podría producir silenciosamente un valor p ligeramente incorrecto, o quizá desplazar una tendencia climática por una fracción minúscula de grado. El artículo cita ejemplos históricos de este fenómeno exacto, señalando que errores, aparentemente menores, e invisibles, en el código científico, han llevado a consecuencias radicales y devastadoras.

Beto
¿Como qué?

Alicia
Pues señalan grandes retractaciones en revistas prestigiosas como el Journal of Clinical Oncology. En esos casos, el código funcionó perfectamente. Produjo un resultado. El resultado fue revisado por pares en base a esa salida. Los hallazgos fueron publicados. Y solo años después un equipo independiente se dio cuenta de que una sola variable estaba invertida en el script original.

Beto
Dios mío. Así que si tenemos un chatbot que alucina y voltea una variable, en lo profundo de un bloque de código de cien líneas, y un estudiante de posgrado que ni siquiera entiende la arquitectura subyacente simplemente copia, pega y publica los resultados ...

Alicia
Estamos construyendo una casa de naipes.

Beto
Una casa de naipes total.

Alicia
Si conectamos esto con la foto más amplia, destaca una vulnerabilidad sistémica profunda. El trabajo mismo que la IA generativa hace más crítico, que es evaluar la solidez, la lógica matemática y la absoluta corrección de software complejo, es precisamente el área donde el desarrollo de software científico históricamente ha tenido más problemas. Básicamente estamos inundando un ecosistema ya frágil con generación no verificada a alta velocidad.

Beto
Y ver esa vulnerabilidad desplegarse en tiempo real explica perfectamente la resistencia que vemos en los datos. Porque dados estos riesgos masivos para la integridad de la investigación científica, no todo el mundo está subiendo ciegamente al carro de la IA, ¿cierto?

Alicia
Cierto, definitivamente no todo el mundo.

Beto
Una porción significativa de la comunidad científica está rechazando activamente estas herramientas.

Alicia
Sí, alrededor de una cuarta parte de los encuestados en la encuesta nunca probó la IA generativa, o la probó y la abandonó intencionalmente.

Beto
Uno de cada cuatro.

Alicia
Sí. Los investigadores realmente quisieron entender los mecanismos que impulsan esta resistencia, así que codificaron cualitativamente 210 respuestas abiertas de estos no adoptantes. Y los temas que surgieron proporcionan una contra-narrativa brillante al bombo publicitario de la productividad sin fin.

Beto
Hablemos de esos temas. Porque el primero, que fue el más común empatado, con un 21.4% de las respuestas, fue un deseo feroz de autosuficiencia.

Alicia
Sí.

Beto
Estos científicos albergan un profundo miedo existencial a la pérdida de habilidades. Y pensemos en cómo un doctorando realmente desarrolla experiencia durante un programa de cinco años. Son esas horas agonizantes depurando un script las que realmente les enseñan los contornos de su propio conjunto de datos.

Alicia
Esa lucha es el punto.

Beto
Exacto. Un encuestado articuló que prefería comprender profundamente el código que escribe. Sabe que fundamentalmente dejará de aprender la metodología si un chatbot simplemente genera la respuesta por él. Ven la lucha de la programación como el mecanismo literal para entender su propia investigación.

Alicia
Bueno, sí. Un científico no puede defender eficazmente una tesis doctoral, o responder preguntas en una conferencia sobre un artículo publicado, si no comprende íntimamente la metodología.

Beto
Sí, se quedarían paralizados.

Alicia
Exacto. Y en la ciencia moderna, el código es la metodología. Si externalizas la lógica a una máquina, básicamente cortas tu propia conexión intelectual con el descubrimiento.

Beto
Vaya. Bien. Y empatado en ese puesto superior, también representando el 21.4% de los no adoptantes, estaban las preocupaciones éticas.

Alicia
Esto es grande.

Beto
Sí. La encuesta capturó un amplio abanico de objeciones específicas. Varios científicos señalaron los enormes impactos ambientales de entrenar y consultar estos grandes modelos de lenguaje. Estaban sopesando activamente la considerable huella de carbono contra la cantidad marginal de tiempo que podría ahorrarles un martes cualquiera.

Alicia
Que es una forma muy científica de verlo.

Beto
Claro, sopesando las variables. Otros expresaron una profunda desconfianza fundamental hacia las empresas de IA respecto a la infracción de derechos de autor. Llamaron explícitamente inmoral la práctica de raspar internet para datos de entrenamiento.

Alicia
Esas respuestas muestran que un segmento de la comunidad científica está evaluando la IA no solo como una utilidad estrecha, sino como parte de un ecosistema global y ético mucho más amplio.

Beto
Sí.

Alicia
Pero, ya sabes, yendo más allá de la filosofía y la ética, los restantes no adoptantes citaron razones mecánicas y profundamente prácticas para rechazar la tecnología.

Beto
Sí, lo funcional. Casi el 20% citó una ineficiencia severa, y otro 19% señaló problemas de exactitud. Informaron que intentar usar estas herramientas en realidad desplomó su productividad.

Alicia
Les hacían más lentos.

Beto
Exacto. Compartieron historias de la IA escribiendo código usando APIs alucinadas. Imagínate trabajar en un campo altamente especializado, como dinámica cuántica de fluidos. La IA podría generar con seguridad un script que llame a una función llamada calcularViscosidadCuántica.

Alicia
Suena súper real.

Beto
Lo formatea de forma hermosa. El único problema es que la función simplemente no existe en ninguna librería real de software.

Alicia
Correcto. Un encuestado detalló explícitamente cómo el tiempo que gastaban buscando esas alucinaciones y depurando errores lógicos sutiles tomaba significativamente más tiempo que simplemente abrir un libro de texto y escribir el código desde cero.

Beto
Entonces, basándonos en estos no adoptantes, me parece que el tiempo supuestamente ahorrado por la IA generativa en realidad no desaparece. Simplemente se desplaza secretamente a la fase de depuración. Es decir, estamos tomando el tiempo que antes pasábamos escribiendo código y obligando a los científicos a gastarlo desenredando código espagueti complejo y nicho escrito por una máquina. ¿Suena bien eso?

Alicia
En realidad, la evidencia empírica está comenzando a alinearse con tu teoría sobre eso.

Beto
¿De verdad?

Alicia
Sí. Los autores destacan un experimento aleatorio conducido por investigadores en Anthropic, que por cierto es en sí misma una desarrolladora importante de modelos de lenguaje grande.

Beto
Cierto. Ellos crearon a Claude.

Alicia
Exacto. Y ese estudio encontró que proporcionar asistencia conversacional de IA a programadores puede en realidad perjudicar su comprensión conceptual de la base de código. Puede degradar sus habilidades para leer código y dañar gravemente su capacidad de depuración, todo sin aportar ganancias de eficiencia estadísticamente significativas en promedio.

Beto
Espera. ¿Así que los vuelve peores depurando y ni siquiera los hace más rápidos?

Alicia
Eso es lo que sugieren los datos. Además, para los paquetes científicos altamente nicho de los que dependen estos investigadores, como bibliotecas matemáticas o físicas especializadas, los modelos de IA simplemente no están entrenados de forma suficientemente profunda.

Beto
Porque es demasiado nicho.

Alicia
Correcto. El volumen de datos de entrenamiento para una biblioteca astronómica nicho es infinitesimal comparado con los datos para construir, digamos, un sitio básico de comercio electrónico. La IA fundamentalmente carece del contexto, así que simplemente adivina.

Beto
Y suena increíblemente confiada cuando adivina.

Alicia
Adivina incorrectamente con suprema confianza. Y el científico pierde cuatro horas tratando de revertir una alucinación.

Beto
Es la economía falsa definitiva. Ahorras 20 minutos generando el borrador inicial, y pierdes dos días enteros, corrigiendo los errores invisibles que corrompen tu conjunto de datos.

Alicia
Exacto. Y esto plantea una pregunta importante sobre la futura arquitectura de nuestra infraestructura científica. Si los modelos de IA no entienden la física subyacente de la ciencia nicho, y los científicos novatos no comprenden completamente la lógica del código generado, ¿dónde reside la experiencia real?

Beto
Vaya. Parece que la experiencia simplemente flota en algún lugar del vacío, entre el prompt y la salida, que es literalmente el último lugar donde quieres que viva la metodología para investigación crítica sobre el cáncer.

Alicia
Sí, es bastante preocupante.

Beto
Si eres un estudiante armando tu primer script en Python para un laboratorio, un profesional que gestiona un equipo de investigadores, o simplemente alguien que depende de la medicina moderna y de datos climáticos, este análisis profundo revela una verdad vital sobre la era en la que estamos entrando.

Alicia
Lo revela.

Beto
La velocidad pura de la creación automatizada está actualmente superando a nuestros sistemas humanos de validación. Estamos construyendo la infraestructura del mañana, más rápido de lo que podemos inspeccionarla.

Alicia
Y realmente necesitamos inspeccionarla.

Beto
Definitivamente. Estar verdaderamente bien informado hoy significa reconocer que la sensación de productividad rápida es fundamentalmente diferente de la realidad de la precisión rigurosa.

Alicia
Quiero dejarte con el pensamiento final para ponderar, en realidad, una implicación que se extiende mucho más allá de los hallazgos de esta encuesta específica.

Beto
Adelante, por favor.

Alicia
Bueno, la gran mayoría de los científicos están conduciendo su investigación usando herramientas propietarias y de código cerrado como ChatGPT o Claude. No están usando modelos de código abierto donde los datos de entrenamiento y los mecanismos puedan ser inspeccionados independientemente por la comunidad científica.

Beto
Correcto. Está todo cerrado.

Alicia
Exacto. Así que si los descubrimientos científicos del mañana, los modelos climáticos fundamentales, los avances médicos avanzados, los nuevos materiales, si se construyen sobre código generado por algoritmos corporativos de caja negra que pueden cambiar sus pesos internos y comportamientos de la noche a la mañana sin advertencia pública, ¿qué pasa con el principio central de la reproducibilidad científica?

Beto
Oh, vaya. Porque la herramienta en sí cambia.

Alicia
Sí. Si un algoritmo se actualiza en un servidor en Silicon Valley, el mismo prompt exacto de un científico podría producir código ligeramente distinto, con fallos distintos, mañana. Si no podemos ver el funcionamiento interno de la herramienta y no podemos garantizar su consistencia a lo largo del tiempo, ¿podemos confiar verdaderamente en la ciencia que ayuda a construir?

Beto
Esa es una pregunta enorme y pesada que la comunidad científica tendrá que responder muy pronto.

La próxima vez que leas un titular sobre un repentino gran avance científico o una predicción radical nueva sobre los océanos, tómate un momento para considerar la capa invisible de software debajo, y al estudiante de posgrado, armado con un navegador web, y un chatbot, que podría haberlo generado.

Muchas gracias por acompañarnos en este análisis profundo. Sigue cuestionando la herramienta invisible que está dando forma a nuestro mundo. Recuerda que la velocidad no sustituye a la comprensión, y nos vemos la próxima vez.