Mostrando entradas con la etiqueta DeepSeek. Mostrar todas las entradas

viernes, 18 de septiembre de 2026

DeepSeek-V4.1-Flash - Informe técnico

La fuente proporcionada detalla el modelo DeepSeek-V4.1-Flash, una IA multimodal alojada en Hugging Face que admite entradas de imagen y texto. Esta documentación técnica destaca que el modelo utiliza precisión de 8 bits y el formato fp8 para mejorar la eficiencia en las tareas de generación de texto. Los desarrolladores pueden implementar el modelo a través de diversas plataformas, como vLLM y SGLang, que facilitan su ejecución local mediante Python o Docker. La página también proporciona acceso a un informe técnico completo e instrucciones específicas para realizar llamadas a la API del servidor del modelo. En definitiva, la información sirve como guía práctica para integrar e implementar este modelo transformador de alto rendimiento en diversos entornos computacionales.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression". Por el equipo de investigación de DeepSeekAI. Publicado el 17 de Septiembre de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Imagina entonces un conglomerado tecnológico masivo, digo, solo un conglomerado tecnológico multimillonario, el tipo de almacenes gigantescos, centros de datos, financiación interminable.

Alicia
Sí. Y tienen la primera opción sobre todas las GPUs Nvidia más avanzadas y de vanguardia.

Beto
Exacto. Ahora, quiero que imagines un azaroso desfavorecido, como un laboratorio chino más pequeño con una fracción del tamaño del equipo, acceso restringido al hardware y definitivamente sin un pozo sin fondo de financiación para cómputo.

Alicia
Naturalmente pensarías que el gigante tecnológico masivo gana esa carrera siempre.

Beto
Claro. Pensarías que es una victoria garantizada.

Pero mientras hoy nos sumergimos en cómo ese azaroso desfavorecido logró superar a los mayores jugadores del mundo.

Alicia
Honestamente, es un escenario fascinante de David contra Goliat. Estamos viendo una clase magistral y optimización de software hoy. Porque cambia por completo la perspectiva sobre cómo construimos la inteligencia artificial. Se alejaron de simplemente usar la fuerza bruta del hardware para reimaginar completamente la arquitectura desde cero.

Beto
Así que nuestra misión para esta inmersión profunda es desempacar este nuevo modelo DeepSeek V4.1 Flash y las estadísticas sobre el rendimiento son simplemente asombrosas.

High-Efficiency_AI_Model_Engineering_1024.png
DeepSeek V4.1 Flash: La Ingeniería de la Hiper-Eficiencia

Alicia
"Asombrosas" es la palabra correcta.

Beto
Estamos hablando de un modelo multimodal Mixture of Experts (MoE) con 552 mil millones de parámetros. Y puede procesar hasta 1 millón de tokens de contexto.

Alicia
Correcto. Lo cual es enorme.

Beto
Es gigantesco. Y hace todo esto mientras rompe por completo los requisitos normales del hardware.

Alicia
Sí.

Beto
Para ustedes que escuchan, aquí está por qué esto realmente importa. Todos queremos agentes de IA que puedan trabajar de forma autónoma durante días.

Alicia
Exacto. Es el Santo Grial.

Beto
Queremos una IA que pueda ingerir bases de código masivas o procesar miles de documentos financieros densos sin congelarse, o costar una fortuna para funcionar.

Alicia
Y DeepSeek acaba de proporcionar el plano literal de cómo es posible. Su tesis central es brillante porque aborda las realidades físicas del hardware mismo.

En lugar de lanzar más GPUs al problema, DeepSeek logró esto a través de una elegancia arquitectónica pura. Hicieron elecciones que parecían completamente contraintuitivas a primera vista, pero finalmente resolvieron el mayor cuello de botella de la industria hoy.

Beto
Que es la huella del caché KV durante la fase de pre-llenado, ¿verdad?

Alicia
Sí.

Beto
Para entender su genialidad, realmente tenemos que mirar este cuello de botella.

Alicia
Definitivamente. La fase de pre-llenado es esencialmente la fase de lectura. Y el contexto largo requiere mucha memoria para almacenar todas las claves y valores de cada token que la IA lee.

Beto
Correcto. Y dentro de la GPU, tienes memoria de alta capacidad de ancho de banda ("High Bandwidth Memory", o HBM). Es increíblemente rápida. Pero el problema es que tiene una capacidad muy limitada.

Alicia
Correcto.

Beto
Así que en el contexto, que escala hasta un millón de tokens, la HBM se llena instantáneamente.

Alicia
Y cuando la HBM se llena, el sistema tiene que comenzar a descargar ese masivo caché KV a unidades de estado sólido externas.

Beto
Sí, es fácil.

Alicia
Exacto, a través del bus PCIe. Y ahí es donde ocurre el cuello de botella catastrófico. El cuello de botella no es la capacidad de cómputo de la GPU.

Beto
Es el ancho de banda de la memoria.

Alicia
Sí. Cuando el modelo necesita generar el siguiente token, tiene que recuperar todas esas claves y valores desde el SSD, pasarlos a través de la placa base a la HBM, y finalmente al RAM del procesador.

Beto
Quisiera visualizar esto usando una analogía estudiantil.

Alicia
Bueno, me gusta eso.

Beto
Así que la memoria de alto ancho de banda, la HBM, es el escritorio del estudiante. Es súper rápida para tomar apuntes, pero tiene una superficie extremadamente limitada.

Alicia
Claro. Solo puedes meter tantos papeles en un escritorio como quieras.

Beto
Exacto. Así que las unidades SSD externas son como archivadores en otra habitación al final del pasillo. Contienen una cantidad masiva de información, pero tener que ir y volver para revisar tus apuntes lleva una eternidad.

Alicia
Lo cual es terrible para la eficiencia.

Beto
Claro. Si la IA está tratando de procesar un millón de tokens, lo cual es esencialmente semanas de clases, esos apuntes se acumulan y la IA pasa todo su tiempo recorriendo el pasillo en lugar de pensar realmente.

Alicia
Si conectamos esto con la imagen más grande, toda la industria está empujando hacia agentes autónomos que ejecutan tareas largas. Pero este cuello de botella específico del caché KV es el obstáculo principal.

Beto
Porque es demasiada información para mover.

Alicia
Exacto. El volumen abrumador de matrices y las lentas velocidades de transferencia de E/S simplemente matan la eficiencia. Los núcleos de cómputo masivos de la GPU terminan simplemente esperando.

Beto
Oh, vaya. Así que están esperando.

Alicia
Sí. Esperan datos. Literalmente a que las matrices viajen a través de los cables desde el disco duro.

Beto
Okay. Para resolver un problema donde tu IA está básicamente ahogada en sus propios apuntes, DeepSeek hizo algo radical. Básicamente decidieron apagar la mitad del cerebro del modelo durante la fase de lectura.

Alicia
Lo cual suena loco, pero funciona. Introdujeron la arquitectura "codificador-decodificador causal" ("Causal Encoder-Decoder", o CED). En un modelo transformer estándar, cada capa genera su propio caché KV a medida que fluye la información. Pero con CED, el modelo está físicamente dividido.

Beto
Okay.

Alicia
Durante la fase de pre-llenado, la segunda mitad del modelo, el decodificador no hace absolutamente nada. Está funcionalmente apagado. La primera mitad, el codificador procesa toda la entrada, construye la comprensión contextual profunda y genera lo que llaman "el caché KV global".

Beto
Y debido a esa división, el ahorro de recursos golpea instantáneamente a la GPU, ¿verdad?

Alicia
Instantáneamente. Sí.

Beto
Porque durante la fase de decodificación, la fase de escritura, el modelo activa aproximadamente 16 mil millones de parámetros por token. Pero durante la fase de pre-llenado, debido a que la mitad del modelo está en reposo, solo activa unos 8 mil millones de parámetros por token.

Alicia
Exacto. El decodificador simplemente omite generar sus propios apuntes globales y simplemente pide prestado el caché KV global completado directamente del final del bloque del codificador.

Beto
Okay, vamos a desglosar esto porque mi reacción inmediata es, "espera un segundo. Si la mitad del cerebro de la IA omite leer el material fuente por completo, ¿no pierde una gran cantidad de matices?"

Alicia
Esa es la preocupación lógica. Sí.

Beto
Quiero decir, si el decodificador no ha procesado el contexto profundo en sí mismo, ¿cómo sabe lo que está generando realmente? ¿No se vuelve la IA notablemente más tonta?

Alicia
No. Y lo fascinante aquí es entender la diferencia matemática entre el contexto global y local. El decodificador pide prestado ese contexto global, las enormes matrices de claves y valores pesadas del codificador. Pero sigue calculando su propio contexto local usando atención de ventana deslizante.

Beto
Así que todavía está haciendo algo de lectura propia.

Alicia
Claro. Piénsalo como una jerarquía corporativa. Imagina una empresa analizando miles de páginas de informes financieros complejos. No tienes que leer cada página.

Beto
No tiene tiempo para eso.

Alicia
Exacto. Obtienes al analista junior. Esa es la mitad del codificador del modelo para leer todo, procesar los conjuntos de datos masivos y escribir un resumen ejecutivo denso y altamente preciso.

Beto
Y ese resumen es el caché KV global.

Alicia
Exacto. El ejecutivo sénior, que es el decodificador, solo lee ese resumen global para la dirección estratégica amplia.

Beto
Pero cuando es hora de firmar el párrafo específico o escribir una cláusula específica, ese ejecutivo se pone sus gafas de lectura y examina la redacción exacta de esa única página frente a él.

Alicia
Sí. Y esa única página es el contexto local.

Beto
Oh, eso tiene todo el sentido.

Alicia
Así que el decodificador omite los cálculos de atención globales masivos, pero presta extrema atención matemática a los tokens más recientes en su ventana deslizante para ejecutar la escritura perfectamente.

Beto
Así que reducen el cómputo requerido para ingerir documentos a la mitad sin degradar la calidad de la salida real.

Alicia
Exactamente.

Beto
Pero incluso con la mitad del cerebro tomando notas, todavía tenemos una pila masiva de matrices globales y locales para almacenar, ¿verdad? Todavía no hemos resuelto completamente el problema del espacio de escritorio.

Alicia
No, no lo hemos hecho.

Beto
Lo que nos lleva a cómo DeepSeek creó lo que es básicamente una reducción de 437x para su huella de memoria. Los números de compresión en el caché KV global aquí son simplemente asombrosos.

Alicia
Realmente lo son. Para poner las matemáticas en perspectiva, el DeepSeek V1 original requería aproximadamente 390,000 bytes de caché KV por token.

ABeto
Okay, 390,000.

Alicia
Luego el DeepSeek V4 Flash lo redujo a 300-500 bytes.

Beto
Lo cual ya es un salto enorme.

Alicia
Pero el DeepSeek V4.1 Flash requiere unos asombrosos 890 bytes de caché KV global por token.

Beto
Espera, ¿890 bytes?

Alicia
Sí, 800.

Beto
Eso es casi 400 veces más pequeño que la primera generación. Quiero decir, a ese tamaño, garantiza que los nodos globales siempre quepan perfectamente en el escritorio de alta velocidad, la HBM, sin que todo se desborde a los lentos archivadores de SSD.

Alicia
Exacto.

Beto
Pero, ¿cómo se comprime la información tan drásticamente sin perder el significado semántico del texto?

Alicia
Diseñaron un mecanismo llamado "atención dispersa comprimida 2" ("Compressed Sparsed Attention 2", o CSA2), que introduce el concepto de compartición extrema.

Beto
Compartición extrema.

Alicia
Correcto. En un modelo estándar, cada cabeza de atención en cada capa calcula sus propias claves y valores redundantes. Algunas capas se enfocan en la gramática, otras en las relaciones de entidades, pero todas almacenan representaciones independientes masivas del texto fuente.

Beto
Lo que ocupa mucho espacio.

Alicia
Exacto. El CSA2 rompe esa redundancia dándole a las capas tres modos de operación diferentes.

Beto
Okay. El primer modo es el modo completo, ¿verdad? Esta capa hace el trabajo pesado tradicional. Calcula la representación latente completa creando notas totalmente nuevas desde cero. Pero fundamentalmente, también calcula un índice, que actúa como una tabla de contenido muy detallada.

Alicia
Correcto. Así que las capas futuras no tienen que escanear toda la matriz del documento.

Beto
Exacto. Simplemente consultan el índice para encontrar los clústeres semánticos que necesitan.

Alicia
Luego tienes el modo de reindexación. Una capa que opera en modo de reindexación no calcula nuevas representaciones latentes. Simplemente reutiliza las matrices exactas generadas por la capa de modo completo.

Beto
Oh, vaya.

Alicia
Sin embargo, aprende una proyección lineal para crear un índice totalmente nuevo.

Beto
Así que si la capa de modo completo creó un índice basado en fechas cronológicas en el texto histórico, una capa de reindexación toma esas mismas notas base, pero crea un índice basado en, digamos, avances tecnológicos en su lugar.

Alicia
Lo tienes. Mapea una nueva ruta matemática a través del mismo espacio latente sin ocupar nuevo almacenamiento.

Beto
Eso es tan inteligente.

Alicia
Y el modo final es el modo de reutilización, que logra la máxima eficiencia.

Beto
Déjame adivinar, simplemente copia la anterior.

Alicia
Básicamente, sí. Una capa en modo de reutilización crea cero nuevas notas y cero nuevos índices. Esencialmente realiza un mapeo de identidad confiando totalmente en las representaciones que las capas anteriores ya construyeron.

Beto
Así que al mezclar dinámicamente estos tres modos, el volumen total de matrices almacenadas simplemente cae en picada.

Alicia
Cae en picada.

Beto
Pero empujan la optimización aún más, agregaron un guardián llamado "el indexador disperso jerárquico" ("hierarchical sparse indexer").

Alicia
Esta es una de mis partes favoritas.

Beto
Así que al comienzo de la mitad del decodificador, este guardián escanea las notas globales. Si le das a la IA un millón de tokens para leer, este indexador selecciona los 16,000 candidatos más relevantes. Y prohíbe estrictamente a todas las capas subsiguientes mirar el resto.

Alicia
Actúa como un balanceador estricto para los datos.

Beto
Pero espera, tengo que desafiar esto. Si restringes a la IA a solo mirar 16,000 tokens de un millón, ¿no estás rogando prácticamente a la IA que alucine o se pierda detalles críticos?

Quiero decir, ¿cómo puede un guardián en la capa uno saber qué conexiones semánticas la capa 50 va a encontrar relevantes? Eso se siente como tirar el 98% del libro y esperar lo mejor.

Alicia
Suena increíblemente arriesgado. Estoy de acuerdo. Pero lo resolvieron a través de un aprendizaje de representación altamente avanzado.

Beto
Okay. ¿Cómo?

Alicia
DeepSeek entrenó esta piscina de selección de candidatos usando una red de enrutamiento especializada. A través de descenso de gradiente, optimizaron a este guardián para predecir las puntuaciones de atención sin realizar realmente el cálculo del producto punto completo.

Beto
Así que está adivinando, pero con extrema precisión.

Alicia
Exacto. La red de enrutamiento aprende a agrupar los 16,000 tokens más densamente semánticos, perfectamente adaptados a la solicitud del usuario. Es tan altamente preciso que las capas más profundas literalmente ni siquiera se dan cuenta de que falta el resto de la información.

Beto
Eso es salvaje. Literalmente no saben que se ha ido.

Alicia
Claro. Reduce drásticamente el universo de datos que las GPUs deben procesar, ahorrando enormes cantidades de cómputo.

Beto
Okay, así que las notas globales están comprimidas, el escritorio está limpio.

Alicia
Sí.

Beto
Pero todavía tenemos un cuello de botella importante, el contexto local que discutimos antes, la memoria a corto plazo de las conversaciones de múltiples turnos.

Alicia
Sí, el hilo conversacional.

Beto
Claro. Cuando chateas con una IA, guardar ese ida y vuelta de contexto todavía estaba obstruyendo las unidades SSD.

Alicia
Guardar contexto local para cada turno en el SSD es una práctica estándar en la industria. Tienes que hacerlo, para que la IA no pierda el hilo conversacional inmediato.

Beto
Pero recuperarlo crea esa temida latencia, recorriendo el pasillo hasta el archivador.

Alicia
La latencia PCIe. Exacto.

Beto
La solución de DeepSeek a esto se llama "reproducción limitada por límite delimitado" ("SWA bounded replay"). Y es genuinamente impactante. Su solución al bloqueo de la memoria a corto plazo en el disco duro es simplemente borrarla.

Alicia
Puff, se fue.

Beto
Se fue. Cuando la IA termina su respuesta para ti, la memoria a corto plazo de los últimos 128 tokens se evapora. Cuando respondes, la GPU simplemente recalcula esos 128 tokens desde cero, en el momento, cada vez.

Alicia
Lo cual suena completamente al revés.

Beto
Correcto. Aquí es donde se pone realmente interesante. Acabamos de pasar esta inmersión profunda hablando sobre dividir el cerebro y la compartición extrema específicamente para evitar hacer cálculos adicionales. Queremos ahorrar cómputo.

Alicia
Sí.

Beto
Ahora están forzando intencionalmente a la IA a rehacer cálculos desde cero. ¿Cómo tiene sentido hacer exactamente los mismos cálculos dos veces?

Alicia
Lo fascinante aquí es que tienes que mirar la intensidad aritmética cruda de una GPU moderna. Realmente tienes que comparar las dos operaciones.

Beto
Okay, explícalos.

Alicia
Por un lado, tienes la transferencia de datos, tomando datos de la RAM de la GPU, empujándolos a la HBM, luego a través de los carriles PCIe al SSD y finalmente trayéndolos de vuelta.

Beto
Estamos recorriendo el pasillo.

Alicia
Correcto. La latencia de ese movimiento físico se mide en milisegundos. Es dolorosamente lenta para una computadora.

Beto
Okay.

Alicia
Por otro lado, tienes el cómputo puro. Las GPUs modernas son monstruos en la aritmética paralela. A menudo sufren de falta de datos, no de capacidad matemática.

Beto
Interesante.

Alicia
Así que para una arquitectura de GPU moderna, procesar el pase hacia adelante por 128 tokens es una fracción de milisegundo. DeepSeek se dio cuenta de que la matemática es esencialmente gratuita en comparación con el ancho de banda; recalcular esos 128 tokens es en realidad significativamente más rápido que esperar físicamente a que los datos viajen desde el SSD.

Beto
Así que hacer la matemática ahorra tiempo y enormes cantidades de almacenamiento físico.

Alicia
Exacto. Es un intercambio brillante.

Beto
Así que borraron la memoria a corto plazo porque hacer la matemática es más rápido que leer el disco duro. Eso es, eso es genial.

Alicia
Realmente lo es.

Beto
Pero incluso con la memoria completamente despejada, la GPU todavía lucha con la velocidad física de escribir la respuesta y mover los estados intermedios.

Alicia
Correcto. La fase de generación tiene su propia fricción.

Beto
Así que para eliminar toda la fricción dentro de la GPU durante la generación real, agregaron tres componentes suplementarios. Veamos cómo vieron el cuello de botella de la salida, comenzando con la MHC de una pasada.

Alicia
Así que MHC significa "multi-generación de respuestas" ("Multi-Head Cache"). Generar respuestas de IA no es solo una gran ecuación. Involucra mover constantemente valores de matriz intermedios dentro de las diferentes memorias de la GPU.

Beto
Lo que causa atascos de tráfico.

Alicia
Exacto. La MHC de una pasada, alinea matemáticamente estas operaciones, fusionando esencialmente los kernels de atención. Al fusionar las operaciones, la GPU realiza los cálculos mientras los datos aún están en la RAM ultra rápida.

Beto
Oh, así que evita la necesidad de leer y escribir constantemente de vuelta a la HBM, que es ligeramente más lenta.

Alicia
Exacto. Elimina los cuellos de botella de transferencia de datos dentro del chip mismo.

Beto
Luego está la velocidad real de la generación. Los modelos normales producen un token a la vez, comprobando su trabajo linealmente, lo cual es increíblemente lento.

Alicia
Muy lento.

Beto
Para arreglar esto, DeepSeek integró DS Spark.

Alicia
DS Spark cambia por completo la fase de generación al utilizar decodificación especulativa.

Beto
Okay, ¿cómo funciona eso?

Alicia
En lugar de generar un token, pasarlo por todas las capas y luego empezar de nuevo, DS Spark utiliza modelos borrador más pequeños y altamente eficientes para predecir tres o cuatro tokens por adelantado simultáneamente.

Beto
Oh, como un borrador.

Alicia
Correcto. La masa principal del modelo luego verifica esos tokens borradores en paralelo en un solo pase hacia adelante.

Beto
Así que esto permite que el modelo produzca múltiples palabras a la vez.

Alicia
Exacto. Aumenta drásticamente los tokens por segundo de salida sin requerir ningún ancho de banda adicional de memoria.

Beto
Y finalmente, la elección arquitectónica más única para mantener la GPU despejada. El módulo Engram.

Alicia
Sí, el módulo Engram. Esta es una red de memoria separada de 168 mil millones de parámetros.

Beto
Es enorme.

Alicia
Lo es. Pero fundamentalmente, no vive en la costosa y altamente restringida HBM de la GPU. Está físicamente separado, sentado en RAM de servidor estándar y más barato. Su único propósito es memorizar hechos estáticos, fechas históricas, capitales, datos fijos que no requieren razonamiento profundo.

Beto
Es esencialmente un abogado sénior y su asistente.

Alicia
Esa es una forma perfecta de verlo.

Beto
Si estuvieras pagando al abogado sénior, la costosa GPU, cientos de dólares por hora para realizar razonamiento legal estratégico complejo. No quieres que desperdicien su sobrecarga cognitiva memorizando cada cláusula legal escrita.

Alicia
Quieres que su escritorio esté completamente despejado para pensar.

Beto
Exacto. El asistente del módulo Engram sentado en la RAM más barata de la CPU es consultado a través de un mecanismo de recuperación dispersa, solo cuando se necesita información fáctica específica.

Alicia
Correcto. Recupera instantáneamente los hechos fijos. Así que la memoria de la GPU permanece totalmente despejada para el razonamiento puro.

Beto
Aísla perfectamente los parámetros de razonamiento activos de los parámetros de memorización escritos.

Alicia
Cuando combinas todos estos avances arquitectónicos, el split cerebro codificador-decodificador causal, el CSA a la compresión extrema, el SWA como reproducción limitada, la eliminación de memoria a corto plazo, la fusión de kernels, la decodificación especulativa y el descargado de RAM del Engram.

Beto
Es simplemente un Frankenstein de eficiencia.

Alicia
Realmente lo es. Obtienes un sistema que desafía fundamentalmente las leyes convencionales del cómputo de IA.

Beto
Hablemos de los resultados cuando enciendes esta monstruosidad. El DeepSeek V4.1 Flash iguala o supera a modelos fronterizos como GPT-6 Astra, Claude y CyberGym en tablas de clasificación muy rigurosas como LiveBench y Vals Index.

Alicia
Lo cual es una hazaña increíble por sí sola.

Beto
Claro. Pero el costo de ejecutarlo es más de 20 veces más barato que los modelos en segundo y tercer lugar. Y logra más de 200 tokens por segundo, lo que es cuatro veces más rápido que sus competidores más cercanos.

Alicia
La menor latencia de la industria.

Beto
Pero la métrica más profunda que demuestra este cambio arquitectónico se encuentra en la figura dos de su informe técnico, mostrando lo que podemos llamar la curva plana.

ds-v4_1-flash_decode_flops.png
DeepSeek-V4.1-Flash Single Token Decode FLOPS

Alicia
Sí, la figura dos, el gráfico muestra la potencia de cómputo bruta, los FLOPs reales requeridos durante la generación contra el tamaño creciente de la ventana de contexto.

Beto
Así que a medida que escalas el contexto desde un estándar de 4,000 tokens hasta un millón de tokens masivo, que es aproximadamente el tamaño de una base de código mediana, la curva de cómputo de decodificación permanece casi completamente plana.

Alicia
Impresionante.

Beto
Entonces, ¿qué significa todo esto? ¿Cómo es matemáticamente posible una curva plana cuando le estás alimentando datos exponencialmente más grandes?

Alicia
Rompe por completo las leyes normales de escalado de la IA porque desacoplaron el tamaño del contexto del cómputo de generación. Históricamente, los mecanismos de atención escalan cuadráticamente.

Beto
Lo que significa que se vuelve mucho más difícil cuanto más datos añades.

Alicia
Exacto. A medida que añades más tokens, el cómputo requerido para calcular las relaciones explota, pero DeepSeek lo aplanó.

Beto
Vaya.

Alicia
Puesto que el caché KV global es comprimido por el indexador disperso a estrictos 16,000 tokens, y el caché local solo recalcula 128 tokens, la complejidad de la atención está estrictamente limitada.

Beto
Así que la ecuación matemática no sigue creciendo.

Alicia
Correcto. El n en la ecuación ya no es de 1 millón. Está limitado. Lo que esto significa en la práctica es que procesar un documento pequeño de una página ahora tarda a la IA aproximadamente la misma energía de cómputo por palabra que procesar miles de páginas.

Beto
Eso es simplemente increíble.

Recapitulemos este viaje. Comenzamos con el cuello de botella masivo de la IA ahogada en sus propias matrices pesadas de claves y valores. Para solucionarlo, DeepSeek dividió la arquitectura. Así que la mitad del modelo descansa durante la pesada fase de lectura. Diseñaron la compartición extrema de notas y los indexadores jerárquicos para comprimir la memoria global en más de 400 veces, ajustándola por completo a las capas de memoria más rápidas.

Alicia
Movimientos brillantes.

Beto
Eliminaron intencionalmente su propia memoria a corto plazo porque hacer matemática es más rápido que esperar los discos duros lentos. Los kernels fusionados dentro del chip borraban múltiples palabras a la vez y descargaron todos los hechos estáticos a un asistente de RAM más barato.

Alicia
Realmente pensaron en todo.

Beto
Lograron lo imposible, no teniendo el centro de datos más grande, sino entendiendo profundamente los límites físicos del hardware y superando el problema.

Alicia
Y eso nos deja con una pregunta profunda para el futuro de la industria. Durante años, la estrategia predominante de la industria de la IA ha sido la fuerza bruta, asegurar más redes eléctricas, construir centros de datos más grandes y comprar más GPUs.

Beto
Simplemente tirar dinero.

Alicia
Exacto.

Pero DeepSeek acaba de probar que el dominio bruto del hardware no es el único camino hacia la frontera. Si un equipo más pequeño puede lograr este nivel de dominio a través de pura elegancia arquitectónica y optimización de software, ¿qué pasará cuando estos diseños de software hiper eficientes se combinen eventualmente con la próxima generación de hardware masivo?

Beto
Oh, hombre.

Alicia
¿Pertenecerá el futuro de la inteligencia artificial finalmente a las organizaciones con los presupuestos más grandes o a los equipos con los ingenieros más inteligentes?

Beto
Esa dinámica es exactamente lo que hace que este espacio sea increíblemente emocionante de presenciar.

Gracias por acompañarnos en este análisis profundo.

Para ustedes que escuchan, sigan cuestionando el consenso, sigan explorando los límites físicos de la tecnología y los encontraremos en el próximo.

viernes, 3 de julio de 2026

DSpark: El secreto para una IA más rápida y eficiente


Este artículo de investigación presenta DSpark, un marco avanzado de decodificación especulativa diseñado para acelerar la inferencia de modelos de lenguaje a gran escala (LLM) mediante la optimización de la generación y verificación de borradores. Los generadores de borradores paralelos tradicionales suelen presentar problemas con el modelado de dependencias de tokens y una verificación ineficiente bajo cargas de sistema elevadas, lo que conlleva un desperdicio de recursos computacionales. Para solucionar esto, DSpark utiliza una arquitectura semiautorregresiva que combina una arquitectura paralela de alta velocidad con un módulo secuencial ligero para garantizar secuencias de borradores de mayor calidad. Además, implementa un sistema de verificación con programación de confianza que utiliza un planificador con reconocimiento de hardware para ajustar dinámicamente la longitud de los bloques de borrador en función de la capacidad del sistema en tiempo real y la certeza de la predicción. Pruebas exhaustivas en el sistema DeepSeek-V4 demuestran que este método mejora significativamente la velocidad de generación y amplía el límite de eficiencia para entornos de servicio de alta concurrencia. Los autores también han publicado como código abierto el repositorio de entrenamiento de DeepSpec y puntos de control específicos del modelo para apoyar futuras investigaciones de la comunidad.

Enlace al artículo científico, para aquellos interesados en profundizar sobre el tema: "DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation", por Xin Cheng y colegas de DeepSeek. Publicado el 27 de Junio de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Sabes, existe esta forma moderna y muy específica de ansiedad que siento como si todos aceptáramos en silencio ahora.

Beto
Oh, sí.

Alicia
Como cuando escribes una pregunta muy compleja y de múltiples capas en tu asistente de IA favorito. Das "enter", y luego simplemente...

Beto
... esperas.

Alicia
Claro. Miras ese cursor parpadeante y lo ves escupir la respuesta. Como una palabra agonizante a la vez. Honestamente, es como ver a alguien teclear con dos dedos índice mientras tú vas cinco minutos tarde para una reunión, y solo necesitas el resumen.

Beto
Es una experiencia universalmente frustrante. Y la ironía es que, cuando haces eso, estás interactuando literalmente con uno de los sistemas computacionalmente más sofisticados y densos en términos de capacidad de cómputo de la historia humana.

Sin embargo, la experiencia del usuario puede sentirse extrañamente estrangulada, ¿sabes? Como si estuvieras descargando una imagen en internet de dial-up de finales de los 90.

Alicia
Sí, exactamente.

Así que hoy vamos a solucionar esa ansiedad del cursor parpadeante o, bueno, al menos exploraremos cómo los ingenieros detrás de escena lo están solucionando por nosotros.

Beto
Me gusta la idea.

Alicia
Bienvenidos a un nuevo análisis profundo. Hoy tenemos en la agenda un artículo de investigación muy técnico, de vanguardia. Se titula "DSpark: Decodificación Especulativa Confiada con Generación Semi-Autorregresiva".

Beto
Es bastante largo.

Alicia
Lo es. Y está escrito por un equipo de investigadores de la Universidad de Pekin y DeepSeek AI.

Beto
Sí, y sabes qué hace que este artículo en particular destaque en un mar de investigación de IA, no es solo la velocidad bruta que logran alcanzar, aunque veremos que las métricas de velocidad son muy impresionantes.

Alicia
Oh, seguro.

Beto
Es realmente la resolución elegante, casi quirúrgica, del problema del mundo real necesaria para equilibrar esa velocidad fulminante con la precisión, todo mientras aseguran que no derritan accidentalmente una enorme granja de servidores en el proceso.

Alicia
Lo cual siempre es algo positivo.

Así que nuestra misión hoy es descubrir los trucos arquitectónicos brillantes que hacen que la IA sea a la vez cegadoramente rápida e increíblemente eficiente. Vamos a decodificar cómo estos investigadores están rompiendo el límite de velocidad de los modelos de lenguaje grandes para que tú, sentado en tu portátil, no tengas que esperar a ese cursor.

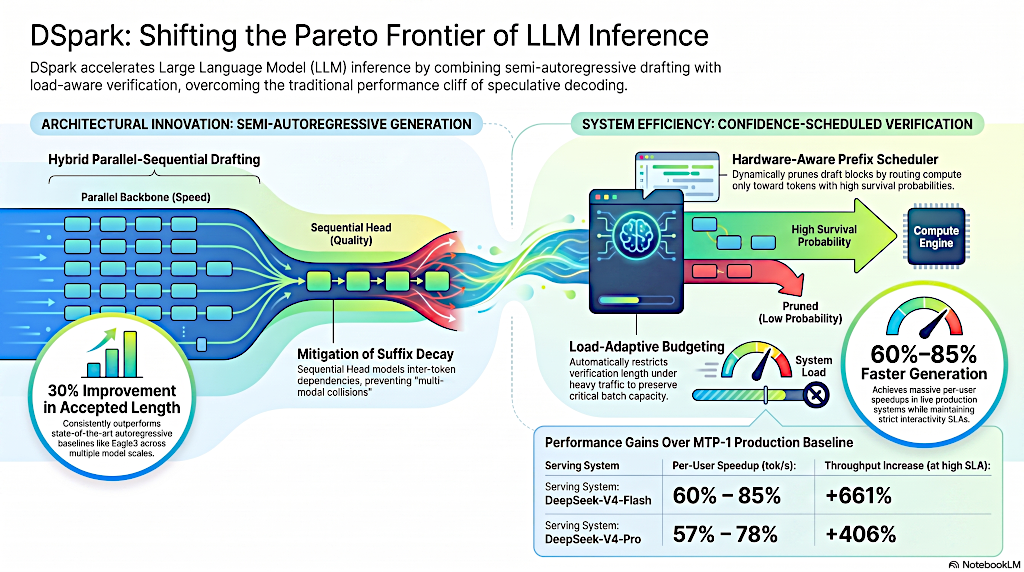
DSpark_LLM_Inf_Arch_Ovw_1024.png
DSpark: Desplazando de la frontera de Pareto de la inferencia LLM.

Pero antes de pasar a las innovaciones específicas de DSpark, necesitamos preparar el escenario un poco. ¿Por qué es que la IA es tan lenta en primer lugar? ¿Qué está pasando realmente cuando ese cursor parpadea?

Beto
Bueno, se reduce fundamentalmente a cómo operan los modelos de lenguaje grandes en su núcleo. Generan texto usando un proceso llamado "generación autorregresiva" ("auto-regressive generation").

Alicia
Okay, autorregresiva.

Beto
Sí. En lenguaje sencillo, eso solo significa que producen exactamente un "token" a la vez. Puedes pensar en un "token" como una sola palabra o, a veces es una parte de una palabra.

Y cada vez que el modelo quiere generar una nueva palabra, tiene que realizar un pase completo hacia adelante ("forward pass") a través de su red neuronal masiva.

Alicia
Pausémos un segundo en el pase hacia adelante. Porque cuando decimos masiva, estamos hablando de miles de millones de parámetros.

Beto
Renderizados en miles de millones, sí.

Alicia
Entonces, ¿cómo se ve eso para la computadora?

Beto
Okay, imagina tener que leer todo un conjunto de enciclopedias solo para decidir la primera palabra de tu oración.

Alicia
Vaya.

Beto
Luego escribes esa palabra. Ahora, para obtener la segunda palabra, tienes que releer todo el conjunto de enciclopedias. Además, la primera palabra que acabas de escribir solo para decidir la segunda palabra.

Alicia
Eso suena increíblemente tedioso.

Beto
Lo es. Enviar los datos a través de miles de millones de neuronas artificiales por cada paso requiere una inmensa cantidad de ancho de banda de memoria.

Alicia
Así que si le pido a una IA que escriba un ensayo de 500 palabras, está haciendo ese cálculo masivo de lectura de enciclopedias 500 veces completamente separadas.

Beto
Ese es el problema central. Exacto. La latencia.

Alicia
Es un retraso que experimentas.

Beto
Claro. El retraso es directamente proporcional a la longitud de la salida. Y como hacer esto una palabra a la vez no aprovecha completamente la potencia de procesamiento paralelo masiva de las GPU modernas, ...

Alicia
... que están diseñadas para hacer miles de cosas a la vez, ¿verdad?

Beto
Exacto. Terminas con una utilización de GPU sorprendentemente baja. Básicamente crea un atasco de tráfico de IA. Y es terrible para tareas sensibles a la latencia como chats en tiempo real o flujos de trabajo complejos y engañosos donde la IA tiene que pensar hacia atrás y hacia adelante consigo misma muy rápidamente para resolver un problema.

Alicia
Así que la industria obviamente sabe que este es un problema. Y sé que no se han quedado quietos. Hay una solución temporal actual que muchos de los mejores modelos están usando ahora, llamada "decodificación especulativa ("speculative decoding").

Beto
Sí.

Alicia
Y me encanta el concepto fundamental de esto porque se siente tan humano para mí.

Beto
Realmente es una solución ingeniosa.

La decodificación especulativa básicamente desacopla la generación del texto de la verificación del texto.

Alicia
Okay, desglosémoslo.

DSpark_architecture.png
Arquitectura DSpark y el ciclo decodificador

Beto
En lugar de depender completamente del modelo grande y pesado, que llamaremos el "modelo objetivo" ("target model"), para hacer todo el trabajo pesado palabra por palabra, introduces un segundo modelo pequeño e increíblemente ligero en el sistema.

Alicia
Y llamamos a esto el "modelo borrador" ("draft model").

Beto
Precisamente. El modelo borrador.

Alicia
Imagino esto como una oficina corporativa. Tienes un ejecutivo brillante pero increíblemente lento y metódico. Ese es nuestro modelo objetivo.

Beto
Correcto.

Alicia
Y el ejecutivo contrata a un interno rápido, quizás un poco imprudente, que es el modelo borrador. Así que el interno escribe rápidamente un párrafo completo de texto, quizás 15 palabras. Luego, el ejecutivo lee todo el párrafo a la vez y simplemente sella "aprobado" en las partes buenas en una sola lectura. Eso es mucho más rápido de que el jefe lo escriba palabra por palabra.

Beto
Esa analogía se sostiene bellamente con la matemática, de hecho. El modelo objetivo verifica el borrador del interno en un solo pase hacia adelante usando un mecanismo llamado "muestreo de rechazo" ("rejection sampling").

Alicia
Okay.

Beto
El ejecutivo esencialmente comprueba el trabajo del interno contra su propia norma interna de calidad. Si la primera palabra coincide con la distribución de probabilidad del ejecutivo, se acepta.

Alicia
Tiene sentido.

Beto
Si la segunda palabra coincide, se acepta. Y esto continúa hasta que el pasante adivina una palabra que el ejecutivo considera demasiado improbable.

Alicia
Y en el momento en que el ejecutivo encuentra una palabra mala, la tacha. Pero no simplemente tacha esa palabra, ¿verdad?

Beto
No, rechaza esa palabra. Y cada palabra que vino después en el borrador.

Alicia
Oh, vaya.

Beto
Sí, porque todas las palabras subsiguientes se basaron en una premisa defectuosa. Pero la belleza de este sistema es que verificar 15 palabras simultáneamente tarda casi exactamente el mismo tiempo que generar solo una palabra desde cero.

Alicia
Espera, ¿de verdad? El mismo tiempo.

Beto
Más o menos, sí. Así que si el interno acierta cinco palabras antes de cometer un error, el sistema acaba de producir cinco palabras perfectas en el tiempo que normalmente tarda en producir una.

Alicia
Eso es increíble.

Beto
Y como el ejecutivo siempre tiene la última palabra, la matemática garantiza que no haya ninguna caída en la calidad de la generación final.

Alicia
Por eso nos importa, ¿verdad? Quiero decir, si has notado que tus herramientas de IA se están volviendo notablemente más rápidas en el último año o así sin que sus respuestas se vuelvan más tontas, este método del interno es exactamente lo que está pasando tras bambalinas.

Beto
Exacto.

Alicia
Pero como este artículo de DSpark señala, el interno tiene algunos fallos serios. Lo que nos lleva a un gran dilema en cómo entrenas y construyes este modelo borrador en primer lugar.

Beto
Sí. La industria se refiere a esto como "el dilema del borrador" ("drafter's dilemma"). Antes de que llegara DSpark, los ingenieros estaban básicamente divididos en dos campos competidores sobre cómo construir un modelo borrador.

Alicia
Okay.

Beto
El primer campo se basaba en borradores autorregresivos ("autoregressive drafters"). Estos son modelos como Eagle-3, por ejemplo.

Alicia
Así que estos son internos que trabajan como el jefe, palabra por palabra, solo con un cerebro más pequeño para moverse un poco más rápido.

Beto
Precisamente eso. Generan el borrador secuencialmente. Y la principal ventaja aquí es la precisión.

Alicia
Claro.

Beto
Porque cada palabra que adivinan se basa en la palabra que literalmente acaban de adivinar un milisegundo antes.

Las oraciones tienen sentido lógico. Pero su latencia crece linealmente.

Alicia
Lo que significa que se vuelven más lentos cuanto más pidas.

Beto
Correcto. Si le pides a este interno que grafique 15 palabras, se necesitan 15 pasos distintos. No puedes pedirles borradores largos, porque simplemente tardan demasiado en generar el texto, lo que frustra por completo el propósito de tener un interno rápido.

Alicia
Okay. Así que si el interno secuencial es demasiado lento, cambiamos al otro extremo. El segundo campo creó "borradores paralelos" ("parallel drafters"), como el modelo DFlash.

Beto
Sí. Y los borradores paralelos son fulminantes. En lugar de ir palabra por palabra, predicen todo el bloque de "tokens" del borrador, digamos, 10 o 15 palabras en un solo pase hacia adelante.

Alicia
Vaya.

Beto
Su tiempo de borrador es básicamente plano. Independientemente de cuántas palabras pidas.

Alicia
Déjame detenerte ahí, porque la mecánica de este tipo me confunde. Si el borrador paralelo está adivinando una oración completa al mismo tiempo, ¿no está básicamente adivinando el futuro con los ojos vendados? ¿Cómo puede saber qué palabra fue la anterior si está generando las 15 palabras simultáneamente?

Beto
Acabas de revelar la debilidad estructural de los borradores paralelos. No pueden modelar las dependencias inter-token.

Alicia
Dependencias inter-token.

Beto
Correcto. No saben cuál será la palabra inmediatamente a su izquierda cuando hagan su adivinanza. Y esto lleva a un fenómeno que los investigadores llaman "colisión multimodal" ("multi-modal collision").

Alicia
Colisión multimodal.

Beto
Sí, lo que causa una rápida decadencia en las tasas de aceptación, cuanto más te adentras en el borrador.

Alicia
La colisión multimodal suena como dos trenes chocando. ¿Cómo se ve eso cuando la IA está tratando de escribir una oración?

Beto
Bueno, veamos cómo se traduce la masa en lenguaje. Imagina que el contexto de una conversación podría ser seguido naturalmente por la frase "por supuesto" o por la frase "no hay problema".

Alicia
Okay.

Beto
Ambas son caminos o modos completamente válidos que puede tomar el texto. Pero como el borrador paralelo no va secuencialmente, tiene que adivinar su mejor opción.

Alicia
Oh, ¿por qué?

Beto
Marginaliza todos los "tokens" anteriores posibles, lo que esencialmente significa que intenta promediar las posibilidades basándose en el contexto general.

Alicia
Espera, creo que veo a dónde va esto. Los promedia y mezcla las frases.

Beto
Lo hace. Puede que tome la palabra de alta probabilidad de "por supuesto" para la posición uno, y la empareje con una palabra de alta probabilidad de "no hay problema" para la posición dos.

Alicia
Oh, no.

Beto
La salida es la frase "por problema".

Alicia
... que es completamente incoherente.

Beto
Exacto. Y cuando el modelo objetivo, el ejecutivo, revisa el borrador, golpea la palabra "problema", la rechaza inmediatamente como sin sentido en ese contexto y bota todo lo que viene después de ella.

Alicia
Así que básicamente desperdicias toda esa potencia de cómputo en un accidente de coche gramaticalmente.

Beto
Sí.

Alicia
Así que estamos atrapados entre una roca y un lugar difícil. El interno autorregresivo es preciso, pero demasiado lento para escribir borradores largos. El interno paralelo es increíblemente rápido, pero se confunde y escribe tonterías si el borrador se pone demasiado largo.

Beto
Aquí es exactamente donde entra DSpark y cambia el paradigma.

DSpark introduce un concepto que llaman "generación semi-autorregresiva" ("semi-auto-regressive generation").

Alicia
Cuando estaba leyendo la sección del artículo, inmediatamente pensé en un corte de pelo. No voy a mentir.

Beto
¿Un corte de pelo?

Alicia
DSpark es esencialmente el "mullet" de la arquitectura de IA.

Beto
Voy a necesitar que me expliques cómo se asemeja una red neuronal a un mullet.

Alicia
Piénsalo. Es negocios por delante con este procesamiento paralelo pesado para mantener el borrador casi instantáneo, pero tiene una pequeña fiesta secuencial en la parte de atrás solo para asegurarse de que las palabras se conecten lógicamente.

Beto
Bueno, aunque dudo seriamente que la fiesta secuencial en la parte de atrás vaya a entrar en una revista de revisión pura pronto. Estás, estructuralmente, correcta.

Alicia
Gracias.

Beto
Pero aterrizémoslo en cómo opera físicamente. Piensa en construir un puente.

Alicia
Okay.

Beto
La columna vertebral paralela de DSpark deja caer todos los enormes pilares de concreto en el río simultáneamente. Esa es la parte del borrador fulminante. Pero si solo dejas caer pilares, no se conectan. Necesitas un equipo para cruzar rápidamente y apretar los pernos secuencialmente para que el puente se sostenga.

Alicia
Okay. Tengo que admitir, el "puente" tiene mucho más sentido que el "mullet". Entonces, ¿cuál es el equipo de aprete de pernos en este sistema de IA?

Beto
DSpark toma una columna vertebral paralela pesada, específicamente una arquitectura D-Flash adaptada para hacer el trabajo pesado del borrador en una pasada.

Alicia
Okay.

Beto
Pero justo al final del proceso, depende de un módulo secuencial increíblemente ligero llamado "cabeza de Markov" ("Markov head"), o para dependencias más largas, una cabeza RNN.

Alicia
¿Qué está haciendo exactamente una cabeza de Markov en ese segundo?

Beto
La cabeza de Markov inyecta un poquito de realidad secuencial en las suposiciones paralelas. Usa un atajo matemático altamente comprimido, lo que el artículo llama "una matriz de factorización de rango bajo" ("low-rank factorization matrix").

Alicia
Okay.

Beto
Usa eso para empujar suavemente las predicciones de palabras de la IA. Llamamos a estas predicciones de palabras "logits". Sesga estos "logits" basándose solo en el "token" que sigue inmediatamente.

Alicia
Solo en el que está justo antes.

Beto
Sí. Así que si la posición uno bloquea aleatoriamente la palabra "por", la cabeza de Markov instantáneamente aumenta la probabilidad de "por supuesto", y suprime la probabilidad de "problema" para la posición dos.

Alicia
Oh, evita la colisión de "por problema".

Beto
Exacto.

Alicia
Y como esta cabeza de Markov es tan computacionalmente diminuta, solo revisar una palabra hacia atrás, hacer la verificación secuencial tarda apenas una fracción de milisegundo.

Beto
La sobrecarga de latencia es prácticamente inexistente. Pero el impacto en la calidad del borrador es masivo.

Alicia
Apuesto que sí.

Beto
El artículo destaca una estadística asombrosa aquí. Al inyectar esta pequeña dosis de lógica secuencial, un modelo DSpark de dos capas muy superficialmente logra superar a una base D-flash de cinco capas mucho más profunda en dominios de matemáticas, código y chat.

Alicia
Espera, ¿un modelo más pequeño venciendo a un modelo más grande solo porque tiene esa pequeña comprobación de realidad secuencial al final?

Beto
Sí.

Alicia
Eso es una locura. Soluciona la colisión multimodal sin sacrificar la velocidad de la columna vertebral paralela. Así que, suena como si solucionáramos al interno rápido y preciso, capaz de escribir borradores largos y coherentes. Todos podemos empaquetar y volver a casa.

Beto
Bueno, si solo estuviéramos hablando de un solo usuario que ejecuta una IA en su portátil personal, sí, el problema estaría resuelto en su mayor parte.

Alicia
Pero lo tenemos ...

Beto
No, tenemos que cambiar de la perspectiva de los datos a la del sistema. En una granja de servidores del mundo real, tratando con millones de solicitudes concurrentes, simplemente revisar borradores largos puede hacer que tu sistema completo colapse.

Alicia
Espera, ¿por qué? Si el interno escribe 15 palabras lógicamente perfectas en un abrir y cerrar de ojos, y el jefe puede leerlas instantáneamente, ¿por qué eso colapsaría el sistema? ¿No resuelve eso el cuello de botella?

Beto
Lo mueve y lo magnifica porque verificar los "tokens" no es gratis.

Alicia
Ahhh.

Beto
Veamos la carga de la verificación. Cada "token" que propone el modelo borrador tiene que ser enviado a través del modelo objetivo masivo para ser verificado. En un entorno de alta concurrencia, lo que significa un servidor lleno que atiende a miles de usuarios simultáneamente. La capacidad de lote (o "batch capacity") de la GPU es tu recurso más preciado.

Alicia
Así que si el interno escribe 15 palabras y el jefe tiene que gastar energía mental leyendo las 15, si el jefe rechaza la palabra número cinco, todavía tuvo que gastar potencia de cómputo leyendo las palabras seis a la quince, solo para tirarlas a la basura.

Beto
Exactamente, ese es el problema. Y en un sistema ocupado, el ciclo de GPU gastado verificando esos "tokens" condenados podría haberse utilizado para procesar una solicitud para un usuario completamente diferente que está esperando en la cola.

Alicia
Oh, vaya.

Beto
Estás literalmente desperdiciando capacidad de lote crítica en "tokens" de alto riesgo.

Alicia
Y el riesgo de que un "token" sea rechazado depende mucho de lo que le pidas a la IA hacer, ¿verdad?

El artículo destaca algunas grandes diferencias de dominio aquí que dictan con qué frecuencia el jefe aprueba el borrador.

Beto
Lo hacen. Los datos altamente estructurados, como escribir código Python, o resolver problemas matemáticos complejos, tienen una tasa de aceptación naturalmente alta.

Alicia
Claro, porque las reglas son estrictas.

Beto
Exacto. El artículo muestra una tasa de aceptación de alrededor del 92% para estas tareas estructuradas. La IA sabe exactamente cómo debe verse la sintaxis de Python, por lo que los borradores paralelos suelen ser correctos.

Alicia
Pero si le pido que escriba algo como una historia creativa, o simplemente tener un chat abierto y sin fin, sobre mi día, ...

Beto
... la tasa de aceptación se desploma. La aceptación de un chat abierto y sin filtro es cercana al 45%.

Alicia
Vaya, 45%. Esa es una caída enorme.

Beto
La distribución de posibles palabras en una historia creativa es simplemente demasiado amplia.

Así que si verificas estáticamente 15 "tokens" de borrador para una solicitud de chat, estás garantizando matemáticamente que desperdiciarás enormes cantidades de potencia de cómputo en "tokens" rechazados.

Alicia
Aquí es donde se pone realmente interesante. ¿Cómo arreglamos al jefe? Porque DSpark introduce otra innovación importante llamada "verificación programada por confianza" ("confidence-scheduled verification").

Beto
Esta es una hermosa pieza de ingeniería de sistemas. DSpark añade una cabeza de confianza ("confidence head") para predecir la probabilidad de supervivencia de cada "token" del borrador.

Alicia
Okay.

Beto
Básicamente pregunta cuáles son las probabilidades de que el jefe apruebe realmente esta palabra específica. Y lo combina con un "planificador de prefijo sensible al hardware" ("hardware-aware prefix scheduler").

Alicia
¿Un "planificador de prefijo sensible al hardware"? Eso son muchas palabras.

Beto
Lo son, pero todo lo que hace es mirar la carga en tiempo real del servidor y cortar dinámicamente el bloque del borrador antes de que siquiera llegue al modelo objetivo.

Alicia
Verás, imagino esto exactamente como un guardia de seguridad en un club lleno.

Beto
¿Cómo es eso?

Alicia
Piénsalo. El club es nuestra GPU. Si el club está completamente vacío un martes por la noche, el guardia dice, claro, dejen entrar a todo el grupo de 15 palabras del borrador, incluso las defectuosas al fondo de la fila.

Beto
Claro, porque no hay penalización.

Alicia
Exacto. El servidor está vacío de todos modos. Pero si es un sábado por la noche y el club está abarrotado con tráfico de alta concurrencia, el guardia se vuelve estricto. Solo los VIP absolutos ...

Beto
... los "tokens" altamente confiados.

Alicia
Sí, los "tokens" altamente confiados que están casi matemáticamente garantizados para ser aceptados, pasan por la puerta para ser verificados. Todos los demás son cortados en la puerta para que el club no viole el código de incendios.

Beto
Eso captura perfectamente la dinámica. El planificador de prefijo sensible al hardware maximiza el rendimiento global del sistema al asignar un presupuesto de verificación solo a los "tokens" con un retorno esperado positivo, basados en la capacidad actual del hardware.

Alicia
Eso es muy inteligente.

Beto
Pero introducir un guardia crea un nuevo problema. Las redes neuronales son horriblemente confiadas.

Alicia
Correcto. La IA siempre piensa que es un VIP, incluso cuando está usando zapatillas en un evento de etiqueta.

Beto
Sí. Una red neuronal cruda podría darle a un "token" una puntuación de confianza del 90%. Pero empíricamente, en el mundo real, solo sobrevive el 60% de las veces.

Alicia
Oh, esa es una gran discrepancia.

Beto
Lo es. Si el guardia confía en esas puntuaciones infladas, serán engañados, dejarán entrar demasiados "tokens", y el sistema seguirá ralentizándose. Para solucionar esto, DSpark usa "escalado de temperatura secuencial" ("sequential temperature scaling", o STS).

Alicia
¿Cómo ajusta STS esas puntuaciones para que el guardia no sea engañado? ¿Cuál es el mecanismo?

Beto
Calcula el producto acumulativo de la probabilidad. Piénsalo como una cadena de confianza.

Alicia
Okay.

Beto
Si confío en la persona A, 90%, y la persona A confía en la persona B, 90%, mi confianza general en la persona B no debería ser 90%.

Alicia
Debería ser menor.

Beto
Debería ser 81%, porque la duda se multiplica.

Alicia
Sí.

Beto
Porque la supervivencia de la palabra "cinco" depende totalmente de la supervivencia de las palabras "uno, dos, tres y cuatro". STS forza al sistema a multiplicar esas probabilidades.

Alicia
Oh, forza a la IA a reconocer que encadenar cinco palabras bastante seguras resulta en una oración altamente incierta en general.

Beto
Exacto. Para encontrar el factor matemático exacto para ajustar esto, ejecutan lo que se llama "una búsqueda en rejilla" ("grid search").

Alicia
¿Qué hace eso?

Beto
Esencialmente, ejecutan miles de simulaciones con datos de validación históricos para encontrar el multiplicador de calibración perfecto. Alinea perfectamente la tasa de supervivencia predicha con la tasa de aceptación empírica real.

Alicia
Eso es brillante.

Beto
Asegura que cuando el guardia ve un pase VIP del 90%, realmente representa una probabilidad del 90% en el mundo real.

Alicia
Así que al guardia se le equipa con un detector de mentiras. Eso es ingeniería increíble.

Okay. Así que tenemos al constructor de puentes semi-autorregresivo haciendo borradores rápidos y coherentes. Tenemos al guardia calibrado protegiendo el servidor de desperdiciar cómputo.

Beto
Correcto.

Alicia
¿Cómo se sostiene toda esta teoría en el mundo real? Porque este artículo no solo lo probó en un entorno de laboratorio prístino.

Beto
No. Lo desplegaron directamente al fuego. Ejecutaron la prueba del mundo real desplegando DSpark dentro del sistema de servicio de DeepSeek v4 bajo tráfico de usuario en vivo.

Alicia
Poner una arquitectura no probada en un entorno de producción en vivo con millones de usuarios es la definición de alto riesgo. Tengo que imaginar que, o colapsó el servidor, o destrozó la línea base antigua. ¿Contra qué lo compararon?

Beto
Lo compararon con su línea base de producción establecida, que era MTP-1.

Alicia
Okay. ¿Qué es eso?

Beto
Es una configuración de predicción de un solo "token". Históricamente, se les obligaba a usar una configuración de un solo "token" porque desplegar un borrador multi-"token" estático bajo alta concurrencia degradaría estrictamente su rendimiento agregado.

Alicia
Completamente debido a ese desperdicio de verificación del que acabamos de hablar.

Beto
Exacto.

Alicia
Así que pusieron DSpark contra un sistema que fue específicamente probado en batalla y optimizado para no colapsar bajo carga pesada. ¿Qué pasó?

Beto
Los resultados fueron asombrosos. Igualó los niveles de rendimiento, lo que significa que los servidores que manejan exactamente el mismo volumen masivo de trabajo.

Alicia
Sí.

Beto
DSpark aceleró las velocidades de generación por usuario en un 60% a 85% en el motor Flash v4.

Alicia
Espera, ¿60 a 85% más rápido para el usuario final?

Beto
Sí.

Alicia
Eso es el cursor parpadeante convirtiéndose prácticamente en un borrón.

Beto
Es un salto masivo hacia adelante.

Pero lo que es aún más impresionante como ingenieros de sistemas es cómo evita lo que llamamos un "acantilado de rendimiento" ("performance cliff").

Alicia
¿El acantilado de rendimiento?

Beto
Sí. En el servicio de LLM existe una frontera de Pareto. Podrías pensarlo como una balanza.

Alicia
Okay, balanza.

Beto
En un lado tienes el rendimiento total del sistema sirviendo a un millón de usuarios a la vez. En el otro lado tienes la velocidad individual asegurando que un usuario específico reciba su respuesta instantáneamente.

Alicia
Claro, quieres servir a un millón de personas, pero no quieres que todos esperen 10 minutos por una respuesta. En sistemas tradicionales, presionar violentamente en un lado tira el otro hacia el aire.

Beto
En sistemas, usa acuerdos de nivel de servicio (SLAs) para garantizar una cierta velocidad mínima a los usuarios. Digamos que el SLA es de estrictos 120 "tokens" por segundo por usuario. Bajo esa restricción estricta, la línea base antigua de un solo "token" se derrumba por completo. Su capacidad se deteriora gravemente porque simplemente no puede seguir el ritmo de la matemática.

Alicia
Pero DSpark, ...

Beto
Porque el Guardia gestiona dinámicamente esa sobrecarga de verificación basada en la carga del servidor, evita esa degradación del rendimiento. Mantiene una capacidad robusta incluso a 120 "tokens" por segundo.

Alicia
Así que no solo se trata de moverse más rápido en la misma carretera. Se trata literalmente de cambiar la frontera de Pareto. Como reescribir la física de la balanza, expandiendo lo que es computacionalmente posible para todo el sistema.

Beto
Desbloquea niveles de rendimiento que antes eran simplemente inalcanzables en entornos de producción.

Alicia
Si alguna vez has visto a tu asistente de IA pausarse a mitad de una oración mientras codifica o volar a través de una compleja solicitud de razonamiento de múltiples pasos, esta gestión invisible del tráfico es exactamente lo que hace posible esa interacción en tiempo real.

Beto
Es realmente una síntesis fenomenal del diseño arquitectónico del lado de los datos y la optimización de hardware del lado del sistema trabajando en perfecto tándem.

Alicia
Vamos a juntar todo esto. Comenzamos con el inmenso cuello de botella de la generación autorregresiva, leyendo la enciclopedia palabra por palabra, dolorosamente lento. Luego exploramos el dilema del borrador. Los internos autorregresivos eran precisos pero demasiado lentos. Los internos paralelos eran rápidos pero se confundían y se aplastaban a sí mismos. DSpark resolvió eso con una arquitectura semi-autorregresiva, fusionando una columna vertebral paralela pesada con una cabeza de Markov ligera para mantener el texto lógicamente sólido.

Beto
Exacto.

Alicia
Y finalmente, para proteger el servidor, introdujeron la "verificación programada por confianza" ("confidence-scheduled verification"), nuestro guardia calibrado.

Beto
El guardia con un detector de mentiras.

Alicia
Sí. Para asegurar que solo los borradores de "tokens" más estadísticamente sólidos consuman un precioso tiempo de GPU.

Beto
Es una solución completa y elegante.

Pero antes de terminar, hay un detalle oculto en el apéndice del artículo que plantea un punto bastante profundo.

Alicia
Oh, ¿de verdad?

Beto
Sí, es sobre lo que los investigadores llaman la "propiedad no anticipatoria" ("non-anticipating property").

Alicia
La propiedad no anticipatoria. ¿Cómo encaja eso en todo esto?

Beto
Bueno, para que todo este marco matemático sin pérdidas funcione, el planificador dinámico, el equilibrador, tiene que tomar sus decisiones de admisión antes de que realmente vea la palabra generada.

Alicia
Espera, ¿de verdad?

Beto
Claro.

Alicia
¿Por qué no puede simplemente mirar la palabra para ver si es buena?

Beto
Si el sistema hace una búsqueda retrospectiva, si mirara la palabra real para decidir si dejarla pasar para la verificación, introduce inadvertidamente un sesgo de selección masivo.

Alicia
Oh, interesante.

Beto
Favorecería sistemáticamente a los "tokens" que conducen a continuaciones seguras y altamente confiadas, lo que fundamentalmente distorsiona la lógica original verdadera de la IA. Haría que la IA sonara genérica.

Alicia
Así que el algoritmo literalmente tiene que vendarse los ojos al futuro para preservar la pureza de su propio proceso de pensamiento.

Beto
Sí. El sistema tiene un diseño asíncrono que forma una barrera causal estricta. Aísla perfectamente el evento de admisión de la realización del "token" futuro.

Alicia
Vaya.

Beto
Literalmente monitorea sus propios límites computacionales y poda impecablemente su propia cadena de pensamiento en tiempo real, solo para sobrevivir al estrés del servidor, todo sin corromper la integridad de la respuesta que está tratando de darte.

Alicia
Eso es, vaya. Plantea una pregunta filosófica fascinante para que la medites. Si los sistemas de IA están siendo diseñados ahora para monitorear proactivamente sus propios límites computacionales y podar perfectamente su propia cadena de pensamiento en tiempo real ciegamente solo para sobrevivir al estrés del servidor, ¿qué sucede cuando esta autoconciencia algorítmica profunda de sus propios límites comienza a dar forma a la lógica real de las respuestas que te da?

Beto
Es un pensamiento profundo para terminar. La arquitectura en sí ya no es solo un recipiente pasivo. Quiero decir, se está convirtiendo en un participante activo en el proceso de razonamiento.

Alicia
Realmente te hace mirar a ese cursor parpadeante un poco diferente, ¿verdad? No es solo pensar, está negociando activamente su propia supervivencia en la granja de servidores antes incluso de hablarte.

Muchas gracias por acompañarnos en este análisis profundo. Sigue explorando las arquitecturas ocultas que impulsan tu mundo, y nos vemos la próxima vez.

jueves, 28 de mayo de 2026

Debate sobre IA: Innovación, desempleo y geopolítica


Este resumen presenta un intenso debate entre Cenk Uygur y Kevin O'Leary sobre el profundo impacto de la inteligencia artificial, el desempleo y la geopolítica. Los participantes discrepan sobre si la IA provocará una depresión económica o, por el contrario, dará paso a una era dorada de productividad e innovación de vanguardia. Uygur advierte que la pérdida masiva de empleos es inevitable y aboga por la regulación, mientras que O'Leary argumenta que la disrupción tecnológica históricamente impulsa la prosperidad estadounidense. La conversación también aborda el conflicto en Oriente Medio, debatiendo específicamente cómo el lobby extranjero y el gasto militar influyen en la política de Estados Unidos. En definitiva, la fuente subraya una creciente división entre las preocupaciones populistas y el optimismo capitalista a medida que el país se acerca a las próximas elecciones.

Enlace a la entrevista de video, de los canales "Diary of a CEO" y "The Young Turks": "EMERGENCY DEBATE: They Are Lying To Us About AI, The Iran War & What Happens Next!". Publicado el 28 de Mayo de 2026.

El resumen, la transcripción, la traducción, y las voces fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.

Escúchalo aquí, mientras lees la transcripción (abajo).

O escúchalo en Spotify.


Transcripción

Alicia
Cuando cambias un interruptor de luz, no piensas inmediatamente en una guerra de drones en el Medio Oriente.

Beto
Definitivamente, no.

Alicia
O en una crisis política en Washington. Simplemente esperas que la luz se encienda y esperas que tu mundo digital simplemente funcione.

Beto
Correcto. Simplemente le pides a una IA que escriba un bloque masivo de código y ¡pum!, está ahí.

Alicia
Exacto. Simplemente aparece mágicamente en la pantalla. Pero quiero decir, esa magia es totalmente una ilusión.

Beto
Bienvenidos todos a un nuevo análisis profundo. Nuestra misión hoy es mapear estas asombrosas colisiones entre la tecnología, la economía y la geopolítica.

Alicia
Sí. Y estamos trabajando con una pila de fuentes realmente fascinante hoy.

Beto
Lo estamos. Es la transcripción de un debate de gran intensidad. Presenta a un CEO prominente actuando como moderador, a un comentarista político progresista y un inversor capitalista multimillonario.

Alicia
Se pone bastante acalorado.

Beto
Oh, muy acalorado. Pero vamos a explorar cómo un centro de datos en el Occidente americano se conecta directamente con el colapso del valor del trabajo humano, la realidad de esta nueva guerra de drones asimétrica y un electorado que está perdiendo rápidamente la fe en el capitalismo mismo. Así que, bien, vamos a desglosar esto.

AI_debate_1024.png
IA & El Futuro: ¿Iceberg Económico o Edad de Oro?

Alicia
Correcto.

Beto
Y mi objetivo aquí es realmente solo sintetizar todo ese ruido del debate y ayudarte a ti, el oyente, a entender por qué estos cambios tectónicos realmente importan para tu cartera y para tu futuro.

Alicia
Sí, porque definitivamente lo hacen. Y creo que tenemos que empezar por la realidad física de la inteligencia artificial, porque hablamos de la IA como si fuera una nube invisible, pero en realidad es una fábrica gigante y hambrienta de energía.

Beto
Oh, sí. Una "fragua" es un marco mucho más preciso para ello.

Alicia
La fragua, un horno forjador de metales, ¿verdad?

Beto
Sí, porque generar inteligencia artificial requiere esta reacción termodinámica masiva. Básicamente estás alimentando cantidades incalculables de electricidad y agua crudas en millones de chips de silicio para forjar inteligencia.

Alicia
Vaya.

Beto
Y nuestras fuentes destacan que la pura escala de esta huella física está chocando contra las comunidades locales en este momento.

Alicia
Sí. El comentarista progresista en el debate menciona Virginia, ¿verdad?

Beto
Exacto. Y la afluencia de centros de datos de IA allí ha tensado tanto la red eléctrica que los costos de energía locales se han disparado hasta en un 30%.

Alicia
30%. Eso es enorme.

Beto
Lo es. Y el mecanismo fundamental aquí es la energía de carga base. Porque, sabes, los centros de datos de IA no se apagan por la noche. Funcionan al 100% de capacidad constantemente.

Alicia
Siempre activos.

Beto
Correcto. Y cuando una red local que fue diseñada solo para la fluctuación residencial normal se ve obligada a suministrar esa extracción masiva constante, bueno, las empresas de servicios públicos tienen que activar energía auxiliar costosa.

Alicia
Y yo supongo que trasladan ese costo directamente al consumidor.

Beto
Lo adivinaste. Así que tienes bibliotecas públicas, iglesias y simples contribuyentes viendo una prima del 30% en sus facturas de servicios públicos.

Alicia
Básicamente solo para subsidiar la capacidad de cómputo de monopolios tecnológicos de billones de dólares.

Beto
Exacto. Pero lo fascinante aquí es que el inversor capitalista concede este punto.

Alicia
Oh, lo hace.

Beto
Sí, reconoce totalmente que simplemente no se puede enchufar un centro de datos de varios gigavatios a una red municipal heredada sin apagones en los condados circundantes.

Alicia
Entonces, ¿cuál es su solución entonces?

Beto
Bueno, señala un proyecto masivo que está construyendo personalmente en Utah. Dice que la infraestructura de IA moderna tiene que traer su propia generación de energía.

Alicia
Okay, eso tiene sentido.

Beto
Sí, su instalación está siendo diseñada no solo para generar su propia electricidad, sino para bombear el exceso de vuelta a la red pública.

Alicia
Wow. Pero, eh, ¿intentar construir esa instalación desencadenó un tipo de desorden completamente diferente?

Beto
Oh, completamente. Desencadenó una guerra de poder geopolítica justo en la junta de zonificación local.

Alicia
Lo cual es increíble de pensar.

Beto
Correcto. El inversor afirma que su proyecto en Utah enfrentó esta oposición local repentina y altamente organizada. Sabes, demandas por derechos de agua, protestas ambientales, disputas de zonificación.

Alicia
Es un muro de trabas burocráticas.

Beto
Exacto. Así que en lugar de solo negociar, contrató auditores forenses para rastrear la financiación de estos grupos locales de base.

Alicia
Siguió el dinero oscuro.

Beto
Lo hizo.

Alicia
Y lo que supuestamente encontraron esos auditores es asombroso porque rastrean el flujo de capital a través de todo este laberinto de empresas fantasma y patrocinadores fiscales.

Beto
Sí, ¿a dónde llevó?

Alicia
Finalmente señaló a fuentes chinas, canalizando dinero a través de una enorme entidad de cobertor sin fines de lucro llamada Airebela.

Beto
¿Airebela, correcto?

Alicia
Sí. Y solo para desglosar cómo funciona realmente ese mecanismo para ti que estás escuchando, un adversario extranjero no simplemente le lanza dinero a un activista local.

Beto
No, eso sería demasiado obvio.

Alicia
Exacto. Escribieron fondos en una enorme red de dinero oscuro 501c4, como Airebela, que luego actúa como una especie de incubadora financiera.

Beto
Correcto. Crea un grupo de defensa local temporal con un nombre de sociedad civil de muy amigable.

Alicia
Sí. Y así, la fuente original del dinero está legalmente ofuscada. Y luego esos fondos se utilizan para contratar abogados ambientales de alto precio para paralizar el centro de datos de IA en años de litigios.

Beto
Es, bueno, la brillantez táctica de esa estrategia es difícil de exagerar.

Alicia
Lo es. ¿Estamos tan enfocados en ganar la carrera geopolítica contra China que estamos ignorando el costo local para los estadounidenses comunes?

Beto
Bueno, esa es la tensión. Porque lo fascinante aquí es que mientras que EE. UU. está atascado en audiencias judiciales municipales por permisos locales, el gobierno chino simplemente opera sin esos puntos de fricción democrática.

Alicia
Correcto.

Beto
La fuente capitalista señala esta métrica profundamente escalofriante. China construyó recientemente 400 gigavatios de energía de carbón en solo 19 meses.

Alicia
¿19 meses? Eso es una locura.

Beto
Sí. Están generando la electricidad necesaria para alimentar la próxima generación de modelos de IA, como su plataforma DeepSeek.

Alicia
Y DeepSeek no es solo otro "chatbot". Quiero decir, si un modelo extranjero tiene acceso a una capacidad de cómputo barata prácticamente ilimitada, mientras que los modelos estadounidenses son estrangulados por, ya sabes, límites de energía locales y demandas de zonificación, ...

Beto
... el modelo extranjero itera más rápido.

Alicia
Exacto. Se adelanta en capacidades de razonamiento puro. Así que el inversor está advirtiendo que si no tratamos nuestra red eléctrica como una cuestión de seguridad nacional, simplemente perdemos la carrera de la IA por completo.

Beto
Lo cual trae una contradicción masiva a colación, honestamente.

Alicia
¿Cómo es eso?

Beto
Bueno, si EE. UU. sufre la tensión de la red, supera la oposición del dinero oscuro y realmente gana la carrera global de la IA, ¿qué le pasa a la economía doméstica que sacrificó para construirla?

Alicia
Oh, man. Esa es la pregunta de los varios billones de dólares.

Beto
Correcto.

Alicia
Básicamente estamos pasando del costo de la energía al valor del trabajo humano.

Beto
Exacto. Así que en un lado del debate, tienes al comentarista progresista confiando en las advertencias de los propios creadores de IA.

Alicia
Como Sam Altman de OpenAI y Dario Amodei de Anthropic.

Beto
Sí. Están pronosticando una tasa de desempleo totalmente plausible del 20% impulsada por la automatización.

Alicia
20%. Eso es nivel de gran depresión.

Beto
Lo es. El progresista esboza este escenario donde las juntas directivas corporativas, que solo están ansiosas por maximizar los precios de las acciones trimestrales, se apresuran a implementar la IA y reducir sus fuerzas laborales de cuello blanco entre un 10 y un 25% de la noche a la mañana.

Alicia
Y la respuesta estándar de la tecnología y la industria a eso es normalmente lo que es el "ingreso básico universal" (IBU), "Universal Basic Income", "UBI".

Beto
Sí. IBU. Simplemente le da a los trabajadores desplazados un cheque gubernamental mensual.

Alicia
Pero la fuente progresista desmantela toda la matemática macroeconómica sobre eso.

Beto
Lo hacen porque piénsalo. Imagina a un desarrollador de software que gana $120,000 al año.

Alicia
Okay.

Beto
Si es reemplazado por un algoritmo y se le entrega un cheque de IBU de, digamos, $36,000 al año, eso no es una red de seguridad.

Alicia
No, eso es una reducción catastrófica del poder adquisitivo.

Beto
Correcto. Y esto toca una teoría llamada "economía de margen medio" ("middle-out economics").

Alicia
Sí. La economía de margen medio se basa en la idea de que la clase media, no los ricos, son los verdaderos creadores de empleo porque su demanda agregada de consumo es lo que impulsa todo el mercado.

Beto
Exactamente, ese es el punto del progresista. Si las corporaciones despiden al 25% de su fuerza laboral de clase media, ¿quién exactamente va a comprar los productos y servicios que están vendiendo esas corporaciones?

Alicia
Nadie. No puedes sostener una economía de consumo sin consumidores.

Beto
Correcto. Las empresas estarían efectivamente torpedeando sus propios flujos de ingresos solo en la búsqueda de ahorros laborales temporales.

Alicia
Pero el capitalista multimillonario en el debate rechaza esto totalmente, ¿correcto?

Beto
Completamente. Desestima todo el pánico como este miedo histérico de que los robots se coman a los niños.

Alicia
"Robots se comen a los niños". Vaya.

Beto
Sí. Mira el arco histórico de la tecnología y argumenta que cada gran disrupción, desde la máquina de vapor hasta Internet, ha creado en última instancia vastas nuevas industrias y trabajos mejor pagados.

Alicia
Correcto. Todo el ángulo del "Destino Manifiesto".

Beto
Exacto. Para ilustrar la escala de la próxima oportunidad, señala iniciativas nuevas masivas, como la directiva de la NASA para construir una base permanente en la luna y el impulso por misiones a Marte rudimentarias.

Alicia
Correcto.

Beto
Argumenta que estas iniciativas requerirán millones de nuevos trabajos altamente técnicos en aeroespacial, manufactura avanzada, e ingeniería de sistemas.

Alicia
Y realmente menciona la predicción de Elon Musk también, ¿correcto?

Beto
Sí. Que estos robots humanoides pronto superarán a los humanos dos por uno. El inversor ve eso como un ejército de mano de obra gratuita, generando riqueza social infinita.

Alicia
Quiero decir, escucho el optimismo, pero hay un brutal problema de transición aquí.

Beto
Oh, definitivamente.

Alicia
Porque eso es un horizonte fantástico de 20 años para un estudiante de posgrado en ingeniería aeroespacial.

Pero el conductor de camiones de 61 años o el trabajador de la línea de ensamblaje en Cleveland que pierda su trabajo mañana ...

Beto
Correcto.

Alicia
No pueden pivotar de repente a la programación de vehículos lunares.

Beto
No, no pueden.

Alicia
El período de transición es donde ocurre la depresión económica.

Beto
Sí. Y sabes, hay una ironía flagrante en nuestras fuentes aquí.

Alicia
¿Qué es eso?

Beto
Los fundadores que están construyendo íntimamente la IA son los que se están preparando para el colapso social. Mientras que los inversores financieros que proporcionan el capital son los que pronostican una utopía económica.

Alicia
Eso es profundo. La desconexión entre los ingenieros y los financieros es simplemente masiva.

Beto
Sí. Pero esta disrupción no está esperando cortésmente en el futuro. La fricción por la energía y el dominio de la IA ya está reescribiendo las reglas del conflicto global en este momento. Actualmente estamos presenciando la mecánica de la primera verdadera guerra tecnológica.

Alicia
Okay, para mapear esto correctamente, necesitamos mirar hacia el Medio Oriente. Y antes de entrar en esto, quiero ser muy clara para ti que estás escuchando.

Beto
Sí, muy importante.

Alicia
Estas fuentes contienen puntos de vista políticos altamente cargados con respecto a Israel, Irán y el gobierno de EE. UU. No estamos tomando partido ni respaldando estas opiniones, pero estamos reportando imparcialmente los argumentos hechos en el material de la fuente para que puedas entender el debate.

Beto
Correcto. Porque para entender la economía subyacente de esta guerra tecnológica, tenemos que rastrear la lógica de ambos argumentos. El contraste mismo es lo que revela el estrés geopolítico más amplio.

Alicia
Exacto. Así que el comentarista progresista argumenta que la participación de EE. UU. en el Medio Oriente es básicamente una guerra de poder encubierta para servir estrictamente a los intereses estratégicos israelíes.

Beto
Sí. Afirma que esta dinámica es sostenida a través de sobornos legalizados en el sistema político estadounidense. Cita específicamente $317 millones en contribuciones políticas de la familia Adelson.

Alicia
Correcto. Y el argumento estratégico allí es que neutralizar a las potencias vecinas asegura un dominio unipolar en la región, lo que requiere mantener al ejército estadounidense permanentemente involucrado.

Beto
E introduce una aplicación aterradora de la IA dentro de este conflicto.

Alicia
Sí, esta parte fue oscura.

Beto
Demasiado. Cita un sistema de ataque de IA israelí interno llamado, "¿dónde está papá?" ("where is daddy")

Alicia
Vaya. Solo el nombre.

Beto
Lo sé. Y esto no es solo un dron con una cámara. El mecanismo aquí es un algoritmo de aprendizaje automático que ingiere miles de puntos de datos dispares.

Alicia
Como, ¿qué?

Beto
Pulsos de celular, metadatos de WhatsApp, cámaras de seguridad, reconocimiento facial, incluso patrones de comportamiento, todo para marcar automáticamente a los militantes sospechosos.

Alicia
Y luego ¿qué hace?

Beto
El sistema supuestamente rastrea a estos individuos continuamente. Y específicamente espera hasta que los datos indiquen que han regresado a sus hogares familiares antes de iniciar un ataque aéreo, lo que obviamente conduce a bajas civiles masivas.

Alicia
Es la automatización de la cadena de muerte, literalmente una máquina que decide cuándo una diana humana es más vulnerable basándose en metadatos.

Beto
Exacto. Pero luego el inversor capitalista mira la misma región geográfica exacta y diagnostica un problema fundamentalmente diferente.

Alicia
Correcto. Ve el conflicto casi exclusivamente a través de la lente del comercio global, el control de recursos, y el suministro de energía.

Beto
Sí. Se enfoca directamente en Irán. Su análisis es que un núcleo de liderazgo de alrededor de 150,000 individuos está oprimiendo sistemáticamente a una población de 100 millones de ciudadanos.

Alicia
Pero el punto de presión crítico que identifica es el estrecho de Ormuz, ¿verdad?

Beto
Sí. Las fuerzas proxy iraníes han bloqueado esencialmente ese estrecho y la matemática económica es devastadora.

Alicia
Porque desviar el envío global está costando un estimado de $210 millones cada día.

Beto
$210 millones cada día. Y esa hemorragia financiera no solo golpea al oeste, China depende del estrecho de Ormuz, por el 48% de todo su suministro de energía.

Alicia
Vaya. Casi la mitad.

Beto
Sí. Así que el capitalista argumenta que la fricción eventualmente forzará al liderazgo de China a intervenir y presionar a Irán simplemente porque el motor de fabricación global no puede sostener ese nivel de interrupción energética indefinidamente.

Alicia
Pero su desglose de la economía militar que está ocurriendo en esa región es lo que realmente expone la vulnerabilidad de occidente.

Beto
Oh, la parte de la guerra asimétrica.

Alicia
Sí. Porque tenemos ejércitos altamente avanzados derribando drones caseros que cuestan aproximadamente $35,000.

Beto
Lo que suena como mucho. Pero en términos militares, eso es prácticamente gratis.

Alicia
Exacto. Estas son armas rudas impulsadas literalmente por motores de cortacésped y construidas con fibra de carbono de catálogo.

Beto
Correcto.

Alicia
Y Estados Unidos está neutralizándolos usando misiles interceptores avanzados que cuestan $2 millones cada uno.

Beto
Es absurdo. Matemáticamente, esa estrategia de defensa simplemente se quiebra.

Alicia
Sí. No puedes ganar una guerra de desgaste cuando tu interceptor cuesta 60 veces más que el objetivo.

Beto
Realmente no puedes. La asimetría está rompiendo fundamentalmente el presupuesto de defensa tradicional.

Alicia
Entonces, ¿cuál es la solución?

Beto
Bueno, la única manera de contrarrestar un enjambre de drones de $35,000 sin ir a la quiebra es desplegar armas de energía dirigida impulsadas por IA o interceptores automatizados.

Alicia
Ah, veo a dónde va esto.

Beto
Correcto. Pero para desarrollar esos sistemas, necesitas una capacidad de cómputo de IA masiva. Para obtener esa capacidad de cómputo, necesitas los enormes centros de datos que discutimos al principio.

Alicia
Y para ejecutar esos centros de datos, necesitas la red eléctrica y los permisos, que están siendo activamente paralizados por dinero oscuro extranjero.

Beto
Exacto. Es un bucle de retroalimentación perfecto e ineludible.

Alicia
Aquí es donde se pone realmente interesante, sin embargo. Ambos lados del debate están de acuerdo en que el cuello de botella en el Estrecho de Ormuz es el punto de estrangulamiento económico que está causando inflación y picos de energía doméstica.

Beto
Sí, están de acuerdo en el cuello de botella.

Alicia
Pero tienen visiones totalmente mutuamente excluyentes sobre quién es responsable de crear el caos geopolítico.

Beto
Correcto. Y cuando tomas ese nivel de inflación global, lo combinas con la amenaza de desempleo masivo de la IA y la colocas directamente sobre los hombros de la clase media estadounidense, el tejido político doméstico comienza a deformarse.

Alicia
Oh, se está deformando rápido.

Beto
Sí. Los datos presentados en el debate muestran una reacción muy marcada por parte del electorado.

Alicia
Las visiones positivas del capitalismo están alcanzando mínimos históricos. Sorprendentemente, el 70% de los demócratas y el 62% de todos los jóvenes estadounidenses ahora ven favorablemente el socialismo.

Beto
Lo cual es un cambio masivo.

Alicia
Lo es. El votante estadounidense está buscando activamente modelos económicos alternativos porque el sistema actual se siente agresivamente hostil a su supervivencia.

Beto
Y el comentarista progresista argumenta que este cambio en las encuestas es solo una consecuencia natural del abandono del libre mercado por parte de EE. UU.

Alicia
Correcto. Caracteriza el sistema actual como "capitalismo de amiguismo" ("crony capitalism"), donde los monopolios corporativos y la ley legal han capturado esencialmente a las agencias reguladoras.

Beto
Sí. Su solución propuesta es el "capitalismo democrático". Señala modelos de Europa del norte donde un proceso democrático robusto controla activamente el poder corporativo y garantiza un estándar básico de vida.

Alicia
También emite una advertencia bastante cruda a la clase política, ¿no?

Beto
Lo hace. Argumenta que los votantes están tan profundamente agotados por políticos que responden a donantes corporativos en lugar de a los constituyentes, que las condiciones están preparadas para una ola populista de derecha.

Alicia
Sí. Nombra específicamente a Tucker Carlson como una figura que podría capturar fácilmente la primaria republicana de 2028.

Beto
Y su lógica tiene sentido. El mensaje anti-corporativo y anti-establecimiento resuena instantáneamente con una clase media económicamente aterrorizada y deprimida.

Alicia
Pero el inversor capitalista se opone a eso totalmente.

Beto
Oh, sí. Cree que la tendencia social en los datos de las encuestas e s solo una fase temporal de la juventud. Y como dice, "analfabetismo económico".

Alicia
Argumenta que los estudiantes universitarios apoyan entusiásticamente el socialismo hasta que entran en la fuerza laboral, reciben su primer cheque de pago y ven una deducción fiscal del 50%.

Beto
Correcto. Cree que la realidad de financiar redes de seguridad social masivas inevitablemente los devuelve hacia el capitalismo.

Alicia
También se basa en gran medida en el concepto de movilidad del capital.

Beto
Sí, este es un punto enorme.

Alicia
Si un gobierno implementa impuestos punitivos sobre los ricos para financiar un IBU o un programa masivo de empleos, la clase capitalista no solo se sienta allí y absorbe la pérdida.

Beto
No, tienen los recursos para cambiar sus impuestos de la noche a la manana.

Alicia
Exacto. Mueven sus activos, sus negocios y su creación de empleo a jurisdicciones con leyes favorables, ya sea a Florida, Texas o Mónaco.

Beto
Como lo formula, "el defecto inherente del socialismo es que eventualmente te quedas sin el dinero de otras personas".

Alicia
Entonces, ¿qué significa todo esto para ti que estás escuchando? Quiero decir, ¿cómo se supone que debemos navegar un futuro donde los extremos políticos se están ampliando justo cuando el mercado laboral se está encogiendo?

Beto
Bueno, si conectamos esto con el panorama general, crea un enfrentamiento fascinante y realmente peligroso.

Alicia
Sí.

Beto
Por un lado, la clase media se está encogiendo, aterrorizada de perder sus medios de vida a un algoritmo y exigiendo protección estatal.

Alicia
¿Y por el otro lado?

Beto
Por el otro lado, las personas que construyen los algoritmos y financian la infraestructura están amenazando con la fuga de capital si son gravados para pagar por las consecuencias sociales.

Alicia
Vaya.

Beto
El miedo económico es el mayor catalizador de la radicalización política. El debate en torno a la elección de 2028 no es solo un desacuerdo político tradicional rojo contra azul.

Alicia
Bueno, es más grande que eso.

Beto
Es una prueba de estrés fundamental del sistema estadounidense. Se trata de si el marco económico puede adaptarse lo suficientemente rápido para proteger a la clase media antes de que, como advierte el progresista sin rodeos, las horquillas proverbiales salgan.

Alicia
Estamos parados directamente en la intersección de fuerzas que definirán el resto de este siglo.

Beto
Lo estamos.

Alicia
Quiero decir, tenemos un auge masivo de infraestructura de IA que requiere poder termodinámico crudo que nuestras redes locales simplemente no pueden manejar.

Beto
Sí.

Alicia
Estamos enfrentando una potencial crisis laboral que enfrenta advertencias económicas apocalípticas contra promesas utópicas de colonias en Marte.

Beto
Es vertiginoso.

Alicia
Y hemos entrado en una nueva era de guerra de drones asimétricas donde los presupuestos de defensa multimillonarios son drenados por motores de cortacésped.

Beto
Exacto.

Alicia
Y todo está culminando en un panorama político cambiante donde el concepto mismo del capitalismo podría estar literalmente en la boleta en 2028.

Beto
Y entender cómo una reunión de la junta de zonificación sobre una red eléctrica se conecta con el mercado laboral global, que luego se conecta con las rutas marítimas militares, esa es la única manera de orientarse en el panorama moviéndose tan rápido.

Alicia
Todo está conectado.

Beto
Sí. Los titulares tratan estos incidentes aislados, pero son todos la misma historia exacta.

Alicia
Lo son. Y quiero dejarte con un pensamiento final, ligeramente escalofriante, para que lo reflexiones tú mismo.

Beto
Oh, vaya.

Alicia
A lo largo de este análisis profundo, el debate se ha centrado en si la IA eventualmente tomará nuestros trabajos, o si librará nuestras guerras.

Beto
Correcto.

Alicia
Pero considera los mecanismos subyacentes que hemos discutido. Si la IA ya es capaz de sintetizar miles de puntos de metadatos para rastrear a un militante hasta su hogar, y si los algoritmos ya están optimizados para mantenerte navegando explotando tus desencadenantes psicológicos específicos, ¿qué pasa cuando esa tecnología se dirige hacia el proceso político?

Beto
Oh, vaya.

Alicia
Correcto. ¿Cuánto tiempo pasará hasta que un modelo de IA especializado no solo escriba un discurso, sino que realmente dirija una campaña política?

Beto
Solo analizando grandes cantidades de datos de votantes para micro-dirigir miedos y generar mensajes perfectamente calibrados.

Alicia
Es exactamente optimizar la elección misma, o tal vez un día realmente dirigir el país. Cuando cambias ese interruptor de luz, ya no obtienes luz. Estás alimentando la fragua que está reescribiendo activamente el mundo.

Gracias por acompañarnos en este análisis profundo. Sigue cuestionando la información que te rodea, y nos vemos la próxima vez.