Mostrando entradas con la etiqueta inferencia. Mostrar todas las entradas

viernes, 3 de julio de 2026

DSpark: El secreto para una IA más rápida y eficiente


Este artículo de investigación presenta DSpark, un marco avanzado de decodificación especulativa diseñado para acelerar la inferencia de modelos de lenguaje a gran escala (LLM) mediante la optimización de la generación y verificación de borradores. Los generadores de borradores paralelos tradicionales suelen presentar problemas con el modelado de dependencias de tokens y una verificación ineficiente bajo cargas de sistema elevadas, lo que conlleva un desperdicio de recursos computacionales. Para solucionar esto, DSpark utiliza una arquitectura semiautorregresiva que combina una arquitectura paralela de alta velocidad con un módulo secuencial ligero para garantizar secuencias de borradores de mayor calidad. Además, implementa un sistema de verificación con programación de confianza que utiliza un planificador con reconocimiento de hardware para ajustar dinámicamente la longitud de los bloques de borrador en función de la capacidad del sistema en tiempo real y la certeza de la predicción. Pruebas exhaustivas en el sistema DeepSeek-V4 demuestran que este método mejora significativamente la velocidad de generación y amplía el límite de eficiencia para entornos de servicio de alta concurrencia. Los autores también han publicado como código abierto el repositorio de entrenamiento de DeepSpec y puntos de control específicos del modelo para apoyar futuras investigaciones de la comunidad.

Enlace al artículo científico, para aquellos interesados en profundizar sobre el tema: "DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation", por Xin Cheng y colegas de DeepSeek. Publicado el 27 de Junio de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Sabes, existe esta forma moderna y muy específica de ansiedad que siento como si todos aceptáramos en silencio ahora.

Beto
Oh, sí.

Alicia
Como cuando escribes una pregunta muy compleja y de múltiples capas en tu asistente de IA favorito. Das "enter", y luego simplemente...

Beto
... esperas.

Alicia
Claro. Miras ese cursor parpadeante y lo ves escupir la respuesta. Como una palabra agonizante a la vez. Honestamente, es como ver a alguien teclear con dos dedos índice mientras tú vas cinco minutos tarde para una reunión, y solo necesitas el resumen.

Beto
Es una experiencia universalmente frustrante. Y la ironía es que, cuando haces eso, estás interactuando literalmente con uno de los sistemas computacionalmente más sofisticados y densos en términos de capacidad de cómputo de la historia humana.

Sin embargo, la experiencia del usuario puede sentirse extrañamente estrangulada, ¿sabes? Como si estuvieras descargando una imagen en internet de dial-up de finales de los 90.

Alicia
Sí, exactamente.

Así que hoy vamos a solucionar esa ansiedad del cursor parpadeante o, bueno, al menos exploraremos cómo los ingenieros detrás de escena lo están solucionando por nosotros.

Beto
Me gusta la idea.

Alicia
Bienvenidos a un nuevo análisis profundo. Hoy tenemos en la agenda un artículo de investigación muy técnico, de vanguardia. Se titula "DSpark: Decodificación Especulativa Confiada con Generación Semi-Autorregresiva".

Beto
Es bastante largo.

Alicia
Lo es. Y está escrito por un equipo de investigadores de la Universidad de Pekin y DeepSeek AI.

Beto
Sí, y sabes qué hace que este artículo en particular destaque en un mar de investigación de IA, no es solo la velocidad bruta que logran alcanzar, aunque veremos que las métricas de velocidad son muy impresionantes.

Alicia
Oh, seguro.

Beto
Es realmente la resolución elegante, casi quirúrgica, del problema del mundo real necesaria para equilibrar esa velocidad fulminante con la precisión, todo mientras aseguran que no derritan accidentalmente una enorme granja de servidores en el proceso.

Alicia
Lo cual siempre es algo positivo.

Así que nuestra misión hoy es descubrir los trucos arquitectónicos brillantes que hacen que la IA sea a la vez cegadoramente rápida e increíblemente eficiente. Vamos a decodificar cómo estos investigadores están rompiendo el límite de velocidad de los modelos de lenguaje grandes para que tú, sentado en tu portátil, no tengas que esperar a ese cursor.
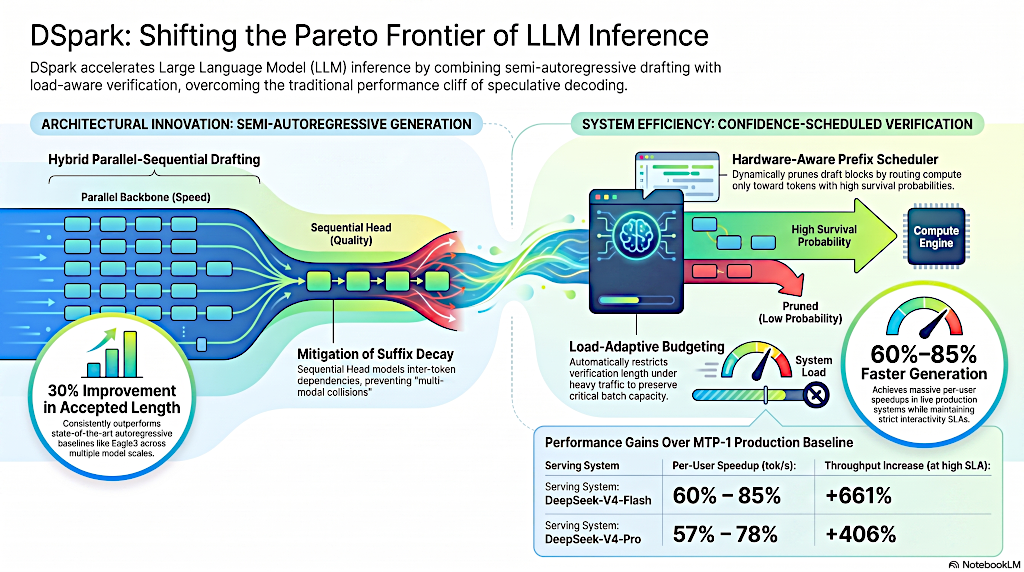
DSpark_LLM_Inf_Arch_Ovw_1024.png
DSpark: Desplazando de la frontera de Pareto de la inferencia LLM.

Pero antes de pasar a las innovaciones específicas de DSpark, necesitamos preparar el escenario un poco. ¿Por qué es que la IA es tan lenta en primer lugar? ¿Qué está pasando realmente cuando ese cursor parpadea?

Beto
Bueno, se reduce fundamentalmente a cómo operan los modelos de lenguaje grandes en su núcleo. Generan texto usando un proceso llamado "generación autorregresiva" ("auto-regressive generation").

Alicia
Okay, autorregresiva.

Beto
Sí. En lenguaje sencillo, eso solo significa que producen exactamente un "token" a la vez. Puedes pensar en un "token" como una sola palabra o, a veces es una parte de una palabra.

Y cada vez que el modelo quiere generar una nueva palabra, tiene que realizar un pase completo hacia adelante ("forward pass") a través de su red neuronal masiva.

Alicia
Pausémos un segundo en el pase hacia adelante. Porque cuando decimos masiva, estamos hablando de miles de millones de parámetros.

Beto
Renderizados en miles de millones, sí.

Alicia
Entonces, ¿cómo se ve eso para la computadora?

Beto
Okay, imagina tener que leer todo un conjunto de enciclopedias solo para decidir la primera palabra de tu oración.

Alicia
Vaya.

Beto
Luego escribes esa palabra. Ahora, para obtener la segunda palabra, tienes que releer todo el conjunto de enciclopedias. Además, la primera palabra que acabas de escribir solo para decidir la segunda palabra.

Alicia
Eso suena increíblemente tedioso.

Beto
Lo es. Enviar los datos a través de miles de millones de neuronas artificiales por cada paso requiere una inmensa cantidad de ancho de banda de memoria.

Alicia
Así que si le pido a una IA que escriba un ensayo de 500 palabras, está haciendo ese cálculo masivo de lectura de enciclopedias 500 veces completamente separadas.

Beto
Ese es el problema central. Exacto. La latencia.

Alicia
Es un retraso que experimentas.

Beto
Claro. El retraso es directamente proporcional a la longitud de la salida. Y como hacer esto una palabra a la vez no aprovecha completamente la potencia de procesamiento paralelo masiva de las GPU modernas, ...

Alicia
... que están diseñadas para hacer miles de cosas a la vez, ¿verdad?

Beto
Exacto. Terminas con una utilización de GPU sorprendentemente baja. Básicamente crea un atasco de tráfico de IA. Y es terrible para tareas sensibles a la latencia como chats en tiempo real o flujos de trabajo complejos y engañosos donde la IA tiene que pensar hacia atrás y hacia adelante consigo misma muy rápidamente para resolver un problema.

Alicia
Así que la industria obviamente sabe que este es un problema. Y sé que no se han quedado quietos. Hay una solución temporal actual que muchos de los mejores modelos están usando ahora, llamada "decodificación especulativa ("speculative decoding").

Beto
Sí.

Alicia
Y me encanta el concepto fundamental de esto porque se siente tan humano para mí.

Beto
Realmente es una solución ingeniosa.

La decodificación especulativa básicamente desacopla la generación del texto de la verificación del texto.

Alicia
Okay, desglosémoslo.

DSpark_architecture.png
Arquitectura DSpark y el ciclo decodificador

Beto
En lugar de depender completamente del modelo grande y pesado, que llamaremos el "modelo objetivo" ("target model"), para hacer todo el trabajo pesado palabra por palabra, introduces un segundo modelo pequeño e increíblemente ligero en el sistema.

Alicia
Y llamamos a esto el "modelo borrador" ("draft model").

Beto
Precisamente. El modelo borrador.

Alicia
Imagino esto como una oficina corporativa. Tienes un ejecutivo brillante pero increíblemente lento y metódico. Ese es nuestro modelo objetivo.

Beto
Correcto.

Alicia
Y el ejecutivo contrata a un interno rápido, quizás un poco imprudente, que es el modelo borrador. Así que el interno escribe rápidamente un párrafo completo de texto, quizás 15 palabras. Luego, el ejecutivo lee todo el párrafo a la vez y simplemente sella "aprobado" en las partes buenas en una sola lectura. Eso es mucho más rápido de que el jefe lo escriba palabra por palabra.

Beto
Esa analogía se sostiene bellamente con la matemática, de hecho. El modelo objetivo verifica el borrador del interno en un solo pase hacia adelante usando un mecanismo llamado "muestreo de rechazo" ("rejection sampling").

Alicia
Okay.

Beto
El ejecutivo esencialmente comprueba el trabajo del interno contra su propia norma interna de calidad. Si la primera palabra coincide con la distribución de probabilidad del ejecutivo, se acepta.

Alicia
Tiene sentido.

Beto
Si la segunda palabra coincide, se acepta. Y esto continúa hasta que el pasante adivina una palabra que el ejecutivo considera demasiado improbable.

Alicia
Y en el momento en que el ejecutivo encuentra una palabra mala, la tacha. Pero no simplemente tacha esa palabra, ¿verdad?

Beto
No, rechaza esa palabra. Y cada palabra que vino después en el borrador.

Alicia
Oh, vaya.

Beto
Sí, porque todas las palabras subsiguientes se basaron en una premisa defectuosa. Pero la belleza de este sistema es que verificar 15 palabras simultáneamente tarda casi exactamente el mismo tiempo que generar solo una palabra desde cero.

Alicia
Espera, ¿de verdad? El mismo tiempo.

Beto
Más o menos, sí. Así que si el interno acierta cinco palabras antes de cometer un error, el sistema acaba de producir cinco palabras perfectas en el tiempo que normalmente tarda en producir una.

Alicia
Eso es increíble.

Beto
Y como el ejecutivo siempre tiene la última palabra, la matemática garantiza que no haya ninguna caída en la calidad de la generación final.

Alicia
Por eso nos importa, ¿verdad? Quiero decir, si has notado que tus herramientas de IA se están volviendo notablemente más rápidas en el último año o así sin que sus respuestas se vuelvan más tontas, este método del interno es exactamente lo que está pasando tras bambalinas.

Beto
Exacto.

Alicia
Pero como este artículo de DSpark señala, el interno tiene algunos fallos serios. Lo que nos lleva a un gran dilema en cómo entrenas y construyes este modelo borrador en primer lugar.

Beto
Sí. La industria se refiere a esto como "el dilema del borrador" ("drafter's dilemma"). Antes de que llegara DSpark, los ingenieros estaban básicamente divididos en dos campos competidores sobre cómo construir un modelo borrador.

Alicia
Okay.

Beto
El primer campo se basaba en borradores autorregresivos ("autoregressive drafters"). Estos son modelos como Eagle-3, por ejemplo.

Alicia
Así que estos son internos que trabajan como el jefe, palabra por palabra, solo con un cerebro más pequeño para moverse un poco más rápido.

Beto
Precisamente eso. Generan el borrador secuencialmente. Y la principal ventaja aquí es la precisión.

Alicia
Claro.

Beto
Porque cada palabra que adivinan se basa en la palabra que literalmente acaban de adivinar un milisegundo antes.

Las oraciones tienen sentido lógico. Pero su latencia crece linealmente.

Alicia
Lo que significa que se vuelven más lentos cuanto más pidas.

Beto
Correcto. Si le pides a este interno que grafique 15 palabras, se necesitan 15 pasos distintos. No puedes pedirles borradores largos, porque simplemente tardan demasiado en generar el texto, lo que frustra por completo el propósito de tener un interno rápido.

Alicia
Okay. Así que si el interno secuencial es demasiado lento, cambiamos al otro extremo. El segundo campo creó "borradores paralelos" ("parallel drafters"), como el modelo DFlash.

Beto
Sí. Y los borradores paralelos son fulminantes. En lugar de ir palabra por palabra, predicen todo el bloque de "tokens" del borrador, digamos, 10 o 15 palabras en un solo pase hacia adelante.

Alicia
Vaya.

Beto
Su tiempo de borrador es básicamente plano. Independientemente de cuántas palabras pidas.

Alicia
Déjame detenerte ahí, porque la mecánica de este tipo me confunde. Si el borrador paralelo está adivinando una oración completa al mismo tiempo, ¿no está básicamente adivinando el futuro con los ojos vendados? ¿Cómo puede saber qué palabra fue la anterior si está generando las 15 palabras simultáneamente?

Beto
Acabas de revelar la debilidad estructural de los borradores paralelos. No pueden modelar las dependencias inter-token.

Alicia
Dependencias inter-token.

Beto
Correcto. No saben cuál será la palabra inmediatamente a su izquierda cuando hagan su adivinanza. Y esto lleva a un fenómeno que los investigadores llaman "colisión multimodal" ("multi-modal collision").

Alicia
Colisión multimodal.

Beto
Sí, lo que causa una rápida decadencia en las tasas de aceptación, cuanto más te adentras en el borrador.

Alicia
La colisión multimodal suena como dos trenes chocando. ¿Cómo se ve eso cuando la IA está tratando de escribir una oración?

Beto
Bueno, veamos cómo se traduce la masa en lenguaje. Imagina que el contexto de una conversación podría ser seguido naturalmente por la frase "por supuesto" o por la frase "no hay problema".

Alicia
Okay.

Beto
Ambas son caminos o modos completamente válidos que puede tomar el texto. Pero como el borrador paralelo no va secuencialmente, tiene que adivinar su mejor opción.

Alicia
Oh, ¿por qué?

Beto
Marginaliza todos los "tokens" anteriores posibles, lo que esencialmente significa que intenta promediar las posibilidades basándose en el contexto general.

Alicia
Espera, creo que veo a dónde va esto. Los promedia y mezcla las frases.

Beto
Lo hace. Puede que tome la palabra de alta probabilidad de "por supuesto" para la posición uno, y la empareje con una palabra de alta probabilidad de "no hay problema" para la posición dos.

Alicia
Oh, no.

Beto
La salida es la frase "por problema".

Alicia
... que es completamente incoherente.

Beto
Exacto. Y cuando el modelo objetivo, el ejecutivo, revisa el borrador, golpea la palabra "problema", la rechaza inmediatamente como sin sentido en ese contexto y bota todo lo que viene después de ella.

Alicia
Así que básicamente desperdicias toda esa potencia de cómputo en un accidente de coche gramaticalmente.

Beto
Sí.

Alicia
Así que estamos atrapados entre una roca y un lugar difícil. El interno autorregresivo es preciso, pero demasiado lento para escribir borradores largos. El interno paralelo es increíblemente rápido, pero se confunde y escribe tonterías si el borrador se pone demasiado largo.

Beto
Aquí es exactamente donde entra DSpark y cambia el paradigma.

DSpark introduce un concepto que llaman "generación semi-autorregresiva" ("semi-auto-regressive generation").

Alicia
Cuando estaba leyendo la sección del artículo, inmediatamente pensé en un corte de pelo. No voy a mentir.

Beto
¿Un corte de pelo?

Alicia
DSpark es esencialmente el "mullet" de la arquitectura de IA.

Beto
Voy a necesitar que me expliques cómo se asemeja una red neuronal a un mullet.

Alicia
Piénsalo. Es negocios por delante con este procesamiento paralelo pesado para mantener el borrador casi instantáneo, pero tiene una pequeña fiesta secuencial en la parte de atrás solo para asegurarse de que las palabras se conecten lógicamente.

Beto
Bueno, aunque dudo seriamente que la fiesta secuencial en la parte de atrás vaya a entrar en una revista de revisión pura pronto. Estás, estructuralmente, correcta.

Alicia
Gracias.

Beto
Pero aterrizémoslo en cómo opera físicamente. Piensa en construir un puente.

Alicia
Okay.

Beto
La columna vertebral paralela de DSpark deja caer todos los enormes pilares de concreto en el río simultáneamente. Esa es la parte del borrador fulminante. Pero si solo dejas caer pilares, no se conectan. Necesitas un equipo para cruzar rápidamente y apretar los pernos secuencialmente para que el puente se sostenga.

Alicia
Okay. Tengo que admitir, el "puente" tiene mucho más sentido que el "mullet". Entonces, ¿cuál es el equipo de aprete de pernos en este sistema de IA?

Beto
DSpark toma una columna vertebral paralela pesada, específicamente una arquitectura D-Flash adaptada para hacer el trabajo pesado del borrador en una pasada.

Alicia
Okay.

Beto
Pero justo al final del proceso, depende de un módulo secuencial increíblemente ligero llamado "cabeza de Markov" ("Markov head"), o para dependencias más largas, una cabeza RNN.

Alicia
¿Qué está haciendo exactamente una cabeza de Markov en ese segundo?

Beto
La cabeza de Markov inyecta un poquito de realidad secuencial en las suposiciones paralelas. Usa un atajo matemático altamente comprimido, lo que el artículo llama "una matriz de factorización de rango bajo" ("low-rank factorization matrix").

Alicia
Okay.

Beto
Usa eso para empujar suavemente las predicciones de palabras de la IA. Llamamos a estas predicciones de palabras "logits". Sesga estos "logits" basándose solo en el "token" que sigue inmediatamente.

Alicia
Solo en el que está justo antes.

Beto
Sí. Así que si la posición uno bloquea aleatoriamente la palabra "por", la cabeza de Markov instantáneamente aumenta la probabilidad de "por supuesto", y suprime la probabilidad de "problema" para la posición dos.

Alicia
Oh, evita la colisión de "por problema".

Beto
Exacto.

Alicia
Y como esta cabeza de Markov es tan computacionalmente diminuta, solo revisar una palabra hacia atrás, hacer la verificación secuencial tarda apenas una fracción de milisegundo.

Beto
La sobrecarga de latencia es prácticamente inexistente. Pero el impacto en la calidad del borrador es masivo.

Alicia
Apuesto que sí.

Beto
El artículo destaca una estadística asombrosa aquí. Al inyectar esta pequeña dosis de lógica secuencial, un modelo DSpark de dos capas muy superficialmente logra superar a una base D-flash de cinco capas mucho más profunda en dominios de matemáticas, código y chat.

Alicia
Espera, ¿un modelo más pequeño venciendo a un modelo más grande solo porque tiene esa pequeña comprobación de realidad secuencial al final?

Beto
Sí.

Alicia
Eso es una locura. Soluciona la colisión multimodal sin sacrificar la velocidad de la columna vertebral paralela. Así que, suena como si solucionáramos al interno rápido y preciso, capaz de escribir borradores largos y coherentes. Todos podemos empaquetar y volver a casa.

Beto
Bueno, si solo estuviéramos hablando de un solo usuario que ejecuta una IA en su portátil personal, sí, el problema estaría resuelto en su mayor parte.

Alicia
Pero lo tenemos ...

Beto
No, tenemos que cambiar de la perspectiva de los datos a la del sistema. En una granja de servidores del mundo real, tratando con millones de solicitudes concurrentes, simplemente revisar borradores largos puede hacer que tu sistema completo colapse.

Alicia
Espera, ¿por qué? Si el interno escribe 15 palabras lógicamente perfectas en un abrir y cerrar de ojos, y el jefe puede leerlas instantáneamente, ¿por qué eso colapsaría el sistema? ¿No resuelve eso el cuello de botella?

Beto
Lo mueve y lo magnifica porque verificar los "tokens" no es gratis.

Alicia
Ahhh.

Beto
Veamos la carga de la verificación. Cada "token" que propone el modelo borrador tiene que ser enviado a través del modelo objetivo masivo para ser verificado. En un entorno de alta concurrencia, lo que significa un servidor lleno que atiende a miles de usuarios simultáneamente. La capacidad de lote (o "batch capacity") de la GPU es tu recurso más preciado.

Alicia
Así que si el interno escribe 15 palabras y el jefe tiene que gastar energía mental leyendo las 15, si el jefe rechaza la palabra número cinco, todavía tuvo que gastar potencia de cómputo leyendo las palabras seis a la quince, solo para tirarlas a la basura.

Beto
Exactamente, ese es el problema. Y en un sistema ocupado, el ciclo de GPU gastado verificando esos "tokens" condenados podría haberse utilizado para procesar una solicitud para un usuario completamente diferente que está esperando en la cola.

Alicia
Oh, vaya.

Beto
Estás literalmente desperdiciando capacidad de lote crítica en "tokens" de alto riesgo.

Alicia
Y el riesgo de que un "token" sea rechazado depende mucho de lo que le pidas a la IA hacer, ¿verdad?

El artículo destaca algunas grandes diferencias de dominio aquí que dictan con qué frecuencia el jefe aprueba el borrador.

Beto
Lo hacen. Los datos altamente estructurados, como escribir código Python, o resolver problemas matemáticos complejos, tienen una tasa de aceptación naturalmente alta.

Alicia
Claro, porque las reglas son estrictas.

Beto
Exacto. El artículo muestra una tasa de aceptación de alrededor del 92% para estas tareas estructuradas. La IA sabe exactamente cómo debe verse la sintaxis de Python, por lo que los borradores paralelos suelen ser correctos.

Alicia
Pero si le pido que escriba algo como una historia creativa, o simplemente tener un chat abierto y sin fin, sobre mi día, ...

Beto
... la tasa de aceptación se desploma. La aceptación de un chat abierto y sin filtro es cercana al 45%.

Alicia
Vaya, 45%. Esa es una caída enorme.

Beto
La distribución de posibles palabras en una historia creativa es simplemente demasiado amplia.

Así que si verificas estáticamente 15 "tokens" de borrador para una solicitud de chat, estás garantizando matemáticamente que desperdiciarás enormes cantidades de potencia de cómputo en "tokens" rechazados.

Alicia
Aquí es donde se pone realmente interesante. ¿Cómo arreglamos al jefe? Porque DSpark introduce otra innovación importante llamada "verificación programada por confianza" ("confidence-scheduled verification").

Beto
Esta es una hermosa pieza de ingeniería de sistemas. DSpark añade una cabeza de confianza ("confidence head") para predecir la probabilidad de supervivencia de cada "token" del borrador.

Alicia
Okay.

Beto
Básicamente pregunta cuáles son las probabilidades de que el jefe apruebe realmente esta palabra específica. Y lo combina con un "planificador de prefijo sensible al hardware" ("hardware-aware prefix scheduler").

Alicia
¿Un "planificador de prefijo sensible al hardware"? Eso son muchas palabras.

Beto
Lo son, pero todo lo que hace es mirar la carga en tiempo real del servidor y cortar dinámicamente el bloque del borrador antes de que siquiera llegue al modelo objetivo.

Alicia
Verás, imagino esto exactamente como un guardia de seguridad en un club lleno.

Beto
¿Cómo es eso?

Alicia
Piénsalo. El club es nuestra GPU. Si el club está completamente vacío un martes por la noche, el guardia dice, claro, dejen entrar a todo el grupo de 15 palabras del borrador, incluso las defectuosas al fondo de la fila.

Beto
Claro, porque no hay penalización.

Alicia
Exacto. El servidor está vacío de todos modos. Pero si es un sábado por la noche y el club está abarrotado con tráfico de alta concurrencia, el guardia se vuelve estricto. Solo los VIP absolutos ...

Beto
... los "tokens" altamente confiados.

Alicia
Sí, los "tokens" altamente confiados que están casi matemáticamente garantizados para ser aceptados, pasan por la puerta para ser verificados. Todos los demás son cortados en la puerta para que el club no viole el código de incendios.

Beto
Eso captura perfectamente la dinámica. El planificador de prefijo sensible al hardware maximiza el rendimiento global del sistema al asignar un presupuesto de verificación solo a los "tokens" con un retorno esperado positivo, basados en la capacidad actual del hardware.

Alicia
Eso es muy inteligente.

Beto
Pero introducir un guardia crea un nuevo problema. Las redes neuronales son horriblemente confiadas.

Alicia
Correcto. La IA siempre piensa que es un VIP, incluso cuando está usando zapatillas en un evento de etiqueta.

Beto
Sí. Una red neuronal cruda podría darle a un "token" una puntuación de confianza del 90%. Pero empíricamente, en el mundo real, solo sobrevive el 60% de las veces.

Alicia
Oh, esa es una gran discrepancia.

Beto
Lo es. Si el guardia confía en esas puntuaciones infladas, serán engañados, dejarán entrar demasiados "tokens", y el sistema seguirá ralentizándose. Para solucionar esto, DSpark usa "escalado de temperatura secuencial" ("sequential temperature scaling", o STS).

Alicia
¿Cómo ajusta STS esas puntuaciones para que el guardia no sea engañado? ¿Cuál es el mecanismo?

Beto
Calcula el producto acumulativo de la probabilidad. Piénsalo como una cadena de confianza.

Alicia
Okay.

Beto
Si confío en la persona A, 90%, y la persona A confía en la persona B, 90%, mi confianza general en la persona B no debería ser 90%.

Alicia
Debería ser menor.

Beto
Debería ser 81%, porque la duda se multiplica.

Alicia
Sí.

Beto
Porque la supervivencia de la palabra "cinco" depende totalmente de la supervivencia de las palabras "uno, dos, tres y cuatro". STS forza al sistema a multiplicar esas probabilidades.

Alicia
Oh, forza a la IA a reconocer que encadenar cinco palabras bastante seguras resulta en una oración altamente incierta en general.

Beto
Exacto. Para encontrar el factor matemático exacto para ajustar esto, ejecutan lo que se llama "una búsqueda en rejilla" ("grid search").

Alicia
¿Qué hace eso?

Beto
Esencialmente, ejecutan miles de simulaciones con datos de validación históricos para encontrar el multiplicador de calibración perfecto. Alinea perfectamente la tasa de supervivencia predicha con la tasa de aceptación empírica real.

Alicia
Eso es brillante.

Beto
Asegura que cuando el guardia ve un pase VIP del 90%, realmente representa una probabilidad del 90% en el mundo real.

Alicia
Así que al guardia se le equipa con un detector de mentiras. Eso es ingeniería increíble.

Okay. Así que tenemos al constructor de puentes semi-autorregresivo haciendo borradores rápidos y coherentes. Tenemos al guardia calibrado protegiendo el servidor de desperdiciar cómputo.

Beto
Correcto.

Alicia
¿Cómo se sostiene toda esta teoría en el mundo real? Porque este artículo no solo lo probó en un entorno de laboratorio prístino.

Beto
No. Lo desplegaron directamente al fuego. Ejecutaron la prueba del mundo real desplegando DSpark dentro del sistema de servicio de DeepSeek v4 bajo tráfico de usuario en vivo.

Alicia
Poner una arquitectura no probada en un entorno de producción en vivo con millones de usuarios es la definición de alto riesgo. Tengo que imaginar que, o colapsó el servidor, o destrozó la línea base antigua. ¿Contra qué lo compararon?

Beto
Lo compararon con su línea base de producción establecida, que era MTP-1.

Alicia
Okay. ¿Qué es eso?

Beto
Es una configuración de predicción de un solo "token". Históricamente, se les obligaba a usar una configuración de un solo "token" porque desplegar un borrador multi-"token" estático bajo alta concurrencia degradaría estrictamente su rendimiento agregado.

Alicia
Completamente debido a ese desperdicio de verificación del que acabamos de hablar.

Beto
Exacto.

Alicia
Así que pusieron DSpark contra un sistema que fue específicamente probado en batalla y optimizado para no colapsar bajo carga pesada. ¿Qué pasó?

Beto
Los resultados fueron asombrosos. Igualó los niveles de rendimiento, lo que significa que los servidores que manejan exactamente el mismo volumen masivo de trabajo.

Alicia
Sí.

Beto
DSpark aceleró las velocidades de generación por usuario en un 60% a 85% en el motor Flash v4.

Alicia
Espera, ¿60 a 85% más rápido para el usuario final?

Beto
Sí.

Alicia
Eso es el cursor parpadeante convirtiéndose prácticamente en un borrón.

Beto
Es un salto masivo hacia adelante.

Pero lo que es aún más impresionante como ingenieros de sistemas es cómo evita lo que llamamos un "acantilado de rendimiento" ("performance cliff").

Alicia
¿El acantilado de rendimiento?

Beto
Sí. En el servicio de LLM existe una frontera de Pareto. Podrías pensarlo como una balanza.

Alicia
Okay, balanza.

Beto
En un lado tienes el rendimiento total del sistema sirviendo a un millón de usuarios a la vez. En el otro lado tienes la velocidad individual asegurando que un usuario específico reciba su respuesta instantáneamente.

Alicia
Claro, quieres servir a un millón de personas, pero no quieres que todos esperen 10 minutos por una respuesta. En sistemas tradicionales, presionar violentamente en un lado tira el otro hacia el aire.

Beto
En sistemas, usa acuerdos de nivel de servicio (SLAs) para garantizar una cierta velocidad mínima a los usuarios. Digamos que el SLA es de estrictos 120 "tokens" por segundo por usuario. Bajo esa restricción estricta, la línea base antigua de un solo "token" se derrumba por completo. Su capacidad se deteriora gravemente porque simplemente no puede seguir el ritmo de la matemática.

Alicia
Pero DSpark, ...

Beto
Porque el Guardia gestiona dinámicamente esa sobrecarga de verificación basada en la carga del servidor, evita esa degradación del rendimiento. Mantiene una capacidad robusta incluso a 120 "tokens" por segundo.

Alicia
Así que no solo se trata de moverse más rápido en la misma carretera. Se trata literalmente de cambiar la frontera de Pareto. Como reescribir la física de la balanza, expandiendo lo que es computacionalmente posible para todo el sistema.

Beto
Desbloquea niveles de rendimiento que antes eran simplemente inalcanzables en entornos de producción.

Alicia
Si alguna vez has visto a tu asistente de IA pausarse a mitad de una oración mientras codifica o volar a través de una compleja solicitud de razonamiento de múltiples pasos, esta gestión invisible del tráfico es exactamente lo que hace posible esa interacción en tiempo real.

Beto
Es realmente una síntesis fenomenal del diseño arquitectónico del lado de los datos y la optimización de hardware del lado del sistema trabajando en perfecto tándem.

Alicia
Vamos a juntar todo esto. Comenzamos con el inmenso cuello de botella de la generación autorregresiva, leyendo la enciclopedia palabra por palabra, dolorosamente lento. Luego exploramos el dilema del borrador. Los internos autorregresivos eran precisos pero demasiado lentos. Los internos paralelos eran rápidos pero se confundían y se aplastaban a sí mismos. DSpark resolvió eso con una arquitectura semi-autorregresiva, fusionando una columna vertebral paralela pesada con una cabeza de Markov ligera para mantener el texto lógicamente sólido.

Beto
Exacto.

Alicia
Y finalmente, para proteger el servidor, introdujeron la "verificación programada por confianza" ("confidence-scheduled verification"), nuestro guardia calibrado.

Beto
El guardia con un detector de mentiras.

Alicia
Sí. Para asegurar que solo los borradores de "tokens" más estadísticamente sólidos consuman un precioso tiempo de GPU.

Beto
Es una solución completa y elegante.

Pero antes de terminar, hay un detalle oculto en el apéndice del artículo que plantea un punto bastante profundo.

Alicia
Oh, ¿de verdad?

Beto
Sí, es sobre lo que los investigadores llaman la "propiedad no anticipatoria" ("non-anticipating property").

Alicia
La propiedad no anticipatoria. ¿Cómo encaja eso en todo esto?

Beto
Bueno, para que todo este marco matemático sin pérdidas funcione, el planificador dinámico, el equilibrador, tiene que tomar sus decisiones de admisión antes de que realmente vea la palabra generada.

Alicia
Espera, ¿de verdad?

Beto
Claro.

Alicia
¿Por qué no puede simplemente mirar la palabra para ver si es buena?

Beto
Si el sistema hace una búsqueda retrospectiva, si mirara la palabra real para decidir si dejarla pasar para la verificación, introduce inadvertidamente un sesgo de selección masivo.

Alicia
Oh, interesante.

Beto
Favorecería sistemáticamente a los "tokens" que conducen a continuaciones seguras y altamente confiadas, lo que fundamentalmente distorsiona la lógica original verdadera de la IA. Haría que la IA sonara genérica.

Alicia
Así que el algoritmo literalmente tiene que vendarse los ojos al futuro para preservar la pureza de su propio proceso de pensamiento.

Beto
Sí. El sistema tiene un diseño asíncrono que forma una barrera causal estricta. Aísla perfectamente el evento de admisión de la realización del "token" futuro.

Alicia
Vaya.

Beto
Literalmente monitorea sus propios límites computacionales y poda impecablemente su propia cadena de pensamiento en tiempo real, solo para sobrevivir al estrés del servidor, todo sin corromper la integridad de la respuesta que está tratando de darte.

Alicia
Eso es, vaya. Plantea una pregunta filosófica fascinante para que la medites. Si los sistemas de IA están siendo diseñados ahora para monitorear proactivamente sus propios límites computacionales y podar perfectamente su propia cadena de pensamiento en tiempo real ciegamente solo para sobrevivir al estrés del servidor, ¿qué sucede cuando esta autoconciencia algorítmica profunda de sus propios límites comienza a dar forma a la lógica real de las respuestas que te da?

Beto
Es un pensamiento profundo para terminar. La arquitectura en sí ya no es solo un recipiente pasivo. Quiero decir, se está convirtiendo en un participante activo en el proceso de razonamiento.

Alicia
Realmente te hace mirar a ese cursor parpadeante un poco diferente, ¿verdad? No es solo pensar, está negociando activamente su propia supervivencia en la granja de servidores antes incluso de hablarte.

Muchas gracias por acompañarnos en este análisis profundo. Sigue explorando las arquitecturas ocultas que impulsan tu mundo, y nos vemos la próxima vez.

miércoles, 17 de junio de 2026

Razonamiento Abductivo: Explicando el "Por qué"


Este artículo ofrece un análisis exhaustivo del razonamiento abductivo en Modelos de Lenguaje a Gran Escala (LLM), que consiste en el proceso lógico de inferir la explicación más probable para una observación dada. Para resolver la fragmentación actual del campo, los autores proponen un marco unificado de dos etapas: generación y selección de hipótesis. Introducen una taxonomía de cuatro ejes para categorizar la investigación existente según la formulación de la tarea, los tipos de conjuntos de datos, las metodologías y las estrategias de evaluación. Mediante la evaluación comparativa empírica de modelos modernos como GPT-5 y Llama 3, el estudio revela que, si bien los LLMs destacan en tareas deductivas, aún presentan dificultades con la inferencia abductiva compleja. Los autores identifican lagunas críticas en la investigación, como la falta de evaluaciones comparativas dinámicas y una cobertura de dominio limitada. Finalmente, sugieren futuras líneas de investigación que incluyen el aprendizaje por refuerzo para potenciar las capacidades explicativas y mejorar la interpretabilidad mecanicista, con el fin de impulsar el campo.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Wiring the ‘Why’: A Unified Taxonomy and Survey of Abductive Reasoning in LLMs". Por Moein Salimi y colegas de la Universidad Tecnológica de Sharif. Publicado el 23 de Abril de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Imagina que un doctor introduce tus síntomas en una inteligencia artificial de mil millones de dólares. Esta procesa tus datos y te da un diagnóstico con un 99% de precisión.

Alicia
Claro. Suena increíble.

Beto
Sí, te sientes completamente seguro con esta tecnología. Pero luego le quitas su lista de opciones múltiples de posibles enfermedades y simplemente se la pides que adivine lo que te pasa en una página completamente en blanco.

Alicia
Y ahí es exactamente donde la ilusión se rompe.

Beto
Exacto. La misma máquina multimillonaria falla como un estudiante de medicina de clase C-.

Así que hoy estamos examinando el mayor punto ciego de la IA moderna.

Alicia
Es una limitación profunda, en realidad. Estamos lidiando con una situación donde los modelos de lenguaje grande (LLM), los motores detrás de la IA que usamos todos los días, son notablemente buenos para seleccionar una respuesta.

Beto
Claro. Si le das las opciones.

Alicia
Sí, pero tienen grandes dificultades cuando se les obliga a generar una teoría desde cero.

Beto
Así que bienvenidos a un nuevo análisis profundo. Nuestra misión hoy es explorar la frontera de la inteligencia artificial viendo lo que sucede cuando la IA se encuentra con lo desconocido. ¿Cómo hace una máquina una suposición educada?

Alicia
Que no es tan simple como parece.

Beto
No, para nada. Muy bien, desglosémoslo.

Nuestra fuente hoy es un artículo de investigación muy completo de 2026 y se titula "Wiring the Why: Una taxonomía unificada y encuesta del razonamiento abductivo en los LLM".

Alicia
Sí. Y el núcleo de todo este artículo se basa en algo llamado "razonamiento abductivo".

Abductive_Reasoning_Pipeline_in_LLMs_1024
Cableando el "por qué": Proceso de dos etapas en Razonamiento Abductivo

Beto
Correcto. Razonamiento abductivo.

Alicia
Que, en términos funcionales, es simplemente el proceso de inferir la explicación más plausible para una observación sorprendente.

Los autores utilizan un ejemplo cotidiano muy concreto para ilustrar esto.

Beto
Espero que sea uno de Wi-Fi, ¿verdad?

Alicia
Exacto. Así que si abres tu portátil y tu navegador web simplemente muestra una página de error, instintivamente infieres que tu Wi-Fi podría estar caído.

Beto
Tiene sentido.

Alicia
Y no posees una prueba matemática absoluta de un fallo de la red. Pero si el Wi-Fi estuviera caído, explicaría perfectamente esa página de error. Así que estás haciendo un salto lógico hacia atrás desde el efecto a la causa probable.

Beto
Y si estás escuchando esto ahora mismo, haces esto durante todo el día sin siquiera pensarlo.

Alicia
Oh, absolutamente.

Beto
Ya seas un programador, solucionando un error extraño en tu código, o un médico tratando de entender el síntoma vago de un paciente, o, tratando de averiguar por qué tu amigo está actuando raro.

Alicia
Sí. Estás usando razonamiento abductivo.

Beto
Estás adivinando constantemente el por qué. Pero la investigación revela que hacer que una computadora adivine la pieza faltante de un rompecabezas requiere una arquitectura totalmente diferente a simplemente hacer matemáticas.

Alicia
Lo requiere. Y para entender el cuello de botella de la IA moderna, realmente tenemos que mirar la naturaleza fundamental de este tipo de lógica, porque este tipo específico de razonamiento ha desconcertado a los filósofos durante siglos.

Beto
Siglos. Vaya.

Alicia
Oh, sí. El artículo rastrea el concepto hasta Aristóteles. Él tuvo esta idea de "apagoge", pero señala que fue el filósofo del siglo XIX, Charles Sanders Peirce, quien la categorizó formalmente. Y Peirce veía la abducción como la lógica del descubrimiento. Me encanta esta parte porque, en su marco, es literalmente la única operación lógica que introduce ideas genuinamente nuevas en nuestra base de conocimiento.

Beto
Esa es una gran afirmación.

Quiero contrastar eso con la lógica con la que la gente probablemente está más familiarizada, como la deducción y la inducción.

Alicia
Claro. Sí. Explícalos.

Beto
Si la deducción es como seguir una receta estricta para obtener un pastel garantizado, combinas harina, azúcar, calor y ¡pum!, obtienes un pastel.

Alicia
Resultado garantizado.

Beto
Y la inducción es asumir que todos los pasteles son dulces porque los últimos 10 que probaste fueron dulces. Entonces la abducción se siente completamente diferente.

Alicia
¿Cómo es eso?

Beto
Suena más como probar un plato nuevo y totalmente extraño e intentar construir la fórmula inversa del ingrediente secreto.

Alicia
Oh, me encanta esa analogía. Es exactamente eso.

Basándonos en ese concepto de ingeniería inversa, el artículo fuente destaca tres razones específicas por las cuales este proceso mental simplemente rompe a las computadoras.

Beto
Muy bien, descríbelas.

Alicia
Primero, la abducción es ampliativa.

Beto
Ampliativa, ¿significa que amplifica las cosas?

Alicia
Algo así. Genera nuevas ideas que van más allá de las premisas originales.

La deducción, por otro lado, solo reformula información que ya existe.

Beto
Entendido. ¿Cuál es la segunda razón?

Alicia
Segunda, la abducción es refutable. Esto simplemente significa que la conclusión es tentativa. Puede ser completamente revertida si llega nueva evidencia.

Beto
Oh, cierto. Si construyes la fórmula inversa de ese plato extraño y adivinas que el ingrediente secreto es la canela. Pero luego el chef te dice que el postre no contiene nada de especias. Tu conclusión es totalmente refutada. Simplemente tienes que empezar de nuevo.

Alicia
Precisamente.

Y tercero, es no-monótona.

Beto
Muy bien, espera. No-monótona suena como un término matemático muy pesado. Para alguien que está escuchando ahora mismo y no es un lógico o un científico de la computación, ¿qué significa eso realmente para la programación de la IA?

Alicia
Bueno, cambia fundamentalmente cómo un sistema procesa hechos nuevos. En la lógica monótona clásica, añadir nueva información no invalida una conclusión verdadera previa.

Beto
Muy bien, dame un ejemplo.

Alicia
Si A es igual a B, aprender una nueva variable C no cambia el hecho de que A es igual a B. Eso está fijado.

Beto
Claro. Tiene sentido.

Alicia
Pero en el razonamiento abductivo, aprender un nuevo hecho puede destruir toda tu teoría de trabajo. Una máquina construida sobre principios monótonos realmente tiene dificultades cuando el terreno se desplaza bajo su lógica de esa manera.

Beto
Así que básicamente construimos sistemas de IA como calculadoras rígidas perfectas. Y ahora les estamos pidiendo que actúen como detectives flexibles y creativos.

Alicia
Esa es una gran manera de decirlo. Y la transición de la lógica monótona a la adivinanza no-monótona está destinada a causar fricción.

Beto
Y esa fricción es un problema real, ¿verdad?

Alicia
Oh, en realidad paralizó a la comunidad de investigación de IA durante años. Porque los filósofos debatieron vehementemente si la abducción era estrictamente el acto creativo de adivinar una hipótesis, o si también incluía el proceso de evaluar y elegir la mejor suposición entre muchas opciones.

Beto
Así que los científicos de la computación estaban confundidos.

Alicia
Totalmente. No sabían cómo probarlo. Construyeron puntos de referencia que estaban completamente desalineados. Algunos investigadores probaron modelos con como indicaciones de escritura creativa libre. Otros usaron pruebas de opción múltiple rígidas.

Beto
Y apuesto a que ambos grupos afirmaron haberlo resuelto.

Alicia
Oh, absolutamente. Ambos grupos publicaron artículos afirmando haber resuelto efectivamente el razonamiento abductivo en la IA.

Beto
Aquí es donde se pone realmente interesante. Debido a que la comunidad de IA estaba paralizada por este debate sobre lo que realmente implica adivinar, estos investigadores de 2026 se dieron cuenta de que no podían simplemente construir una mejor prueba.

Alicia
Correcto. Tenían que construir un nuevo plano completamente.

Beto
Sí. Se retiraron y propusieron una solución unificada basada en un concepto filosófico moderno llamado "inferencia a la mejor explicación", "Inference to the Best Explanation", o IBE, por sus siglas en clave corta.

Alicia
Sí, IBE.

Beto
Y dividieron el razonamiento abdutivo en un claro conducto de dos etapas.

Alicia
Lo cual es brillante porque el plano IBE finalmente pone fin a la fragmentación.

Así que la primera etapa es la generación de hipótesis. Esta es la fase puramente creativa.

Beto
Una página en blanco.

Alicia
Exacto. La IA se enfrenta a una observación y a una página completamente en blanco. Debe producir un conjunto de explicaciones candidatas para tender un puente en el conocimiento.

Luego pasamos a la segunda etapa, que es la selección de hipótesis.

Beto
Y esa es la fase evaluativa.

Alicia
Claro. La IA mira los candidatos que acaban de generar o los candidatos que se le dan en formato de opción múltiple y los califica. Busca virtudes como el poder explicativo y la coherencia, y selecciona la opción más plausible.

Beto
Así que al dividirlo en generación y selección, los investigadores finalmente pudieron organizar todas las pruebas desordenadas de la IA en una taxonomía limpia.

Alicia
Lo fascinante aquí es cómo clasificaron los conjuntos de datos. Los colocaron en dos grupos principales. El primer grupo son conjuntos de datos de sentido común, que involucran narrativas cotidianas. Destacan pruebas como ART y e-CARE.

Beto
Vale, sentido común. Danos una idea de cómo se ven esas pruebas.

Alicia
Bueno, esas pruebas evalúan la capacidad de comprensión de la IA sobre el conocimiento humano implícito.

En un conjunto de datos como ART, el modelo podría recibir dos nodos narrativos. Observación uno: "Cameron decidió organizar una barbacoa". Observación dos: "Sus amigos se sintieron aburridos".

Beto
Y la IA tiene que conectarlos.

Alicia
Exacto. Tiene que proporcionar el tejido conectivo. Tiene que generar un evento intermedio plausible como "Cameron olvidó comprar la comida y solo pudo servir agua", para que la narrativa sea lógicamente sólida.

Beto
Yo definitivamente haría una barbacoa aburrida.

Alicia
Genial.

Beto
Luego tienes el segundo cubo, los conjuntos de datos de expertos o formales. Y estos son mucho más rigurosos porque tratan con campos especializados.

Alicia
Muy rigurosos.

Beto
Los investigadores destacan DDXPlus, que es un enorme conjunto de datos de diagnóstico médico. También miran a ProofWriter, que pide a la IA que encuentre reglas lógicas faltantes en un sistema matemático formal.

Alicia
Sí. Y en estas pruebas, la IA no puede simplemente confiar en la intuición humana cotidiana. Tiene que respetar restricciones científicas o matemáticas estrictas.

Beto
Lo cual es un gran salto. Así que armada con este conducto IBE de dos etapas, los autores hicieron una evaluación comparativa sistemática de los modelos de lenguaje grande más potentes disponibles en 2026.

Alicia
Lo hicieron. Analizaron GPT 5.4, DeepSeek V3.2, Qwen3 y Llama 3.3.

Beto
Y vamos a contextualizar brevemente eso para el oyente, especialmente en lo que respecta a Llama 3.3. Opera con 70 mil millones de parámetros.

Alicia
Esa es una escala masiva.

Beto
Enorme. Un parámetro es esencialmente un peso matemático que actúa como una sinapsis digital. Así que tienes 70 mil millones de estos pequeños puntos de conexión disparándose para calcular y predecir la siguiente secuencia de texto. El poder de cómputo es astronómico.

Alicia
Pero a pesar de todo ese poder, los resultados empíricos que recopilaron al probar estos sistemas apuntan a un punto ciego innegable.

Beto
Sí, veamos los datos para la segunda etapa. Selección de hipótesis. Cuando la investigación ha proporcionado a la IA una lista de opción múltiple, el rendimiento fue asombroso.

Alicia
Caso increíble.

Beto
En el conjunto de datos médico DDX Plus, le dieron a la IA síntomas de un paciente y una lista de enfermedades candidatas. Los modelos principales lograron una precisión de casi el 99% en clasificar la enfermedad correcta dentro de sus tres mejores opciones.

Alicia
Quiero decir, si la evaluación se detuviera ahí, la percepción pública sería que la inteligencia artificial ha dominado fundamentalmente el diagnóstico médico complejo.

Beto
Pero los investigadores no se detuvieron ahí. Luego forzaron a los modelos en la primera etapa.

Alicia
La prueba de la página en blanco.

Beto
Sí. Eliminaron por completo la lista de opción múltiple. Proporcionaron exactamente los mismos síntomas del paciente y le dieron a la IA una página en blanco, instándola a encontrar los diagnósticos médicos desde cero. La precisión del 99% se desplomó al 63%.

Alicia
La caída es severa y es consistente en diferentes dominios también. Como en el conjunto de datos de lógica formal, ProofReader, el modelo líder solo logró una precisión de alrededor del 21% cuando se le obligó a generar un hecho lógico faltante sin una lista de opciones.

Beto
Mira, tengo que contrarrestar lo que esto implica sobre la tecnología.

Alicia
Vaya. Adelante.

Beto
Si un estudiante solo sabe cómo eliminar malas opciones en una prueba de opción múltiple, pero falla cuando se le da una indicación de ensayo, normalmente decimos que ese estudiante no entiende realmente el material.

Alicia
Es un punto justo.

Beto
¿Significa esta caída masiva que estos modelos de mil millones de parámetros en realidad no están razonando en absoluto? ¿Son solo coincidencias de patrones increíblemente sofisticadas que dependen de que nosotros les alimentemos las respuestas para evaluarlas?

Alicia
Bueno, yo no iría tan lejos como decir que no están razonando en absoluto. Su lógica deductiva, su capacidad para tomar hechos establecidos y ejecutar reglas matemáticas o procedimentales es matemáticamente prístina.

Beto
Pero la parte abductiva está rota.

Alicia
Exacto. Y el artículo aborda tu preocupación exacta con un gráfico de dispersión revelador. Graficaron la precisión del modelo en tareas puramente deductivas contra su precisión en estas tareas de generación abdutiva.

Beto
Oh, vaya. ¿Y qué mostró el grupo de puntos de datos?

Alicia
Mostró una dura realidad. La alta precisión deductiva no se traduce de manera confiable en capacidad abdutiva.

Beto
Para nada.

Alicia
Realmente no. Los modelos que obtuvieron cerca de la cima en lógica y matemáticas estrictas a menudo mostraron un rendimiento bajo a moderado en la generación de explicaciones plausibles desde una página en blanco. Los datos simplemente prueban que estos son músculos cognitivos distintos.

Beto
Ejecutar una prueba matemática es una operación fundamentalmente diferente a inventar una hipótesis plausible.

Alicia
Completamente diferente.

Beto
Entonces, ¿qué significa todo esto? Por qué esta brecha entre seleccionar una respuesta y generar una respuesta realmente importa para ti, oyente, se reduce a cómo queremos usar la IA en el mundo real.

Alicia
Exacto. Se trata de aplicación práctica.

Beto
Porque si quieres que una IA actúe como una verdadera compañera investigadora, rara vez empiezas con una lista ordenada de opción múltiple.

Alicia
Casi nunca.

Beto
El espacio de hipótesis en el mundo real es completamente abierto. Un médico se enfrenta a un paciente cuyos síntomas contradicen el libro de texto. Un analista de ciberseguridad mira el tráfico de red que no coincide con ninguna firma de malware conocida.

Alicia
Y si tu compañera de IA solo puede seleccionar de una lista preaprobada de teorías conocidas, su utilidad está severamente limitada. No puede ayudarte a descubrir nada genuinamente nuevo. Básicamente, no puede navegar por lo desconocido.

Beto
Pero la buena noticia es que el artículo no solo diagnostica el problema. Describe una hoja de ruta completa para la industria de la IA para tender este puente.

Alicia
Sí, ofrecen soluciones reales.

Beto
Y la primera solución importante que proponen es un cambio hacia puntos de referencia orientados a la acción.

Alicia
Esto es crucial. Actualmente, el panorama de pruebas es en gran parte estático. La IA produce una oración y un humano u otro programa la califica como correcta o incorrecta.

Beto
Como una prueba escolar tradicional.

Alicia
Sí, exactamente. La abducción en el mundo real es inherentemente interactiva. Si un médico formula la hipótesis de que un paciente tiene una infección específica, el siguiente paso inmediato es ordenar una prueba de sangre dirigida.

Beto
Claro. Tomas una acción para verificar la suposición.

Alicia
Exacto. Así que el artículo argumenta que los modelos de IA futuros deben ser evaluados en si su hipótesis generada apoya una acción productiva. ¿La suposición de la IA conduce a un experimento físico útil o a un paso de depuración funcional?

Beto
Esto cambia el enfoque de simplemente proporcionar una cadena de texto correcta a proporcionar una herramienta para una investigación posterior.

Alicia
Exacto.

Beto
Ahora, la segunda solución del detalle implica el uso de aprendizaje por refuerzo para enseñar a la IA lo que llaman "virtudes explicativas".

Alicia
¿Virtudes explicativas? Me gusta mucho este concepto.

Beto
Porque ahora mismo, la mayoría de la IA se entrena usando "ajuste fino supervisado" ("supervised fine-tuning", o SFT). El sistema simplemente recibe miles de ejemplos de explicaciones correctas y aprende a imitarlas.

Alicia
Sí. El entrenamiento supervisado simplemente enseña al modelo a producir la secuencia de palabras más estadísticamente probable basada en sus datos de entrenamiento. No enseña al modelo los principios subyacentes de lo que hace que una explicación sea fundamentalmente mejor que otra.

Beto
Así que los investigadores proponen "aprendizaje por refuerzo" ("reinforcement learning", o RL), donde la IA es activamente recompensada o penalizada en función de su comportamiento.

Alicia
Claro.

Beto
Quieren enseñarle virtudes como "la navaja de Occam", el principio de que la explicación más simple es generalmente la correcta.

Pero espera, ¿cómo mide realmente una computadora la simplicidad? Una ecuación matemática no sabe inherentemente lo que significa simple.

Alicia
Esa es la parte complicada, pero los investigadores sugieren medir y recompensar a la IA por tomar el camino lógico más corto.

Beto
Ah, ok.

Alicia
Así que si el modelo utiliza 10 pasos complejos de baja probabilidad para explicar una observación que podría explicarse adecuadamente en dos pasos de alta probabilidad, el sistema penaliza al modelo.

Beto
Tiene sentido.

Alicia
Con el tiempo, la IA aprende a favorecer la elegancia estructural y la coherencia interna sobre teorías innecesariamente complejas.

Beto
Eso es fascinante.

Ahora, la tercera solución arquitectónica que proponen es el debate multiagente.

Alicia
Esta es realmente genial.

Beto
En lugar de depender de un único modelo de IA monolítico para manejar tanto la generación creativa como la evaluación rigurosa, sugieren dividir el trabajo.

Alicia
Que es lo que hacemos en los equipos humanos todo el tiempo. Dependemos de roles especializados. En esta arquitectura propuesta, empleas un agente de IA especializado cuya única función es la primera etapa.

Beto
La etapa de generación.

Alicia
Claro. Lluvia de ideas diversas, creativas e incluso improbables sin filtrar.

Luego introduces un agente de IA completamente separado actuando como el crítico.

Beto
Así que la segunda etapa.

Alicia
Sí. Su función es evaluar rigurosamente esas opciones generadas contra las virtudes explicativas.

Beto
Básicamente, el soñador y el contador.

Alicia
Exacto. Les dejas interactuar. El agente crítico proporciona retroalimentación, señalando fallos lógicos, y el agente creativo utiliza esa retroalimentación como un proceso que llaman "propagación hacia atrás de la crítica" ("back propagation of critique") para refinar su próximo conjunto de suposiciones.

Beto
Eso suena increíblemente poderoso.

Alicia
Lo es. La interacción forza al sistema a explorar un espacio de posibilidades mucho más rico de lo que un solo modelo podría lograr por sí solo.

Beto
Pero estas tres soluciones, los puntos de referencia orientados a la acción, el aprendizaje por refuerzo y el debate multiagente, todos operan a nivel de software y entrenamiento.

El artículo de 2026 va un paso más allá, ¿verdad?

Alicia
Lo hace. Si conectamos esto con la imagen más grande, la frontera definitiva a la que apuntan es llamada "interpretabilidad mecanicista".

Beto
Interpretabilidad mecanicista. Vamos a desglosarlo.

Alicia
Aquí es donde la investigación pasa de la arquitectura de software a la neurociencia digital.

Actualmente, los modelos de lenguaje grande son relativamente opacos. Introducimos una instrucción, millones de parámetros ejecutan multiplicaciones de matriz complejas y recibimos una salida.

Beto
Es una caja negra.

Alicia
Exacto. Pero los investigadores argumentan que para resolver verdaderamente el cuello de botella del razonamiento abductivo, tenemos que mirar dentro del cerebro digital y mapear los circuitos abductivos físicos.

Beto
Así que la interpretabilidad mecanicista es menos como mirar el código de una computadora y más como realizar un escaneo de resonancia magnética funcional (fMRI) en el cerebro digital.

Alicia
Esa es una analogía perfecta.

Beto
Estamos tratando de ver exactamente qué agrupaciones de datos se iluminan durante diferentes tareas cognitivas.

Alicia
Esa es una forma muy precisa de visualizarlo.

Los investigadores quieren aislar componentes específicos como "cabezales de atención" ("attention heads").

Beto
¿Cabezales de atención?

Alicia
Sí. Un cabezal de atención es un mecanismo en la red neuronal que decide qué palabras o conceptos son más relevantes entre sí en un contexto dado. El objetivo es identificar precisamente qué cabezales de atención y capas neuronales se activan cuando un modelo está realmente haciendo una lluvia de ideas sobre una nueva hipótesis versus cuando simplemente está recitando un hecho memorizado de sus datos de entrenamiento.

Beto
Vaya. Si podemos mapear esos circuitos específicos, podemos entender el mecanismo matemático exacto que distingue la inferencia abductiva verdadera del simple emparejamiento de patrones.

Alicia
Exacto. Y una vez que esos circuitos están aislados, los investigadores podrían intervenir para mejorarlos.

Beto
Como reparar físicamente el cerebro de la IA.

Alicia
Básicamente sí, amplificando directamente la capacidad de la IA para razonar en lo desconocido. Proporciona una solución tangible basada en ingeniería a un problema que comenzó como un debate filosófico hace siglos.

Beto
Realmente lo trae de vuelta al círculo.

Veamos más lejos y resumamos las ideas centrales de esta investigación.

Rastreamos el concepto de razonamiento abductivo hasta Charles Sanders Peirce, quien lo definió como "la lógica del descubrimiento". Es el proceso de adivinación ampliativo de adivinar el "por qué", para introducir ideas genuinamente nuevas.

Exploramos cómo la confusión filosófica entre generar una suposición, y evaluar una suposición, condujo a un panorama de pruebas altamente fragmentado en la IA.

Alicia
Y examinamos cómo el plano unificado de dos etapas, inferencia a la mejor explicación, permitió a los investigadores finalmente probar la realidad de los sistemas de IA modernos de manera objetiva.

Beto
Y esos resultados empíricos apuntan a un punto ciego bastante innegable. Los modelos más grandes de 2026 que operan con mil millones de parámetros pueden evaluar una lista de opción múltiple con casi certeza matemática.

Alicia
Increíble precisión, sí.

Beto
Pero cuando se les obliga a generar una teoría desde una página en blanco, su rendimiento cae drásticamente. Los datos prueban que deducir un hecho en la generación de una hipótesis son músculos cognitivos totalmente diferentes.

Alicia
Lo son.

Beto
La chispa humana de la ingeniería inversa de un problema sigue siendo un obstáculo masivo para las máquinas.

Alicia
Define la frontera para la próxima generación de inteligencia artificial. Quiero decir, hemos dominado la calculadora deductiva y ahora estamos intentando diseñar la capacidad para el descubrimiento abductivo.

Beto
Lo que nos deja con un experimento mental pendiente para considerar mucho después de que cerremos hoy.

Si los investigadores siguen esta hoja de ruta, si eventualmente ejecutan esa resonancia magnética funcional digital, mapean los circuitos abductivos precisos dentro de una inteligencia artificial y aíslan la matemática de adivinar, ¿qué encontrarán?

Alicia
Es una pregunta profunda.

Beto
Mientras que mapear ese circuito sirve como un espejo de cómo funciona realmente la intuición humana, ¿veremos nuestra propia chispa creativa reflejada en las capas neuronales? ¿O descubriremos que el método de una máquina para encontrar la pieza faltante está impulsado por una lógica totalmente ajena, como una forma de conectar lo desconocido que ni siquiera podemos empezar a comprender?

Alicia
Una lógica ajena del descubrimiento, plantea preguntas fundamentales sobre si el razonamiento humano es el único camino válido para comprender lo desconocido.

Beto
Realmente lo hace.

Para todos los que nos escuchan, gracias por acompañarnos en esta exploración de la mente artificial.

Sigan cuestionando los sistemas en los que confían, manténganse curiosos, y sigan buscando "el por qué" en sus propias vidas.

Hasta el próximo análisis profundo.

miércoles, 10 de diciembre de 2025

Los LLMs son Invertibles - Fin de la Caja Negra


Recientemente publicaron un artículo científico muy importante, que prueba que los LLMs son invertibles, es decir, lo que antes se consideraba una caja negra, se debe ahora ver como una caja transparente. A partir de unos embeddings, se puede reconstruir el texto original que se dio como entrada de consulta a un LLM. Eso tiene muchas implicaciones: entre otras, se puede construir un algoritmo para dar explicaciones que ayuden a entender qué sucede dentro de un LLM durante el proceso de inferencia. Y lo que es grave para privacidad, ahora los espías pueden reversar el estado del LLM y ver qué estaba la gente consultando.

Enlaces a las fuentes de este artículo, para aquellos que quieran profundizar en el tema:

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Si alguna vez has tenido uno de esos momentos, estás escribiendo algo sensible en la ventana de chat de una IA. Una consulta privada, una pregunta embarazosa o incluso solo el borrador de un pensamiento sobre el que dudas.

Alicia
Oh, sí.

Beto
Entras en pánico, pulsas eliminar y piensas que ya se ha ido. Lo ha devorado el sistema.

Alicia
Confías en el proceso. Confías en que simplemente ha desaparecido.

Beto
Exacto. Y durante mucho tiempo, toda la comunidad científica… bueno, estuvo de acuerdo contigo.

Todos creíamos que estas enormes IAs, estos LLMs, eran básicamente como "licuadoras digitales".

Alicia
Es una gran analogía.

Beto
Arrojas tus palabras, tus secretos, cualquiera que sean los ingredientes, y esta máquina de miles de millones de parámetros lo mezcla todo en un batido, una respuesta. Y la suposición clave, la parte crítica, era que nunca, jamás podrías recuperar los ingredientes originales.

Alicia
La información se perdería de forma fundamental; quedaría irreversiblemente mezclada.

Beto
Esa creencia estaba equivocada. Peligrosamente equivocada.

Así que la misión de este análisis profundo es desenmarañar una bomba silenciosa que aterrizó en el mundo de la IA en octubre de 2025. Era un denso PDF titulado simplemente "Los Modelos de lenguaje son inyectables, y, por lo tanto, invertibles".

Alicia
No es precisamente un título pegadizo.

Beto
Para nada. Pero demostró que estas IAs no son licuadoras. Son dispositivos de grabación impecables y perfectos. Y para cualquier cosa que jamás hayas tecleado en ellas, el botón de eliminar nunca fue real.

Vamos a profundizar en por qué esto abre "la era de la IA caja de cristal”, y por qué también puede ser quizá la peor pesadilla de privacidad que hayamos visto.

Alicia
Para entender bien el impacto, hay que volver a lo que llamábamos "la era de la caja negra". Quiero decir, durante años tratamos a los LLMs como sistemas demasiado vastos, demasiado complejos para que los comprendiéramos de verdad.

Beto
Sabíamos que la receta funcionaba, pero no podíamos mirar dentro de la cocina.

Alicia
Exacto. Esa era la analogía que usábamos todos.

Le das al “chef” — la IA — tus ingredientes, tu prompt, y sale un pastel perfecto: la salida. Pero lo que ocurre dentro de la cocina, dentro del espacio latente o estado oculto de la IA, era un completo misterio.

Beto
Era una caja negra.

Alicia
Y la suposición de que el proceso era intrínsecamente con pérdida (lossy) parecía completamente lógica; estaba arraigada en la arquitectura de los propios modelos. Cosas como las activaciones no lineales, las capas de normalización se consideraban herramientas matemáticas que tenían que destruir información.

Beto
Por favor explícalo. ¿Por qué la gente pensaba que los componentes estaban destruyendo los datos?

Alicia
Piénsalo: para convertir texto crudo en un pensamiento coherente, la IA tiene que comprimir cosas, combinar datos. Esas funciones, esas activaciones, están diseñadas para aplastar, estirar y filtrar estas enormes matrices de números.

Beto
Como convertir un objeto 3D en una sombra 2D.

Alicia
Exactamente. Inevitablemente pierdes información, algo de profundidad. La lógica era que dos entradas ligeramente diferentes — por ejemplo “el gato se sentó en el tapete” frente a “el felino descansó en la alfombra” — acabarían siendo aplastadas hasta dar exactamente el mismo estado interno, porque la IA se centraría en el significado central. Si dos entradas distintas pueden conducir al mismo estado interno, el proceso es con pérdida, es irreversible.

Beto
Y eso tenía enormes implicaciones en el mundo real.

Alicia
Masivas. Era la mayor barrera para la confianza y la seguridad. ¿Cómo puedes poner una IA en un hospital o hacer que apruebe un préstamo bancario si no puedes abrir esa caja para comprobar sesgos? O incluso solo para explicar su razonamiento: estábamos volando a ciegas.

Beto
Entonces apareció ese artículo y dijo: "en realidad, la base es cristalina". Y aquí entra la idea de inyectividad.

Alicia
La inyectividad es el concepto matemático central que destruye por completo la idea de la caja negra.

Beto
Para simplificar: todos hemos usado sistemas no inyectivos. Piensa en una vieja máquina de chicles: metes una moneda (tu entrada) y puede salir un chicle rojo, azul o amarillo.

Alicia
No puedes predecirlo.

Beto
Ver un chicle rojo no te dice nada sobre la moneda.

Alicia
Muchas entradas, misma salida.

Beto
Pero un sistema inyectivo es como una máquina expendedora moderna: presionas B4 y obtienes una cola. Cada vez. Mapeo uno a uno. Sin colisiones.

Alicia
Todo el mundo — literalmente todo el mundo — asumía que los LLMs eran la máquina caótica de chicles: con miles de millones de oraciones posibles, tenía que haber colisiones en ese espacio interno. Parecía obvio.

Beto
Pero no lo son.

Alicia
Son máquinas expendedoras perfectas e infinitamente grandes. Eso fue lo que demostró el artículo. La frase “el firmamento es azul” crea una huella interna totalmente única — lo llamaron “estado cerebral 5.829” — y una frase similar como “los cielos son azures” crea un estado completamente distinto y único, quizá “estado cerebral 9.000.000”. La IA no lo reduce todo a una sola idea “cielo azul” en ese nivel profundo.

Beto
Espera: ¿no era ese el objetivo de un espacio de embeddings, encontrar el significado compartido entre frases similares?

Alicia
Ahí está la genialidad contraintuitiva de lo que encontraron. La IA sí abstrae significado en sus capas finales para generar texto. Sí. Pero en un nivel de codificación fundamental —el espacio latente— guarda un registro perfecto y meticuloso. El artículo mostró que el cambio más diminuto, como añadir o quitar un solo punto, crea una huella interna totalmente nueva y única. Cada entrada posible está codificada perfectamente y de forma única. Uno a uno.

Beto
Si la inyectividad significa que una entrada única crea un estado cerebral único, la invertibilidad significa que puedes ir hacia atrás: si ves el estado cerebral, puedes reconstruir la entrada.

Alicia
100%. El sistema está roto (en el sentido de que ya no preserva anonimato). Si tienes el estado interno, puedes reconstruir el texto exacto que lo generó. Y los investigadores no se quedaron solo en la teoría: nos mostraron cómo hacerlo.

Beto
El avance en tres pasos: la matemática, el experimento y la herramienta real.

Empecemos por la matemática. ¿Cómo probaron que la “licuadora” podía realmente licuar?

Alicia
Examinaron los bloques constructores del LLM — los embeddings, la atención, las MLP (perceptrones multicapa), que son como los principales circuitos de toma de decisiones — y demostraron que esos componentes son lo que los matemáticos llaman "funciones reales analíticas".

Beto
Suena denso, ¿cómo lo traducimos?

Alicia
Piénsalo como una suavidad perfecta: una función real analítica es una curva totalmente suave y continua, sin quiebres ni aristas; es matemáticamente predecible en cada punto. El artículo probó que, como todo el LLM está construido a partir de estas partes suaves y predecibles, el sistema es fundamentalmente incapaz del tipo de plegamiento o compresión que haría que dos entradas distintas acabaran en el mismo punto.

Beto
¿Así que está construido para evitar colisiones?

Alicia
Por su propia naturaleza, sí. Demostraron que la probabilidad de una colisión ocurre en lo que se llama "un conjunto de medida cero" ("measure zero set"), que básicamente significa que es como lanzar un dardo a un mapamundi y acertar en un átomo específico que nombraste antes: teóricamente posible, pero prácticamente imposible. Y esto es crítico. La forma en que entrenamos estos modelos con descenso por gradiente preserva esa inyectividad: los modelos nacen así y el entrenamiento lo consolida.

Beto
La matemática estaba sólida. Pero la teoría es una cosa y el mundo real es otra, así que el paso dos fue el experimento: la confirmación.

Alicia
Exacto. Se convirtieron en cazadores de colisiones. Probaron seis modelos grandes — GPT-2, Gemma de Google, Llama 3.1, Mistral 5.4 — con literalmente miles de millones de pruebas, introduciendo prompts ligeramente distintos y comparando los estados internos.

Beto
¿Y los resultados?

Alicia
Cero colisiones. Cero. Categórico. De miles de millones de intentos. Algunos estados cerebrales estuvieron muy cerca, como cabría esperar de oraciones similares, pero siempre separados por una distancia medible; la distancia mínima que encontraron seguía estando a años luz de una colisión verdadera.

Beto
No es una tasa de fallo: es una ley de la física para estas cosas.

Alicia
Confirmó que la matemática era correcta. Los sistemas son inyectivos, punto.

Beto
Lo último fue la herramienta práctica que hace todo esto real: la “anilla decodificadora”. SipIt. "Sequential Inverse Prompt via Iterative Updates". Es un prompt inverso secuencial mediante actualizaciones iterativas. Trata el estado cerebral de la IA como una coordenada en un enorme mapa topográfico. El texto original, tu prompt, está en el punto más bajo de un valle específico en ese mapa.

Alicia
No solo en algún lugar del valle, sino exactamente en el fondo. SipIt usa un método basado en gradientes para caminar valle abajo. Dado que la matemática prueba que solo hay un fondo en ese valle, garantiza la recuperación exacta al 100% del prompt: puntuación, espacios, todo.

Beto
Y es rápido. Tiempo lineal. No es solo teoría; es una herramienta práctica que realmente puedes usar.

Alicia
Es de nivel industrial.

Beto
Así que la caja negra está hecha añicos. Estamos en "la era de la caja de cristal". Desgranemos las implicaciones porque esto es asombroso.

Alicia
Y a la vez maravilloso y aterrador.

Empecemos por lo maravilloso: transparencia. Es el mayor avance en interpretabilidad de la IA jamás visto. Ese estado interno es ahora una grabadora de vuelo perfecta e ineditable de los pensamientos de la IA.

Beto
Por fin podemos ver los pasos que sigue para llegar a una respuesta.

Alicia
Podemos. Toma esa IA que da un diagnóstico médico extraño. Antes solo decíamos: bueno, el algoritmo se comportó raro. Ahora podemos usar SipIt, capturar el estado interno en ese momento exacto y decodificar qué estaba “pensando”. ¿Se fijaba en la resonancia magnética del paciente o se obsesionó con algún comentario irrelevante en las notas?

Beto
Finalmente podemos auditar su razonamiento.

Alicia
Podemos depurar la mente de la IA para industrias reguladas, por equidad, por seguridad — esto lo cambia todo.

Beto
Es enorme.

Pero toda herramienta poderosa tiene un uso dual. El lado aterrador es que esa grabadora de vuelo perfecta lo registró todo: ese mensaje borrado, ese secreto; no ha desaparecido, está perfectamente codificado.

Alicia
Y si alguien obtiene acceso a ese estado de activación, esa cadena de números, puede usar SipIt para reconstruir tu texto original palabra por palabra. De repente, los estados cerebrales del LLM son una de las formas de datos más sensibles del planeta.

Beto
El atacante ni siquiera necesita tus registros de chat: solo necesita robar el estado interno del modelo mientras hablas con una IA de atención al cliente, ...

Alicia
... y puede reconstruir toda la conversación.

Piensa en el caos regulatorio: autoridades de protección de datos, como la de Hamburgo, operaban bajo la suposición — y esta es la frase clave — de que los datos de entrenamiento no podían ser "reconstruidos de forma trivial".

Beto
Ese resquicio protegía la privacidad.

Alicia
Este artículo no solo desafía eso; lo aniquila. Prueba que en tiempo de inferencia, en el momento en que escribes algo, tu entrada es totalmente y trivialmente recuperable con un algoritmo rápido. La privacidad de los datos ya no trata solo de lo que envías: trata de los pensamientos perfectamente recuperables que esos datos crean dentro de una mente artificial.

Beto
La era de la caja negra ha terminado.

Alicia
Es un punto de inflexión fundamental. Lo compararía con el descubrimiento de la estructura del ADN: abrió la puerta a curas milagrosas, pero también a posibilidades aterradoras. Ahora conocemos el código fundamental de estas mentes artificiales, y ese código se apoya en una base de memoria perfecta e indeleble.

Beto
El código está roto, la caja está abierta. Ahora que sabemos que son grabadoras perfectas, ...

  • ¿qué construiremos sobre esa base?
  • ¿Será un futuro de IA transparente y confiable que pueda explicarse a sí misma?
  • ¿O un futuro de vigilancia perfecta, donde cada pensamiento que tecleaste sea recuperable?

La respuesta depende de las protecciones que exijamos ahora, sabiendo que esos estados cerebrales no son solo pensamientos, sino registros perfectos. Piensa en ello la próxima vez que le hagas a una IA una pregunta privada.

jueves, 4 de diciembre de 2025

Modelos Multimodales Aplicados a Medicina


Uno de los campos profesionales donde se aplica la Inteligencia Artificial (IA) es la Medicina. El siguiente es un resumen de un artículo científico que lista los modelos multimodales aplicados a la medicina, y los enfoca desde el punto de vista de la tecnología, sus aplicaciones y los desafíos a los que se encuentran.

Enlace al artículo, para aquellos que quieran profundizar en el tema: "Multimodal Large Language Models for Medicine: A Comprehensive Survey", por Jiarui Ye y Hao Tang. Publicado el 29 de Abril del 2025.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Bienvenidos a un nuevo análisis profundo. El programa donde abordamos algunos de los temas más complejos y de rápida evolución. Extraemos los conocimientos más importantes para que puedas estar instantáneamente bien informado.

Hoy nos centramos en una de las áreas de innovación con más carga: la integración de la IA en la medicina. Específicamente, hacemos una inmersión profunda en los modelos de lenguaje grandes multimodales, o MLLMs. Y nuestro material fuente para esto es una enorme síntesis. Hablamos de más de 330 artículos de investigación recientes.

Beto
Correcto. Y nuestra misión hoy es realmente ir más allá del bombo general. Ya sabes, se oye todo el tiempo sobre modelos solo de texto como GPT‑4. Pero necesitamos enfocarnos en los MLLMs porque, francamente, son el siguiente paso necesario para cualquier uso clínico real.

Alicia
¿Por qué? ¿Por qué lo multimodal es la clave?

Beto
Porque la propia medicina es multimodal. Un médico maneja imágenes, texto, audio, vídeos quirúrgicos, marcadores genéticos, todo eso. Y un LLM, por sí solo, solo maneja texto. Un médico trata con la realidad.

Alicia
Precisamente. Así que hoy vamos a desglosar tres áreas centrales. Primero la tecnología: cómo es posible esa integración multimodal.

Luego las principales aplicaciones clínicas que existen ahora.

Beto
Por ejemplo, generar informes, cirugía, ese tipo de cosas.

Alicia
Exacto. Y, lo más crítico, los desafíos inmediatos que estos modelos deben superar antes de que puedan ser confiables en un entorno clínico real.

Bien, empecemos por la base. Todos más o menos conocemos la historia ahora. Los modelos modernos de lenguaje realmente despegaron con la arquitectura "transformer", allá por 2017. Esa innovación, el mecanismo de "self‑attention", llevó a los enormes modelos de texto que conocemos, como la serie GPT.

Beto
Y esos modelos de texto fueron revolucionarios. Pero lo fascinante es lo rápido que el campo médico se dio cuenta de que tenían que pivotar.

Alicia
¿Por qué? ¿Porque el texto no es suficiente?

Beto
Ni de lejos. Los LLMs son excelentes resumiendo historias clínicas o redactando notas de paciente. Pero la atención sanitaria se trata fundamentalmente de correlacionar múltiples tipos de datos al mismo tiempo.

Alicia
Exacto, un cardiólogo no solo está leyendo notas.

Beto
Exacto. Está mirando notas textuales, sí, pero también lecturas de ECG, vídeos de ecografía, quizá incluso secuencias genómicas. Para ayudar realmente en una tarea compleja, el sistema tiene que combinar todo eso.

Alicia
Eso suena como un desafío técnico enorme. Quiero decir, si tienes datos que vienen de un escáner CT de alta resolución, que es visual, y del historial de texto de un paciente, ¿cómo hace el sistema para que se comuniquen entre sí? ¿No se pierde algo?

Beto
Ese fue el salto crítico que los LLMs tuvieron que resolver. Y la arquitectura central es en realidad bastante elegante. Usa el LLM como el cerebro, la parte central de razonamiento. Pero los datos no van directamente al cerebro. Primero tienes estos codificadores especializados por modalidad. Toman la entrada cruda — una radiografía, un archivo de audio — y extraen las características clave.

Alicia
Y luego viene la parte mágica.

Beto
Viene un módulo crucial llamado "módulo de alineamiento".

Alicia
¿Qué hace en realidad el módulo de alineamiento?

Beto
Piénsalo como un traductor universal. Toma esas características no textuales de los codificadores y las convierte al lenguaje conceptual que el LLM entiende.

Alicia
¿Entonces convierte la imagen de un tumor en algo que el cerebro basado en texto puede procesar?

Beto
Perfectamente dicho. Traduce esa información visual en vectores de embedding que corresponden a conceptos textuales. Así, ahora el LLM puede procesar esa imagen del tumor junto con un informe de biopsia escrito.

Alicia
Esa explicación estructural realmente ayuda. Nos da la base. Ahora vayamos al “y qué”. ¿Cómo se está usando esta tecnología en la práctica? Encontramos tres aplicaciones principales, empezando por la documentación.

Beto
Bien. La primera y probablemente la más adoptada es la generación de informes médicos.

Alicia
Esto ahorra una enorme cantidad de tiempo a los doctores.

Beto
Muchísimo. Profesionales altamente cualificados como los radiólogos pasan horas cada día redactando informes detallados basados en rayos X, TACs, resonancias. La esperanza con la IA es reducir ese tiempo y disminuir errores sencillos.

Alicia
La investigación da un gran ejemplo: XrayGPT. ¿Puedes explicarnos cómo funciona ese y, quizá más importante, dónde falla?

Beto
Claro. XrayGPT toma la imagen, extrae características con un codificador visual y luego ese módulo de alineamiento que comentamos pasa esas características al LLM médico.

Alicia
Y entonces le haces preguntas.

Beto
Le haces una pregunta del tipo: “¿Cuáles son los hallazgos principales y las impresiones de esta radiografía?” y genera un informe.

Alicia
Pero aquí está la parte crucial. Los informes médicos tienen una estructura lógica muy estricta. Tienes los hallazgos, las observaciones objetivas, y luego la impresión, que es el resumen final.

Beto
Exacto. Y esto es un enorme reto clínico destacado en la investigación. Estos LLMs suelen sacar puntuaciones muy altas en benchmarks. Pasan el examen. Pero funcionan mal en el mundo real. Y es porque se vuelven muy buenos generando una impresión que suena plausible pero les falta la habilidad inferencial profunda para conectarla lógicamente con los hallazgos.

Alicia
Pueden listar observaciones, pero no pueden realmente diagnosticar la enfermedad.

Beto
Es una gran analogía: es la diferencia entre memorización y razonamiento verdadero. Y esa incapacidad para conectar los puntos es una preocupación de seguridad enorme.

Alicia
Bien, eso es eficiencia.

La segunda aplicación que abordamos es algo más suave: la atención al paciente.

Beto
Se trata de comunicación médica profesional y compasiva. Todos sabemos que los chatbots solo de texto fracasaron bastante aquí.

Alicia
La brecha de empatía.

Beto
Exacto. Los pacientes necesitan sentirse comprendidos, no simplemente procesados por una máquina.

Alicia
Y los LLM intentan arreglar eso incorporando todos esos datos no textuales que un médico humano captaría de forma natural en una habitación.

Beto
Precisamente. Si un paciente escribe un mensaje de texto, perfecto, un sistema solo de texto no tiene forma de saber si es genuino o sarcástico. Un LLM multimodal puede entrenarse para analizar movimiento facial, lenguaje corporal, seguimiento ocular, incluso el ritmo y el tono de la voz. Así, sistemas como ChatDoctor o LLaVA-Med pueden obtener una imagen mucho más precisa del estado real del paciente.

Alicia
Nuestra tercera aplicación va a un entorno de muy alta responsabilidad: el quirófano. Hablamos de asistencia clínica en cirugía.

Beto
Modelos como SurgicalGPT se están desarrollando para responder a preguntas rápidas basadas en vídeo quirúrgico en vivo. Se llama "Visual Question Answering" (VQA).

Alicia
La idea de una IA que observa un procedimiento y da análisis en tiempo real es revolucionaria.

Beto
Lo es, pero la limitación aquí es importante y, francamente, plantea banderas de seguridad inmediatas.

Alicia
Si pasan por alto detalles claves en radiología, ¿qué pueden estar perdiendo en cirugía?

Beto
Los modelos VQA quirúrgicos actuales tienden a centrarse solo en el área inmediata de la enfermedad, el órgano objetivo.

Alicia
Así que tienen visión de túnel.

Beto
Visión de túnel total. Con frecuencia pasan por alto información de fondo crucial, como el movimiento de una herramienta quirúrgica, el estado operativo general o signos de sangrado justo fuera de su foco principal.

Alicia
Y pasar por alto el movimiento de instrumentos en un quirófano es un riesgo inaceptable. Conduce a una comprensión defectuosa del procedimiento y podría causar un error catastrófico.

Entonces, si estos MLLMs son el motor, el combustible debe ser una diversidad increíble de datos médicos. Entremos en las seis modalidades principales que deben dominar, empezando por los clásicos.

Beto
Comenzamos con imágenes radiológicas: resonancias magnéticas para tejido blando, las radiografías estándar y luego los TACs.

Alicia
Y los TACs son particularmente complicados, leí.

Beto
Son muy desafiantes. Te dan estas hermosas secciones transversales en alta resolución de la anatomía, pero la pura dimensionalidad de esos datos — estás tratando con espacio 3D — crea enormes problemas de estabilidad y precisión para los modelos.

Alicia
A continuación, imágenes fotográficas. Esto es más directo, ¿no?

Beto
En parte. Son visuales de dispositivos ópticos: imágenes de dermatología de la piel, imágenes de oftalmología del ojo, o imágenes de endoscopia de, por ejemplo, pólipos en el recto. ChatGPT4 es un buen ejemplo aquí.

Alicia
Luego hay una que me pareció muy interesante: datos de audio. Es más que conversación.

Beto
Mucho más. Incluye sonidos que realmente transmiten estado de salud. La investigación menciona un modelo llamado RespLLM.

Alicia
¿Qué hace eso?

Beto
Convierte sonidos como toses y patrones respiratorios en espectrogramas para predecir la salud respiratoria general. Y en algo como la consulta psicológica, el tono y el tempo de la voz del paciente son puntos de datos críticos.

Alicia
Para la medicina personalizada, tenemos que hablar de todos los datos ómicos. Esto es la información de plano, ¿no?

Beto
Es el genoma, el proteoma, el transcriptoma, todos los datos moleculares complejos que determinan cómo funciona tu cuerpo. Es absolutamente crucial para la medicina personalizada, pero es increíblemente difícil de integrar con otros datos clínicos.

Alicia
Y, por supuesto, finalmente está el dato textual: la base.

Beto
Historias clínicas electrónicas, informes médicos detallados, enormes conjuntos de diálogo como MedDialog, y por supuesto toda la literatura científica para razonamiento basado en evidencia.

Alicia
Dicho todo esto, pensarías que los MLLMs tienen material de entrenamiento sin límite. Pero nos topamos de frente con lo que la investigación llama "la paradoja de la escasez".

Beto
Los datos médicos son en realidad increíblemente escasos.

Alicia
¿Por restricciones legales, éticas y de privacidad?

Beto
Exacto. Cosas como la Ley de Portabilidad y Responsabilidad del Seguro Médico ("Health Insurance Portability and Accountability Act", HIPAA) limitan severamente el acceso. Esto realmente daña el rendimiento del modelo, especialmente para enfermedades raras donde simplemente no hay conjuntos de datos públicos grandes con los que entrenar.

Alicia
Así que esta escasez obliga a la industria a ponerse creativa.

Beto
Muy creativa. La atacan por dos frentes. Primero, soluciones basadas en el modelo: en lugar de exigir más datos, afinarán un modelo potente existente — por ejemplo convertir "PaLM" en "Med-PaLM" —. Se concentran en potenciar sus habilidades inferenciales para que dependa menos de la memorización de datos.

Alicia
Y la segunda solución es, creo, aún más fascinante: la augmentación basada en datos. Si no puedes obtener los datos, los fabricas.

Beto
Generas datos sintéticos de alta calidad. Por ejemplo, los investigadores usan modelos como GPT‑4 para crear preguntas y respuestas basadas en libros de texto médicos. O generan leyendas detalladas y formateadas para imágenes públicas existentes.

Alicia
Básicamente construyen su propio currículo de entrenamiento de alta calidad ...

Beto
... desde cero para sortear las barreras regulatorias. Es una solución ingeniosa.

Alicia
Esto nos lleva a lo que podría ser la sección más crítica. Porque por muy ingeniosa que sea la tecnología, estos modelos tienen que cumplir los estándares más altos antes de tocar una vida humana.

Beto
Correcto. Debemos hablar de profesionalismo, seguridad y equidad.

Alicia
Empecemos con el Desafío Uno: Profesionalismo. El modelo tiene que pensar y hablar como un especialista. ¿Cómo medimos eso?

Beto
Bueno, hay dos formas principales. Una es la valoración manual por expertos, donde médicos humanos puntúan las salidas del modelo en cosas como exactitud y utilidad.

Alicia
Y la otra es hacer que tomen exámenes profesionales.

Beto
Correcto. Hacemos que los modelos se presenten a evaluaciones profesionales como el Examen para la Licencia Médica de los EE.UU. ("United States Medical Licensing Examination,", USMLE).

Alicia
Y las puntuaciones son impresionantes, ¿no? Vi que GPT‑4 y Med-PALM obtienen más del 86% de acierto.

Beto
Las cifras suenan increíbles, pero aquí está el punto clave al que volvemos una y otra vez.

Alicia
Si obtuvieron 86% en los exámenes médicos, ¿por qué siguen fallando en la clínica? ¿Cuál es la desconexión?

Beto
La desconexión es la inferencia. Las altas puntuaciones muestran competencia y recuerdo. Han memorizado mucha información. Pero la práctica clínica real exige inferencia profunda: aplicar el conocimiento a una situación de paciente completamente nueva y dinámica.

Alicia
Así que conoce el libro de texto, pero no puede manejar el mundo real.

Beto
Precisamente. Y la falta de ese razonamiento profundo es una falla persistente. Incluso están recurriendo a construir diccionarios especializados solo para evitar que los modelos cometan errores básicos, como dividir la palabra “cardiomegalia” en partes...

Alicia
Desafío Dos posiblemente sea el mayor destructor de confianza: las alucinaciones. El modelo simplemente genera información que suena plausible pero está completamente fabricada. Puede sonar totalmente confiado mientras está peligrosamente equivocado.

Beto
Este es el obstáculo principal para la credibilidad. En los MLLMs a menudo aparece como una mala identificación, especialmente con imágenes. La investigación las clasifica como "alucinaciones de tipo, propiedad o relación".

Alicia
¿Un ejemplo?

Beto
Piensa en el ejemplo quirúrgico: el modelo ve una herramienta en una herida. Podría apoyarse en un estereotipo aprendido sobre la relación entre esa herramienta y ese tipo de herida. Prioriza su patrón aprendido sobre los datos visuales únicos que está viendo.

Alicia
Está viendo lo que espera ver, no lo que realmente hay. ¿Cómo se arregla eso?

Beto
Se pueden usar soluciones técnicas como la segmentación de imágenes: fuerzas al modelo a concentrarse en las partes clave de la imagen, lo que evita suposiciones generales. O se construyen estructuras de auto‑verificación donde tiene que contrastar su salida con los datos fuente antes de dar una respuesta.

Alicia
Y el último desafío es la equidad y el sesgo. Esto es enorme. La IA es tan buena como los datos con los que se entrena.

Beto
Si esos datos están sesgados, el consejo clínico estará sesgado. El desequilibrio en los datos y los prejuicios sociales incrustados pueden influir gravemente en los resultados.

Alicia
¿Qué encontró la investigación?

Beto
Citó ejemplos de modelos que predicen mayores costes o estancias hospitalarias más largas para poblaciones blancas, o reducen las tasas de tratamiento para grupos minoritarios, todo por estereotipos incrustados en los datos de entrenamiento.

Alicia
¿Es discriminación algorítmica?

Beto
Eso es exactamente lo que es. Y debe abordarse de forma proactiva. Se puede hacer a nivel de datos filtrando o remuestreando, y a nivel de modelo usando cosas como aprendizaje por refuerzo a partir de la retroalimentación humana ("Reinforcement Learning from Human Feedback", RLHF) ...

Alicia
... para alinearlo con valores humanos.

Beto
Para alinearlo con los valores médicos y éticos humanos, sí. Un sentido de empatía reforzado.

Alicia
Ha sido una inmersión realmente fascinante. Está claro que los MLLMs prometen un futuro de atención sanitaria de bajo coste y alta eficiencia. Es un verdadero cambio de paradigma.

Beto
La promesa es enorme. Pero como hemos dicho, el desafío del mundo real que une todo esto es el despliegue. Irónicamente, las regiones que más necesitan esta tecnología — lugares con pocos especialistas y recursos médicos escasos — a menudo carecen de la infraestructura técnica masiva para ejecutar estos modelos.

Alicia
Son simplemente demasiado grandes y consumidores de energía.

Beto
Exacto. Así que para ti, el aprendiz, la idea clave a mantener es esta: el futuro de la IA equitativa en medicina no es solo hacer modelos más inteligentes. Es hacerlos más pequeños.

Alicia
El imperativo moral definitivo es crear soluciones ligeras.

Beto
De verdad. Hablamos de técnicas como LoRA y QLoRA, que permiten a los desarrolladores congelar la mayor parte de un modelo enorme y ajustar solo una fracción mínima.

Alicia
¿Qué hace eso en la práctica?

Beto
Reduce drásticamente la carga de cómputo. Permite el despliegue en el borde, ejecutar estos complejos MLLMs directamente en un smartphone o un dispositivo wearable. Así es como se asegura que los beneficios de esta medicina de alta tecnología lleguen realmente a los lugares con mayores carencias.

Alicia
Por tanto, la optimización técnica no es solo un problema de ingeniería.

Beto
En este campo, la optimización técnica es un imperativo moral.