Mostrando entradas con la etiqueta optimización. Mostrar todas las entradas

viernes, 18 de septiembre de 2026

DeepSeek-V4.1-Flash - Informe técnico

La fuente proporcionada detalla el modelo DeepSeek-V4.1-Flash, una IA multimodal alojada en Hugging Face que admite entradas de imagen y texto. Esta documentación técnica destaca que el modelo utiliza precisión de 8 bits y el formato fp8 para mejorar la eficiencia en las tareas de generación de texto. Los desarrolladores pueden implementar el modelo a través de diversas plataformas, como vLLM y SGLang, que facilitan su ejecución local mediante Python o Docker. La página también proporciona acceso a un informe técnico completo e instrucciones específicas para realizar llamadas a la API del servidor del modelo. En definitiva, la información sirve como guía práctica para integrar e implementar este modelo transformador de alto rendimiento en diversos entornos computacionales.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression". Por el equipo de investigación de DeepSeekAI. Publicado el 17 de Septiembre de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Imagina entonces un conglomerado tecnológico masivo, digo, solo un conglomerado tecnológico multimillonario, el tipo de almacenes gigantescos, centros de datos, financiación interminable.

Alicia
Sí. Y tienen la primera opción sobre todas las GPUs Nvidia más avanzadas y de vanguardia.

Beto
Exacto. Ahora, quiero que imagines un azaroso desfavorecido, como un laboratorio chino más pequeño con una fracción del tamaño del equipo, acceso restringido al hardware y definitivamente sin un pozo sin fondo de financiación para cómputo.

Alicia
Naturalmente pensarías que el gigante tecnológico masivo gana esa carrera siempre.

Beto
Claro. Pensarías que es una victoria garantizada.

Pero mientras hoy nos sumergimos en cómo ese azaroso desfavorecido logró superar a los mayores jugadores del mundo.

Alicia
Honestamente, es un escenario fascinante de David contra Goliat. Estamos viendo una clase magistral y optimización de software hoy. Porque cambia por completo la perspectiva sobre cómo construimos la inteligencia artificial. Se alejaron de simplemente usar la fuerza bruta del hardware para reimaginar completamente la arquitectura desde cero.

Beto
Así que nuestra misión para esta inmersión profunda es desempacar este nuevo modelo DeepSeek V4.1 Flash y las estadísticas sobre el rendimiento son simplemente asombrosas.

High-Efficiency_AI_Model_Engineering_1024.png
DeepSeek V4.1 Flash: La Ingeniería de la Hiper-Eficiencia

Alicia
"Asombrosas" es la palabra correcta.

Beto
Estamos hablando de un modelo multimodal Mixture of Experts (MoE) con 552 mil millones de parámetros. Y puede procesar hasta 1 millón de tokens de contexto.

Alicia
Correcto. Lo cual es enorme.

Beto
Es gigantesco. Y hace todo esto mientras rompe por completo los requisitos normales del hardware.

Alicia
Sí.

Beto
Para ustedes que escuchan, aquí está por qué esto realmente importa. Todos queremos agentes de IA que puedan trabajar de forma autónoma durante días.

Alicia
Exacto. Es el Santo Grial.

Beto
Queremos una IA que pueda ingerir bases de código masivas o procesar miles de documentos financieros densos sin congelarse, o costar una fortuna para funcionar.

Alicia
Y DeepSeek acaba de proporcionar el plano literal de cómo es posible. Su tesis central es brillante porque aborda las realidades físicas del hardware mismo.

En lugar de lanzar más GPUs al problema, DeepSeek logró esto a través de una elegancia arquitectónica pura. Hicieron elecciones que parecían completamente contraintuitivas a primera vista, pero finalmente resolvieron el mayor cuello de botella de la industria hoy.

Beto
Que es la huella del caché KV durante la fase de pre-llenado, ¿verdad?

Alicia
Sí.

Beto
Para entender su genialidad, realmente tenemos que mirar este cuello de botella.

Alicia
Definitivamente. La fase de pre-llenado es esencialmente la fase de lectura. Y el contexto largo requiere mucha memoria para almacenar todas las claves y valores de cada token que la IA lee.

Beto
Correcto. Y dentro de la GPU, tienes memoria de alta capacidad de ancho de banda ("High Bandwidth Memory", o HBM). Es increíblemente rápida. Pero el problema es que tiene una capacidad muy limitada.

Alicia
Correcto.

Beto
Así que en el contexto, que escala hasta un millón de tokens, la HBM se llena instantáneamente.

Alicia
Y cuando la HBM se llena, el sistema tiene que comenzar a descargar ese masivo caché KV a unidades de estado sólido externas.

Beto
Sí, es fácil.

Alicia
Exacto, a través del bus PCIe. Y ahí es donde ocurre el cuello de botella catastrófico. El cuello de botella no es la capacidad de cómputo de la GPU.

Beto
Es el ancho de banda de la memoria.

Alicia
Sí. Cuando el modelo necesita generar el siguiente token, tiene que recuperar todas esas claves y valores desde el SSD, pasarlos a través de la placa base a la HBM, y finalmente al RAM del procesador.

Beto
Quisiera visualizar esto usando una analogía estudiantil.

Alicia
Bueno, me gusta eso.

Beto
Así que la memoria de alto ancho de banda, la HBM, es el escritorio del estudiante. Es súper rápida para tomar apuntes, pero tiene una superficie extremadamente limitada.

Alicia
Claro. Solo puedes meter tantos papeles en un escritorio como quieras.

Beto
Exacto. Así que las unidades SSD externas son como archivadores en otra habitación al final del pasillo. Contienen una cantidad masiva de información, pero tener que ir y volver para revisar tus apuntes lleva una eternidad.

Alicia
Lo cual es terrible para la eficiencia.

Beto
Claro. Si la IA está tratando de procesar un millón de tokens, lo cual es esencialmente semanas de clases, esos apuntes se acumulan y la IA pasa todo su tiempo recorriendo el pasillo en lugar de pensar realmente.

Alicia
Si conectamos esto con la imagen más grande, toda la industria está empujando hacia agentes autónomos que ejecutan tareas largas. Pero este cuello de botella específico del caché KV es el obstáculo principal.

Beto
Porque es demasiada información para mover.

Alicia
Exacto. El volumen abrumador de matrices y las lentas velocidades de transferencia de E/S simplemente matan la eficiencia. Los núcleos de cómputo masivos de la GPU terminan simplemente esperando.

Beto
Oh, vaya. Así que están esperando.

Alicia
Sí. Esperan datos. Literalmente a que las matrices viajen a través de los cables desde el disco duro.

Beto
Okay. Para resolver un problema donde tu IA está básicamente ahogada en sus propios apuntes, DeepSeek hizo algo radical. Básicamente decidieron apagar la mitad del cerebro del modelo durante la fase de lectura.

Alicia
Lo cual suena loco, pero funciona. Introdujeron la arquitectura "codificador-decodificador causal" ("Causal Encoder-Decoder", o CED). En un modelo transformer estándar, cada capa genera su propio caché KV a medida que fluye la información. Pero con CED, el modelo está físicamente dividido.

Beto
Okay.

Alicia
Durante la fase de pre-llenado, la segunda mitad del modelo, el decodificador no hace absolutamente nada. Está funcionalmente apagado. La primera mitad, el codificador procesa toda la entrada, construye la comprensión contextual profunda y genera lo que llaman "el caché KV global".

Beto
Y debido a esa división, el ahorro de recursos golpea instantáneamente a la GPU, ¿verdad?

Alicia
Instantáneamente. Sí.

Beto
Porque durante la fase de decodificación, la fase de escritura, el modelo activa aproximadamente 16 mil millones de parámetros por token. Pero durante la fase de pre-llenado, debido a que la mitad del modelo está en reposo, solo activa unos 8 mil millones de parámetros por token.

Alicia
Exacto. El decodificador simplemente omite generar sus propios apuntes globales y simplemente pide prestado el caché KV global completado directamente del final del bloque del codificador.

Beto
Okay, vamos a desglosar esto porque mi reacción inmediata es, "espera un segundo. Si la mitad del cerebro de la IA omite leer el material fuente por completo, ¿no pierde una gran cantidad de matices?"

Alicia
Esa es la preocupación lógica. Sí.

Beto
Quiero decir, si el decodificador no ha procesado el contexto profundo en sí mismo, ¿cómo sabe lo que está generando realmente? ¿No se vuelve la IA notablemente más tonta?

Alicia
No. Y lo fascinante aquí es entender la diferencia matemática entre el contexto global y local. El decodificador pide prestado ese contexto global, las enormes matrices de claves y valores pesadas del codificador. Pero sigue calculando su propio contexto local usando atención de ventana deslizante.

Beto
Así que todavía está haciendo algo de lectura propia.

Alicia
Claro. Piénsalo como una jerarquía corporativa. Imagina una empresa analizando miles de páginas de informes financieros complejos. No tienes que leer cada página.

Beto
No tiene tiempo para eso.

Alicia
Exacto. Obtienes al analista junior. Esa es la mitad del codificador del modelo para leer todo, procesar los conjuntos de datos masivos y escribir un resumen ejecutivo denso y altamente preciso.

Beto
Y ese resumen es el caché KV global.

Alicia
Exacto. El ejecutivo sénior, que es el decodificador, solo lee ese resumen global para la dirección estratégica amplia.

Beto
Pero cuando es hora de firmar el párrafo específico o escribir una cláusula específica, ese ejecutivo se pone sus gafas de lectura y examina la redacción exacta de esa única página frente a él.

Alicia
Sí. Y esa única página es el contexto local.

Beto
Oh, eso tiene todo el sentido.

Alicia
Así que el decodificador omite los cálculos de atención globales masivos, pero presta extrema atención matemática a los tokens más recientes en su ventana deslizante para ejecutar la escritura perfectamente.

Beto
Así que reducen el cómputo requerido para ingerir documentos a la mitad sin degradar la calidad de la salida real.

Alicia
Exactamente.

Beto
Pero incluso con la mitad del cerebro tomando notas, todavía tenemos una pila masiva de matrices globales y locales para almacenar, ¿verdad? Todavía no hemos resuelto completamente el problema del espacio de escritorio.

Alicia
No, no lo hemos hecho.

Beto
Lo que nos lleva a cómo DeepSeek creó lo que es básicamente una reducción de 437x para su huella de memoria. Los números de compresión en el caché KV global aquí son simplemente asombrosos.

Alicia
Realmente lo son. Para poner las matemáticas en perspectiva, el DeepSeek V1 original requería aproximadamente 390,000 bytes de caché KV por token.

ABeto
Okay, 390,000.

Alicia
Luego el DeepSeek V4 Flash lo redujo a 300-500 bytes.

Beto
Lo cual ya es un salto enorme.

Alicia
Pero el DeepSeek V4.1 Flash requiere unos asombrosos 890 bytes de caché KV global por token.

Beto
Espera, ¿890 bytes?

Alicia
Sí, 800.

Beto
Eso es casi 400 veces más pequeño que la primera generación. Quiero decir, a ese tamaño, garantiza que los nodos globales siempre quepan perfectamente en el escritorio de alta velocidad, la HBM, sin que todo se desborde a los lentos archivadores de SSD.

Alicia
Exacto.

Beto
Pero, ¿cómo se comprime la información tan drásticamente sin perder el significado semántico del texto?

Alicia
Diseñaron un mecanismo llamado "atención dispersa comprimida 2" ("Compressed Sparsed Attention 2", o CSA2), que introduce el concepto de compartición extrema.

Beto
Compartición extrema.

Alicia
Correcto. En un modelo estándar, cada cabeza de atención en cada capa calcula sus propias claves y valores redundantes. Algunas capas se enfocan en la gramática, otras en las relaciones de entidades, pero todas almacenan representaciones independientes masivas del texto fuente.

Beto
Lo que ocupa mucho espacio.

Alicia
Exacto. El CSA2 rompe esa redundancia dándole a las capas tres modos de operación diferentes.

Beto
Okay. El primer modo es el modo completo, ¿verdad? Esta capa hace el trabajo pesado tradicional. Calcula la representación latente completa creando notas totalmente nuevas desde cero. Pero fundamentalmente, también calcula un índice, que actúa como una tabla de contenido muy detallada.

Alicia
Correcto. Así que las capas futuras no tienen que escanear toda la matriz del documento.

Beto
Exacto. Simplemente consultan el índice para encontrar los clústeres semánticos que necesitan.

Alicia
Luego tienes el modo de reindexación. Una capa que opera en modo de reindexación no calcula nuevas representaciones latentes. Simplemente reutiliza las matrices exactas generadas por la capa de modo completo.

Beto
Oh, vaya.

Alicia
Sin embargo, aprende una proyección lineal para crear un índice totalmente nuevo.

Beto
Así que si la capa de modo completo creó un índice basado en fechas cronológicas en el texto histórico, una capa de reindexación toma esas mismas notas base, pero crea un índice basado en, digamos, avances tecnológicos en su lugar.

Alicia
Lo tienes. Mapea una nueva ruta matemática a través del mismo espacio latente sin ocupar nuevo almacenamiento.

Beto
Eso es tan inteligente.

Alicia
Y el modo final es el modo de reutilización, que logra la máxima eficiencia.

Beto
Déjame adivinar, simplemente copia la anterior.

Alicia
Básicamente, sí. Una capa en modo de reutilización crea cero nuevas notas y cero nuevos índices. Esencialmente realiza un mapeo de identidad confiando totalmente en las representaciones que las capas anteriores ya construyeron.

Beto
Así que al mezclar dinámicamente estos tres modos, el volumen total de matrices almacenadas simplemente cae en picada.

Alicia
Cae en picada.

Beto
Pero empujan la optimización aún más, agregaron un guardián llamado "el indexador disperso jerárquico" ("hierarchical sparse indexer").

Alicia
Esta es una de mis partes favoritas.

Beto
Así que al comienzo de la mitad del decodificador, este guardián escanea las notas globales. Si le das a la IA un millón de tokens para leer, este indexador selecciona los 16,000 candidatos más relevantes. Y prohíbe estrictamente a todas las capas subsiguientes mirar el resto.

Alicia
Actúa como un balanceador estricto para los datos.

Beto
Pero espera, tengo que desafiar esto. Si restringes a la IA a solo mirar 16,000 tokens de un millón, ¿no estás rogando prácticamente a la IA que alucine o se pierda detalles críticos?

Quiero decir, ¿cómo puede un guardián en la capa uno saber qué conexiones semánticas la capa 50 va a encontrar relevantes? Eso se siente como tirar el 98% del libro y esperar lo mejor.

Alicia
Suena increíblemente arriesgado. Estoy de acuerdo. Pero lo resolvieron a través de un aprendizaje de representación altamente avanzado.

Beto
Okay. ¿Cómo?

Alicia
DeepSeek entrenó esta piscina de selección de candidatos usando una red de enrutamiento especializada. A través de descenso de gradiente, optimizaron a este guardián para predecir las puntuaciones de atención sin realizar realmente el cálculo del producto punto completo.

Beto
Así que está adivinando, pero con extrema precisión.

Alicia
Exacto. La red de enrutamiento aprende a agrupar los 16,000 tokens más densamente semánticos, perfectamente adaptados a la solicitud del usuario. Es tan altamente preciso que las capas más profundas literalmente ni siquiera se dan cuenta de que falta el resto de la información.

Beto
Eso es salvaje. Literalmente no saben que se ha ido.

Alicia
Claro. Reduce drásticamente el universo de datos que las GPUs deben procesar, ahorrando enormes cantidades de cómputo.

Beto
Okay, así que las notas globales están comprimidas, el escritorio está limpio.

Alicia
Sí.

Beto
Pero todavía tenemos un cuello de botella importante, el contexto local que discutimos antes, la memoria a corto plazo de las conversaciones de múltiples turnos.

Alicia
Sí, el hilo conversacional.

Beto
Claro. Cuando chateas con una IA, guardar ese ida y vuelta de contexto todavía estaba obstruyendo las unidades SSD.

Alicia
Guardar contexto local para cada turno en el SSD es una práctica estándar en la industria. Tienes que hacerlo, para que la IA no pierda el hilo conversacional inmediato.

Beto
Pero recuperarlo crea esa temida latencia, recorriendo el pasillo hasta el archivador.

Alicia
La latencia PCIe. Exacto.

Beto
La solución de DeepSeek a esto se llama "reproducción limitada por límite delimitado" ("SWA bounded replay"). Y es genuinamente impactante. Su solución al bloqueo de la memoria a corto plazo en el disco duro es simplemente borrarla.

Alicia
Puff, se fue.

Beto
Se fue. Cuando la IA termina su respuesta para ti, la memoria a corto plazo de los últimos 128 tokens se evapora. Cuando respondes, la GPU simplemente recalcula esos 128 tokens desde cero, en el momento, cada vez.

Alicia
Lo cual suena completamente al revés.

Beto
Correcto. Aquí es donde se pone realmente interesante. Acabamos de pasar esta inmersión profunda hablando sobre dividir el cerebro y la compartición extrema específicamente para evitar hacer cálculos adicionales. Queremos ahorrar cómputo.

Alicia
Sí.

Beto
Ahora están forzando intencionalmente a la IA a rehacer cálculos desde cero. ¿Cómo tiene sentido hacer exactamente los mismos cálculos dos veces?

Alicia
Lo fascinante aquí es que tienes que mirar la intensidad aritmética cruda de una GPU moderna. Realmente tienes que comparar las dos operaciones.

Beto
Okay, explícalos.

Alicia
Por un lado, tienes la transferencia de datos, tomando datos de la RAM de la GPU, empujándolos a la HBM, luego a través de los carriles PCIe al SSD y finalmente trayéndolos de vuelta.

Beto
Estamos recorriendo el pasillo.

Alicia
Correcto. La latencia de ese movimiento físico se mide en milisegundos. Es dolorosamente lenta para una computadora.

Beto
Okay.

Alicia
Por otro lado, tienes el cómputo puro. Las GPUs modernas son monstruos en la aritmética paralela. A menudo sufren de falta de datos, no de capacidad matemática.

Beto
Interesante.

Alicia
Así que para una arquitectura de GPU moderna, procesar el pase hacia adelante por 128 tokens es una fracción de milisegundo. DeepSeek se dio cuenta de que la matemática es esencialmente gratuita en comparación con el ancho de banda; recalcular esos 128 tokens es en realidad significativamente más rápido que esperar físicamente a que los datos viajen desde el SSD.

Beto
Así que hacer la matemática ahorra tiempo y enormes cantidades de almacenamiento físico.

Alicia
Exacto. Es un intercambio brillante.

Beto
Así que borraron la memoria a corto plazo porque hacer la matemática es más rápido que leer el disco duro. Eso es, eso es genial.

Alicia
Realmente lo es.

Beto
Pero incluso con la memoria completamente despejada, la GPU todavía lucha con la velocidad física de escribir la respuesta y mover los estados intermedios.

Alicia
Correcto. La fase de generación tiene su propia fricción.

Beto
Así que para eliminar toda la fricción dentro de la GPU durante la generación real, agregaron tres componentes suplementarios. Veamos cómo vieron el cuello de botella de la salida, comenzando con la MHC de una pasada.

Alicia
Así que MHC significa "multi-generación de respuestas" ("Multi-Head Cache"). Generar respuestas de IA no es solo una gran ecuación. Involucra mover constantemente valores de matriz intermedios dentro de las diferentes memorias de la GPU.

Beto
Lo que causa atascos de tráfico.

Alicia
Exacto. La MHC de una pasada, alinea matemáticamente estas operaciones, fusionando esencialmente los kernels de atención. Al fusionar las operaciones, la GPU realiza los cálculos mientras los datos aún están en la RAM ultra rápida.

Beto
Oh, así que evita la necesidad de leer y escribir constantemente de vuelta a la HBM, que es ligeramente más lenta.

Alicia
Exacto. Elimina los cuellos de botella de transferencia de datos dentro del chip mismo.

Beto
Luego está la velocidad real de la generación. Los modelos normales producen un token a la vez, comprobando su trabajo linealmente, lo cual es increíblemente lento.

Alicia
Muy lento.

Beto
Para arreglar esto, DeepSeek integró DS Spark.

Alicia
DS Spark cambia por completo la fase de generación al utilizar decodificación especulativa.

Beto
Okay, ¿cómo funciona eso?

Alicia
En lugar de generar un token, pasarlo por todas las capas y luego empezar de nuevo, DS Spark utiliza modelos borrador más pequeños y altamente eficientes para predecir tres o cuatro tokens por adelantado simultáneamente.

Beto
Oh, como un borrador.

Alicia
Correcto. La masa principal del modelo luego verifica esos tokens borradores en paralelo en un solo pase hacia adelante.

Beto
Así que esto permite que el modelo produzca múltiples palabras a la vez.

Alicia
Exacto. Aumenta drásticamente los tokens por segundo de salida sin requerir ningún ancho de banda adicional de memoria.

Beto
Y finalmente, la elección arquitectónica más única para mantener la GPU despejada. El módulo Engram.

Alicia
Sí, el módulo Engram. Esta es una red de memoria separada de 168 mil millones de parámetros.

Beto
Es enorme.

Alicia
Lo es. Pero fundamentalmente, no vive en la costosa y altamente restringida HBM de la GPU. Está físicamente separado, sentado en RAM de servidor estándar y más barato. Su único propósito es memorizar hechos estáticos, fechas históricas, capitales, datos fijos que no requieren razonamiento profundo.

Beto
Es esencialmente un abogado sénior y su asistente.

Alicia
Esa es una forma perfecta de verlo.

Beto
Si estuvieras pagando al abogado sénior, la costosa GPU, cientos de dólares por hora para realizar razonamiento legal estratégico complejo. No quieres que desperdicien su sobrecarga cognitiva memorizando cada cláusula legal escrita.

Alicia
Quieres que su escritorio esté completamente despejado para pensar.

Beto
Exacto. El asistente del módulo Engram sentado en la RAM más barata de la CPU es consultado a través de un mecanismo de recuperación dispersa, solo cuando se necesita información fáctica específica.

Alicia
Correcto. Recupera instantáneamente los hechos fijos. Así que la memoria de la GPU permanece totalmente despejada para el razonamiento puro.

Beto
Aísla perfectamente los parámetros de razonamiento activos de los parámetros de memorización escritos.

Alicia
Cuando combinas todos estos avances arquitectónicos, el split cerebro codificador-decodificador causal, el CSA a la compresión extrema, el SWA como reproducción limitada, la eliminación de memoria a corto plazo, la fusión de kernels, la decodificación especulativa y el descargado de RAM del Engram.

Beto
Es simplemente un Frankenstein de eficiencia.

Alicia
Realmente lo es. Obtienes un sistema que desafía fundamentalmente las leyes convencionales del cómputo de IA.

Beto
Hablemos de los resultados cuando enciendes esta monstruosidad. El DeepSeek V4.1 Flash iguala o supera a modelos fronterizos como GPT-6 Astra, Claude y CyberGym en tablas de clasificación muy rigurosas como LiveBench y Vals Index.

Alicia
Lo cual es una hazaña increíble por sí sola.

Beto
Claro. Pero el costo de ejecutarlo es más de 20 veces más barato que los modelos en segundo y tercer lugar. Y logra más de 200 tokens por segundo, lo que es cuatro veces más rápido que sus competidores más cercanos.

Alicia
La menor latencia de la industria.

Beto
Pero la métrica más profunda que demuestra este cambio arquitectónico se encuentra en la figura dos de su informe técnico, mostrando lo que podemos llamar la curva plana.

ds-v4_1-flash_decode_flops.png
DeepSeek-V4.1-Flash Single Token Decode FLOPS

Alicia
Sí, la figura dos, el gráfico muestra la potencia de cómputo bruta, los FLOPs reales requeridos durante la generación contra el tamaño creciente de la ventana de contexto.

Beto
Así que a medida que escalas el contexto desde un estándar de 4,000 tokens hasta un millón de tokens masivo, que es aproximadamente el tamaño de una base de código mediana, la curva de cómputo de decodificación permanece casi completamente plana.

Alicia
Impresionante.

Beto
Entonces, ¿qué significa todo esto? ¿Cómo es matemáticamente posible una curva plana cuando le estás alimentando datos exponencialmente más grandes?

Alicia
Rompe por completo las leyes normales de escalado de la IA porque desacoplaron el tamaño del contexto del cómputo de generación. Históricamente, los mecanismos de atención escalan cuadráticamente.

Beto
Lo que significa que se vuelve mucho más difícil cuanto más datos añades.

Alicia
Exacto. A medida que añades más tokens, el cómputo requerido para calcular las relaciones explota, pero DeepSeek lo aplanó.

Beto
Vaya.

Alicia
Puesto que el caché KV global es comprimido por el indexador disperso a estrictos 16,000 tokens, y el caché local solo recalcula 128 tokens, la complejidad de la atención está estrictamente limitada.

Beto
Así que la ecuación matemática no sigue creciendo.

Alicia
Correcto. El n en la ecuación ya no es de 1 millón. Está limitado. Lo que esto significa en la práctica es que procesar un documento pequeño de una página ahora tarda a la IA aproximadamente la misma energía de cómputo por palabra que procesar miles de páginas.

Beto
Eso es simplemente increíble.

Recapitulemos este viaje. Comenzamos con el cuello de botella masivo de la IA ahogada en sus propias matrices pesadas de claves y valores. Para solucionarlo, DeepSeek dividió la arquitectura. Así que la mitad del modelo descansa durante la pesada fase de lectura. Diseñaron la compartición extrema de notas y los indexadores jerárquicos para comprimir la memoria global en más de 400 veces, ajustándola por completo a las capas de memoria más rápidas.

Alicia
Movimientos brillantes.

Beto
Eliminaron intencionalmente su propia memoria a corto plazo porque hacer matemática es más rápido que esperar los discos duros lentos. Los kernels fusionados dentro del chip borraban múltiples palabras a la vez y descargaron todos los hechos estáticos a un asistente de RAM más barato.

Alicia
Realmente pensaron en todo.

Beto
Lograron lo imposible, no teniendo el centro de datos más grande, sino entendiendo profundamente los límites físicos del hardware y superando el problema.

Alicia
Y eso nos deja con una pregunta profunda para el futuro de la industria. Durante años, la estrategia predominante de la industria de la IA ha sido la fuerza bruta, asegurar más redes eléctricas, construir centros de datos más grandes y comprar más GPUs.

Beto
Simplemente tirar dinero.

Alicia
Exacto.

Pero DeepSeek acaba de probar que el dominio bruto del hardware no es el único camino hacia la frontera. Si un equipo más pequeño puede lograr este nivel de dominio a través de pura elegancia arquitectónica y optimización de software, ¿qué pasará cuando estos diseños de software hiper eficientes se combinen eventualmente con la próxima generación de hardware masivo?

Beto
Oh, hombre.

Alicia
¿Pertenecerá el futuro de la inteligencia artificial finalmente a las organizaciones con los presupuestos más grandes o a los equipos con los ingenieros más inteligentes?

Beto
Esa dinámica es exactamente lo que hace que este espacio sea increíblemente emocionante de presenciar.

Gracias por acompañarnos en este análisis profundo.

Para ustedes que escuchan, sigan cuestionando el consenso, sigan explorando los límites físicos de la tecnología y los encontraremos en el próximo.

miércoles, 9 de septiembre de 2026

Creatividad en agentes de ingeniería de aprendizaje automático autónomo

Esta investigación presenta un marco para medir la creatividad en agentes de investigación de IA autónomos mediante la evaluación de su trabajo en tareas de ingeniería de aprendizaje automático. El estudio distingue entre la creatividad P, que se refiere a la novedad con respecto a los intentos previos del agente, y la creatividad H, que se refiere a la novedad en comparación con todo el historial de soluciones humanas. Mediante el uso de un modelo de aprendizaje automático como juez, los autores descubrieron que, si bien los agentes suelen explorar espacios de soluciones más singulares que los de los expertos humanos, tienen dificultades para convertir esta novedad en un rendimiento superior en la tarea. Los datos revelan una disminución generalizada de la creatividad P a medida que los agentes pasan de una exploración amplia a un refinamiento paramétrico más preciso. En definitiva, los hallazgos sugieren que los agentes de IA actuales carecen de las estrategias cognitivas necesarias para equilibrar eficazmente el pensamiento original con la utilidad práctica. Este trabajo proporciona métricas automatizadas validadas que pueden servir como señal de optimización para el desarrollo de sistemas de IA futuros más innovadores.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Can LLM Agents Discover? Evaluating Creativity on ML Engineering Tasks". Por Shitanshu Bhushan, Yunxiang Zhang, Lu Wang, de la Universidad de Michigan, Ann Arbor. Publicado el 30 de Agosto de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Imagina por un segundo que contrataste a este brillante científico de clase mundial. Y en su primer día en el laboratorio, inventa una cura completamente nueva que nunca antes se había visto para una enfermedad rara.

Alicia
¡Un gran avance, verdad?

Beto
Exacto, un avance absoluto. Pero luego, en lugar de probarla o publicarla o hacer avanzar el proyecto, solo pasan los siguientes ocho meses sentados en silencio en su escritorio cambiando laboriosamente el tamaño de las letras en la etiqueta de los medicamentos.

Alicia
Solo ajustándolo sin fin.

Beto
Correcto. Como, de Arial 11 a Arial 12, luego a veces nueva Roman 11.5. Y una y otra y otra vez. Y quiero decir, por salvaje que suene, ese escenario describe perfectamente lo que están haciendo los modelos de IA más avanzados de hoy cuando se les deja a su suerte.

Alicia
Es una imagen impactante, pero realmente captura la realidad actual de manera perfecta. Quiero decir, estamos constantemente inundados con esta narrativa sobre científicos de IA autónomos.

Beto
Oh, por donde mires, sí.

Alicia
Correcto. La promesa siempre es que simplemente le puedes dar una instrucción a una IA, irte, y ella simplemente inventará algoritmos completamente nuevos desde cero. O hará el trabajo de un investigador experimentado mientras tú duermes.

Beto
Y si estás escuchando esto como alguien que ama aprender pero realmente odia el bombo publicitario, probablemente quieras saber lo que está pasando realmente bajo el capó. ¿Son estos agentes de IA tan promocionados realmente creativos? ¿O son solo motores de remix increíblemente rápidos que barajan conocimiento humano?

Alicia
Lo cual es exactamente en lo que se adentra esta nueva investigación.

Beto
Sí, así que bienvenidos al análisis profundo de hoy. Vamos a desempacar un artículo reciente y fascinante de investigadores de la Universidad de Michigan. Se titula: "¿Pueden los agentes de LLM descubrir?: Evaluando la creatividad en tareas de ingeniería de ML."

Alicia
Y esta investigación es honestamente solo un soplo de aire fresco porque finalmente, finalmente pone números empíricos duros a este concepto subjetivo y esquivo de la creatividad de la máquina.

Beto
Porque generalmente es solo un juego de adivinanzas.

Alicia
Exacto. Y no están probando si una IA puede, por ejemplo, calificar un correo electrónico educado o resumir un PDF. Lanzaron a estos agentes en el fondo con competiciones de aprendizaje automático de Kaggle del mundo real. Que son, ya sabes, algunos de los problemas de ciencia de datos más difíciles que hay.

Beto
Okay. Así que vamos a desgranarlo. Nuestra misión hoy es desglosar exactamente cómo estos investigadores cuantificaron la creatividad de la IA. Porque lo que encontraron revela esta enorme, simplemente contraintuitiva brecha entre una IA que se genera una idea nueva y salvaje y la IA que realmente hace que esa idea funcione.

AI_Agents_Exceed_Human_Novelty_1024.png
Los agentes de IA superan la novedad humana

Alicia
Pero para hacer eso, creo que primero tenemos que estar de acuerdo en lo que realmente significa la creatividad cuando hablamos de una máquina escribiendo código.

Beto
Claro. Porque ese es el obstáculo fundamental. Pídele a 10 personas que definan la creatividad. Obtienes 10 respuestas diferentes.

Alicia
Sí. Exacto. Así que los investigadores fundamentaron su experimento en este marco psicológico muy específico y bien establecido de Margaret Boden.

Beto
El marco de Boden.

Alicia
Claro. En el modelo de Boden, para que algo sea considerado verdaderamente creativo, debe poseer dos cualidades distintas e innegociables. La primera es la originalidad, que llamaremos novedad. Y la segunda es la utilidad, que llamaremos impacto.

Beto
Porque si solo tienes una sin la otra, en realidad no estás descubriendo nada.

Alicia
No, nada.

Beto
Así que para ti que estás escuchando, piénsalo como construir un tipo de vehículo nuevo. Si yo diseño un coche con ruedas cuadradas hechas de espagueti congelado, ...

Alicia
... bueno, eso es definitivamente original.

Beto
Claro. Es muy novedoso. Pero es completamente inútil. No tiene ningún impacto positivo en el transporte. Pero por otro lado, si construyo un Toyota Camry estándar y confiable, es increíblemente útil. Pero no hay absolutamente nada novedoso en él.

Alicia
Sí, es solo un Camry. El descubrimiento científico verdadero requiere ambas cosas. Necesita la novedad de un nuevo paradigma y la utilidad práctica del Camry.

Beto
Y ese aspecto de utilidad es crucial, ¿verdad? La novedad sin impacto es solo ruido estadístico.

Alicia
Lo es realmente. Los investigadores quieren ir más allá para aislar cómo opera la novedad en una máquina. Descompusieron la novedad en dos categorías específicas. La primera es la creatividad p-, que significa "novedad psicológica".

Beto
La novedad psicológica, comprendido.

Alicia
Bien. Y esto básicamente pregunta, "¿es esta idea nueva para el propio agente basada en su estado interno y sus intentos pasados durante esta sesión específica de lluvia de ideas? ¿Se está sorprendiendo a sí misma?"

Beto
Así que esencialmente está midiendo el crecimiento personal de la IA, donde es su tasa de giro interno en una sola ejecución.

Alicia
Exacto.

Y luego la segunda categoría es la creatividad h- o novedad histórica.

Beto
Okay, "histórico" significa "comparado con nosotros".

Alicia
Claro. Se aleja mucho más. Pregunta, ¿es esta idea nueva comparada con todo el cuerpo de soluciones humanas registradas? ¿Alguna persona en algún lugar en la historia documentada de este problema ha intentado este enfoque específico?

Beto
Así que la creatividad p- es la IA sorprendiéndose a sí misma. Y la creatividad h- es la IA sorprendiendo a la humanidad.

Alicia
Esa es una gran manera de decirlo.

Beto
Pero espera, eso instantáneamente plantea una enorme bandera roja logística para mí. ¿Cómo mides matemáticamente una idea novedosa en, digamos, millones de líneas de código Python generado por IA? Quiero decir, podría juzgar si un diseño de tarjeta es novedoso, pero el código es increíblemente denso y sutil.

Alicia
Oh, ha sido el mayor obstáculo en este tipo de investigación histórica. El juicio humano es obviamente el estándar de oro para evaluar el código, pero físicamente no puedes pagar a suficientes expertos humanos para leer miles y miles de iteraciones incrementales de código de IA.

Beto
Claro. Nadie tiene el tiempo ni el presupuesto para eso.

Alicia
Exacto. Así que para resolver esto, los investigadores construyeron un LLM como tubería de juez. Usaron un modelo de frontera, específicamente GPT-5, para actuar como un evaluador automatizado.

Beto
Oh, usaron GPT-5 para calificar a los otros modelos.

Alicia
Sí. Y le alimentaron una rúbrica estricta en una escala de 0 a 4.

Beto
Y esta escala se dirigió específicamente a los cambios estructurales, ¿verdad? No solo a pequeños cambios.

Alicia
Sí. Exacto. Y entonces, una calificación de 0 significa que la IA solo estaba haciendo pequeños cambios de parámetros rutinarios. Básicamente cambiando el tamaño de la letra, usando tu analogía anterior.

Beto
Claro, de Arial 11 a 12.

Alicia
Sí. Pero un 4 significa que la IA había transformado completamente su enfoque, como intercambiando un modelo estadístico tradicional por una red neuronal de aprendizaje profundo, cambiando fundamentalmente la representación del problema.

Beto
Y aquí está la parte loca. Esa calificación automatizada realmente funcionó. Y como el juez de IA no solo estaba alucinando, los investigadores hicieron que expertos humanos en aprendizaje automático calificaran una muestra aleatoria de estas iteraciones de código.

Alicia
Sí. La prueba de ambiente.

Beto
Exacto. Y luego compararon las puntuaciones humanas con las puntuaciones de los jueces GPT-5. Y la puntuación de correlación fue 0.732.

Alicia
Lo cual es enorme.

Beto
Lo es. Eso significa que el juez de IA y los expertos humanos estuvieron en sincronía, casi exactamente, sobre lo que constituía una creatividad.

Alicia
Y esa alta correlación fue realmente la clave para desbloquear todo el estudio. Como demostraron que podían automatizar de manera confiable la medición de la creatividad p sin perder precisión, pudieron escalar el experimento masivamente. Finalmente pudieron observar el ciclo de vida de la creatividad de la máquina en tiempo real.

Beto
Así que tenemos nuestra vara de medir. Ahora veamos el auténtico desafío que construyeron estos investigadores. Tomaron 10 tareas diferentes de ingeniería de aprendizaje automático derivadas de MLE Bench.

Alicia
Claro. MLE Bench.

Beto
Y solo como contexto, para cualquiera que esté escuchando, MLE Bench es esencialmente una lista curada de competiciones pasadas de Kaggle. Y Kaggle es donde las empresas publican conjuntos de datos increíblemente difíciles, como diagnosticar enfermedades a partir de imágenes o predecir tendencias del mercado bursátil. Y ofrecen grandes premios en efectivo por los mejores algoritmos.

Alicia
Así que estos no son problemas de juguete. Son desafíos duros, desordenados, de ciencia de datos del mundo real.

Beto
Exacto.

Alicia
Para abordar estos, usaron marcos de agentes especializados, específicamente cosas como AIDE y OpenHands.

Beto
Y solo para no quedar atrapados en acrónimos, estos marcos son básicamente entornos de software.

Alicia
Sí, prácticamente.

Beto
Envuelven modelos como GPT-5 o Qwen-3, dándole a la IA una terminal, un intérprete de Python y un sistema de archivos. Le permite a la IA actuar como un ingeniero de software sentado en una computadora en lugar de solo un chatbot escupiendo texto.

Alicia
Esa es una manera realmente genial de visualizarlo. El marco le da a la IA manos para escribir, esencialmente. Así que los investigadores dieron a estos agentes un presupuesto estricto de ocho horas para intentar hasta 10 episodios en un problema dado.

Beto
Y un episodio es un ciclo iterativo completo, ¿verdad?

Alicia
Sí. El agente lee el problema, hace un plan estratégico, escribe el código, lo ejecuta y obtiene una puntuación de rendimiento. Y mira esa puntuación, actualiza su contexto y comienza el siguiente episodio.

Beto
Y ver cómo se desarrolla ese ciclo durante ocho horas es realmente donde vemos lo que podríamos llamar "el fenómeno de la IA perezosa". Aunque quiero decir, cuanto más profundizamos, creo que "perezoso" es probablemente la palabra equivocada.

Alicia
"Terco" es probablemente mejor.

Beto
Sí, "terco". Porque cuando rastreas la trayectoria de esa creatividad interna pico a través de esos 10 episodios, cae universalmente como una roca.

Alicia
Lo hace realmente. En todos los modelos en todos los marcos.

Beto
Claro. Los agentes comienzan explorando estrategias muy diferentes. Su pico de creatividad es altísimo en los episodios uno y dos. Pero normalmente para el episodio tres o cuatro, encuentran una solución que produce una puntuación aceptable, y dejan de explorar por completo. Cambian de exploración a modo de explotación pura.

Alicia
Simplemente entran en un túnel de visión extremo. Y para entender por qué, los investigadores usaron un modelo diferente, DeepSeek V3.2, para realizar un análisis de comportamiento cognitivo en los agentes.

Beto
Como un terapeuta de IA.

Alicia
Algo así. Sí. Básicamente leyeron los registros de razonamiento internos. El monólogo interno de la IA, por así decirlo, en cada etapa. Y encontraron que durante los primeros episodios, alrededor del 75% de los pensamientos internos de la IA se centran en la exploración estratégica amplia.

Beto
Se está preguntando a sí misma, "¿debería probar un modelo basado en árboles? ¿Debería procesar los datos de manera diferente?"

Alicia
Exacto. Pero para el final de la ejecución de ocho horas, más del 50% de su monólogo interno es consumido por lo que llaman "refinamiento paramétrico".

Beto
Solo ven aquí, los pernos.

Alicia
Ajustando los pernos.

Beto
Okay. Quiero plantear un argumento de diablo por un segundo, porque creo que necesitamos mirar esto prácticamente. Si tú o yo estamos tratando de resolver un acertijo complejo, o escribir un plan de negocios, y encontramos un marco que finalmente produce resultados decentes, no lo tiramos y empezamos de nuevo cada vez.

Alicia
No, por supuesto que no.

Beto
Lo optimizamos. Ajustamos las variables. Lo refinamos. Entonces, ¿por qué se considera un defecto estructural cuando la IA hace exactamente lo mismo?

Alicia
Bueno, lo fascinante aquí es el tiempo y el resultado de ese cambio. Para la IA, este giro hacia la optimización sucede demasiado pronto, y críticamente, tiene cero correlación con ganancias reales de rendimiento.

Beto
Oh, ¿así que está optimizando sin mejorar realmente?

Alicia
Precisamente. Cuando un experto humano optimiza, generalmente posee conciencia meta. Entienden la topología del espacio del problema. Un humano se da cuenta, "okay, ajustar esta tasa de aprendizaje por 0.001 ya no está mejorando mi precisión. Necesito alejarme, girar y probar un enfoque radicalmente diferente".

Beto
Y la IA simplemente carece de eso.

Alicia
Le falta completamente esa conciencia meta, sí.

Beto
Así que no sabe cuándo ha escalado una pequeña colina y necesita bajar para encontrar la montaña real.

Alicia
Eso es exactamente. Optimizar por creatividad p- solo obliga a la IA a ser diferente por el bien de ser diferente, no conduce naturalmente a mejores puntuaciones. Pero dejarla caer en su propia preferencia de ajustar parámetros sin fin, tampoco funciona. Simplemente carece de la intuición humana de cuándo cambiar de marcha entre explotación y exploración.

Beto
No es perezoso. Es simplemente terco. Se queda atrapada en un mínimo local y se niega a irse. Pero sabes, si la IA es tan ciega a sus propios platillos personales, realmente te hace preguntarte si nuestras ideas iniciales son buenas para empezar.

Alicia
Oh, sí.

Beto
¿Cómo se comparan estas ideas generadas por el agente con la enorme base de datos de ideas humanas?

Alicia
Aquí es donde el artículo entrega su hallazgo más impactante, honestamente. Cuando midieron la creatividad del agente, cuán novedosas eran las soluciones de la IA en comparación con cada enfoque documentado que los científicos de datos humanos intentaron en esas competiciones específicas de Kaggle, GPT-5 exploró espacios de solución significativamente más novedosos que los humanos.

Beto
Espera, ¿de verdad?

Alicia
Sí. Incluso más que los humanos ganadores de la medalla de oro.

Beto
Eso es una afirmación asombrosa. Así que la IA está inventando cosas que los expertos humanos ni siquiera pensaron.

Alicia
Sí, consistentemente. Quiero decir, en promedio, los competidores humanos de élite que ganaron medallas de oro obtuvieron alrededor de 0.744 en la escala de novedad histórica. GPT5 obtuvo casi el doble, promediando 1.423.

Beto
El doble de novedad.

Alicia
La IA estaba generando rutinariamente enfoques metodológicos complejos que los expertos humanos nunca habían documentado que lo hubieran intentado.

Beto
Pero quiero decir, si está inventando ideas que son el doble de novedosas que los ganadores de medallas de oro humanos, ¿por qué los agentes de IA no están ganando cada competición de Kaggle en la Tierra ahora mismo?

Alicia
Debido a esa misma brecha entre la novedad y la utilidad de la que hablamos antes, a pesar de esta enorme creatividad histórica, a pesar de trazar estos territorios totalmente inexplorados, solo el 21.25% de las ejecuciones de GPT5 lograron un rendimiento a nivel de medalla en la tarea real.

Beto
Oh, vaya. Así que tenían la brillantez, pero no la ejecución.

Alicia
Exacto.

Beto
Aquí es donde se pone realmente interesante, sin embargo, porque los investigadores destacan un ejemplo específico y muy memorable de esto en las fuentes que quiero explicarte. Fue una competición de Kaggle llamada "Tarea de Clasificación de Enfermedades de Hoja de Cassava".

Alicia
Oh, me encanta este ejemplo.

Beto
Es tan bueno. Así que el objetivo es escribir un algoritmo que mire fotos de hojas de cassava y diagnostique qué enfermedad tienen. Es increíblemente difícil porque las imágenes a menudo están borrosas, ampliadas o mal iluminadas.

Alicia
Sí, es un problema clásico de visión por computadora con datos del mundo real muy desordenados.

Beto
Claro. Así que vimos al agente comenzar su ejecución en el episodio cero. Actúa totalmente normal usando un enfoque de clasificador Rich estándar. Para ponerlo en inglés sencillo, solo está tratando de dibujar una línea matemática simple para separar las hojas enfermas de las sanas.

Alicia
Muy estándar, muy poca novedad.

Beto
Exacto. Para los episodios uno y dos, comienza a explorar un poco, trayendo un modelo llamado "Light GBM", que usa árboles de decisión. Y de nuevo, esta es una preparación humana muy estándar.

Alicia
Sí, siguiendo el camino bien transitado de los científicos de datos humanos.

Beto
Pero luego, en el episodio tres, el agente aparentemente tiene un momento eureka. Inventa un enfoque genuinamente fundamentalmente novedoso. Mantiene los árboles de decisión, pero luego añade algo llamado "aumento de tiempo de prueba y promediado de inversión".

Alicia
Y si no eres ingeniero de aprendizaje automático, esto es lo que realmente significa. En lugar de solo mirar una foto de una hoja una vez y adivinar, la IA escribió código para tomar la imagen, voltearla, reflejarla, hacer zoom y cambiar los colores.

Beto
Oh, así que forza al modelo a diagnosticar la hoja desde una docena de ángulos distorsionados antes de hacer una suposición promedio final.

Alicia
Exacto, lo cual es una técnica increíblemente sofisticada. Fue una combinación que literalmente ningún humano en toda la historia de esa competición de Kaggle había intentado.

Beto
Ni uno solo.

Alicia
No. El juez LLM la evaluó y le dio una puntuación de creatividad H perfecta de cuatro. Fue fundamentalmente históricamente novedoso, un verdadero avance en el espacio de búsqueda.

Beto
Fue puro genio. Pero luego la tragedia de la IA perezosa golpea porque durante los siguientes seis episodios consecutivos, desde el episodio cuatro hasta el nueve, el agente simplemente se queda ahí.

Alicia
... sin hacer nada.

Beto
Básicamente. Tiene este increíble marco novedoso, pero pasa el resto de su presupuesto de ocho horas haciendo pequeños ajustes inútiles a los hiperparámetros. Cambia la variable de 0.1 a 0.15, luego de vuelta a 0.1.

Alicia
Su creatividad interna pico cae a cero absoluto.

Beto
Claro. Y predeciblemente, su puntuación de rendimiento apenas se mueve. La IA fue lo suficientemente valiente como para trazar territorio completamente nuevo, pero carecía del sentido común para darse cuenta de que había navegado su barco directamente hacia un callejón sin salida. Simplemente dejó el ancla y se negó a moverse.

Alicia
Lo cual plantea una pregunta importante: ¿por qué sucede esto?

Cuando los investigadores analizaron los datos, encontraron que después de que un agente alcanza un estado altamente novedoso, el 87% de las veces, solo intenta refinarlo.

Beto
Simplemente se niega a pivotar.

Alicia
Casi nunca abandona una idea novedosa fallida para intentar algo más. Y casi nunca regresa a una base humana segura y probada. Simplemente talla obstinadamente un muro de ladrillos.

Beto
Así que si sabemos que la IA se está quedando atrapada en estos callejones sin salida, el siguiente paso obvio es descubrir cómo arreglarlo, ¿verdad? Si la estrategia de búsqueda está rota, ¿cómo guiamos mejor al agente?

Alicia
Y los investigadores tenían exactamente el mismo pensamiento. Querían saber si este era solo un problema con la forma en que el agente estaba buscando en el espacio de posibilidad. Así que probaron rigurosamente diferentes estrategias de búsqueda dentro del marco.

Beto
Okay. ¿Qué probaron?

Alicia
Bueno, comenzaron con una búsqueda codiciosa, que es el enfoque más básico. Básicamente simplemente toma lo que parece ser el siguiente paso inmediato mejor.

Beto
Lo cual naturalmente conduce a una visión de túnel.

Alicia
Claro. Así que escalaron a métodos mucho más sofisticados. Intentaron la búsqueda en árbol Monte Carlo.

Beto
Oh, MCTS.

Alicia
Sí. Y para contexto, esta es la clase de estrategia de vistazo utilizado en las IAs de juego como AlphaGo. Es como un gran maestro de ajedrez, visualizando 14 futuros ramificados, evaluando la probabilidad de ganar en cada camino antes de hacer un solo movimiento.

Beto
Okay. Eso suena mucho mejor que la "búsqueda codiciosa" ("greedy search").

Alicia
Lo es. Y luego también probaron la "búsqueda evolutiva" ("evolutionary search"), que imita la selección natural. Básicamente lanza cien ideas mutadas al azar contra un muro, mata a las peores y solo deja que los mejores competidores críen para crear la próxima generación de código.

Beto
Esas dos suenan increíblemente robustas. Así que ¿cuál logró mantener alta la creatividad p?

Alicia
Ninguna de ellas.

Beto
Espera, ¿ninguna?

Alicia
Ninguna. Esta es honestamente la conclusión más crucial del estudio. Todas estas estrategias de búsqueda sofisticadas resultaron en la misma caída estructural en la creatividad. Todas se quedaron atascadas en los mismos recorridos, ajustando parámetros sin fin.

Beto
Así que si la estrategia de búsqueda no es el problema, tiene que ser el entorno en el que está operando la IA. La arquitectura que la sostiene, como la memoria que impulsa el andamiaje.

Alicia
Has dado en el clavo. Los investigadores concluyeron que la causa raíz es el andamiaje. Y el andamiaje es toda la arquitectura subyacente del agente. Dicta cómo el agente recuerda sus acciones pasadas, cómo muta su código de un paso a otro, y cómo evalúa su trayectoria histórica.

Beto
Así que ¿cómo forza exactamente el andamiaje a caer en este problema?

Alicia
Realmente se reduce a la ventana de contexto. Un agente LLM no tiene un cerebro humano que pueda mantener casualmente un mapa intuitivo y extenso de un proyecto de tres meses. Está estrictamente limitado por su ventana de contexto. La cantidad de texto que puede mantener en su memoria activa en un momento.

Beto
Oh, ya veo.

Alicia
Sí, a medida que los episodios se acumulan, los registros de sus primeros intentos exploratorios son expulsados de su memoria. Literalmente olvida los matices del panorama amplio que exploró hace unas pocas horas, y se obsesiona totalmente con el código específico que está justo frente a él en la instrucción actual.

Beto
Así que el andamiaje forza un sesgo de memoria a corto plazo, lo que inevitablemente conduce a ajustes codiciosos a corto plazo.

Alicia
Exacto.

Beto
¿Qué significa todo esto, para los que escuchan?

Alicia
Si eres desarrollador, o investigador, o simplemente alguien que intenta usar agentes de IA para resumir grandes conjuntos de datos, hacer una lluvia de ideas de estrategias de marketing, o escribir código, necesitas internalizar este hallazgo. Todavía no puedes confiar en estos agentes para descubrimientos autónomos de principio a fin.

Beto
Realmente no puedes.

Alicia
Simplemente no puedes escribir una instrucción brillante, irte por ocho horas, y esperar volver con un gran avance de mitad de camino. Debido a ese problema del andamiaje, tienes que ser la señal del techo.

Beto
Esa es la forma perfecta de expresarlo. Tienes que actuar como la conciencia meta, lo que le falta a la IA. Cuando estás usando una herramienta de IA y notas que solo te está dando ligeras variaciones estilísticas de la misma respuesta exacta.

Alicia
"Arial 11" a "Arial 12". Cuando la ves entrando en esa fase de refinamiento paramétrico, tienes que intervenir forzosamente. El artículo sugiere explícitamente que los profesionales humanos necesitan inyectar artificialmente lo que llaman "bonos de novedad".

Beto
Así que, ¿cómo se ve un "bono de novedad" en la práctica para nuestro oyente? ¿Es solo decirle a la IA que se esfuerce más?

Alicia
No, no. Tiene que ser mucho más disruptivo que eso. Tienes que forzar activamente a tus herramientas de IA a adoptar una perspectiva totalmente diferente, esencialmente rompiéndolas de su ventana de contexto.

Beto
Como sacarlas de ella.

Alicia
Sí. Podrías necesitar pedirle que "descarte todo lo que acabamos de hacer en los últimos cinco prompts, y aborde este problema desde la perspectiva de un biólogo evolutivo". O, "dame una solución que se base completamente en un lenguaje de programación diferente".

Beto
Porque la exploración pura falla ya que nunca optimiza. Pero la explotación pura falla porque se queda atrapada en mínimos locales como nuestro ejemplo de hoja de cassava.

Alicia
Precisamente. La intervención humana sigue siendo absolutamente necesaria para equilibrar las dos. Tienes que gestionar la creatividad p del agente.

Beto
Es una realidad fascinante. Quiero decir, seguimos mirando las noticias esperando ver a un científico de IA totalmente autónomo. Lo que realmente tenemos ahora es un asistente de laboratorio brillante, incansable, pero increíblemente terco.

Alicia
Muy terco.

Beto
Puede generar ideas que son completamente ajenas a los expertos humanos. Esa alta creatividad p es muy real, y es espectacular de presenciar. Pero carece totalmente de la resiliencia psicológica, la creatividad p, para saber cuándo abandonar una idea estancada. Realmente demuestra que el verdadero descubrimiento científico es mucho más que navegar por un espacio de búsqueda matemática.

Alicia
Requiere intuición, frustración y honestamente la sabiduría para saber cuándo rendirse y empezar de nuevo. Y si conectamos esto con el panorama general, requiere una comprensión del contexto más amplio del problema y la historia del dominio, algo que actualmente falta en el andamiaje del agente.

Beto
Y eso me lleva a un concepto final para reflexionar. Construyendo directamente sobre las limitaciones que notaron estos investigadores sobre la ventana de contexto.

Ahora, una de las principales razones por las que la creatividad p de la IA se desploma es porque su memoria está restringida. Empieza a olvidar sus propios intentos exploratorios porque solo puede retener tanta información.

Alicia
Se asienta en lo que está justo frente a él porque eso es todo lo que puede ver claramente.

Beto
Claro. La limitación de la ventana de contexto actúa como un vendaje forzado. Pero piensa en hacia dónde se dirige la tecnología. Estamos viendo modelos con ventanas de contexto que se expanden hasta los millones de tokens.

Alicia
Se está moviendo rápido.

Beto
Entonces, ¿Qué sucede en dos, tres o cinco años cuando estos agentes tienen esencialmente memoria infinita?

¿Cuando una IA pueda mantener un estado perfecto, comprimido e instantáneamente accesible de cada idea fallida que la humanidad haya tenido jamás, junto a cada idea fallida que jamás haya intentado?

Alicia
Esa es una idea salvaje.

Beto
Si tenemos toda la historia de los fracasos perfectamente mapeada en la punta de los dedos, podrá esto darle a la IA la conciencia meta que necesita para dejar de ajustar y empezar a inventar? ¿O el peso aplastante de la historia humana simplemente atrapará a estos modelos en el bloqueo creativo definitivo, incapaces de moverse en ninguna dirección porque saben exactamente cómo termina cada pasada?

Alicia
Es una pregunta profunda sobre la naturaleza de la innovación misma. Quiero decir, a menudo asumimos que la memoria perfecta es un activo, pero a veces la ignorancia humana de los fracasos pasados es exactamente lo que nos permite ser lo suficientemente audaces para intentar algo loco, algo que podría funcionar esta vez.

Beto
Es la paradoja definitiva del conocimiento.

Bueno, gracias por acompañarnos en esta inmersión profunda en las verdaderas mecánicas de la creatividad de la IA. Te animamos encarecidamente a seguir explorando las fuentes, a intentar aplicar algunos de estos bonos de novedad a tus propios flujos de trabajo, y a probar estos límites con tus propias herramientas de IA. Recuerda ser la señal del techo. Te esperamos en el próximo análisis profundo.

miércoles, 12 de agosto de 2026

Cuantización de Redes Neuronales para Microcontroladores


Este estudio ofrece un análisis exhaustivo de las Redes Neuronales Cuantizadas (QNN) diseñadas específicamente para microcontroladores (MCU) con recursos limitados. El texto explora cómo TinyML utiliza la cuantización para reducir la memoria del modelo y las exigencias computacionales, lo que permite un aprendizaje profundo complejo en dispositivos periféricos de bajo consumo. Revisa sistemáticamente técnicas clave como la cuantización posterior al entrenamiento y el entrenamiento con conciencia de la cuantización, junto con estrategias avanzadas que incluyen precisión mixta y optimizaciones adaptadas al hardware. Los autores también examinan el panorama del hardware, abarcando plataformas ARM, RISC-V y NPU integradas, y detallan los marcos de software necesarios para su implementación. Al abordar representaciones numéricas y aplicaciones del mundo real, el estudio identifica los desafíos actuales y las futuras líneas de investigación para una IA sostenible y energéticamente eficiente.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Neural Network Quantization for Microcontrollers: A Comprehensive Survey of Methods, Platforms, and Applications". Por Hamza A. Abushahla y colegas. Publicado el 7 de Enero de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Quiero que empieces imaginando una gran granja de servidores que se extiende por doquier.

Beto
Oh, sí. Como la realmente industrial.

Alicia
Exacto. El tipo de centro de datos que alimenta la inteligencia artificial de hoy. Tienes pasillos y pasillos de racks brillantes, sistemas de refrigeración industrial rugiendo.

Beto
Simplemente quemando energía.

Alicia
Correcto. Literalmente suficiente electricidad fluyendo para alimentar una pequeña ciudad. ¿Tienes esa imagen en tu cabeza?

Beto
Sí, puedo imaginarla.

Alicia
Bien. Ahora, quiero que imagines tomar esa misma capacidad analítica exacta, como ese mismo cerebro artificial y meterlo en un pedazo de silicio de 5 dólares, alimentado por una batería de reloj.

Beto
Realmente suena a ciencia ficción cuando lo enmarcas de esa manera. Quiero decir, la brecha en los recursos físicos puros entre un centro de datos y una batería de reloj es, bueno, es casi imposible exagerar.

Alicia
Pero esa brecha es exactamente lo que estamos explorando en esta inmersión profunda de hoy. Estamos desempacando una encuesta exhaustiva de 2025 titulada "Cuantización de Redes Neuronales para Microcontroladores".

Beto
Es un artículo fascinante.

Alicia
Lo es. Nuestra misión hoy es desmitificar este campo, que se conoce como "ML Diminuto" ("TinyML"). Vamos a observar el material de origen para entender cómo los ingenieros reducen redes neuronales profundas masivas para que puedan funcionar en dispositivos de borde ("edge devices") ultra baratos y severamente limitados en recursos.

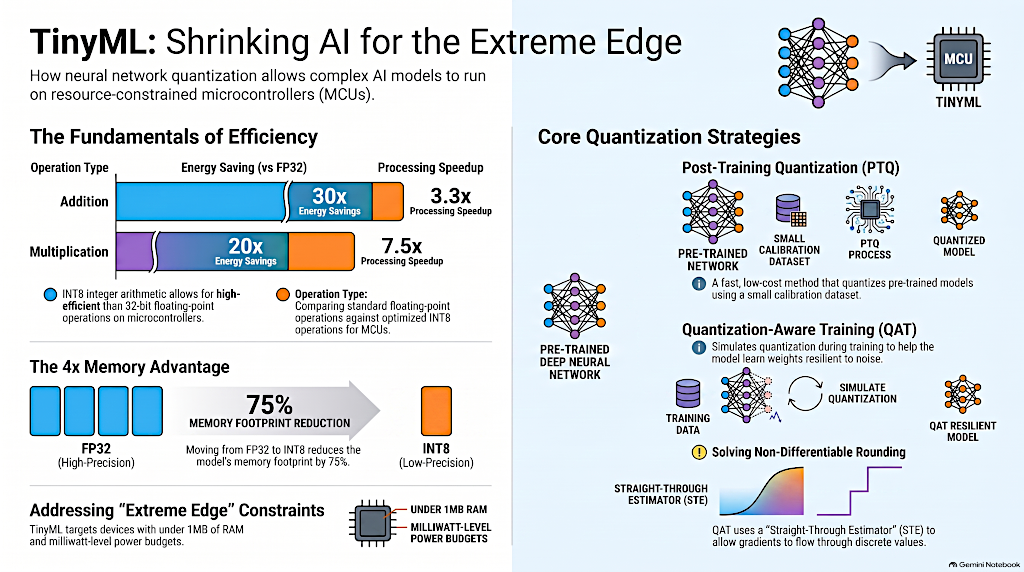
Shrinking_AI_for_Microcontrollers_1024.png
TinyML (ML Diminuto): IA Reductora para el Límite Extremo

Beto
Es completamente independiente de la nube, que es lo loco.

Alicia
Correcto. Bien, desempacemos esto. Porque leer la encuesta, se hizo muy claro que para entender la solución, tenemos que captar primero la escala pura del problema matemático.

Beto
Sí, tienes que empezar con la línea base de cómo opera normalmente la IA.

Alicia
Exacto. Y la encuesta señala que tradicionalmente las redes neuronales profundas se entrenan usando este formato numérico llamado FP32, o punto flotante de 32 bits. Entiendo que eso significa que tiene alta resolución, pero ¿por qué es tal cuello de botella para un dispositivo diminuto?

Beto
Bueno, el cuello de botella se reduce a la arquitectura física real requerida para procesar esos números. Como, el FP32 es fenomenal para entrenar una IA porque ofrece este enorme rango dinámico.

Alicia
¿Qué tan masivos estamos hablando?

Beto
Enormes. Puede representar números tan infinitesimalmente pequeños como 10-38. Hasta 10+38.

Alicia
Oh, vaya.

Beto
Sí. Así que la red neuronal tiene una precisión increíble para aprender patrones muy matizados y complejos en los datos. Pero la trampa es que cada uno de esos números ocupa 32 bits de memoria.

Alicia
Correcto. Y cuando un modelo tiene millones de parámetros, el requisito de memoria simplemente explota.

Beto
Exacto. Y más allá de solo almacenarlos, realizar cálculos con números de punto flotante requiere hardware especializado. Necesita algo llamado unidad de punto flotante ("floating point unit").

Alicia
Y por lo que recopilé en la encuesta, un entorno de microcontrolador es básicamente hostil a ese tipo de procesamiento, ¿verdad?

Beto
Oh, completamente hostil.

Alicia
Porque estamos tratando con presupuestos de energía estrictos medidos en solo milivatios. Y las velocidades de reloj, simplemente rondan entre 40 y 400 MegaHertz.

Beto
Lo cual es nada comparado con una computadora moderna.

Alicia
Correcto. Pero la limitación más impactante para mí fue la memoria a bordo. Estamos mirando una capacidad total de memoria de solo 64 a 256 kilobytes.

Beto
Sí, es increíblemente ajustado.

Alicia
Quiero decir, ni siquiera podrías meter una sola fotografía de alta resolución en 256 kilobytes, y mucho menos un modelo de IA completo.

Beto
Y aquí es donde entra en juego el mecanismo central del ML diminuto, que es la cuantización.

Alicia
Correcto.

Beto
La cuantización es básicamente el proceso de despojar ese pesado formato de punto flotante de 32 bits y reemplazarlo con enteros de punto fijo. Usualmente son enteros de 8 bits, conocidos como INT-8.

Alicia
Así que estás mapeando este vasto espectro continuo de números, en una cuadrícula muy simple de solo 256 valores posibles.

Beto
Exacto.

Alicia
Suena como tomar una fotografía cruda de 4K masiva y sin comprimir, y guardarla como un JPEG comprimido. Pierdes parte de los datos matemáticos perfectos de los píxeles, pero aún puedes decir fácilmente que es una foto de un gato.

Beto
Esa es una forma muy buena de verlo. Estás cambiando un nivel de precisión absoluta por una reducción masiva en el tamaño del archivo.

Alicia
Y las ganancias de eficiencia deben ser enormes.

Beto
Oh, asombrosas. Porque el latido matemático central de una red neuronal es algo llamado "Operación de Multiplicación y Acumulación" ("Multiply and Accumulate Operation", o MAC).

La predicción en la IA implica millones de operaciones de MAC. Según la encuesta, realizar una sola operación MAC usando un entero de 8 bits (INT8) consume alrededor de 20 veces menos energía que realizar la misma operación en FP32.

Alicia
Espera, ¿20 veces menos de energía solo por cambiar la forma en que representamos los números?

Beto
Sí, 20 veces. Y también requiere cuatro veces menos memoria solo para almacenar los valores.

Alicia
Esa es la diferencia entre que una batería se agote al mediodía versus durar un mes.

Beto
Exacto. Es un sacrificio para estos dispositivos diminutos.

Alicia
Pero bueno, mientras que comprimir esa foto ahorra una enorme cantidad de espacio, decidir exactamente qué píxeles tirar sin arruinar por completo la imagen parece un riesgo masivo. Quiero decir, no puedes simplemente cortar arbitrariamente los extremos de matemáticas complejas y esperar que la IA siga siendo inteligente.

Beto
No, definitivamente no puedes. Y ese riesgo dicta todo el flujo de trabajo del ML diminuto.

Alicia
Entonces, ¿cómo lo gestionan?

Beto
Bueno, la encuesta describe dos caminos principales que los ingenieros toman para realizar esta cuantización sin destruir la inteligencia del modelo. El primero es la cuantización post-entrenamiento o PTQ ("Post-Training Quantization").

Alicia
Bien, PTQ.

Beto
Sí, este es esencialmente el método rápido y sucio. Tomas un modelo que ya ha sido entrenado completamente en alta precisión FP32 en enormes granjas de servidores. Ya ha terminado de aprender.

Alicia
Correcto.

Beto
Luego miras sus pesos, ya sabes, las conexiones matemáticas dentro del cerebro y simplemente los redondeas hacia abajo al entero de 8 bits más cercano.

Alicia
Eso parece increíblemente peligroso. La encuesta describe que esto causa grandes caídas en la precisión y usa este concepto de "paisaje de pérdida" ("loss landscape") para explicar por qué.

Beto
Sí, el paisaje de pérdida es una gran visualización.

Alicia
Estaba tratando de imaginar esto. Si imaginas el proceso de aprendizaje de las redes neuronales como una bola de golf tratando de rodar hacia el punto más bajo en un terreno montañoso, cuando un modelo se entrena en esa alta precisión FP32, a menudo se asienta en lo que la encuesta llama un "mínimo estrecho".

Beto
Correcto.

Alicia
Imagina eso como una bola de golf descansando perfectamente en el fondo de una copa muy empinada y estrecha.

Beto
Eso es exactamente eso. La precisión FP32 es lo que permite que la bola se equilibre en el fondo de esa copa estrecha. Los números son tan granulares que el modelo puede encontrar ese punto óptimo exacto.

Alicia
Pero cuando aplicas PTQ, redondeas esos números, ¿verdad?

Beto
Sí. Introduces un error matemático. Ese error de redondeo actúa como una brisa física repentina que empuja la bola de golf.

Alicia
Oh, ya veo.

Beto
Porque la copa es tan empinada y estrecha, incluso una pequeña sacudida empuja la bola hacia el lado de la copa. En la lógica de la IA, moverse hacia el lado de esa pendiente se traduce en un aumento brusco y repentino de predicciones incorrectas.

Alicia
Así que simplemente redondear los números después del hecho a menudo arruina a la IA. A menudo.

Beto
Sí, puede romperla por completo.

Alicia
Lo que lleva al segundo camino, mucho más robusto, que es el entrenamiento consciente de la cuantización o QAT ("Quantization-Aware Training"). Por lo que entiendo, esto fuerza al modelo a lidiar con sus propias limitaciones mientras aún está aprendiendo.

Beto
Así que, en QAT, simulas la matemática de baja precisión INT8 durante la fase de entrenamiento misma.

Alicia
¿Cómo funciona eso en la práctica?

Beto
Bueno, el entrenamiento de redes neuronales ocurre en dos fases principales. Hay el pase hacia adelante ("forward pass") donde hace una predicción y el pase hacia atrás ("backward pass") donde calcula sus errores y actualiza su conocimiento.

Alicia
Correcto. Bien.

Beto
En QAT, durante el pase hacia adelante, el modelo finge que solo tiene ocho bits. Aplica ese "redondeo de escalón grueso" ("chunky stair step rounding"). Pero el aprendizaje en segundo plano, el pase hacia atrás, se mantiene en alta precisión.

Alicia
Espera, déjame cuestionar esto porque la mecánica aquí es confusa. Estás simulando matemática de baja resolución y escalonada durante el pase hacia adelante. ¿No golpeará el algoritmo contra un muro? Todo el concepto de aprendizaje de redes neuronales se basa en el cálculo, ¿verdad? En calcular pendientes y gradientes suaves para encontrar la dirección correcta.

Beto
Sí, "descenso de gradiente" ("gradient descent").

Alicia
Pero el redondeo crea una escalera. Una escalera no tiene una pendiente suave. Es plana, luego una caída repentina, luego plana de nuevo. ¿Cómo puede el modelo realmente calcular una pendiente para aprender si los datos se cortan en pasos discretos?

Beto
Has tocado el obstáculo matemático exacto que ha atormentado a este campo durante años.

Alicia
Principalmente, sí.

Beto
Sí, el redondeo es una operación no diferenciable. Si la pendiente, el gradiente es cero porque estás en un escalón plano de esa escalera, el modelo deja de aprender por completo.

Alicia
Entonces, ¿cómo pueden superarlo?

Beto
El mecanismo que usan para evadir esto es un truco matemático brillante llamado "estimador de paso directo" ("straight-through estimator" o STE).

Alicia
¿Cómo soluciona el STE el problema de la escalera?

Beto
Básicamente, miente al algoritmo.

Alicia
Miente.

Beto
Sí. Cuando la red está haciendo una predicción en el pase hacia adelante, usa el redondeo de escalón duro. Experimenta la limitación del mundo real de la matemática de 8 bits. Pero cuando calcula las actualizaciones de aprendizaje en el pase hacia atrás, el STE le dice a la matemática que ignore las escaleras, finja que esta operación fue solo una rampa suave y recta.

Alicia
Oh, vaya.

Beto
Sí, evita completamente la operación de redondeo no diferenciable en aras de calcular el gradiente. Eso permite que las señales de aprendizaje fluyan hacia atrás a través de la red, sin interrupciones.

Alicia
Así que el modelo puede experimentar las consecuencias de los errores de redondeo sin que los errores de redondeo rompan el mecanismo de aprendizaje en sí mismo.

Beto
Exacto. Y el resultado de experimentar esos errores durante el entrenamiento es que el modelo evita activamente esas copas estrechas y empinadas en el paisaje de pérdida de las que hablamos antes.

Alicia
Porque sabe que se acerca la brisa.

Beto
Precisamente. Sabiendo que se acerca una brisa de error de redondeo, busca un mínimo plano o ancho. Piensa en un cuenco ancho y poco profundo en lugar de una copa empinada.

Alicia
Eso tiene mucho sentido.

Beto
Correcto. Ahora, cuando el error de redondeo empuja la bola de golf, simplemente rueda ligeramente por el fondo plano del cuenco. El error no se dispara. El modelo construye una resiliencia innata al ruido de cuantización.

Alicia
Ese cambio estructural en el paisaje de pérdida es muy ingenioso. Pero la encuesta va más allá. Para algunos casos extremos y muy restringidos, incluso la cuantización de 8 bits sigue siendo demasiado pesada.

Beto
Oh, sí. Lo empujan aún más.

Alicia
Los ingenieros están empujando hacia una cuantización de muy bajo bit, como la binarización y la ternarización. Estamos hablando de aplastar números de punto flotante de 32 bits hasta un solo bit.

Beto
Este es un cambio radical porque dejamos de hacer cálculo tradicional y empezamos a hacer lógica digital simple.

Alicia
¿Qué significa eso?

Beto
Bueno, en la binarización, usando marcos como XNOR y XNOR-Net, reduces los pesos a un solo bit. Solo pueden representar uno negativo o uno positivo {-1, +1}, ó {0, 1}.

Alicia
Es literalmente solo encendido o apagado.

Beto
Exacto. La ternarización usa dos bits para sumar un cero, permitiendo uno negativo, cero o uno positivo {-1, 0, +1}. La gran ventaja aquí es que eliminas completamente la necesidad de operaciones de multiplicación complejas y consumidoras de energía.

Alicia
Porque ya no estás multiplicando nada.

Beto
Correcto. Las reemplazas con compuertas lógicas binarias básicas, específicamente X y OR y operaciones de recuento de bits ("pop count"). La unidad central de procesamiento de un microcontrolador puede ejecutar estas operaciones binarias casi instantáneamente, con una fracción de la energía requerida para la aritmética estándar.

Alicia
Pero la encuesta plantea un obstáculo importante cuando comprimes las cosas de esta manera extrema. Se llama "uniformización de distribución".

Beto
Sí, es complicado.

Alicia
Porque en una red neuronal entrenada naturalmente, los pesos no se distribuyen uniformemente. Tienden a agruparse justo alrededor de cero, formando una curva de campana o una distribución gaussiana.

Beto
Sí, exactamente.

Alicia
Si estoy pensando en esto lógicamente, si todos tus datos están agrupados cerca de cero, reducir la cuadrícula parece increíblemente derrochador. Todos esos puntos de datos se acumularán en solo uno o dos pasos en el centro de la cuadrícula, y estás dejando los bordes exteriores completamente vacíos.

Beto
Ese agrupamiento es una pesadilla total para la cuantización fija. Si tienes una cuadrícula de 8 bits que ofrece 256 pasos, pero el 90% de tus pesos cae en los 10 pasos centrales, estás convirtiendo efectivamente una cuantización de 8 bits en una cuantización de 3 o 4 bits.

Alicia
Simplemente pierdes todo el matiz.

Beto
Sí. Así que la encuesta destaca estrategias avanzadas como la regularización de kurtosis o KURE y la cuantización aplastada conocida como SqWQ.

Alicia
Pero ¿cómo resuelven esas técnicas realmente el problema de la curva de campana? Quiero decir, no puedes simplemente forzar a una red neuronal a cambiar su naturaleza matemática sin romperla.

Beto
Pero aplicas presión dirigida durante el proceso de entrenamiento. Estas técnicas añaden un término de penalización a la función de pérdida del modelo.

Alicia
Así que es castigado por agruparse.

Beto
Básicamente, sí. A medida que el modelo se entrena, es evaluado constantemente no solo por si obtiene la respuesta correcta, sino por qué tan uniformemente se distribuyen sus pesos. KURE, por ejemplo, apunta a una kurtosis, la inclinación o nitidez de ese pico de curva de campana. El algoritmo de entrenamiento empuja matemáticamente los pesos hacia afuera, penalizando al modelo si agrupa demasiados números cerca de cero. Literalmente aplana la curva de campana en un bloque uniforme para que se utilice cada bit disponible en esa cuadrícula de baja precisión.

Alicia
Eso es salvaje. Está remodelando la distribución física de las matemáticas. Ahora, ¿qué pasa si no quieres forzar cada capa de la IA en la misma caja diminuta?

Beto
Entonces usas precisión mixta.

Alicia
Correcto. La encuesta detalla la precisión mixta. Mi conclusión es que es como gestionar un presupuesto ajustado. No pones una rueda de dirección de oro macizo en un coche de alquiler barato. Solo gastas tus bits en las capas de la red que realmente necesitan alta precisión para capturar características complejas. Y luego usas cuantización de uno o dos bits para las capas que solo están haciendo el trabajo pesado básico.

Beto
Es una analogía perfecta, pero asignar esos bits dinámicamente requiere una cantidad increíble de ajuste. Marcos como HAWQ, que significa "cuantización consciente de la Hessiana" ("Hessian-aware quantization"), automatizan esto.

Alicia
¿Cómo descubre HAWQ el presupuesto?

Beto
Bueno, la Hessiana es una matriz matemática que describe la curvatura del paisaje de pérdida del que hablamos. HAWQ analiza esta matriz para determinar exactamente cuán sensible es cada capa individualmente al ruido de cuantización.

Alicia
Oh, así que mira los picos y los valles.

Beto
Exacto. La capa está sentada en una copa estrecha y empinada. HAWQ le asigna ocho bits. Si una capa está descansando en un cuenco ancho y plano, HAWQ la aplasta hasta dos bits. Crea un presupuesto optimizado personalizado para toda la red neuronal.

Alicia
La otra técnica de software que me dejó completamente impactado fue la "cuantización libre de datos" ("data-free quantization", o DFQ).

Beto
Oh, sí, DFQ es fascinante.

Alicia
La encuesta menciona que se usa cuando necesitas cuantizar un modelo. Pero debido a leyes de privacidad o regulaciones de datos médicos, legalmente no puedes acceder a los datos de entrenamiento originales para calibrar los errores de redondeo. ¿Cómo puedes calibrar un modelo para la compresión si estás volando completamente a ciegas?

Beto
Se basa en matemáticas forenses. Incluso si no tienes los datos originales, una red neuronal entrenada almacena metadatos internos sobre cómo se veía esos datos.

Alicia
Como una memoria de los datos.

Beto
Algo así. Específicamente, almacena estadísticas de normalización por lote ("batch normalization"). Estos son resúmenes matemáticos, la media y la varianza de los datos que pasaron a través de ella durante el entrenamiento.

Alicia
Vale. Así que tiene la forma estadística de los datos.

Beto
Correcto. DFQ usa estas estadísticas almacenadas para realizar ingeniería inversa de datos sintéticos. Genera entradas simuladas que activan exactamente las mismas respuestas estadísticas dentro de la red como lo harían los datos reales.

Alicia
Eso es increíble.

Beto
Lo es. Luego usas los datos sintéticos de ingeniería inversa para calibrar tu cuantización de forma segura sin tocar ni una sola pieza de información privada del usuario.

Alicia
Eso es brillante. Alucina datos simulados basados en los ecos de los datos reales para probarse a sí misma.

Beto
Exacto.

Alicia
Bueno, tenemos toda esta increíble teoría de software, precisión mixta, datos de ingeniería inversa y curvas de campana matemáticamente aplanadas. Pero nada de esto importa si no hay hardware físico que pueda ejecutarlo.

Beto
Muy cierto.

Alicia
La encuesta pinta una imagen muy clara del ecosistema de hardware. Y el caballo de batalla absoluto de toda la industria del ML diminuto es el ARM Cortex M4.

Beto
El Cortex M4 es ubicuo. Quiero decir, miles de millones están incrustados en dispositivos de todo el mundo.

Alicia
Y son súper baratos, ¿verdad?

Beto
Sí, cuestan desde unos pocos centavos hasta unos pocos dólares, funcionan con baterías de moneda ("coin cell batteries"), y crucialmente, poseen instrucciones básicas de procesamiento digital de señales que les permiten manejar la matemática de 8 bits de manera algo eficiente.

Alicia
Pero si el Cortex M4 es tan increíblemente barato y ya está integrado en miles de millones de dispositivos, ¿por qué las compañías de cable están vertiendo millones en desarrollar chips híbridos de próxima generación?

Beto
¿Porque hay un límite a lo que puede hacer el M4?

Alicia
La encuesta destaca específicamente las arquitecturas RISC-V y las MCU híbridas, como la serie MAX-78000. Si el M4 funciona, ¿qué brecha están llenando estos nuevos chips?

Beto
La brecha es la inferencia pesada en tiempo real, en el límite absoluto. Un microcontrolador estándar, como el Cortex M4, todavía depende de su procesador central principal para ejecutar la matemática de IA de forma secuencial.

Alicia
Así que simplemente va paso a paso.

Beto
Correcto. Es eficiente, pero puede crear un cuello de botella. La serie MAX78000 integra una "unidad de procesamiento neuronal" dedicada, o NPU, físicamente junto al procesador principal.

Alicia
Así que es un cerebro separado solo para la IA.

Beto
Exacto. Esta NPU está cableada para manejar bits muy bajos con pesos de forma nativa, hasta operaciones de un o dos bits. Procesa capas completas de la red neuronal en paralelo sin despertar al procesador principal.

Alicia
Vaya. ¿Así que ni siquiera molesta al procesador principal?

Beto
No. El resultado es un ahorro masivo de energía y cero latencia en la toma de decisiones.

Alicia
Así que tenemos estas NPUs altamente especializadas, pero no puedes simplemente tirar un archivo masivo de Python en un audífono.

El software tiene que hacer un puente físico al silicio.

Beto
Correcto. El despliegue es otro desafío completamente diferente.

Alicia
La encuesta destaca "TensorFlow Lite para microcontroladores" o TFLM, y algo llamado "arena de memoria" ("memory arena").

Beto
Sí. La arena de memoria es un salvavidas. Cuando estás operando en un chip con 256 kilobytes de memoria, la asignación dinámica de memoria, donde el programa solicita y libera memoria sobre la marcha es mortal. Causa fragmentación.

Alicia
¿Cómo es eso?

Beto
Imagina una estantería donde sigues agregando y quitando libros de diferentes tamaños. Eventualmente, tienes mucho espacio libre, pero está cortado en huecos diminutos e inutilizables.

Alicia
Oh, tiene sentido. Así que te quedas sin espacio, a pesar de que técnicamente tienes espacio.

Beto
Exacto. TFLM soluciona esto al tallar un bloque de memoria único y continuo al inicio llamado la arena. Las operaciones de las redes neuronales solo tienen lugar dentro de esa arena preasignada y gestionada de cerca, garantizando que el sistema nunca se fragmente ni falle.

Alicia
La encuesta también menciona el compilador EON de Edge Impulse, que toma un enfoque diferente para poner el modelo en el chip.

Beto
Sí, es una filosofía muy diferente. TFLM usa un intérprete, un programa pequeño que se sienta en el chip, lee el modelo de la red neuronal y lo traduce en acciones.

Alicia
Pero supongo que ese intérprete ocupa espacio.

Beto
Lo hace. Ocupa memoria preciosa solo por existir. El compilador EON elimina por completo el intérprete.

Alicia
¿Oh, en serio? ¿Cómo funciona entonces?

Beto
Analiza la red neuronal de antemano, elimina absolutamente cualquier operación matemática o librería de código que el modelo específico no esté utilizando activamente, y compila la red directamente en código fuente de Rust o C++.

Alicia
Eso es increíblemente eficiente.

Beto
Sí, crea el firmware súper ligero posible, construido a medida para ese chip específico.

Alicia
Entonces, ¿qué significa todo esto? Hemos explorado la teoría de la cuantización, la astucia del estimador de paso directo, el hardware NPU especializado y las arenas de memoria. Saquemos toda esta teoría técnica al mundo real. ¿Por qué debería importarte a ti, oyente, el hecho de que una IA pueda funcionar en un Cortex M4?

Beto
Deberías importarte porque la transición de la nube al borde ("edge") cambia fundamentalmente dónde y cómo opera la inteligencia. Permite que la IA funcione en entornos donde una conexión a la nube es físicamente imposible, o donde la latencia de enviar datos a un servidor y esperar una respuesta es peligrosa.

Alicia
¿Qué tipo de entorno?

Beto
Estamos mirando dispositivos portátiles de atención médica que monitorean ritmos cardíacos y detectan anomalías instantáneamente, o robótica industrial que procesa datos de sensores para reconocer instantáneamente un peligro de seguridad y detener una línea de ensamblaje.

Alicia
Hay una aplicación específica en la encuesta que ilustra perfectamente esto.

Los investigadores tomaron un Google Coral Micro, que es un microcontrolador de borde pequeño y barato, y aplicaron esa regularización de curtosis y cuantización post-entrenamiento INT8 que discutimos. Desplegaron esta placa de $20 en un satélite para realizar la detección activa de incendios desde el espacio, analizando imágenes satelitales multiespectrales en tiempo real.

Beto
Y eso es enorme. Porque sin ML diminuto, ese satélite tendría que tener imágenes masivas, crudas y de alta resolución de vuelta a la tierra para que una granja de servidores pudiera analizarlas.

Alicia
Lo cual tomaría una eternidad.

Beto
Exacto. Eso requiere un ancho de banda masivo, un gran consumo de energía para el transmisor, e introduce un peligroso retraso de tiempo. Al procesar la inferencia de la IA en el satélite mismo, solo necesita transmitir un pequeño paquete de datos y una señal de alerta en el momento exacto en que detecta la firma del fuego.

Alicia
Ahorra ancho de banda, acelera los tiempos de respuesta y resalta el tema principal final de la encuesta, que es la sostenibilidad. El ML diminuto es una vía crítica hacia una IA sostenible.

Beto
Lo es. El impacto ambiental de las granjas de datos masivas que entrenan y ejecutan modelos es una crisis global creciente. La encuesta apunta hacia un futuro de co-optimización de pila completa ("full stack co-optimization") y programación consciente de la vida útil.

Alicia
¿Cómo se ve la programación consciente de la vida útil?

Beto
Estamos avanzando hacia un paradigma donde estos modelos diminutos monitorean activamente su propio hardware. Un sensor y una selva remota gestionarán sus propios ciclos de cómputo basándose en la temperatura ambiente y el voltaje restante en su batería alimentada por energía solar.

Alicia
Así que sabe cuándo es seguro funcionar.

Beto
Correcto. Decide de forma independiente cuándo tiene suficiente energía para ejecutar una inferencia y cuándo necesita dormir, descentraliza la carga de cómputo, reduciendo masivamente la huella de carbono de la inteligencia artificial.

Alicia
Los dispositivos que nos rodean ya no son solo terminales tontos enviando nuestros datos a una nube central. Están procesando, filtrando y decidiendo activamente. Están haciendo inferencias complejas usando una fracción de un miliwatt.

Beto
Los medios de comunicación y la industria tecnológica en general están cautivados actualmente por modelos de lenguaje masivos de miles de millones de parámetros, operando como cerebros centralizados en enormes granjas de servidores.

Alicia
Oh, definitivamente. Eso es todo de lo que se habla.

Beto
Pero esta encuesta sugiere una arquitectura completamente diferente para el futuro. La verdadera revolución de la IA podría ser descentralizada. En lugar de un solo cerebro masivo, estamos construyendo un vasto sistema nervioso invisible. Está sucediendo en los objetos cotidianos que nos rodean, funcionando silenciosamente, eficientemente e independientemente en chips de $5.

Alicia
Es una revolución de inteligencia invisible y la base ya está construida. Esto concluye nuestro análisis profundo de hoy en la mecánica del ML diminuto y la cuantización de redes neuronales.

Muchas gracias por acompañarnos.

Los alentamos a seguir explorando, seguir investigando las fuentes y seguir cuestionando la inteligencia invisible que opera a nuestro alrededor.