Mostrando entradas con la etiqueta Estudiante. Mostrar todas las entradas

jueves, 22 de octubre de 2026

Diseño de Cursos en la Era de IA

Esta investigación presenta un marco matemático para el diseño de cursos educativos óptimos cuando los estudiantes tienen la opción de realizar las tareas por sí mismos o delegarlas a la inteligencia artificial. Al modelar las interacciones entre el desarrollo de habilidades del estudiante, el esfuerzo cognitivo y la asistencia de la IA, el estudio demuestra cómo los docentes deben ajustar la dificultad de las tareas para evitar que los estudiantes eviten el esfuerzo productivo esencial para el aprendizaje. Cuando la IA funciona como sustituto del esfuerzo, los cursos óptimos deben pasar de diseños intensivos en habilidades, a diseños intensivos en esfuerzo para mantener el interés, mientras que la IA complementaria requiere enfoques personalizados según la capacidad del estudiante. En definitiva, los hallazgos indican que las mejoras en la calidad de la inteligencia artificial pueden acelerar el aprendizaje de los estudiantes con altas habilidades, pero dificultar el de los estudiantes con bajas habilidades, lo que subraya la importancia del diseño estratégico del currículo en la educación moderna.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Course design in the age of AI". Por Benjamin Davies. Publicado el 2 de Septiembre de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Quiero que imagines que estás pisando el suelo de esta fábrica perfectamente calibrada. Es este enorme conjunto de ensamblaje, ¿verdad?

Beto
Ah, claro. Como engranajes rechinando, pistones disparando.

Alicia
Exacto. Las materias primas van por un lado, la maquinaria zumba. Cantidades de calor que irradia el metal. Y está haciendo exactamente lo que fue diseñado para hacer.

Beto
Correcto. Requiere una cantidad masiva de energía, pero funciona impecablemente.

Alicia
Sí. Y en el otro extremo, sale un producto terminado y bellamente acabado. Es completamente predecible.

Beto
Es un circuito cerrado, en realidad. Un ciclo de esfuerzo y recompensa. Cada pieza móvil en esa fábrica tiene un propósito. Y mientras mantengas la maquinaria, alimentes la materia prima, esa alta calidad de producción está esencialmente garantizada.

Alicia
Pero entonces alguien entra en la fábrica e instala este botón rojo brillante, justo en medio de la sala, un botón mágico.

Beto
Uh oh. Siento que sé a dónde va esto.

Alicia
Seguro. Lo presionas y un producto terminado se materializa instantáneamente al final de la línea. Ningún engranaje está girando.

Beto
Ninguna energía gastada.

Alicia
Exactamente. Nada de calor, nada de fricción, pero hay una trampa oculta. Cada vez que presionas ese botón para obtener el producto gratis, la maquinaria física real de la línea de ensamblaje comienza a oxidarse.

Beto
Bueno.

Alicia
Sí, los engranajes se fusionan, el motor se degrada. Si miras puramente la producción al final de la línea, todo parece estar perfectamente bien. Pero la máquina misma está muriendo silenciosamente.

Beto
Lo cual es francamente una forma aterradora de mirar la cognición humana. Pero digo, captura la realidad exacta con la que estamos lidiando hoy. Estamos produciendo más resultados que nunca, pero la maquinaria interna que solíamos pensar, quizás se está oxidando en el proceso.

Alicia
Bienvenidos a nuestra inmersión profunda de hoy. Vamos a explorar un documento de trabajo fascinante de 2026 de la Universidad de Stanford, del economista Benjamin Davies. Simplemente titulado "Diseño de cursos en la era de la IA".

Beto
Es una obra maestra.

Alicia
Lo es. Y nuestra misión hoy es comprender la realidad matemática y económica de cómo la IA está rompiendo fundamentalmente la educación tradicional y, exactamente cómo se están obligando a los profesores a rediseñar la forma en que aprendemos.

Beto
Sí. Y para ustedes que están escuchando, esta dinámica se aplica a mucho más que solo un aula universitaria.

Alicia
Totalmente. Ya sea que estés tomando activamente un curso de desarrollo profesional o tratando de mejorar tus habilidades en tu carrera o simplemente tratando de mantenerte alerta en tu resolución de problemas diaria, enfrentas una elección cada día.

Beto
¿Haces el trabajo cognitivo tú mismo o se lo entregas a una IA?

Course_Design_in_AI_Age_1024.png
Diseño de Cursos en la Era de IA: Adaptando la Secuencia de Tareas, para el Desarrollo de Habilidades

Alicia
Correcto. Y hoy vamos a mirar debajo del capó el costo a largo plazo oculto de esa elección específica.

Beto
Para entrar realmente en la mecánica de este artículo, primero tenemos que establecer el conflicto central que Davies está modelando aquí. En esencia, es una batalla de incentivos.

Alicia
Okay.

Beto
Por un lado de la ecuación, tenemos lo que el artículo denomina un estudiante miope.

Alicia
Y solo para aclarar, miope no significa que tengan mala vista, ¿verdad?

Beto
Correcto. Significa que su horizonte temporal es extremadamente corto. Está hiper-enfocado en el presente inmediato.

Alicia
Tal como lo que tengo frente a mí ahora mismo.

Beto
Exacto. Solo les importa obtener una buena nota o generar un trabajo de alta calidad en este momento. Y quieren hacerlo con la mínima cantidad de esfuerzo posible.

Alicia
Es el camino de menor resistencia.

Beto
Solo quieren el resultado.

Alicia
Sí.

Beto
Pero en el otro lado de la ecuación, tenemos al profesor con visión de futuro. Y aquí está la desconexión crucial. Al profesor no le importa realmente la producción (el resultado, la salida).

Alicia
Espera, ¿de verdad?

Beto
Para nada. No en el vacío. No. El ensayo, la hoja de trabajo de matemáticas, el código, es completamente irrelevante para el profesor. El único objetivo real del profesor es que el estudiante construya una habilidad subyacente a largo plazo.

Alicia
Oh, ya veo.

Beto
La producción es solo un subproducto. Es un subproducto de que el estudiante construya esa maquinaria mental.

Alicia
Okay. Entonces, antes de llegar al botón rojo mágico que explota toda esta dinámica, hablemos de la fábrica antes de que se instalara el botón. ¿Cómo optimizaron los profesores el aprendizaje antes de que existiera la IA?

Beto
Davies llama a esto "el primer mejor mundo". En este entorno pre-IA, el aprendizaje está gobernado por una fórmula muy sencilla. La producción es generada por una combinación de dos insumos: esfuerzo y habilidad.

Alicia
Esfuerzo y habilidad.

Beto
Entendido. Vamos a desglosarlos.

El esfuerzo conlleva un alto costo cognitivo. Es agotador esforzarse, concentrarse, luchar contra un problema.

Alicia
Oh, seguro.

Beto
Pero el modelo opera bajo una regla absoluta. Ejercer esfuerzo es la única manera que un estudiante puede construir habilidad.

Alicia
El sudor es la única moneda.

Beto
Exacto. El sudor es la moneda. Y una vez que compras esa habilidad con tu esfuerzo, la habilidad en sí es completamente gratuita de usar.

Alicia
Interesante.

Beto
Piensa en la habilidad como un multiplicador. Si tienes una alta habilidad, tu esfuerzo puro se vuelve increíblemente eficiente. Podrías hacer cosas complejas muy rápidamente.

Alicia
Okay, desglosémoslo. Si un profesor sabe que el estudiante naturalmente quiere evitar el esfuerzo, ¿verdad? Pero el esfuerzo es lo único que realmente crea habilidad. ¿Cómo obliga el profesor a introducir el tema? ¿Qué palancas pueden tirar cuando están diseñando la tarea, o los exámenes?

Beto
Bueno, controlan el diseño de las tareas. El artículo distingue entre dos tipos específicos de diseño de tareas: intensidad de esfuerzo e intensidad de habilidad.

Alicia
Okay, ¿cómo se ven eso en la práctica?

Beto
Si un profesor asigna una tarea intensiva en esfuerzo, el estudiante está aplicando un método conocido a un problema. El artículo usa el ejemplo del cálculo, como usar la regla de potencia para diferenciar estas funciones polinómicas.

Alicia
Correcto. Así que el estudiante conoce la regla. Solo tiene que luchar a través de la mecánica de unos 30 problemas de matemáticas diferentes.

Beto
Puro trabajo pesado.

Alicia
Solo fricción.

Beto
Fricción.

Por otro lado, una tarea intensiva en habilidad es completamente diferente. Requiere que el estudiante identifique el método correcto desde el principio.

Alicia
Oh, eso es mucho más difícil.

Beto
Demasiado. El ejemplo del artículo aquí es construir un modelo económico manejable. No puedes simplemente luchar a través de eso con tu sudor. Si no tienes la capacidad conceptual subyacente, la habilidad, ni siquiera sabrás por dónde empezar.

Alicia
Eso tiene perfecto sentido. Es exactamente como un entrenamiento de gimnasio, ¿verdad?

Beto
Oh, totalmente.

Alicia
Cuando empiezas a levantar pesas, tu forma puede ser súper básica. Y se trata puramente de esfuerzo físico puro y duro. Solo tienes que levantar el hierro pesado y ponerlo abajo.

Beto
Sí, solo eso.

Alicia
Exacto. No puedes subcontratar ese levantamiento pesado a tu compañero y esperar que tus propios músculos crezcan. Tu sudor es la moneda que compra el músculo.

Beto
Me gusta mucho esa analogía. Vamos a mapearlo en la línea de tiempo del diseño de curso pre-IA del artículo.

Alicia
Okay.

Beto
Si eres el profesor y tu objetivo es maximizar la masa muscular final del estudiante, su habilidad, tienes que secuenciar el entrenamiento perfectamente.

El primer día del semestre, el estudiante tiene básicamente cero habilidad.

Alicia
Correcto.

Beto
Así que el profesor debe comenzar con tareas intensivas en esfuerzo. El estudiante lucha con lo básico. Paga el costo cognitivo y lentamente su nivel de habilidad aumenta.

Alicia
Pero déjame contradecir eso por un segundo. Si el objetivo final de todo el curso es producir un estudiante capaz de pensamiento complejo de alto nivel como las tareas intensivas en habilidad, ¿por qué no simplemente sumergirlos de lleno?

Beto
Quieres decir, ¿saltarte lo básico?

Alicia
Sí.

ABeto
Exacto. ¿Por qué el profesor no les da simplemente las tareas más difíciles, las más intensivas en habilidad, desde el primer día y salta todo el proceso repetitivo de fricción?

Beto
Bueno, porque la matemática subyacente del aprendizaje humano lo prohíbe. El esfuerzo y la habilidad son insumos complementarios.

Alicia
¿Cómo es eso?

Beto
Si un estudiante tiene habilidad fundamental cero y tú le entregas una tarea intensiva en habilidad como, pedirle a un estudiante de primer año que construya un modelo macroeconómico completo. Chocarán contra un muro. Su producción será exactamente cero.

Alicia
Correcto. Y como el estudiante es miope y solo le importa la producción, ...

Beto
Mirará la tarea imposible, se dará cuenta de que va a fallar de todos modos. Y ejercerá cero esfuerzo.

Alicia
Y nada de sudor significa nada de músculo.

Beto
Exacto. Si ejerces cero esfuerzo, aprendes cero habilidad. Todo el sistema colapsa.

Alicia
Vaya.

Beto
Entonces, el profesor tiene que proporcionar tareas tempranas donde el esfuerzo crudo y sin refinar del estudiante se traduzca en una victoria tangible. Eso los mantiene enganchados en el juego lo suficiente para construir la base.

Alicia
Correcto.

Beto
Una vez que tienen esa base, el profesor lentamente gira el dial. Hacen que las tareas posteriores sean menos sobre esfuerzo crudo y mucho más sobre habilidad compleja. Esa es la situación perfecta, perfectamente optimizada en el mundo pre-IA.

Alicia
Así que si ese esfuerzo de fricción es absolutamente necesario para hacer girar los engranajes, ¿qué sucede cuando un estudiante de repente tiene una máquina en su bolsillo que puede evitar la fricción por completo? El botón rojo mágico aparece en el suelo de la fábrica.

Beto
Sí. Entramos en la era de la delegación. Esto es lo que Davies llama "la segunda mejor realidad". La IA introduce una alternativa brutalmente tentadora para nuestro estudiante miope, la capacidad de generar una producción perfecta con cero esfuerzo cognitivo.

Alicia
Simplemente le dan la instrucción a un chatbot: "escribe mi ensayo".

Beto
Sí. Delegan la tarea. El artículo señala que esto, cita "corto-circuita el esfuerzo productivo esencial para el aprendizaje".

Alicia
El esfuerzo productivo. Me gusta esa frase.

Beto
Es crucial. El estudiante obtiene el ensayo. Lo entrega. Obtiene la nota que quería. Pero como no pagaron ningún costo cognitivo, el desarrollo de habilidades se estanca por completo. La maquinaria se oxida.

Alicia
Así que prohibir el botón mágico parece la respuesta obvia, ¿verdad? Pero el artículo simplemente lo toma como un hecho de que no puedes.

Beto
Realmente no puedes. La tecnología es ubicua. Está en sus teléfonos. Está incorporada en sus procesadores de texto. No puedes vigilarla eficazmente.

Alicia
Correcto. Así que si un profesor sabe que el estudiante tiene esta herramienta, ¿cómo puede rediseñar el curso para evitar que el estudiante simplemente delegue cada tarea?

Beto
Esto genera una pregunta importante, ¿verdad? ¿Cómo engañas a un estudiante miope para que trabaje?

Alicia
Sí, ¿cómo?

Beto
Tienes que distorsionar completamente el diseño óptimo del curso. Ya no pueden seguir la jugada de primer método del que hablamos.

Alicia
Porque el estudiante simplemente hará trampa en las cosas fáciles.

Beto
Precisamente. Para contrarrestar la tentación abrumadora de delegar al principio cuando la habilidad del estudiante es más baja, el profesor tiene que reducir la intensidad del esfuerzo de esas tareas tempranas y hacerlas artificialmente más intensivas en habilidad.

Alicia
Espera, ¿cómo hacerla más difícil evita que usen la IA?

Beto
No es necesariamente hacerla más difícil. Es hacer la tarea resistente a una simple delegación de copiar y pegar. Tienes que pedir algo que la IA no pueda fingir fácilmente en nombre del estudiante sin que el estudiante entienda realmente lo que está entregando.

Alicia
Oh, ya veo. Y estamos viendo esto en todas partes ahora mismo. Hablas con profesores o incluso maestros de secundaria y están cambiando completamente sus programas de estudio.

Beto
Sí. El artículo menciona algunos ejemplos del mundo real de esto de Chirikov en 2026.

Alicia
Oh, correcto. Como ya no pueden simplemente asignar un ensayo de cinco páginas sobre la Revolución Francesa. Están obligando a los estudiantes a rastrear el historial de su documento de Google para demostrar que lo escribieron o, más comúnmente, están haciendo exámenes orales en clase donde el estudiante tiene que defender verbalmente las elecciones que hizo en el ensayo.

Beto
Exacto. Pedirle a un estudiante que explique verbalmente su razonamiento sobre la marcha es una tarea altamente intensiva en habilidad.

Alicia
Porque la IA puede escribir el ensayo, pero no puede pararse frente a la clase y responder preguntas dinámicas por el estudiante.

Beto
Bingo. El profesor está matemáticamente obligado a inyectar esa alta intensidad de habilidad mucho antes en el curso, puramente como mecanismo de defensa.

Alicia
Pero bueno, esto lleva a una realización que me detuvo en seco mientras leía este artículo del profesor: Al obligar al profesor a defenderse, la IA está dañando activamente a los estudiantes que ni siquiera están haciendo trampa.

Beto
Sí, explícanos eso.

Alicia
Bueno, si al profesor se le obliga a usar un diseño de curso matemáticamente subóptimo y distorsionado solo para evitar la delegación, entonces el camino del aprendizaje ya no está perfectamente calibrado para construir habilidad.

Beto
Correcto.

Alicia
Por lo tanto, el estudiante termina desarrollando menos habilidad general al final del semestre de lo que la habría hecho en el mundo pre-IA.

Beto
Es inevitable.

Alicia
Incluso si tienes un estudiante muy ético que rechaza los chatbots y quiere hacer el trabajo, la mera presencia de la IA en el mundo más amplio obliga al profesor a rediseñar el curso de una manera que reduce el techo total de aprendizaje para todos.

Beto
Es una profunda tragedia de los comentarios. Para asegurar que el estudiante aprenda algo, el profesor tiene que aceptar la realidad de que, finalmente, aprenderán menos de lo que podrían haber aprendido.

Alicia
Vaya.

Beto
Esta postura defensiva es esencialmente un impuesto invisible permanente sobre el desarrollo del capital humano.

Alicia
Eso es increíblemente sombrío.

Beto
Lo es.

Alicia
Pero veamos el otro lado aquí porque la IA no es puramente una hoja de respuestas que hace tu tarea por ti. También es una herramienta. ¿Qué sucede cuando un estudiante usa la IA no para saltarse el trabajo, sino para mejorar su propio esfuerzo?

Beto
Ah, okay. El artículo modela esto introduciendo un parámetro de calidad de IA representado por la letra Q.

Alicia
Aquí es donde se pone realmente interesante, gente.

Beto
Lo hace. Esto cambia el escenario de la pura delegación a algo mucho más matizado. En lugar de tratar a la IA como un sustituto, donde simplemente le entregas toda la tarea y te vas, ahora el estudiante usa la IA como complemento.

Alicia
Okay.Entonces, ¿cómo se ve eso en la práctica?

Beto
Significa que el estudiante usa su propia habilidad existente para deconstruir un proyecto grande en tareas subsidiarias más pequeñas.

Alicia
Como desglosarlo.

Beto
Correcto. Pueden esbozar un ensayo, determinar los argumentos clave y luego usar la IA para ayudar a redactar párrafos específicos o revisar su lógica o, depurar un bloque de código específico que escribieron.

Alicia
Así que todavía están conduciendo el coche. La IA es solo el motor.

Beto
Exacto.

Alicia
Me hace pensar en una sierra eléctrica.

Beto
¿Una sierra eléctrica?

Alicia
Sí. Si le das una sierra eléctrica de primera línea a un carpintero maestro, no solo la usa para sentarse y no hacer nada. La usa para construir una casa en la mitad de tiempo.

Beto
Correcto.

Alicia
Y luego usan el tiempo que ahorraron para dedicarse a proyectos más complejos para refinar los detalles intrincados de su oficio y para empujar los límites de su habilidad aún más. La herramienta fundamentalmente aumenta su maestría.

Beto
Esa es una imagen muy útil.

Pero la matemática en el artículo lo lleva aún más allá de solo ahorrar tiempo. Cuando mejoras la calidad de la IA, cuando subes ese parámetro Q, desencadena una divergencia estructural masiva basada enteramente en el nivel de habilidad inicial del estudiante.

Alicia
Espera, así que la habilidad inicial importa tanto.

Beto
Es todo.

Veamos al carpintero maestro en tu ejemplo, o al estudiante de secundaria en el modelo. Puesto que su esfuerzo es repentinamente potenciado por esta IA de alta calidad, el costo cognitivo de hacer el trabajo se siente mucho menor, en relación con la producción masiva de alta calidad que están generando de repente.

Alicia
Ah, así que el retorno de la inversión para su esfuerzo se dispara.

Beto
Precisamente. Realmente eligen ejercer más esfuerzo.

Alicia
Espera, ¿de verdad? Puesto que es más fácil, trabajan más duro.

Beto
Exacto. Y como el esfuerzo es igual al crecimiento de la habilidad, aprenden y construyen habilidades avanzadas a un ritmo acelerado e inédito.

Pero si miras al estudiante de baja habilidad, ...

Alicia
La persona que nunca ha construido nada, ni siquiera sabe cómo medir una tabla o enmarcar una pared.

Beto
Correcto. No tienen la habilidad fundamental requerida para desglosar una tarea compleja en tareas subsidiarias manejables. No pueden dirigir la IA de manera efectiva.

Así que recurren a usar la IA puramente como un sustituto.

Alicia
Simplemente presionando el botón mágico.

Beto
Sí. Y como la IA es increíblemente buena generando resultados competentes, la tentación de simplemente presionar generar y marcharse es abrumadora. Ejercen mucho menos esfuerzo. Y por lo tanto, su desarrollo de habilidad se estanca por completo.

Alicia
Así que exactamente la misma herramienta, en exactamente el mismo entorno, actúa como un cohete para los hábiles, y un sedante para los novatos. Y así sucesivamente. Davies conecta esta divergencia matemática directamente con el trabajo del premio Nobel James Heckman.

Alicia
He oído hablar de él.

Beto
Heckman se centra en el concepto de que "la habilidad da a la habilidad". Piénsalo como interés compuesto, pero para tu cerebro.

Alicia
Me encanta ese "interés compuesto para tu cerebro".

Beto
Correcto. Las ganancias cognitivas que haces hoy actúan como el principio para el interés que ganas mañana. Una ligera ventaja inicial en la habilidad fundamental no solo añade un beneficio lineal. Se multiplica masivamente con el tiempo a través de una secuencia de tareas complejas.

Alicia
Así que el estudiante de alta habilidad que usa la IA no solo se mantiene una ventaja por delante. Puesto que está usando la herramienta para aprender a aprender más rápido, su curva de habilidad se vuelve completamente exponencial, dejando al estudiante de baja habilidad, cuya curva se estanca, por completo en el polvo.

Beto
La brecha entre los dos se convierte en un abismo insalvable.

Alicia
Pero entonces, ¿qué significa todo esto? Si esa inmensa brecha se está abriendo, ¿por qué la realidad no se ve así?

Beto
¿Qué quieres decir?

Alicia
Bueno, si miramos alrededor de las universidades o los lugares de trabajo corporativos ahora mismo, los datos empíricos muestran que la IA parece estar estrechando la brecha de rendimiento. Todos están entregando ensayos con nota A. Los codificadores junior están enviando código funcional que se parece exactamente al trabajo de ingenieros sénior. Si los estudiantes de alta habilidad están acelerando hacia la estratosfera y los estudiantes de baja habilidad están estancándose, ¿por qué muestra los datos que el rendimiento se comprime?

Beto
Lo fascinante aquí es cómo el modelo resuelve esta misma paradoja. Y todo se reduce a una confusión social fundamental. Estamos mirando los datos y confundiendo la producción con habilidad.

Alicia
Producción versus habilidad.

Beto
No son lo mismo.

Alicia
Es la ilusión de competencia.

Beto
Es una ilusión total. Cuando un estudiante o empleado de baja habilidad delega una tarea a una IA, la IA eleva su producción cruda hasta la competencia base de la máquina, lo que podría ser equivalente a un humano de alta habilidad.

Alicia
Okay. Así que en papel, si un profesor solo está calificando el ensayo o un gerente solo está revisando las líneas de código, los productos de trabajo se ven idénticos.

Beto
Exacto. La brecha de producción se comprime por completo.

Alicia
Así que en la superficie, todos parecen un genio, pero debajo del capó, ...

Beto
Bajo el capó, en lo profundo de la maquinaria cognitiva de los individuos, esa divergencia compuesta que acabamos de hablar está rugiendo.

Alicia
Vaya.

Beto
El estudiante de alta habilidad está usando la IA para hacer maratones mentales. Estirando constantemente su capacidad cognitiva y avanzando cada vez más en la capacidad humana real. El estudiante de baja habilidad solo está conduciendo un carrito de golf.

Alicia
Ambos cruzan la meta exactamente al mismo tiempo. La producción es la misma, pero solo uno de ellos está realmente en forma.

Beto
Y el mercado eventualmente reconocerá quién está en forma.

Alicia
Lo que nos lleva directamente a la puerta para ti, el oyente.

Estamos entrando en una economía donde la IA está comoditizando rápidamente la producción cruda.

Beto
Muy rápidamente.

Alicia
Muy pronto, cualquiera con conexión a internet podrá generar un memorando perfectamente competente o un software funcional o una estrategia de marketing decente por esencialmente $0 y cero esfuerzo, lo que significa que tu producción ajustada al costo ya no es tu ventaja competitiva.

Beto
Para nada.

Alicia
Generar la cosa es solo el precio de entrada.

Beto
Si juzgas tu valía profesional por el volumen puro o incluso la calidad básica de tu producción, estás jugando un juego que inevitablemente perderás contra una máquina. El mercado eventualmente fijará el precio de la producción generada por IA en cero.

Alicia
Tu único foso verdadero es tu habilidad invisible subyacente. Tu capacidad humana para identificar los métodos correctos para hacer las preguntas correctas y altamente contextuales para desglosar problemas caóticos en tareas subsidiarias que una IA pueda procesar. Esa es la prima.

Beto
Lo que nos lleva a un pensamiento bastante escalofriante escondido en la conclusión del artículo de Davies.

Alicia
Oh, sí, esta parte fue salvaje.

Beto
Correcto. A lo largo de todo este modelo matemático, la suposición ha sido una relación uno a uno, un profesor diseñando un curso para un estudiante.

Alicia
Pero esa no es la realidad. Un profesor del mundo real está frente a una sala de conferencias con 30, quizás 300 estudiantes. Un gerente corporativo está liderando un equipo de 20 empleados diferentes.

Beto
Exacto.

Alicia
Y en cualquier grupo de ese tamaño, tienes una distribución increíblemente amplia de habilidades iniciales.

Beto
Y si la IA causa naturalmente esta divergencia compuesta entre la cima y el fondo, si los estudiantes de secundaria están subiendo y los estudiantes de secundaria están estancándose, ese único profesor se enfrenta a una elección imposible, casi distópica, en cómo diseñar el curso.

Alicia
Porque ¿cómo diseñas un sistema para dos especies de estudiantes totalmente diferentes?

Beto
Exacto. ¿Beberían diseñar el curso para el estudiante promedio?

Alicia
Si lo hacen, tienen que mantener esas restricciones defensivas y altamente restrictivas para evitar que la mitad inferior delegue todo.

Beto
Correcto. Pero al hacerlo, están obstaculizando activamente a los estudiantes de arriba. Les impiden usar la IA para alcanzar su potencial exponencial.

Alicia
Oh, hombre.

Beto
O hacen la elección brutal de optimizar por la cima.

Alicia
Lo que significa que relajan intencionalmente las restricciones, permiten una integración masiva de la IA y simplemente empujan a los estudiantes de secundaria a sus límites cognitivos absolutos.

Beto
Sabiendo muy bien que al eliminar las barreras, están dejando efectivamente atrás a los estudiantes de secundaria.

Alicia
Completamente atrás.

Beto
Están literalmente permitiendo que la parte inferior delegue a la IA, estanque su desarrollo de habilidad y se oxide. Simplemente porque el costo de oportunidad de frenar a las mentes más talentosas se ha vuelto demasiado imposible. Decidir si salvar al promedio o liberar a los brillantes.

Realmente te hace mirar tus propios hábitos diarios con mucha más lupa.

Alicia
Absolutamente.

Beto
Mientras pasas por tu semana, abordando tus propios proyectos y aprendiendo tu propio material, te animo a mirar las tareas que tienes enfrente y preguntarte honestamente, ¿estás presionando el botón mágico para evitar el costo cognitivo? ¿O estás usando la herramienta para elevar tu propio techo?

Porque esa línea de ensamblaje perfectamente calibrada en tu mente solo se mantiene nítida si sigues haciendo girar los engranajes.

Alicia
Exacto. Feliz aprendizaje a todos.

miércoles, 12 de agosto de 2026

Destilación del Conocimiento: El Aprendizaje entre Profesor y Estudiante


El presente texto ofrece un estudio completo sobre la destilación del conocimiento ("Knowledge Distillation", KD), una técnica especializada de compresión de modelos que se utiliza para entrenar modelos de estudiantes pequeños mediante la transferencia de "conocimiento oculto" de modelos de profesores grandes y complejos. Este proceso aborda el desafío de implementar redes neuronales profundas masivas en hardware con recursos limitados, como los teléfonos móviles, al reducir los costos computacionales y de almacenamiento manteniendo una alta precisión. Los autores clasifican la información destilada en conocimiento basado en respuestas, basado en características y basado en relaciones, cada uno dirigido a diferentes capas de la arquitectura del profesor. Además, el artículo describe varios esquemas de entrenamiento —incluidos el entrenamiento fuera de línea, en línea y la autodestilación— para explicar cómo interactúan estos modelos durante el proceso de aprendizaje. Más allá de la simple compresión, el estudio explora algoritmos avanzados como la destilación adversaria y los marcos de múltiples profesores, demostrando la versatilidad de la KD en diversas aplicaciones como el reconocimiento visual y el procesamiento del lenguaje natural. En definitiva, el texto proporciona una hoja de ruta estructurada del estado actual del campo, al tiempo que destaca las futuras líneas de investigación y los obstáculos técnicos existentes.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Knowledge Distillation: A Survey". Por Jianping Gou y colegas. Publicado el 20 de Mayo de 2021.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Pido que te tomes un segundo y simplemente mires tu teléfono inteligente. De verdad, míralo.

Alicia
Sí. Adelante y sácalo de tu bolsillo o simplemente muéstralo si está sobre tu escritorio ahora mismo.

Beto
Correcto. Porque durante la última década o así, hemos desarrollado esta expectativa increíblemente, bueno, absurda por estas pequeñas planchas de vidrio y metal.

Alicia
Oh, totalmente. Esperamos que básicamente tengan las capacidades cognitivas de una supercomputadora masiva.

Beto
Exacto. Quiero decir, hablamos con ellas y transcriben nuestro discurso en tiempo real. Apuntamos la cámara a un letrero de calle extranjero y ¡pum!, traducen el texto instantáneamente.

Alicia
Esperamos que el reconocimiento facial simplemente desbloquee nuestras pantallas en milisegundos.

Beto
Sí. Pero si te detienes y realmente piensas en la realidad física por un segundo, ¿cómo encaja exactamente un cerebro artificial que tradicionalmente requiere una gran granja de servidores del tamaño de un almacén en tu bolsillo?

Alicia
Es una contradicción fundamental en la computación moderna, de verdad. Quiero decir, por un lado, tienes estos modelos de aprendizaje profundo de vanguardia que se vuelven más inteligentes cada día. Pero como resultado directo, se vuelven exponencialmente más grandes y, mucho más demandantes de energía.

Beto
Lo cual es un gran problema para los dispositivos móviles.

Alicia
Exacto. Porque por otro lado, los dispositivos que realmente usamos a diario están limitados por límites físicos implacables. Estamos hablando de restricciones térmicas, duración de la batería, chips de memoria diminutos.

Beto
Sí. Un modelo de IA masivo simplemente sobrecalentará un teléfono móvil, o agotará su batería en cinco minutos.

Alicia
Oh, seguro. Simplemente derretiría la cosa.

Beto
Así que para descubrir cómo la industria tecnológica está resolviendo esta fricción masiva entre hardware y software, estamos haciendo un análisis profundo en un artículo académico increíblemente completo hoy.

Alicia
Es fascinante.

Beto
Lo es. Se titula "Knowledge Distillation: A Survey" ("Destilación de Conocimiento"). Y es de los investigadores Jianping Gou y colegas.

Alicia
Recomiendo encarecidamente que lo revisen.

Beto
Absolutamente. Así que nuestra misión para esta inmersión profunda es desempacar este truco mágico exacto. Vamos a explorar cómo un proceso llamado "Destilación de Conocimiento" ("Knowledge Distillation", KD) extrae la inteligencia cruda de modelos de IA masivos y engorrosos, ...

Alicia
... y la transfiere a modelos pequeños y ligeros, modelos estudiante.

Beto
De acuerdo. Así que pueden ejecutarse directamente en los dispositivos que tienen en sus manos ahora mismo. Bien. Vamos a desempacar esto.

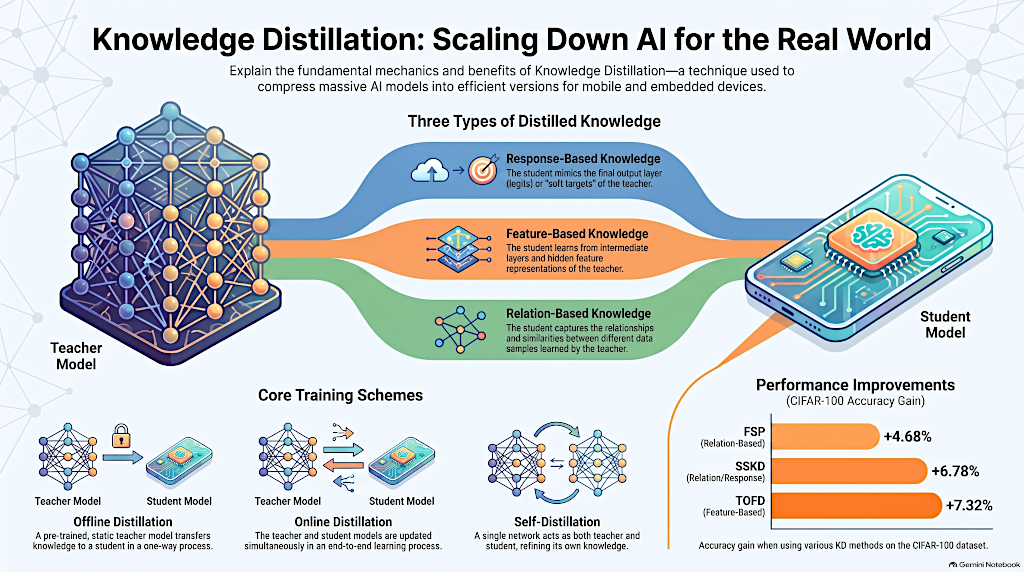
Knowledge_Distillation_1024.png
Destilación del Conocimiento: Reduciendo la Escala de la IA para el Mundo Real.

Alicia
Para apreciar realmente la elegancia de la solución aquí. Primero tenemos que captar la asombrosa escala del problema.

Beto
Sí. Dibuja una imagen para nosotros.

Alicia
Bueno, de hecho, actualicé mi fondo de video a una torre de granja de servidores zumbantes porque, bueno, porque esa es la realidad física del aprendizaje profundo ahora mismo.

Beto
Son simplemente estanterías interminables de computadoras.

Alicia
Interminables. El campo debe casi todos sus avances recientes a la escalada. Quiero decir, estamos maniobrando miles de millones, a veces incluso billones de parámetros ahora.

Beto
Espera, solo para aclarar para todos, cuando dices parámetros, estás hablando de los millones de pesos matemáticos y sesgos pequeños que la red utiliza para tomar una decisión, ¿cierto?

Alicia
Exacto. Las conexiones individuales pequeñas y los modelos de referencia estándar como ResNet para el reconocimiento de imágenes, o una BERT para el procesamiento del lenguaje natural. Requieren clústeres increíblemente potentes de GPU o TPU.

Beto
Y tienen que ejecutarse continuamente durante semanas solo para entrenar la cosa.

Alicia
Solo para entrenarlo una vez. Sí. Así que desplegar esos colosos en aplicaciones de borde (edge) en tiempo real, como digamos un coche autónomo que necesita tomar una decisión de vida o muerte en una fracción de segundo.

Beto
Correcto. O una cámara de vigilancia de video local.

Alicia
Sí. Es básicamente un impedimento. La complejidad computacional es demasiado alta. El tiempo de inferencia es demasiado lento, y la lectura y escritura constante en la memoria ahogaría todo el sistema.

Beto
Lo que nos lleva al concepto central de la "destilación de conocimiento", que a menudo se abrevia como KD ("Knowledge Distillation").

Alicia
Correcto. KD. El fundamento de esta idea fue propuesto originalmente por Bucilǎ en 2006. Y luego fue formalizado y popularizado más tarde por Geoffrey Hinton en 2015.

Beto
Ok, ¿cuál es el concepto real?

Alicia
El concepto es tomar un modelo grande totalmente entrenado, que llamamos el profesor ("teacher"), y transferir su información aprendida a un modelo mucho más pequeño y no entrenado, el estudiante ("student").

Beto
Y el objetivo es hacerlo sin sufrir una caída significativa en la precisión.

Alicia
Precisamente. Quieres que el estudiante pequeño funcione casi tan bien como el profesor gigante.

Beto
Espera. Así que, ¿es esto como comprimir un archivo en mi computadora para hacerlo más pequeño? ¿Como si simplemente comprimiéramos los datos y lo descompiéramos cuando los necesitemos?

Alicia
No, no realmente. Quiero decir, comprimir un archivo es una forma de compresión sin pérdida ("lossless"), ¿cierto? Obtienes exactamente los mismos datos cuando lo descomprimes. Eso no es lo que está sucediendo aquí.

Beto
Oh, okay. Entonces, no es compresión.

Alicia
La comparación más cercana a lo que estás pensando es probablemente la poda de parámetros ("parameter pruning"), que es más como comprimir agresivamente un JPEG hasta que pierda calidad.

Beto
Okay. Así que en la poda, tomas un modelo grande y cortas físicamente los pesos redundantes.

Alicia
Sí, literalmente quitando partes de la arquitectura de la red para reducir su huella. Pero la destilación de conocimiento es una filosofía totalmente diferente.

Beto
¿Cómo es eso?

Alicia
No se trata de recortar físicamente la arquitectura del profesor. Se trata de clonación de comportamiento ("behavioral cloning"). Se trata, bueno, es "educación".

Beto
"Educación", como una escuela de verdad.

Alicia
Un maestro enseñando a un aprendiz, es probablemente la mejor manera de verlo. Quiero decir, el aprendiz no hace crecer físicamente su cerebro para que coincida con el tamaño del cerebro del maestro, ¿cierto?

Beto
Correcto. Eso sería aterrador.

Alicia
Exacto. En cambio, el aprendiz es expuesto al comportamiento de resolución de problemas del maestro. En la KD, la red estudiante se construye desde cero para ser pequeña y eficiente.

Beto
Okay. Así que comienza diminuta.

Alicia
Sí. Y luego usamos la salida de la red profesor gigante para guiar el entrenamiento de esa pequeña red estudiante. No están compartiendo código físico. Están compartiendo experiencia.

Beto
Aquí es donde se pone realmente interesante porque, si el estudiante solo está imitando al profesor, ¿qué está imitando exactamente?

Alicia
Esa es la pregunta de millón de dólares.

Beto
Correcto. Porque si solo memorizo una lista de respuestas finales para un examen de biología, no he aprendido biología. No puedo resolver un problema nuevo. Solo he memorizado una lista estática.

Alicia
Y los investigadores en el artículo destacan ese obstáculo exacto. Si solo le das al estudiante la respuesta difícil final, por ejemplo, "esta imagen es un perro". El estudiante no aprende mucho sobre el matiz visual del mundo real.

Beto
Porque es solo un hecho binario.

Alicia
Correcto. En el entrenamiento de IA tradicional, un modelo se entrena con lo que llamamos "objetivos duros" ("hard targets"). Un objetivo duro es binario. Es 100% perro, 0% gato, 0% coche.

Beto
Correcto. Muy en blanco y negro.

Alicia
Pero el verdadero poder de la destilación de conocimiento "vainilla" se basa en lo que Hinton denominó famosamente "conocimiento basado en respuesta" ("response-based knowledge").

Beto
Okay. Conocimiento basado en respuesta. Desglosa eso. ¿Cómo realmente parece dentro de la máquina?

Alicia
Así que para entenderlo, necesitamos mirar lo que sucede justo antes de que una IA te dé su respuesta final.

Beto
Okay.

Alicia
Antes de que una red arroje una probabilidad limpia, genera estas puntuaciones matemáticas crudas y no normalizadas llamadas "logits".

Beto
Logits, entendido.

Alicia
Digamos que un modelo mira una imagen. Podría emitir una puntuación de logit de 50 para perro, 10 para gato y no sé, -5 para coche.

Beto
Así que no está tratando con porcentajes todavía. Simplemente está asignando puntos crudos arbitrarios basados en las características que detecta.

Alicia
Esa es una forma muy buena de visualizarlo. Sí.

En el entrenamiento estándar, esos "logits" crudos se introducen en una función matemática llamada "softmax".

Beto
Softmax.

Alicia
Y softmax los normaliza en probabilidades que suman un 100%. Pero como el logit para perro era mucho más alto, como 50 frente a 10, la función softmax estándar arrojará algo como un 99.9% perro.

Beto
Lo que empuja todo lo demás a casi cero.

Alicia
Exacto. Crea una predicción muy nítida y confiada, pero la destilación de conocimiento altera este proceso introduciendo un factor de temperatura en la ecuación de softmax.

Beto
Un factor de temperatura. Espera, ¿cómo cambia la adición de temperatura la matemática?

Alicia
Matemáticamente, divides esas puntuaciones de logit crudas por el valor de la temperatura antes de convertirlas en probabilidades.

Beto
Ok, te sigo.

Alicia
Así que si la temperatura se establece en uno, la matemática opera normalmente, resultando en esa predicción nítida del 99.9%. Pero a medida que aumentas la temperatura, digamos hasta cinco o diez, la división reduce la brecha matemática entre esas puntuaciones crudas.

Beto
Oh, ya veo.

Alicia
Sí. Así que cuando las pasas por la función ahora, la distribución de probabilidad se aplana. Se suaviza.

Beto
Ah. Okay. Así que en lugar de un 99.9% perro, una temperatura alta podría producir algo como, no sé, un 85% perro, 14% gato y 1% coche.

Alicia
Exacto. Y esa distribución suave resultante es lo que llamamos un "objetivo suave" ("soft target"). Y es increíblemente valioso porque revela las relaciones estructurales ocultas entre las clases.

Beto
Porque ya no es solo un sí o un no.

Alicia
Correcto. El modelo profesor masivo después de analizar millones de imágenes ha aprendido que "perros" y "gatos" comparten geometría visual, sabes, "pelo", "hocicos", mientras que los coches no.

Beto
Así que esa similitud del 14% con un "gato" contiene inmensas cantidades de información sobre el mundo visual.

Alicia
Toneladas de información que aludían a esta información estructural oculta como "conocimiento oscuro" ("dark knowledge").

Beto
"Conocimiento oscuro". Suena un poco ominoso, pero es realmente solo la lógica interna de la IA.

Alicia
Muy cierto. Sí.

Beto
Piensa en cómo aprendemos mejor como humanos. Si estás luchando con un problema de cálculo complejo, no solo quieres que el profesor escriba 42 en la pizarra.

Alicia
Correcto. Eso no te ayuda en absoluto en el examen.

Beto
Exacto. Quieres ver el desarrollo. Quieres saber cómo llegaron a la respuesta, la lógica que usan, las rutas alternativas que consideraron descartar antes de aterrizar en 42.

Alicia
Esa es una analogía perfecta.

Beto
Así que estos objetivos suaves, su conocimiento oscuro, actúan como esa fase crucial de desarrollo para la IA.

Alicia
Y el artículo muestra que forzar al modelo pequeño estudiante a igualar esas probabilidades suaves exactas, en lugar de solo los objetivos duros binarios, le permite absorber las capacidades de generalización del modelo masivo.

Beto
Eso es aprender la geometría de los datos.

Alicia
Sí, lo que permite a una pequeña red neuronal alcanzar niveles de precisión, que literalmente nunca podría haber logrado si solo fuera entrenada con el conjunto de datos crudo por sí misma.

Beto
Ok. Así que tenemos este conocimiento oscuro actuando como un currículo bellamente matizado.

Alicia
Correcto.

Beto
Pero si solo tomo ese currículo y se lo doy a un chip diminuto, ¿simplemente lo absorbe instantáneamente? ¿O es el proceso de transferencia real, la dinámica del aula, por así decirlo, un cuello de botella?

Alicia
Oh, la dinámica del aula es absolutamente un cuello de botella. Y el artículo clasifica cómo los investigadores lo manejan.

Beto
¿Cómo es eso?

Alicia
Bueno, durante mucho tiempo, el enfoque estándar era lo que llamamos "destilación offline". Este es un método sencillo de dos fases.

Beto
Fase uno siendo ...

Alicia
En la fase uno, pasas tus semanas y millones de dólares entrenando tu modelo "profesor" masivo de miles de millones de parámetros en una supercomputadora.

Una vez que está completamente horneado, congelas sus pesos.

Y luego en la fase dos, usas ese "profesor" congelado para extraer los objetivos suaves y enseñar al pequeño modelo "estudiante".

Beto
Verás, eso se siente como la forma más intuitiva de hacerlo. Construyes al "experto" primero, luego el "experto" enseña al "novato". ¿Dónde se rompe esto?

Alicia
Se rompe cuando la brecha entre los dos modelos se vuelve demasiado amplia. Los investigadores como Mosada y sus colegas identificaron esto como la "brecha de capacidad" ("capacity gap").

Beto
¿La brecha de capacidad?

Alicia
Sí. Los resultados empíricos mostraron un fenómeno muy contraintuitivo. A veces, hacer que el modelo "profesor" sea más grande, más inteligente y más preciso, en realidad hacía que el "estudiante" tuviera un peor rendimiento.

Beto
Espera, ¿realmente? ¿Un "profesor" más inteligente resultando en un "estudiante" peor? ¿Cómo funciona eso?

Alicia
Porque el "profesor" masivo está aprendiendo características altamente complejas y abstractas profundamente en un espacio multidimensional masivo. El pequeño "estudiante" simplemente no tiene la capacidad matemática, el recuento de parámetros físicos para mapear esas representaciones altamente abstractas. El "estudiante" simplemente se siente abrumado por la complejidad del conocimiento oscuro.

Beto
Oh, hombre. Así que la destilación offline básicamente puede convertirse en tener a Albert Einstein tratando de enseñar matemáticas de kínder.

Alicia
Eso es exactamente lo que es.

Beto
Los conceptos en la cabeza de Einstein son tan avanzados y la brecha de capacidad es tan amplia que los niños simplemente terminan completamente confundidos. Como Einstein podría dar objetivos suaves que involucren cálculo avanzado cuando el estudiante solo necesita saber cómo contar manzanas.

Alicia
Sí. Las arquitecturas matemáticas son tan diferentes que la transferencia falla.

Para resolver esta brecha de capacidad, los investigadores comenzaron a explorar la destilación en línea ("online distillation").

Beto
Destilación en línea. Okay. ¿Qué es eso?

Alicia
En esta configuración, descartas por completo la idea de preentrenar a un profesor genio masivo. En cambio, el profesor y el estudiante se actualizan simultáneamente en un marco entrenable de extremo a extremo ("end-to-end").

Beto
Oh, espera. Así que están aprendiendo el material al mismo tiempo exacto.

Alicia
Sí. Un marco destacado para esto se llama "aprendizaje mutuo profundo" ("deep mutual learning"). En lugar de un gran "profesor" y un pequeño "estudiante", inicializas un grupo de redes ligeras que aprenden juntas de manera colaborativa. Durante el proceso de entrenamiento, cualquier red actúa como estudiante y las otras actúan colectivamente como profesor. En cada paso del entrenamiento, comparten sus "logits" crudos entre sí, calculan la pérdida y actualizan sus pesos de manera colaborativa.

Beto
Vaya. Así que la destilación en línea es menos como una lección de Einstein y mucho más como un grupo de estudio de estudiantes universitarios.

Alicia
Exacto.

Beto
Todos están estudiando la materia cruda juntos, aprendiendo mutuamente, rebotando sus ideas probabilísticas entre sí y corrigiéndose entre sí en tiempo real.

Alicia
Y ese entorno de aprendizaje colectivo crea realmente un efecto de regularización, que evita que cualquier modelo individual se sobreajuste a los datos.

Beto
Eso es brillante.

Alicia
Y lo que hace que esto sea tan poderoso para la industria es que la destilación en línea colaborativa evita por completo la necesidad de entrenar un modelo profesor masivo en primer lugar.

Beto
Oh, cierto. Porque no hay profesor gigante.

Alicia
Exacto. Ahorra cantidades increíbles de tiempo y potencia de supercomputación mientras sigue resultando en modelos ligeros y desplegables y altamente precisos.

Beto
Okay. Así que hemos trazado la teoría aquí. Hemos hablado de extraer conocimiento oscuro a través de ajustes de temperatura, navegar las brechas de capacidad y organizar grupos de estudio de IA. Pero, ¿dónde estás tú y yo interactuando realmente con estas redes neuronales destiladas en la naturaleza? Porque toda la premisa de este artículo de encuesta es descubrir cómo llevar la IA a nuestros bolsillos.

Alicia
Honestamente, probablemente interactúes con ellas docenas de veces al día.

Beto
¿De verdad? ¿Como dónde?

Alicia
Veamos el procesamiento del lenguaje natural ("Natural Language Processing", "NLP"). Modelos como BERT son increíbles para comprender el contexto y el lenguaje humano. Pero desplegar una BERT estándar en un dispositivo móvil es simplemente imposible debido a las restricciones de memoria.

Beto
Correcto. Es demasiado grande.

Alicia
Así que a través de la destilación de conocimiento, los investigadores crearon modelos como TinyBERT. Ellos toman el modelo masivo y destilan tanto el conocimiento del lenguaje del dominio general, gramática y sintaxis básica, y el conocimiento específico de la tarea, como cómo resumir un correo electrónico.

Beto
Okay.

Alicia
Esto permite que tu teléfono procese mensajes de texto o consultas de búsqueda localmente e instantáneamente.

Beto
Lo cual es enorme para la experiencia del usuario. Quiero decir, si mi teléfono tuviera que enviar todo lo que escribo a un servidor en la nube para que sea analizado por una BERT de tamaño completo, no solo habría un gran retraso de latencia mientras espera una respuesta ...

Alicia
Sí, tardaría una eternidad.

Beto
... pero las implicaciones de privacidad de enviar cada pulsación de tecla fuera del dispositivo sería una pesadilla.

Alicia
Ah, una pesadilla de privacidad. La privacidad y la latencia son los dos impulsores principales para la computación en el borde ("edge computing").

Beto
Tiene sentido.

Alicia
La encuesta también describe cómo la destilación de conocimiento a nivel de secuencia está revolucionando el reconocimiento de voz.

Beto
Oh, ¿el reconocimiento de voz también?

Alicia
Sí. Históricamente, el procesamiento de voz en tiempo real requería redes neuronales recurrentes, o RNNs, complejas. La destilación permite reducir esas arquitecturas para que quepan en plataformas integradas como dispositivos de hogar inteligente, o el silicio de tu teléfono.

Beto
¿Sucede eso directamente en el chip?

Alicia
Exacto. Esto resuelve la necesidad de una respuesta rápida para la identificación del lenguaje hablado sin necesidad de una conexión constante a Wi-Fi.

Beto
Significa que cuando estoy viajando en el extranjero, ¿cierto? Y estoy en modo avión sin servicio de celular. Y uso una aplicación de traducción para hablar con un taxista. Es un modelo estudiante destilado haciendo todo el trabajo pesado completamente en el chip local.

Alicia
Sí. No se requiere conexión a la nube y cero latencia. Y las aplicaciones se extienden más allá del texto y el habla, llegan a la visión por computadora.

Beto
Okay. ¿Qué tipo de cosas de visión?

Alicia
El artículo destaca una aplicación increíblemente ingeniosa llamada "reconocimiento facial de resolución cruzada" ("cross-resolution face recognition").

Beto
Resolución cruzada.

Alicia
Sí. Imagina una cámara de seguridad estándar o incluso la cámara frontal de tu teléfono en iluminación terrible. La calidad de la imagen resultante es baja, borrosa y pixelada.

Beto
Correcto. Todos hemos visto esos videos de seguridad granulados.

Alicia
Así que los investigadores entrenan un modelo "profesor" de alta resolución con imágenes de calidad de estudio cristalina. Luego destilan su conocimiento de características faciales en un modelo "estudiante" de baja resolución.

Beto
Espera. Así que el modelo estudiante aprende a reconocer caras con precisión incluso cuando la imagen está borrosa. Porque el profesor le enseñó la geometría subyacente de lo que realmente representan esos píxeles borrosos.

Alicia
Lo entendiste muy bien. El estudiante infiere los detalles visuales faltantes basándose en el conocimiento estructural oscuro que recibió durante el entrenamiento. Básicamente, aprende a reconocer patrones en el ruido que un modelo independiente simplemente ignoraría.

Beto
Entonces, ¿qué significa todo esto?

Cuando miramos todas estas aplicaciones del mundo real: guardar nuestros datos en el dispositivo, reconocimiento de voz offline, mantenernos conectados sin servicio de celular, reconocimiento facial borroso, mantener el sistema seguro ...

Alicia
La destilación de conocimiento sirve como el puente invisible entre la investigación de laboratorio de vanguardia y la tecnología de consumo que confiamos.

Beto
El puente invisible. Me gusta.

Alicia
Sí, constantemente vemos titulares sobre nuevos modelos de IA con un billón de parámetros, pero físicamente no puedes meter un billón de parámetros en un reloj inteligente.

Beto
No, definitivamente no.

Alicia
KD es la capa de traducción. Es lo que evita que la batería de tu teléfono se agote en cinco minutos cuando le haces una pregunta a un asistente virtual. Es verdaderamente el héroe algorítmico no reconocido de la revolución de la IA móvil.

Beto
Me encanta esa interpretación. Pero la tecnología nunca deja de moverse, ¿cierto? Y los conjuntos de datos están creciendo exponencialmente. Hemos resuelto el problema móvil para los modelos de hoy. Pero, ¿cómo están los investigadores construyendo los modelos estudiante del mañana para mantenerse al día con esta afluencia de datos?

Alicia
Bueno, eso nos lleva a la verdadera frontera de la investigación de KD. Uno de los mayores desafíos emergentes destacados en la encuesta es el diseño de la arquitectura del estudiante.

Beto
Ok, ¿qué significa exactamente?

Alicia
Actualmente el estándar de la industria es simplemente hacer que la red estudiante sea una versión truncada y simplificada de la red profesor. Simplemente reducimos el plano existente.

Beto
Correcto.

Alicia
Pero los investigadores están empezando a preguntar si un plano reducido es realmente la forma óptima para que un cerebro estudiante reciba el conocimiento específico.

Beto
Ah, cierto. Porque solo porque una red masiva requiera una topología específica para aprender de los datos crudos, no significa que una red diminuta deba ser solo una versión en miniatura de ella para aprender de objetivos suaves.

Alicia
Exacto.

Beto
Podría necesitar una estructura física totalmente diferente para contener ese conocimiento oscuro de manera eficiente.

Alicia
Y encontrar esa estructura perfecta manualmente es casi imposible porque el espacio de búsqueda es demasiado vasto. Así que el gran avance destacado en el artículo es combinar el conocimiento, la destilación con NAS.

Beto
Sí, ¿NAS?

Alicia
"Búsqueda de arquitectura neuronal" ("Neural Architecture Search").

Beto
Búsqueda de arquitectura neuronal. Espera, así que el sistema está escribiendo sus propios planos.

Alicia
Ese es el objetivo. En lugar de que un ingeniero humano adivine cuántas capas necesita el modelo estudiante o dónde debe ir la conexión de salto ("skip connection"), integras NAS directamente con KD.

Beto
Oh, wow.

Alicia
El sistema busca dinámicamente y automáticamente la estructura estudiantil perfecta absoluta, basada en el conocimiento específico que el profesor está tratando de transferir.

Beto
¿Así que está probando diferentes formas?

Alicia
Sí. El algoritmo prueba miles de topologías de redes diferentes en segundo plano, evaluando su rendimiento, guiado por el profesor hasta que encuentra el recipiente óptimo para ese currículo específico.

Beto
Eso realmente cambia todo el paradigma de desarrollo.

El profesor está esencialmente construyendo, a medida, las vías neuronales del estudiante, para recibir perfectamente su propio conocimiento.

Alicia
Automatiza la parte más tediosa de la ingeniería de aprendizaje automático.

Y la investigación se vuelve aún más fascinante cuando miras otra frontera mencionada en el artículo, la "destilación modal cruzada" ("cross modal distillation").

Beto
"Modal cruzada", significando transferir conocimiento a través de modos de entrada sensorial completamente diferentes.

Alicia
Sí. Enseñar un modelo a través de diferentes sentidos. Por ejemplo, considera los coches autónomos. Se basan en LiDAR, sabes, sensores voluminosos y caros que rebotan láseres para crear nubes de puntos 3D altamente precisas. Un modelo profesor entrenado en datos de LiDAR entiende totalmente la profundidad y la geometría del espacio 3D.

Beto
Correcto. Porque tiene todos esos ricos datos 3D.

Alicia
Los investigadores están usando la destilación modal cruzada para tomar ese profesor entrenado con LiDAR y usarlo para enseñar a un modelo estudiante a comprender la profundidad usando solo imágenes RGB planas estándar de una cámara básica y barata.

Beto
Déjame asegurarme de que lo estoy captando completamente. Estamos enseñando a una IA a ver profundidad física sin un sensor de profundidad real. Solo porque un sensor más antiguo entrenado en IA rica le enseñó a interpretar una imagen plana.

Alicia
Exacto. El modelo profesor analiza la imagen plana junto con sus datos LiDAR, accediendo a su comprensión profunda de la profundidad. Luego proporciona objetivos suaves al estudiante, que solo tiene acceso a la imagen plana.

Beto
Oh, eso es salvaje.

Alicia
A través del proceso de destilación, el estudiante aprende a inferir profundidad a partir de sombras sutiles, ángulos y relaciones de píxeles y una imagen 2D plana simplemente imitando las salidas del profesor.

Beto
Las implicaciones para el hardware de consumo son asombrosas. Quiero decir, un sistema LiDAR cuesta miles de dólares, pero una lente de cámara digital estándar cuesta como 50 centavos.

Alicia
Exacto.

Beto
Podrías poner conciencia espacial increíblemente sofisticada en aspiradoras robot o drones básicos o gafas de realidad aumentada. Les faltan los sensores de hardware caros, pero operan como si los tuvieran porque poseen el conocimiento destilado de una máquina que sí lo hizo.

Alicia
Esto democratiza completamente las capacidades del hardware a través del entrenamiento de software. Estás tomando la información espacial privilegiada de modalidades ricas y destilándola hasta dispositivos de borde ubicuos y accesibles.

Beto
Qué viaje increíble a través de este artículo. Tomemos un respiro y recapitulémos lo lejos que hemos llegado hoy.

Comenzamos mirando las limitaciones físicas de los dispositivos de borde en comparación con aquellos modelos de IA masivos y engorrosos que tardan semanas en entrenarse en clústeres de supercomputación.

Alicia
Luego exploramos cómo tender ese abismo extrayendo conocimiento oscuro. Ajustando el factor de temperatura en la función softmax, aplanamos los valores "logit" para crear objetivos suaves sofisticados.

Beto
Correcto. Objetivos que revelan las relaciones geométricas ocultas entre los puntos de datos, la fase de desarrollo del problema.

A partir de ahí, miramos a la dinámica del aula. Cómo la destilación offline a veces choca contra un muro debido a la brecha de capacidad, todo ese Einstein tratando de enseñar matemáticas de kínder.

Alicia
Y cómo el aprendizaje mutuo en línea resuelve esto al hacer que los modelos ligeros estudien de manera colaborativa actualizando sus pesos al mismo tiempo.

Beto
Y finalmente, vimos cómo esta matemática teórica resulta en las redes neuronales altamente eficientes que impulsan el reconocimiento de voz offline, el procesamiento del lenguaje natural y la visión por computadora en los dispositivos que usamos todos los días.

Alicia
Abriendo el camino para un futuro donde la IA utiliza la búsqueda de arquitectura neuronal para construir a medida sus propios estudiantes óptimos.

Beto
Es realmente una clase magistral en eficiencia.

Pero antes de que cerremos, quiero dejarles a los oyentes con un concepto final no abordado.

Alicia
Oh, okay. Escuchémoslo.

Beto
Vimos todo este análisis profundo hablando sobre la transferencia de conocimiento entre máquinas, la extracción de inteligencia de una gran granja de servidores y la compresión en un pequeño chip de silicio. Pero piensen en las implicaciones de la búsqueda de arquitectura neuronal.

Alicia
Correcto. Construir el recipiente perfecto.

Beto
Si un algoritmo puede diseñar perfectamente la arquitectura de una máquina estudiante para recibir eficientemente el conocimiento complejo de la máquina profesor, ¿podría este mismo proceso algorítmico aplicarse eventualmente a las interfaces hombre-computadora?

Alicia
Vaya. Aplicar la destilación personalizada a la pedagogía humana.

Beto
Exacto. Imagina un futuro donde una IA educativa no solo destile su conocimiento en otra IA. Imagina un sistema que destile y formatee perfectamente su vasto conocimiento de física o historia o medicina para que coincida con tu estilo de aprendizaje biológico exacto.

Alicia
Eso cambiaría todo.

Beto
Una IA que monitorea continuamente tu comprensión, ajustando sus objetivos suaves y analogías para mapearse perfectamente a la capacidad y forma exactas de tu mente.

¿Qué sucede cuando el modelo estudiante ligero perfecto es tu mente?

La próxima vez que mires ese teléfono inteligente en tu bolsillo, solo recuerda que la parte más difícil de la revolución de la IA no fue construir el cerebro gigante. La parte más difícil fue descubrir cómo reducirlo para que pudiera encajar perfectamente en tu vida.

Hasta la próxima.