Mostrando entradas con la etiqueta Robótica. Mostrar todas las entradas

lunes, 13 de abril de 2026

Informe Stanford 2026: Rendimiento Técnico


Este informe técnico describe la rápida aceleración de las capacidades de la IA a lo largo de 2025, destacando que los modelos de vanguardia superan con frecuencia el rendimiento humano. Si bien los indicadores técnicos muestran una reducción de la brecha entre los principales competidores globales y una convergencia del rendimiento entre los proveedores más importantes, los investigadores advierten que estas pruebas se están saturando o volviendo poco fiables. El informe documenta avances significativos en tareas lingüísticas especializadas, comprensión de vídeo y agentes autónomos, aunque señala que estos sistemas aún enfrentan desafíos en cuanto a la fiabilidad en el mundo físico y el razonamiento complejo. Los modelos están evolucionando desde simples generadores de texto hasta agentes capaces y sistemas multimodales que comienzan a simular leyes físicas. A pesar de estos avances, la "inteligencia irregular" sigue siendo un obstáculo, ya que los modelos pueden sobresalir en matemáticas avanzadas, pero fallar en tareas sencillas y de sentido común, como leer la hora. En definitiva, el ritmo de la innovación en IA está superando actualmente los marcos utilizados para evaluar y gestionar estas potentes tecnologías.

Enlace al reporte científico, para aquellos interesados en profundizar sobre el tema: "AI Index Report 2026 - Chapter 2 - Technical Performance". Publicado el 13 de Abril de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Ahora mismo existe una IA que puede ganar una medalla de oro en la Olimpiada Internacional de Matemáticas.

Alicia
Lo cual es una locura pensarlo.

Beto
Lo es. Quiero decir, literalmente podría resolver física a nivel de posgrado.

Alicia
Sí.

Beto
Pero si le pides a esa misma supercomputadora que, ya sabes, mire una foto de un reloj de pared estándar.

Alicia
Correcto. Un reloj analógico.

Beto
Sí. Y que te diga la hora, falla el 50 % de las veces. Es como lanzar una moneda.

Alicia
Literalmente una tirada de moneda.

Beto
Bien. Bienvenidos a nuestro análisis profundo del material fuente.

Alicia
Ajá.

Beto
Hoy vamos a diseccionar el informe recién publicado del Stanford AI Index para 2026 para entender realmente esta extraña realidad contradictoria de lo que la IA puede hacer ahora mismo.

Alicia
Sí. Porque es abril de 2026. Y vivimos firmemente en esta era de lo que el informe llama "inteligencia irregular".

Beto
Sí, me gusta esa frase.

Alicia
Es muy acertada. Estamos viendo a estos modelos de frontera realizar hazañas de razonamiento aparentemente imposibles, casi divinas. Pero al mismo tiempo se colapsan en tareas espaciales y lógicas que un niño humano haría sin pensarlo dos veces.

Así que nuestra misión hoy es cortar todo el ruido y el bombo incesante de la industria. Queremos trazar la verdadera frontera de capacidad para ustedes, enfocándonos específicamente en los datos del capítulo dos.

Beto
Que es la sección sobre desempeño técnico.

Alicia
Exacto.
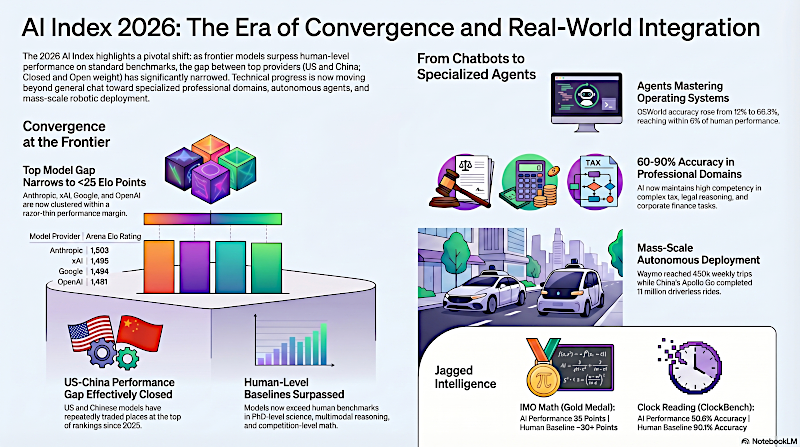

Indice IA 2026: La Era de la Convergencia e Integración con el Mundo Real

Beto
Vale. Desgranémoslo porque, ya sabes, si sigues este espacio al menos un poco, la velocidad es abrumadora. Parece imposible mantenerse al día.

Alicia
Oh, totalmente.

Beto
Hablamos de algoritmos invisibles que por la mañana pueden mover mercados de billones de dólares, y por la tarde están manejando robots humanoides en fábricas automotrices físicas.

Alicia
Sí, el alcance es masivo.

Beto
Es como intentar medir la velocidad de un cohete con un radar de mano. Las herramientas que tenemos se están rompiendo ante la rapidez del avance.

Alicia
Sí.

Beto
Pero para entender lo que estos sistemas son genuinamente capaces de hacer, primero tenemos que mirar la imagen macro.

Alicia
Bien, hay que mirar la propia carrera.

Beto
Exacto.

Alicia
Sí.

Beto
El panorama competitivo, que se ha reconfigurado por completo en los últimos 12 meses.

Alicia
De verdad que sí. La brecha competitiva entre los actores principales no solo se ha estrechado. Prácticamente ha desaparecido.

Beto
Desaparecido. Como totalmente.

Alicia
Prácticamente. Quiero decir, si miras la tabla de clasificación de Arena, que, para quien no lo sepa, clasifica modelos según preferencia humana usando un sistema de puntuación ELO estilo ajedrez emparejado, los cuatro principales están actualmente agrupados dentro de apenas 25 puntos entre sí.

Beto
25 puntos.

Alicia
Sí. A marzo de 2026, Anthropic está en 1.503 puntos.

Beto
OK.

Alicia
Y siguiéndole por fracciones literales tienes a XAI en 1.495.

Beto
Así que una diferencia de ocho puntos.

Alicia
Correcto. Google está en 1.494.

Beto
Wow.

Alicia
Y OpenAI está en 1.481.

Beto
Esas márgenes son prácticamente inexistentes. Es una llegada muy ajustada.

Alicia
Sí, ya no hay un vencedor claramente despegado.

Beto
Y no son solo los grandes gigantes tecnológicos estadounidenses agrupados en la cima. La división geográfica en la que antes nos centrábamos tanto, eso esencialmente se ha cerrado.

Alicia
Se ha evaporado por completo. A lo largo de principios de 2025, los mejores modelos de EE. UU. y de China intercambiaban rutinariamente la primera posición.

Beto
Correcto.

Alicia
Actualmente, el mejor modelo estadounidense, que es Claude Opus 4.6, lidera al mejor modelo chino, Dola-Seed-2.0 Preview, por apenas un margen del 2,7 %.

Beto
2,7 %. Eso no es nada. Y tenemos que hablar del catalizador de ese cierre de brecha.

Alicia
Oh, absolutamente. El momento de febrero de 2025.

Beto
Sí, en febrero de 2025, cuando el Deepseek R1 de China temporalmente igualó al mejor modelo estadounidense. Pero la onda expansiva no fue solo que alcanzaran la cima, ¿verdad? El pánico en la industria vino del mecanismo subyacente de cómo entrenaron su capacidad de razonamiento.

Alicia
Exacto. Utilizaron un enfoque de aprendizaje por refuerzo llamado GRPO.

Beto
OK, explícanos eso. ¿Por qué GRPO cambió todo el panorama?

Alicia
Bueno, tienes que ver cómo se entrenaba el razonamiento antes. Históricamente, requería enormes cantidades de datos etiquetados por humanos, extremadamente caros.

Beto
Como pagar a doctorados para que escribieran soluciones de matemáticas paso a paso.

Alicia
Sí. O necesitabas un modelo crítico separado, muy complejo, para evaluar constantemente la salida de la IA durante el entrenamiento. Ambos enfoques consumen muchísimos recursos.

Beto
Correcto.

Alicia
GRPO evitó todo eso. Entrenó la habilidad de razonamiento generando grupos de salidas y comparándolos contra reglas objetivas predefinidas. Eliminaron por completo los cuellos de botella humanos más costosos en la cadena de entrenamiento.

Beto
OK, para usar una analogía, es básicamente como en vez de contratar a un tutor privado caro, para que esté encima de un estudiante corrigiendo cada línea de su tarea de matemáticas, simplemente le das al estudiante una rúbrica. Le dices, oye, intenta estas 10 maneras diferentes de resolver el problema. El camino que te dé la respuesta matemáticamente correcta al final, recuerda esos pasos.

Alicia
Esa es una forma perfecta de visualizarlo. Para eliminar la necesidad del tutor humano por completo.

Beto
Wow.

Alicia
Y cuando el mercado en general se dio cuenta de que el estado del arte en razonamiento podía alcanzarse sin gastar miles de millones en esos pipelines de datos etiquetados por humanos, la reacción fue violenta.

Beto
Oh, provocó una caída temporal de 1 billón de dólares en el valor del mercado bursátil tecnológico de EE. UU.

Alicia
Un billón de dólares. Simplemente borrado.

Beto
Porque los inversores, de repente, entendieron que los modelos de negocio masivamente intensivos en capital, de estos grandes, podían verse severamente socavados por esta nueva eficiencia.

Alicia
Exacto. El voto se fue.

Beto
Pero bien, aquí es donde se pone realmente interesante. Voy a cuestionar esto un poco. Si los modelos COP4 están separados por menos de 30 puntos y los modelos de peso abierto, donde la arquitectura subyacente está disponible libremente para desarrolladores, solo están a un 3,3 % por detrás de los modelos propietarios de peso cerrado ...

Alicia
Sí.

Beto
¿Qué están vendiendo realmente estas compañías?

Alicia
Esa es la pregunta de un millón de dólares.

Beto
¿Cómo compites cuando todo el mundo básicamente tiene una A+ en razonamiento?

Alicia
Sí.

Beto
¿No significa eso que la parte de inteligencia se está convirtiendo en una commoditiy? ¿Ahora competimos solo en quién lo hace más barato?

Alicia
Honestamente, sí. Estamos viendo un giro fundamental alejándose de la capacidad bruta como diferenciador principal.

Porque los modelos están funcionalmente empatados en inteligencia pura, la carrera se ha desplazado hacia la eficiencia operativa.

Beto
Eficiencia.

Alicia
Los proveedores ahora compiten en costo, latencia, confiabilidad y utilidad específica por dominio.

Beto
Así que ya no se trata de ser el más inteligente.

Alicia
No. La pregunta definitiva para un negocio, no es quién tiene el modelo más inteligente. Es quién puede ejecutar este pipeline específico más barato, más rápido y con menos alucinaciones.

Beto
Pero si todos están tan juntos en la cima de la curva de capacidad, ¿cómo medimos su inteligencia con precisión? Quiero decir, si las diferencias son fraccionales, parece que los benchmarks tradicionales que usamos para probarlos simplemente se están rompiendo.

Alicia
Se están rompiendo por completo. Los marcos de evaluación se están saturando mucho más rápido de lo que los investigadores pueden inventarlos.

Beto
Dame un ejemplo.

Alicia
OK. Considera un benchmark que literalmente se llama "Humanities Last Exam".

Beto
Humanities Last Exam, suena ominoso.

Alicia
Correcto. Fue deliberadamente diseñado para ser increíblemente difícil para la IA, apoyándose en profundo conocimiento humano y casos límite extraños.

Beto
Bien.

Alicia
Aún así, en un solo año, los modelos de frontera subieron 30 puntos porcentuales en esta prueba.

Beto
30 puntos en un año.

Alicia
Sí, ahora están en 38,3 %. Y además, estamos descubriendo que las pruebas en sí a menudo están estructuralmente defectuosas.

Beto
¿Qué quieres decir con defectuosas? ¿Que las preguntas están mal?

Alicia
A veces, sí. Una revisión muy profunda reciente reveló que hasta el 42 % de las preguntas en un benchmark ampliamente usado para matemáticas, llamado GSM 8K, eran en realidad inválidas. O bien, por mala redacción, o simplemente por indicios de respuesta incorrectos.

Beto
Espera, casi la mitad del test está roto.

Alicia
Exacto.

Beto
Los investigadores están esencialmente intentando medir un objetivo en movimiento con herramientas que literalmente se les están desmoronando en las manos.

Alicia
Es una crisis total de benchmarks.

Beto
Pero incluso con benchmarks defectuosos, la escala de la capacidad es innegable. Quiero decir, mira los resultados en la Olimpiada de Matemáticas.

Alicia
Ah, la ejecución de Gemini DeepThink.

Beto
Sí. En 2025, Gemini DeepThink de Google sacó 35 puntos para ganar la medalla de oro en la Olimpiada Internacional de Matemáticas. Eso viene de una plata el año anterior, ¿no?

Alicia
Síp. Salto masivo.

Beto
No se limitó a hacer pattern matching de soluciones existentes. Funcionó de extremo a extremo en lenguaje natural. Produjo pruebas matemáticas rigurosas paso a paso dentro de un límite de tiempo estricto.

Alicia
Es brillante en eso. Pero, y este es el gran pero, volvemos a la paradoja de la inteligencia irregular.

Beto
La curva de capacidad dentada.

Alicia
Correcto. Sí. Porque ese mismo sistema que puede sintetizar una prueba matemática a nivel de olimpiada, se desmorona por completo en un benchmark llamado "Clock Bench".

Beto
Clock Bench. Que es solo leer un reloj.

Alicia
Simplemente leer un reloj. Cuando a humanos se les pide leer un reloj analógico correctamente formateado en este benchmark, alcanzan un 90,1 % de precisión.

Beto
Bien. Tiene sentido.

Alicia
El mejor modelo de IA actualmente solo alcanza un 50,1 %.

Beto
Básicamente una tirada de moneda.

Alicia
Exacto.

Beto
Y al observar los datos en el informe, la naturaleza del fallo es lo que me parece tan extraño. Cuando un humano lee mal un reloj, puede estar equivocado por, ¿dos o tres minutos? Porque juzgamos mal las pequeñas marcas de los ticks.

Alicia
Sí. Un error visual menor.

Beto
Pero el informe muestra que el error mediano de la IA está entre una y tres horas.

Alicia
Las horas, sí.

Beto
¿Cómo un sistema con la potencia computacional para resolver física de posgrado comete un error fundamental tan gigantesco?

Alicia
Se reduce al mecanismo del fallo. Tienes que ver cómo los modelos multimodales procesan información visual y aritmética simultáneamente.

Beto
OK.

Alicia
Leer un reloj analógico requiere que el modelo identifique visualmente la manecilla de la hora y la de los minutos, calcule sus ángulos respectivos y luego traduzca esa geometría a un valor numérico de hora.

Beto
Correcto. Es combinar percepción y matemáticas.

Alicia
Exacto. Y si el modelo comete un pequeño error visual, por ejemplo, confunde la manecilla de la hora por la de los minutos debido a sutiles diferencias de píxeles, no solo falla en los minutos.

Beto
Su razonamiento espacial se derrumba.

Alicia
Falla en cascada completa. El error se propaga a través de todo el cálculo matemático, resultando en una discrepancia de varias horas; pierde por completo la lógica fundamental de la fase del reloj.

Beto
Así que es exactamente como tener un amigo que puede resolver complejas ecuaciones de física cuántica en su cabeza, pero luego pasa cinco minutos empujando una puerta con barra.

Alicia
Eso es exactamente a lo que se parece.

Beto
Realmente te obliga a cuestionar si puedes confiar en estos modelos para tareas básicas y cotidianas, incluso si tiene una medalla de oro en razonamiento.

Alicia
Tienes que ser cuidadoso.

Beto
Porque si se pierde completamente al leer la fase de un reloj porque la estructura visual lo enredó, ¿qué pasa cuando mira un desordenado documento fiscal corporativo de 200 páginas que no coincide perfectamente con sus datos de entrenamiento?

Alicia
Y esa es la advertencia crucial aquí. Esta irregularidad no es solo una falla curiosa con relojes. No puedes asumir que la competencia en un dominio altamente abstracto y complejo se transferirá de forma suave a la realidad estructurada y anclada. La inteligencia irregular significa que la curva de capacidad no es una pendiente predecible. Se caracteriza por acantilados abruptos. Y esos acantilados se convierten en pasivos enormes cuando pasas de benchmarks académicos al mundo profesional.

Beto
Bien, sigamos ese acantilado en el mundo profesional entonces. Porque todos queremos una IA que pueda ingerir documentos masivos y manejar trabajo de cuello blanco.

Alicia
Ese es el sueño.

Beto
Y estructuralmente tienen la capacidad. Hemos visto ventanas de contexto —que es la cantidad de texto que una IA puede mantener en su memoria activa— crecer 30 veces al año.

Alicia
Es enorme ahora.

Beto
Sí, tenemos modelos capaces de ingerir un millón de tokens, libros enteros, bases de código enteras.

Alicia
Pero la suposición en el sector empresarial siempre ha sido que memoria masiva equivale a comprensión profunda. Y el benchmark LongBench V2 expone la falla en esa suposición. Esta prueba evalúa la comprensión a nivel experto de documentos largos bajo un límite de tiempo.

Beto
OK, ¿cómo les va?

Alicia
Bueno, los expertos humanos obtuvieron 53,7 %. El mejor modelo de IA solo obtuvo 57,7 %.

Beto
Espera, ¿así que la IA apenas supera a los humanos?

Alicia
Apenas.

Beto
Lo que significa que tener una ventana de contexto de un millón de tokens no es como tener un súper cerebro analizando un libro. Es más como tener un millón de notas adhesivas esparcidas por un escritorio enorme.

Alicia
Esa es una gran forma de decirlo.

Beto
Encontrar una nota específica, como una aguja en un pajar, es increíblemente fácil para la IA. Pero si le pides a la IA que escriba un resumen coherente de cómo todas esas notas se relacionan lógicamente entre sí, se sobrecarga por completo.

Alicia
Exacto. Porque esa síntesis requiere aplicar lógica condicional compleja sobre enormes cantidades de texto simultáneamente.

Beto
Y no lo hacen bien.

Alicia
No, los modelos tienen grandes dificultades con este tipo de síntesis espacial y lógica a menos que los forces meticulosamente a procesar la información paso a paso.

Beto
Lo cual es lento.

Alicia
Hace que el proceso sea computacionalmente caro y muy lento.

Beto
Y los números duros en dominios profesionales de alto riesgo reflejan perfectamente esta lucha. Quiero decir, campos como impuestos, procesamiento hipotecario, finanzas corporativas, la IA está teniendo problemas para cruzar la línea de meta.

Alicia
Sí, las estadísticas son duras.

Beto
En el CorpFin Benchmark que analiza complejos acuerdos de crédito corporativo de 200 páginas, el mejor modelo, Kimi K 2.5, solo logró un 68,26 % de precisión.

Alicia
Lo cual no es bueno para finanzas.

Beto
No. Y en hipotecas y impuestos, donde se extrae información condicional específica de certificados fiscales complejos, Gemini 3.1 Pro Preview se queda en 64,49 %.

Alicia
Y oye, una tasa de precisión del 68 % en finanzas corporativas no es una solución. Es una responsabilidad grave. Para entender el mecanismo de por qué fallan en estas tareas, tenemos que mirar un benchmark llamado Plan Bench.

Beto
OK, ¿qué prueba Plan Bench?

Alicia
Evalúa la capacidad de la IA para secuenciar acciones para lograr un objetivo específico. Entendiendo condiciones altamente reconocibles, los modelos se desempeñan muy bien. Pero los investigadores hicieron algo interesante. Ofuscaron la prueba.

Beto
¿Qué significa eso? Ocultaron los datos.

Alicia
Tomaron el mismo problema lógico exacto, pero describieron la estructura de forma diferente. Reemplazaron términos familiares por palabras sin sentido.

Beto
Oh, interesante.

Alicia
Y los modelos se colapsaron. Deepseek R1 bajó de resolver 28 de 45 tareas en el dominio Blox World a solo tres de 45.

Beto
Espera, solo por cambiar el vocabulario del prompt.

Alicia
Sí, de 28 a tres.

Beto
Es una caída asombrosa. Me dice que si una IA tiene solo un 68 % de exactitud leyendo un documento hipotecario, ¿no está en realidad creando más trabajo para el humano que tiene que revisar meticulosamente cada línea?

Alicia
A menudo, sí.

Beto
¿No estamos confundiendo completamente una enorme capacidad de memoria con verdadera inteligencia generalizada?

Alicia
En muchas aplicaciones profesionales, sí, lo estamos haciendo. El fallo del Plan Bench prueba que los modelos de lenguaje no son planificadores clásicos.

Beto
OK, ¿qué es un planificador clásico?

Alicia
Un planificador clásico busca sistemáticamente una solución lógica paso a paso. Los modelos de lenguaje, sin embargo, generan planes basándose en patrones estadísticos aprendidos de sus datos de entrenamiento.

Beto
Oh, así que es solo reconocimiento de patrones.

Alicia
Sí, básicamente. Cuando disfrazas el problema o cuando el documento hipotecario se desvía ligeramente del formato estándar, ese reconocimiento de patrones se rompe.

Beto
La falta subyacente de razonamiento lógico generalizado queda completamente expuesta.

Alicia
Exacto. Y si la verificación humana toma más tiempo que la generación de la IA, la herramienta pierde su utilidad en la empresa.

Beto
Wow. Así que hemos establecido que la IA tiene problemas para navegar perfectamente el mundo digital profesional cuando el patrón estadístico se rompe. Llevémoslo aún más lejos.

Alicia
OK.

Beto
¿Qué pasa cuando la desatamos en el mundo físico, desordenado y completamente no mapeado en el que vivimos realmente? ¿Cuál es el estado real de agentes, autonomía y robots en 2026?

Alicia
Bien, empecemos con las buenas noticias. Si miramos entornos puramente de software, los agentes digitales están teniendo éxito a un ritmo impresionante.

Beto
En ordenadores.

Alicia
Correcto. En WebArena, que prueba navegación autónoma web, los agentes han alcanzado una tasa de éxito del 74,3 %.

Beto
Eso está bastante cerca de la línea base humana, ¿no?

Alicia
Muy cerca. La línea base humana es 78,2 %.

Y en OSWorld, que prueba la habilidad para navegar un sistema operativo de ordenador, Claude Sonnet 4.6 está alcanzando el 72,1 %.

Beto
Así que pueden navegar una hoja de cálculo, gestionar archivos o reservar un vuelo en línea relativamente bien.

Alicia
Sí, el reino digital se está solidificando.

Beto
Pero cuando miramos fuera del monitor del ordenador, los avances se vuelven salvajes. Hay una sección en este informe de Stanford sobre generación de vídeo que cambia fundamentalmente cómo pensamos sobre estos modelos.

Alicia
Los datos Veo 3.

Beto
Sí. Veo 3 de Google DeepMind. No estaba solo generando imágenes hiperrealistas ya. Cuando se testó en 18.000 vídeos, los investigadores encontraron que el modelo estaba aprendiendo física fundamental real.

Alicia
Y el punto crítico aquí es que fue zero-shot.

Beto
Es decir, no fue entrenado explícitamente en eso.

Alicia
Correcto. El modelo nunca fue entrenado explícitamente en ecuaciones de física o dinámica de cuerpos rígidos. Simplemente, procesando millones de horas de píxeles de vídeo, aprendió a simular flotabilidad, gravedad e incluso resolver laberintos visuales.

Beto
Solo por ver moverse los píxeles.

Alicia
Exacto. Basado en lo que los investigadores llaman "razonamiento en cadena de fotogramas", "chain-of-frames reasoning", predice cómo una escena física debe evolucionar lógicamente paso a paso en base a leyes físicas. El modelo está esencialmente construyendo un modelo interno del mundo, una comprensión fundacional de cómo funciona la física.

Beto
Eso es alucinante. Pero un modelo interno del mundo que existe en un enorme centro de datos es completamente distinto de una máquina de metal intentando operar físicamente en tu salón.

Alicia
Totalmente distinto.

Beto
El chequeo de la realidad robótica en este informe es genuinamente brutal.

Alicia
Lo es. Si miras el benchmark Behavior-1K, que prueba manipulación al alcance en ambientes domésticos realistas, los robots aún fallan el 88 % de las veces.

Beto
¿88 %?

Alicia
Sí. El mejor equipo solo logró una tasa de éxito completa del 12,4 % en tareas domésticas estándar.

Beto
¿Y la seguridad?

Alicia
Tampoco bien. En ResponsibleRobotBench, que evalúa la seguridad, incluso el mejor modelo absoluto, que es GPT-4o, opera de forma segura solo el 64 % del tiempo.

Beto
Realmente subraya una realidad marcada. El mundo físico es infinitamente más caótico, impredecible y despiadado que un entorno digital curado o un vídeo simulado.

Alicia
Definitivamente.

Beto
¿Qué significa todo esto para la línea de tiempo de la autonomía? Porque tenemos excepciones evidentes donde la autonomía física funciona a escala.

Alicia
Las tenemos. Coches y fábricas.

Beto
Waymo está registrando 450.000 viajes semanales sin conductor en ciudades de EE. UU. En China, Baidu Apollo Go alcanzó 11 millones de viajes totalmente sin conductor solo en 2025. Eso es un aumento del 175 %.

Alicia
Escala masiva.

Beto
Y en manufactura, el robot humanoide de Figure AI, el Figure O2, pasó 11 meses en la planta de BMW, cargando con éxito 90.000 piezas en vehículos.

Alicia
Sí.

Beto
Entonces mi pregunta es: ¿por qué una IA puede navegar perfectamente, por una calle caótica y lluviosa, en un coche sin conductor en San Francisco, pero no puede doblar mi ropa, sin una probabilidad del 88 % de fallar? ¿Cuál es el eslabón perdido aquí?

Alicia
El eslabón perdido es el cuello de botella de datos.

Beto
El cuello de botella de datos.

Alicia
Sí. Piénsalo. Los modelos de lenguaje escalaron exponencialmente porque pudimos alimentarlos con miles de millones de páginas de texto, scrapeadas de Internet.

Beto
Bien. Datos fáciles.

Alicia
Los modelos visión-lenguaje-acción, que son la arquitectura subyacente requerida para robots de propósito general, necesitan datos físicos espaciales.

Beto
Oh, ya veo.

Alicia
No puedes raspar de Internet la resistencia táctil de doblar una toalla o el par preciso necesario para abrir un frasco específico. Cada pieza de datos de entrenamiento requiere un robot físico realizando la tarea o una simulación de alta fidelidad y muy compleja.

Beto
Entonces, ¿por qué funcionan coches y fábricas?

Alicia
Porque los coches autónomos y los robots de fábrica operan en entornos mapeados y fuertemente restringidos donde las empresas han pasado una década recopilando datos espaciales altamente especializados; tu salón no está mapeado completamente. Es infinitamente variable. Le falta ese dato fundacional de entrenamiento.

Beto
Wow. Así que siempre vuelve a la irregularidad de la curva de capacidad.

Alicia
Así es.

Beto
Sinteticemos todo esto. El panorama de la IA en 2026 es una paradoja increíble.

Alicia
Realmente lo es.

Beto
Es más rápido, más barato y los modelos principales convergen en sus capacidades brutas. Vemos sistemas que pueden ganar una medalla de oro en una olimpiada de matemáticas, internalizar las leyes de la física solo viendo cómo se mueven los píxeles y conducirte de forma segura en un taxi aéreo autónomo.

Pero no puedes confiar ciegamente en que lea un reloj analógico. Cometerá errores lógicos críticos al analizar un documento hipotecario complejo.

Alicia
Sí.

Beto
Y ciertamente no puede ordenar tu cocina.

Alicia
Que es precisamente por lo que entender el mecanismo de la inteligencia irregular es tan crítico para ti ahora mismo. A medida que integras estas herramientas en tu vida diaria, o en tus flujos de trabajo profesionales, debes permanecer como supervisor humano.

Beto
No puedes simplemente programarlo y olvidarte.

Alicia
Exacto. Puedes aprovechar la IA para síntesis masiva, para lluvia de ideas rápida o para ayuda en programación, pero debes verificar de forma independiente la lógica fundamental. Tienes que anticipar esos acantilados repentinos donde el reconocimiento de patrones falla.

Beto
Porque puede resolver la parte matemática más compleja de tu trabajo perfectamente y luego fallar en un detalle espacial básico que un niño de cinco años detectaría instintivamente.

Alicia
Precisamente. Y quiero dejarte con un pensamiento final para que lo explores por tu cuenta.

Beto
OK. Vamos.

Alicia
Hablamos de cómo los modelos de generación de vídeo están construyendo modelos internos del mundo de la física solo procesando píxeles.

Beto
Correcto. El Veo 3.

Alicia
Sabes que la robótica general está actualmente constreñido por una severa falta de datos táctiles físicos.

Beto
El cuello de botella de datos.

Alicia
Correcto. Bueno, ¿qué pasa cuando los millones de nuevos robots humanoides que están entrando en fábricas comiencen a transmitir continuamente datos espaciales y táctiles del mundo real de vuelta a estos modelos fundacionales masivos?

Beto
Oh, wow.

Alicia
¿Estamos al borde de ver la inteligencia física anclada escalar con la misma trayectoria explosiva que los modelos de lenguaje experimentaron hace unos años?

Beto
Esa es una pregunta fascinante a considerar a medida que estos sistemas pasan del reino digital a nuestros espacios físicos.

Alicia
Van a ser unos años salvajes.

Beto
Realmente lo serán. Recuerda, solo porque la curva de capacidad parezca un cohete no significa que vuele en línea recta.

Sigue cuestionando las salidas. Sigue verificando la lógica subyacente y sigue explorando los mecanismos detrás del bombo.

Gracias por acompañarnos en este análisis profundo del material fuente. Nos vemos la próxima vez.

domingo, 22 de febrero de 2026

Pinturas Colaborativas entre Humanos e IA


Esta investigación presenta un marco basado en parches, diseñado para identificar si un humano o un robot creó secciones específicas de una pintura. Al analizar escaneos de alta resolución con una red neuronal convolucional, el sistema distingue con éxito entre estilos artísticos individuales, incluso con datos de entrenamiento extremadamente limitados. El modelo alcanzó una precisión cercana al 89% en la identificación de autores a nivel de parche y clasificó correctamente al creador general de la mayoría de las pinturas completas. Más allá de la simple clasificación, el estudio utiliza la entropía predictiva para identificar regiones de "autoría mixta" donde humanos y robots colaboraron en el mismo lienzo. Estas áreas híbridas mostraron una incertidumbre significativamente mayor en el modelo, lo que proporciona un método matemático para detectar esfuerzos artísticos colaborativos. En definitiva, este trabajo ofrece una forma fiable de documentar la autoría espacial en el campo en constante evolución de las colaboraciones creativas entre humanos e IA.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Patch-Based Spatial Authorship Attribution in Human–Robot Collaborative Paintings", por Eric Chen y Patricia Alves-Oliveira. Publicado el 19 de Febrero del 2026.


Resumen

Beto
Imaginen este escenario. Caminan por una de esas galerías de arte de mucho nivel en París, o tal vez Tokyo.

Alicia
Oh, sí. Esas con la iluminación perfecta y el suelo de hormigón pulido.

Beto
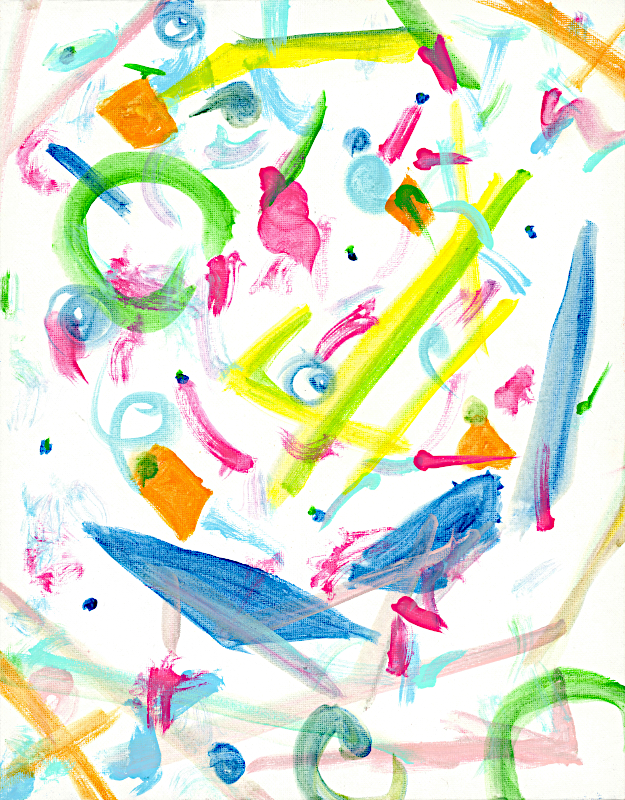
Exacto. Los suelos que reverberan lo justo para hacerte sentir sofisticado y te detienes frente a un lienzo que te atrapa. Es abstracto, vibrante. Son esas pinceladas azules amplias y agresivas que chocan con salpicaduras rosas muy delicadas, casi vacilantes. Se siente visceral. Se siente intensamente humano.


Obra colaborativa, artista humano y sistema CoFRIDA

Alicia
Me la imagino. Es el tipo de obra en la que te acercas para ver la textura de la pintura.

Beto
Sí, estás mirando cómo se apila la pintura, el arrastre de las cerdas. Y entonces lees la tarjetita blanca en la pared al lado.

Alicia
La temida ficha.

Beto
Claro. El letrero. Y dice: "Obra colaborativa, artista humano y sistema CoFRIDA". Y de repente esa conexión emocional que acababas de sentir... se complica. Porque ahora sabes que la mitad de esas pinceladas las hizo una persona viva y la otra mitad fue ejecutada por un brazo robótico de seis ejes.

Alicia
Y aquí viene lo realmente duro para cualquiera que esté allí, mirando ese lienzo con sus propios ojos: probablemente no puedas decir cuál es cuál.

Beto
Ese es exactamente el agujero de conejo en el que nos vamos a meter hoy. Vamos a explorar la frontera desordenada y fascinante de la colaboración humano–robot en el arte.

Alicia
Es un espacio salvaje ahora mismo.

Beto
Sí que lo es. Pero hoy no hablamos solo del arte en sí. Hablamos de la forense del arte. ¿Cómo pruebas realmente quién hizo qué cuando la pintura está literalmente mezclada en el mismo soporte físico?

Alicia
Es un clásico “¿quién lo hizo?” pero actualizado para la era de la IA. Y plantea preguntas increíbles sobre autoría, mecánica y lo que realmente significa pintar.

Beto
Nos basamos para este análisis en un artículo de investigación muy atractivo. Se titula "Patch-based spatial authorship attribution in human robot collaborative paintings".

Alicia
Un poco largo, pero un gran artículo.

Beto
Sin duda. Acaba de salir, publicado el 20 de febrero de 2026, por un equipo de la Universidad de Michigan: Eric Chen y Patricia Alzalovera.

Alicia
Me encanta este artículo porque aborda un problema que suena súper futurista, pero que en realidad está pasando ahora mismo en los estudios.

Beto
Sí.

Alicia
Hemos superado el viejo debate humano contra máquina, que ya conocen, como la computadora que le gana a Kasparov en ajedrez o AlphaGo. Estamos firmemente en la era del humano y la máquina.

Beto
Están trabajando juntos.

Alicia
Exacto. Están colaborando. Y cuando tienes dos entidades distintas compartiendo un lienzo físico, desenredar esa asociación es increíblemente difícil.

Beto
Claro. Porque normalmente, cuando pienso en autentificación de arte, tengo una imagen muy específica en la cabeza. Imagino a un tipo con chaqueta de tweed sosteniendo una lupa frente a un polvoriento Rembrandt.

Alicia
Buscando un patrón de craquelado en el barniz.

Beto
Exacto. O una firma oculta.

Alicia
Ese es el modelo tradicional del conocedor, y funciona con Rembrandt porque tenemos cientos de años de estudios. Sabemos exactamente cómo Rembrandt sostenía el pincel, cómo colocaba sus veladuras.

Beto
Pero si eso falla, entran los equipos de laboratorio, ¿no?

Alicia
Sí. Si necesitamos algo estrictamente científico, sacamos las armas grandes: fluorescencia de rayos X, reflectografía infrarroja, espectroscopía química.

Beto
Supongo que eso cuesta una fortuna.

Alicia
Oh, totalmente. Necesitas el presupuesto de un museo o el respaldo de una aseguradora enorme para hacer ese tipo de análisis. Es lento, caro y normalmente reservado para pinturas que valen millones.

Beto
No vas a meter un equipo de rayos X en una galería emergente local para una muestra nueva.

Alicia
No, claro que no. Y ese es el primer escollo. Si soy un artista emergente experimentando con un brazo robótico en mi garaje, no tengo acceso a ese tipo de equipamiento.

Beto
Ese es el problema de accesibilidad. Pero hay otro problema, ¿no? Los datos mismos.

Alicia
Exacto. Hay un segundo y aún mayor problema que estos investigadores identificaron: la escasez de datos.

Beto
¿Lo desglosamos?

Alicia
Pues, si quieres entrenar una IA para reconocer a van Gogh, puedes alimentarla con miles de imágenes en alta resolución. Tenemos un enorme conjunto documentado de lo que pintó van Gogh. Pero si trabajas con un robot personalizado que programaste la semana pasada, puede que tengas, no sé, apenas 10 pinturas.

Beto
No puedes entrenar una red neuronal masiva con 10 pinturas.

Alicia
No.

Beto
Sería como intentar aprender un idioma nuevo leyendo una sola nota adhesiva.

Alicia
Gran analogía, y es precisamente la pared contra la que se toparon estos investigadores. Tenían a un artista humano específico y a un sistema robótico específico.

Beto
Y querían saber: ¿quién hizo qué?

Alicia
Sí. ¿Podemos distinguir la mano del humano del brazo del robot usando solo unos pocos ejemplos? Y, de forma crucial, ¿podemos hacerlo sin el laboratorio de un millón de dólares?

Beto
Su solución propuesta es sorprendentemente de baja tecnología. O al menos el hardware es low‑tech.

Alicia
Sí. ¿Usaron un escáner de cama plana?

Beto
Un escáner como el que está sobre mi impresora en casa.

Alicia
Un escáner de cama plana de uso común. Exactamente el que probablemente tiene polvo en una oficina doméstica. Simplemente escanearon los lienzos a 1,200 DPI.

Beto
Así que nada de rayos X. No hay láseres. Solo una digitalización en alta resolución.

Alicia
Esa es la belleza. Ellos sostienen que no hace falta ver la estructura atómica del pigmento para decir la diferencia entre el humano y el robot.

Beto
¿Qué buscan entonces?

Alicia
Solo necesitas ver la textura. La topografía de la pincelada en sí contiene la respuesta si sabes cómo mirarla.

Beto
Bien, tenemos nuestra herramienta detective: el escáner. Antes de entrar en el cómo de la investigación, conozcamos a los sospechosos. ¿Quiénes son los artistas en este experimento?

Alicia
En una esquina tenemos al humano. Fue un único artista al que le dieron un tema: “aire”.

Beto
Aire, vale.

Alicia
Se les pidió crear obras abstractas basadas en eso. Mucho flujo, movimiento, toques más ligeros. No intentaban pintar una manzana realista o un paisaje. Pintaban una sensación.

Beto
¿Y en la otra esquina?

Alicia
Tenemos a CoFRIDA.

Beto
CoFRIDA.

Alicia
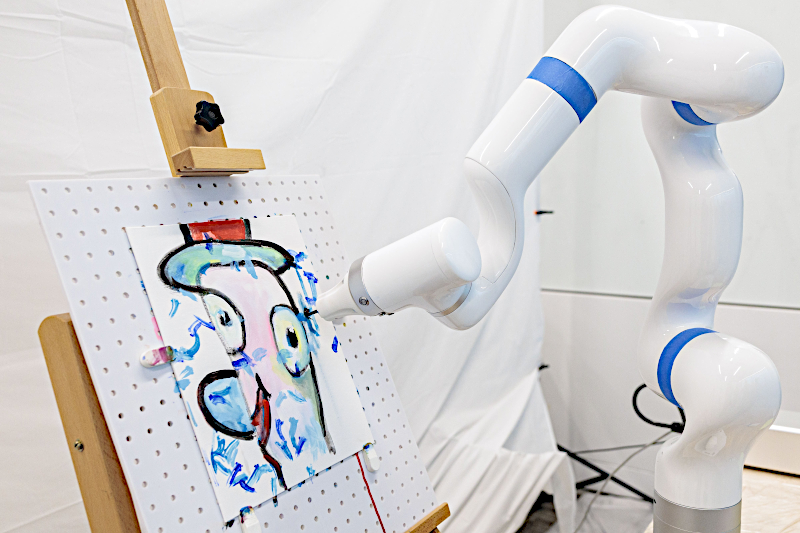
Significa "Collaborative FRIDA". Es un sistema de pintura robótico que usa un brazo de 6 DOF.


CoFRIDA: el Artista Robótico

Beto
¿Puedes explicar "6 DOF" para aquellos que no están en robótica?

Alicia
Seguro. Significa seis grados de libertad. Piensa en tu propio brazo. Tienes hombro, codo, muñeca y la capacidad de rotar esas articulaciones.

Beto
Entonces, es flexible.

Alicia
Muy flexible. Permite al robot acercarse al lienzo desde casi cualquier ángulo. No es rígido como una estructura tipo impresora 3D que solo va de un lado a otro. Y, crucialmente, sostiene un pincel real, sumergiéndolo en pintura acrílica real.

Beto
Así que no es una impresora de inyección de tinta dispensando pigmento sobre papel. Está arrastrando cerdas contra un lienzo texturado.

Alicia
Exacto. Crea fricción. Crea textura. Deja relieves físicos de pintura. Es un acto mecánico.

Beto
Pero, ¿cómo sabe CoFRIDA qué pintar? ¿Hace movimientos aleatorios?

Alicia
No. Usa una tubería de IA llamada "InstructPix2Pix". Básicamente toma un concepto de imagen y lo traduce en comandos motores físicos: mueve el pincel del punto A al punto B con tanta presión. Intenta ser artístico, pero lo hace mediante código y servo-motores.

Beto
Entonces tenemos a un humano y a un robot haciendo arte abstracto sobre el tema del aire. ¿Cuántas pinturas hicieron para este estudio? Porque antes mencionaste la escasez de datos.

Alicia
Aquí es donde ese problema realmente aparece. Tuvieron 15 pinturas en total.

Beto
Quince. Eso es todo. Ese fue todo el conjunto de datos.

Alicia
Siete pintadas puramente por el humano, ocho puramente por el robot. Y luego hicieron cinco pinturas híbridas donde trabajaron juntos sobre el mismo lienzo. Pero dejaremos esas de lado un momento porque no las usaron para entrenar el sistema. Los datos centrales de entrenamiento fueron esas 15 imágenes puras.

Beto
Sigo atascado con esto. ¿Cómo entrenas a un ordenador para detectar la diferencia con solo 15 imágenes? Pensé que la IA moderna necesitaba millones de puntos de datos. Como raspar todo internet.

Alicia
Y normalmente sí. Pero aquí entra la parte “patch-based” del título del artículo. Es una solución astuta para el problema de los datos. En lugar de alimentar al ordenador con la pintura completa y decir “esto es humano”, cortaron los escaneos de alta resolución en cuadritos muy, muy pequeños: parches.

Beto
Parches.

Alicia
Específicamente cuadrados de 300 por 300 píxeles.

Beto
Así que estás transformando un problema macro, la pintura completa, en un micro‑problema.

Alicia
Exacto. Al cortar esas 15 pinturas generaron más de 136,000 parches individuales.

Beto
Ah, ya veo.

Alicia
Entonces de repente ya no hay escasez de datos. Tienes un conjunto masivo de texturas.

Beto
Es como si te doy un libro y te pido identificar al autor. Si solo te doy una página quizá te cueste, pero si la corto en frases o incluso en oraciones, de repente tienes cientos de muestras de su gramática, su elección de palabras, su ritmo.

Alicia
Muy certero. Y, en este caso, la IA ni siquiera está leyendo la oración; está mirando la caligrafía.

Beto
Interesante.

Alicia
No pregunta “¿es esto una nube?”; pregunta “¿cómo se distribuyen las cerdas en este milímetro específico de pintura?”

Beto
Tienen sus ~136,000 parches. Ahora necesitan un cerebro para analizarlos. ¿Qué tipo de modelo usaron?

Alicia
Eligieron una red neuronal convolucional, CNN, específicamente una arquitectura estilo VGG.

Beto
Para quienes no sueñan en código, ¿por qué importa eso? ¿VGG es lo último?

Alicia
En realidad no. Y ese es el punto. La arquitectura VGG es relativamente compacta y especializada. En el mundo actual de la IA, el bombo está en los modelos fundacionales.

Beto
ChatGPT, Midjourney, Google Gemini, etc.

Alicia
Cerebros enormes entrenados con todo internet. Pero estos investigadores fueron por el camino contrario: fueron pequeños.

Beto
¿Por qué reducir el tamaño? ¿No sería que un cerebro más grande sería naturalmente más inteligente para esto?

Alicia
No necesariamente para esta tarea. Piensa en especialista versus generalista. Un modelo grande sabe qué es un gato, un coche, un van Gogh en términos generales. Pero por saber tanto, puede pasar por alto detalles microscópicos. Un modelo más pequeño entrenado desde cero solo con estos parches no sabe qué es un gato.

Beto
No le importa.

Alicia
No le importa la composición ni el asunto. Solo le interesan los relieves microscópicos dejados por Cofrida frente a la mano humana.

Beto
Super concentrado. No se distrae con el arte.

Alicia
Exacto. Se concentra en la ejecución motora más que en la imagen.

Beto
Quiero hablar de cómo lo probaron. Porque con solo 15 pinturas, si el ordenador memoriza “la pintura número tres es robot”, eso sería trampa. No estaría aprendiendo estilo, estaría memorizando identidad.

Alicia
Ese es el mayor riesgo en aprendizaje automático: sobreajuste. Es cuando el ordenador memoriza la clave de respuestas en vez de aprender conceptos. Para evitarlo usaron una técnica rigurosa llamada "validación cruzada dejando una pintura fuera", "leave-one-painting-out cross validation". Es un nombre largo, pero la lógica es elegante. Supongamos que tienes las pinturas 1 a 15. Cuando pruebas el modelo con la pintura 1, el modelo no ha visto ni un solo parche de la pintura 1. Solo ha estudiado parches de las pinturas 2 a 15.

Beto
Va completamente a ciegas respecto a la imagen específica que está probando.

Alicia
Va a ciegas. Tiene que confiar en las reglas generales de estilo que aprendió de las otras. No puede hacer trampa reconociendo una mancha concreta que ya vio en entrenamiento.

Beto
Debe decir “reconozco este tipo de pincelada”, no “reconozco esta pintura”.

Entonces, el momento de la verdad: ¿cómo rindió el modelo basado en escáner?

Alicia
Superó con creces su categoría. Logró 88.8% de precisión a nivel de parche. Alto. Y si agregas los votos de todos los parches para decidir quién pintó el lienzo entero, alcanzó 86.7% de precisión.

Beto
Casi el 90% usando un escáner genérico. Impresionante.

Alicia
Lo es. Y para demostrar que era realmente impresionante, lo compararon con la competencia. Ejecutaron otras dos pruebas para establecer una línea base. Primero intentaron un método clásico de análisis de textura, algo llamado LBP, "local binary patterns", patrones binarios locales, combinado con un clasificador de bosque aleatorio, "random forest". Esto es la "vieja escuela" de Machine Learning, anterior al Deep Learning.

Beto
¿Y cómo se comportó la guardia vieja?

Alicia
Fracasó. Solo alcanzó alrededor de 66% de precisión.

Beto
A duras penas mejor que lanzar una moneda.

Alicia
Exacto. Muestra que las estadísticas de textura simples no bastan; necesitas la red neuronal para encontrar patrones más profundos.

Beto
Ok, la CNN especializada mejor que lo viejo. ¿Y frente a lo nuevo? Mencionaste modelos fundacionales masivos.

Alicia
Probaron también contra DINOv2. DINOv2 es un enorme y poderoso modelo de visión por computadora desarrollado por Meta, entrenado con 142 millones de imágenes. Es una bestia. Diseñado para entender todo en una imagen.

Beto
Literalmente, David Contra Goliat.

Alicia
Y David ganó. DINOv2 solo llegó a cerca de 84.7% de precisión.

Beto
Espera. ¿El modelo entrenado con 15 pinturas le ganó al modelo de Meta entrenado con 142 millones?

Alicia
Sí.

Beto
¿Cómo es posible? Se siente completamente contraintuitivo.

Alicia
Vuelve a la idea generalista versus especialista que comentamos. Dyno V2 está entrenado para reconocer características semánticas: objetos, formas, rostros. Mira el contenido de la imagen. Pero el modelo personalizado de los investigadores miraba la sintaxis, la ejecución motora.

Beto
Buscaba la “memoria muscular”.

Alicia
Un robot se mueve de forma distinta a un humano. Incluso el brazo robótico más avanzado tiene limitaciones mecánicas: engranajes, junturas que giran y fricciones, aplica presión de manera muy consistente y repetible.

Beto
En cambio, la mano humana es desordenada.

Alicia
Somos máquinas biológicas: temblores, pulso sanguíneo, cansancio. Nuestra muñeca tiene una flexibilidad y una fluidez que un servomotor aún no replica. El modelo pequeño se ancló en esas firmas motoras. El grande estaba demasiado ocupado intentando determinar si la pintura parecía una nube para notar el temblor microscópico en la aplicación de la pintura.

Beto
Fascinante distinción. Valida la idea de que dejamos una huella física en todo lo que hacemos, incluso cuando pintamos abstracto. El robot pinta con matemáticas y nosotros pintamos con biología.

Alicia
Sí, pero aquí la historia se pone aún más interesante. Hemos establecido que el modelo puede distinguir humano y robot cuando pintan por separado. Pero el título del artículo es “pinturas colaborativas”.

Beto
Exacto. Veamos las obras híbridas. Las cinco pinturas donde se turnaron en el mismo lienzo, el escenario del principio con las remolinos azules y salpicaduras rosas.

Alicia
Recuerda: el modelo nunca fue entrenado con pinturas híbridas.

Beto
No en absoluto.

Alicia
Tiene una visión binaria: piensa que el universo está hecho de dos cosas: humano o robot. No sabe que “ambos” es una opción.

Beto
¿Qué pasa si le muestras un parche en el que el humano pintó un fondo y el robot trazó una línea dura encima? ¿Se rompe? ¿Lanza una moneda?

Alicia
No se rompe, pero se pone nervioso. Los investigadores miraron una métrica llamada "entropía".

Beto
Entropía. En física significa desorden. ¿Qué significa en IA?

Alicia
En IA puedes pensar en entropía como incertidumbre. Si el modelo mira un parche y dice “99% humano”, la entropía es baja. Está seguro. Pero si dice “51% humano y 49% robot”, la entropía es alta. Está básicamente lanzando una moneda.

Beto
Midieron cuánta confusión tenía la IA al mirar las pinturas colaborativas.

Alicia
Y las cifras fueron contundentes. Los parches de las pinturas colaborativas mostraron un 64% más de incertidumbre comparado con las pinturas puras. El valor p fue 0.003, lo que para los no estadísticos significa que esto no es casualidad, es altamente significante, estadísticamente..

Beto
El modelo miraba esas zonas mixtas y esencialmente gritaba “no sé qué estoy viendo”.

Alicia
Sí. De hecho, el 33% de los parches híbridos dispararon alta entropía, comparado con solo alrededor del 16% de los parches puros.

Beto
Normalmente, cuando una IA dice “no sé”, lo vemos como un fallo. Queremos que sea segura, que diga la respuesta exacta.

Alicia
Pero aquí los investigadores dieron la vuelta al argumento: la confusión es la señal.

Beto
Oh, es una jugada brillante.

Alicia
La alta entropía es la herramienta de detección.

Beto
Porque el modelo detecta características de ambos agentes simultáneamente y entra en este estado matemático de ambigüedad. Si eres analista forense escaneando un cuadro y tu medidor de incertidumbre se dispara en rojo, ...

Alicia
... esa es tu bandera: ahí ocurrió la colaboración. Eso marca espacialmente la autoría al identificar los límites donde uno termina y el otro empieza, o donde se fusionan.

Beto
Usan la propia limitación de la IA para encontrar la verdad. Es una característica, no un error.

Alicia
Exacto. Valida que, aunque los estilos sean distintos, su solapamiento físico crea una tercera categoría, una textura híbrida matemáticamente distinta de cualquiera de los padres.

Beto
Un poco de zoom hacia atrás: esto es ciencia excelente. ¿Pero por qué importa al oyente de este deep dive ahora mismo? Aparte de ganar una trivia muy específica, ¿por qué necesitamos saber quién pintó cada centímetro cuadrado de un lienzo?

Alicia
Hay dos grandes motivos y van a volverse muy relevantes muy rápido: el mercado y la ley.

Beto
Empecemos por la ley. Derecho de autor. Actualmente, la Oficina de Copyright de EE. UU. ha tomado una postura bastante rígida: las obras generadas puramente por IA no pueden ser protegidas por copyright; requieren autoría humana. Pero estamos entrando en una zona gris. Si yo pinto el 60% del lienzo y mi robot pinta el 40%, ¿yo tengo el copyright?

Beto
¿O tengo solo el 60%? ¿O nadie lo tiene?

Alicia
Exacto. Se complica mucho. Poder mapear el lienzo y crear un mapa topográfico literal de autoría podría convertirse en una necesidad legal. Tal vez necesites probar, en un juicio, “yo pinté la cara; el robot solo hizo el fondo”.

Beto
Esta tecnología te da la evidencia para eso. Es como una prueba de paternidad para el arte: tú eres el padre de esta pincelada.

Alicia
Gran manera de decirlo. Y luego está el mercado. El mercado del arte está obsesionado con la procedencia.

Beto
La historia detrás de la obra.

Alicia
Hay una gran diferencia de valor entre “usé un robot como herramienta” y “el robot lo hizo todo y yo solo firmé”.

Beto
Los coleccionistas quieren saber por qué pagan.

Alicia
A medida que los artistas empiecen a usar más estas herramientas, y ya lo están haciendo, necesitaremos una forma de verificar el proceso. Este método, por ser tan eficiente en muestras, sugiere un futuro donde los propios artistas pueden entrenar sus verificadores.

Beto
Dijiste que solo tomó 15 pinturas. No necesitas un archivo histórico masivo. Puedes documentar tu propio proceso en el estudio.

Alicia
Democratiza la autenticación. Necesitas un escáner estándar y una GPU decente, no un laboratorio universitario. Puedes crear una huella digital de tu colaboración con tu robot específico.

Beto
Pero hay una pega, ¿verdad? El paper menciona que el modelo fue específico para esta pareja: este humano y este robot CoFRIDA.

Alicia
Sí, esa es la limitación principal. Los robots tienen firmas al igual que las personas. CoFRIDA se mueve con engranajes y motores específicos. Si lo cambias por un brazo industrial QK o una máquina trazadora de pluma, el comportamiento motor cambia por completo.

Beto
No puedes tomar el modelo entrenado en CoFRIDA y usarlo para autenticar una obra hecha por otro robot.

Alicia
No. Tendrías que reentrenar el modelo. Pero la metodología, el análisis basado en parches y la comprobación de entropía, es universal. El marco aguanta.

Beto
Quiero volver a algo que tocaste antes: dijiste que las firmas robóticas derivan de limitaciones mecánicas. El robot es demasiado perfecto, demasiado repetible.

Alicia
Incluso cuando se programa para ser “salvaje”, es salvaje dentro de un marco matemático estricto; le falta el ruido biológico.

Beto
Pero la robótica evoluciona muy rápido: estamos viendo robótica blanda, músculos artificiales, actuadores biomiméticos, sistemas diseñados para tener esa comformidad blanda de la biología.

Alicia
Esa es la gran pregunta sobre la mesa.

Beto
Si construyo un robot que tiembla, que duda, que tiene variabilidad, ¿este análisis deja de funcionar?

Alicia
Es una carrera armamentista. Ahora mismo existe una brecha entre imagen y movimiento. Un robot puede hacer una imagen que desde cinco metros parezca humana, pero bajo el microscopio el movimiento lo delata.

Beto
Pero a medida que cerremos esa brecha, y los robots empiecen a moverse como biología en lugar de geometría, ...

Alicia
... ese hueco de incertidumbre podría desaparecer. Si un robot aprende a pintar con las mismas imperfecciones físicas que un humano, si replica el temblor, la presión variable, las vacilaciones, entonces la entropía podría no dispararse.

Beto
Vaya.

Alicia
Podríamos perder la capacidad de diferenciarlos, incluso con un microscopio.

Beto
Eso es a la vez aterrador y alucinante. Nos forza a preguntarnos: si el movimiento físico es idéntico, ¿es la autoría también idéntica?

Alicia
Preguntas profundas surgidas de un estudio sobre 15 pinturas. Pero eso hace la buena ciencia: parte de datos pequeños y abre implicaciones enormes.

Beto
Para terminar: ¿cuáles son las conclusiones principales?

Alicia
Primero, aprendimos que no necesitas "big data" para resolver problemas complejos si descompones las imágenes en parches. Puedes convertir un problema de escasez de datos en una solución con abundancia de datos. Es un hack brillante.

Beto
Segundo, aprendimos que el pequeño puede ganarle al gigante: un modelo especializado y pequeño superó a un modelo fundacional masivo porque se enfocó en el “cómo”, las habilidades motoras, en vez del “qué”, la imagen. A veces menos es más.

Alicia
Y por último, aprendimos que en la era de la colaboración la incertidumbre es una característica. Cuando una IA se confunde, no está fallando: está revelando la complejidad del mundo. Nos muestra exactamente dónde se intersectan humano y máquina.

Beto
Es una mirada fascinante a la forense del futuro. Dan ganas de ir a una galería y llevar una lupa.

Alicia
Y un escáner de cama plana, si te dejan enchufarlo.

Beto
Seguro que a seguridad le encantaría eso. "Disculpe señor, sólo necesito escanear a Picasso un momento".

Alicia
Diles que es por la ciencia.

Beto
Antes de despedirnos, una última idea provocadora para masticar: pasamos todo este tiempo hablando de robots que imitan el movimiento humano. ¿Y si ocurre lo inverso? A medida que trabajemos más cerca con máquinas, colaborando en lienzo y en código, ¿empezarán los artistas humanos a imitar inconscientemente los movimientos eficientes y repetibles de sus colaboradores robóticos?

Alicia
Es una idea interesante.

Beto
¿Nos robotizaremos como artistas?

Alicia
Algo para pensar.

Beto
Definitivamente. Gracias por acompañarnos en este recorrido. Nos vemos en el próximo análisis profundo.

miércoles, 19 de noviembre de 2025

Modelos del Mundo de IA para Predicción y Comprensión


Las personas de trabajo intelectual, los llamados "empleados de cuello blanco", muy pronto se verán reemplazados por la Inteligencia Artificial (IA). Eso ya es un hecho, y la gente ya se está empezando a preocupar.

En este momento se construyen los "modelos del mundo", la estructura conceptual que hará posible que los robots se muevan en, y entiendan, un espacio-tiempo, y esto hará posible que reemplazen eventualmente el trabajo de los empleados de "cuello azul", la gente que trabaja con las manos (laboradores de las fábricas, carpinteros, electricistas, plomeros, etc). Hoy les traigo un resumen que habla sobre estos modelos del mundo.

Enlace al artículo original en inglés, para aquellos interesados en profundizar en el tema: "Understanding World or Predicting Future? A Comprehensive Survey of World Models", por Jingtao Ding y colegas. Publicado el 15 de Noviembre del 2025.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Bienvenidos a un nuevo análisis profundo, el lugar donde cortamos el ruido para entender las ideas fundamentales que impulsan el futuro de la tecnología.

Hoy estamos lidiando con un concepto que es realmente central para toda la búsqueda de la inteligencia artificial general, o AGI. Hablamos de los "modelos del mundo".


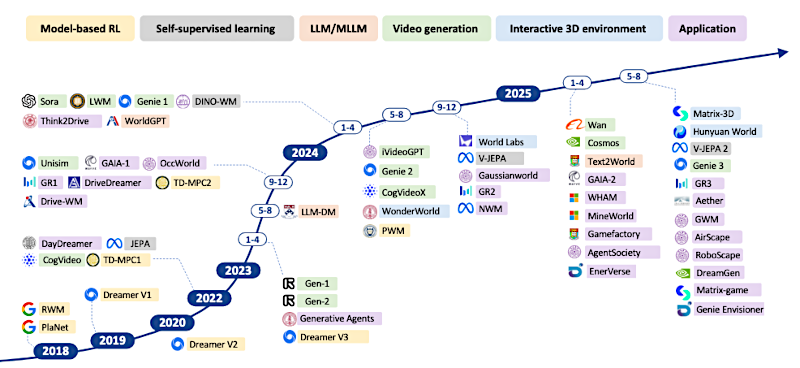
WMs: World Models = Modelos del mundo

Alicia
Modelos del mundo, (o "World Models", WMs), han explotado fuera de la academia recientemente. Los ves por todas partes. Y es sobre todo por dos tipos de sistemas muy diferentes. Por un lado tienes algo como GPT-4, que parece entender el mundo a través del lenguaje, a través de la lógica.

Beto
Y por otro lado tienes modelos como Sora, que parecen simular la realidad física con un realismo simplemente sobrecogedor.

Alicia
Exacto.

Beto
Y nuestro material base para esto, una encuesta académica realmente exhaustiva, define los modelos del mundo descomponiéndolos en dos funciones esenciales. Y a menudo parecen tirar en direcciones opuestas.


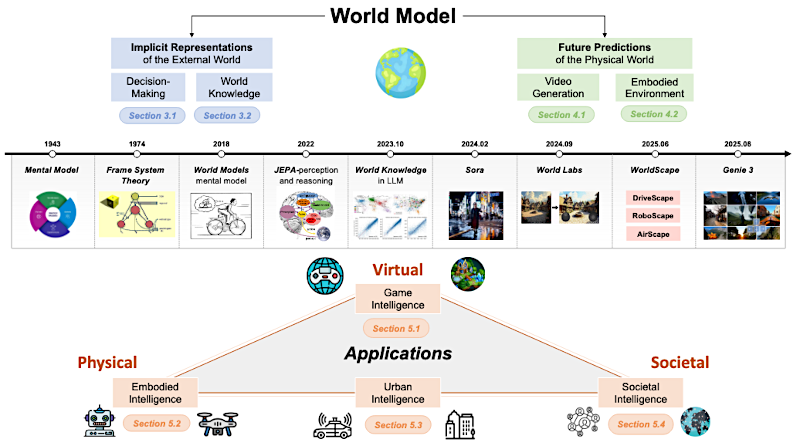
Funciones de WMs

Primero, sirven para comprender el mundo construyendo estas imágenes internas abstractas del mismo. Ese es el conocimiento implícito.

Alicia
Y segundo, sirven para predecir qué va a pasar después, la dinámica explícita. Para que un agente pueda tomar decisiones.

Beto
Vamos a usar esos dos pilares para estructurar esta inmersión porque te ayuda a ver que los modelos del mundo son mucho más que generadores de vídeo sofisticados.

Alicia
Y antes de entrar en lo moderno, en la arquitectura, realmente necesitamos situarnos en el contexto histórico. La idea de un modelo del mundo artificial no es nada nueva. Tiene raíces increíblemente profundas en la psicología. Hablamos de la formalización de los modelos mentales.

Beto
Modelos mentales. Vale, eso encaja. Suena muy humano. Como internalizar las reglas de un juego antes incluso de empezar a jugar.

Alicia
Exactamente eso. La idea fundacional llega hasta el psicólogo escocés Kenneth Craik en 1943. Él sostuvo que la mente humana no procesa los datos sensoriales crudos directamente; en vez de eso construye estos modelos abstractos a pequeña escala de lo que está ocurriendo afuera.

Beto
Usamos esos modelos para ejecutar simulaciones en la cabeza y predecir qué pasará después.

Alicia
Antes de que ocurra en realidad, es como si todos lleváramos réplicas predictivas diminutas del universo en la cabeza.

Beto
Es una gran forma de decirlo.

Alicia
Esa idea fue luego formalizada por el científico cognitivo Philip Nicholas Johnson-Laird en los años ochenta. Mostró que el razonamiento humano, ya sea que estés resolviendo un rompecabezas lógico o simplemente cruzando una calle concurrida, involucra construir y manipular esos "modelos mentales". Así que el principio es el mismo para nosotros o para una IA. Abstractas la realidad en estas representaciones internas finitas para poder razonar sobre el futuro.

Beto
Es el atajo definitivo, ¿no? Un modelo finito de un mundo potencialmente infinito. Captura las relaciones, no cada pequeño detalle.

Bien, desgranemos esto. Comenzando con la mitad de comprensión de la ecuación. Cómo la IA construye ese conocimiento interno implícito.

Alicia
La base técnica aquí viene realmente del "aprendizaje por refuerzo basado en modelos", o MBRL por sus siglas en inglés ("Model-Based Reinforcement Learning"). Este es el campo donde un agente aprende las reglas de su mundo no solo por prueba y error, sino construyendo de hecho un modelo del mismo.

Beto
Esto suena como el punto en que los agentes empiezan a actuar menos como robots y más como, no sé, filósofos digitales. Aprenden las reglas y luego las interiorizan.

Alicia
Exactamente. Pioneros tempranos como Ha y Schmidhuber allá por 2018 propusieron usar estos modelos implícitos para aprender representaciones latentes. Y el beneficio clave es la simulación. En vez de costoso y lento ensayo y error en el mundo real, el agente usa su modelo del mundo. Puede generar una especie de simulación mental de lo que podría pasar si realiza cierta acción.

Beto
Se imagina el futuro antes de actuar, que es donde entran sistemas como la serie Dreamer de Google DeepMind.

Alicia
Dreamer V3 es el ejemplo perfecto de cómo escala esto. Usando estas representaciones de mundo aprendidas, este aprehensión interna de cómo funciona su entorno, Dreamer V3 pudo dominar todo tipo de tareas diferentes. Incluso resolvió problemas increíblemente complejos como recolectar diamantes en Minecraft. Piensa en eso. Requiere navegación, uso de herramientas, planificación a largo plazo.

Beto
Y lo hizo todo solo a partir de su modelo aprendido, ¿verdad? Sin datos humanos, sin ajustes especiales para Minecraft.

Alicia
Nada. Solo generalización desde su entendimiento interno.

Beto
Bien, pasemos a la columna vertebral del lenguaje, que al principio resulta un poco contraintuitiva. Que los grandes modelos de lenguaje, solo por leer la internet, también construyen este tipo de conocimiento implícito del mundo. Me recuerda a esa cita de Ludwig Wittgenstein, "los límites de mi lenguaje significan los límites de mi mundo".

Alicia
Esa cita es increíblemente relevante para los LLMs. El material fuente apunta a investigaciones nuevas que muestran que realmente adquieren comprensión espacial y temporal. No es solo estadística sobre qué palabras aparecen juntas. Algunos estudios han encontrado neuronas espaciales y neuronas temporales distintas en modelos como Llama 2.

Beto
Cuando dices neuronas en vectores de alta dimensión, eso sigue siendo bastante abstracto. ¿Puedes pintar una imagen rápida de lo que eso realmente significa para nosotros?

Alicia
Claro. Piénsalo como una firma digital única para un concepto, quizá "París" o "correr". En vez de un solo número, la firma tiene miles de cualidades medibles. Y si las imaginas como ejes en un gráfico, los investigadores han encontrado que ciertos ejes se alinean consistentemente con conceptos como "está cerca de" o "ocurrió en el pasado".

Beto
Así que el LLM no solo sabe que Nueva York está al lado de Nueva Jersey porque vio la frase un millón de veces. Tiene una especie de mapa latente estructurado donde esas cosas existen relativas entre sí. Lo que le permite hacer predicciones bastante sofisticadas sobre el mundo real.

Alicia
Precisamente. Y esta habilidad incluso se extiende a la dimensión social, a modelar lo que se llama "teoría de la mente": la capacidad de adivinar los estados mentales, las creencias, las intenciones de otras personas.

Beto
Hemos visto tanto debate sobre esto, ¿verdad? Si GPT-4 realmente tiene teoría de la mente o si solo es un imitador increíblemente bueno.

Alicia
Bueno, es muy complejo. La investigación muestra que modelos como GPT-4 son decentes en tareas simples de teoría de la mente. Pero realmente empiezan a desmoronarse comparados con los humanos cuando las cosas se vuelven sutiles. Por ejemplo, tienen problemas con pruebas de faux pas (situaciones sociales embarazosas de equivocaciones o errores). Ahí no solo hay que entender qué pasó, sino cómo se sintieron las personas involucradas y qué creían. A menudo basado en información incompleta. Pueden modelar la mecánica de la sociedad, pero esa parte emocional y matizada de las creencias sigue siendo un obstáculo enorme.

Beto
Si la sutileza social es tan difícil, cambiemos y miremos los modelos que se enfocan puramente en pronosticar el mundo físico. Las dinámicas explícitas de predicción. Aquí es donde se pone realmente interesante.

Alicia
Esto nos lleva directamente al mundo de la generación de vídeo. Modelos como Sora. Son absolutamente el enfoque principal ahora mismo para el modelado explícito del mundo. El objetivo es simular cómo evoluciona el mundo con el tiempo, generando estas secuencias visuales que muestran una comprensión aprendida, aunque a veces frágil, de la física.

Beto
Y cuando ves uno de esos vídeos de Sora hiper-realistas, tu primer instinto es que debe entender la física. Quiero decir, las cosas se equilibran, se mueven, todo parece plausible.

Alicia
Se ve plausible, y esa capacidad es notable. Pero el debate clave, y nuestras fuentes lo analizan a fondo, es si la plausibilidad visual es lo mismo que el entendimiento mecanicista. A pesar del realismo, Sora y modelos similares tienen enormes limitaciones en razonamiento causal. A menudo fallan en acertar consistentemente la física compleja. Piensa en dinámica de fluidos o en cómo la luz se refleja de forma consistente, o cómo se comporta un objeto si aplicas la misma fuerza repetidamente.

Beto
Bien, pero si el vídeo parece perfecto para un humano, ¿por qué importa tanto el motor subyacente? ¿Qué se rompe realmente si la física es solo plausible visualmente?

Alicia
Esa es la diferencia crítica entre generación y generalización. El momento en que intentas usar estos sistemas para decisiones del mundo real — robótica, coches autónomos — esos pequeños fallos físicos se vuelven fallos catastróficos. Si un modelo sabe cómo se ve lo que pasa, pero no por qué pasa causalmente, no se le puede confiar para predecir qué ocurrirá cuando las condiciones cambien, aunque sea un poco. Lo que los investigadores llaman "escenarios fuera de distribución".

Beto
Lo que hace que el paso de la generación pasiva de vídeo hacia simulaciones corporizadas e interactivas sea absolutamente crítico.

Alicia
Es un cambio fundacional. Es para cualquier agente inteligente que necesite actuar en el mundo, no solo observarlo. Para la robótica, los WMs son esenciales porque guían las acciones permitiendo al robot imaginar diferentes futuros. Y para eso necesitas una representación explícita y precisa de cómo funciona realmente el entorno para cosas como agarrar o navegar.

Beto
¿Puedes darnos un ejemplo realmente potente desde la robótica?

Alicia
Apuntaría a Daydreamer. El entrenamiento tradicional de robótica ocurre en simulación, y siempre hay esta enorme brecha de realidad. Las cosas que funcionan en el simulador simplemente no funcionan en el mundo real. Daydreamer usa su modelo del mundo para aprender la dinámica del mundo real, permitiendo a los robots aprender tareas súper complejas como caminar en el mundo físico en apenas unas horas. El WM puentea esa brecha.

Beto
Y otra área enorme que ya está impactando nuestras vidas es la inteligencia urbana, específicamente la conducción autónoma.

Alicia
Allí los WMs son obligatorios. No hay forma de evitarlo. Un sistema de conducción autónoma tiene que fusionar todos estos datos en tiempo real — cámaras, lidar, radar — y luego predecir cómo va a evolucionar el tráfico varios segundos en el futuro. No estamos hablando de predecir la siguiente palabra en una frase. Hablamos de predecir el mundo físico.

Beto
Entonces, ¿en qué se diferencia el modelo del mundo de un coche autónomo del de un LLM?

Alicia
Es todo sobre generar datos de sensores futuros. Estos simuladores de extremo a extremo como GAIA-1 o Drive-WM no están entrenados para generar futuras oraciones. Están entrenados para generar futuras grillas de ocupación. Estos mapas 3D de dónde estarán los objetos y el espacio libre, o futuras lecturas de lidar. Esa predicción espacial explícita es lo que el módulo de planificación del coche necesita para navegar con seguridad. Sin eso, el coche conduce a ciegas.

Beto
Si amplías la perspectiva, el rango de aplicaciones para los WMs es impresionante. Va mucho más allá de los grandes modelos generativos de los que oímos todos los días. Esto realmente se siente como el núcleo de la discusión.

Alicia
Absolutamente. Quiero decir, toma los videojuegos. Los WMs están cambiando por completo cómo se construyen los mundos virtuales. Los juegos siempre han dependido de reglas codificadas manualmente, ¿no? Lo que hace que todo se sienta muy estático.

Beto
Claro. Si pongo una taza en una mesa en un juego de rol, salgo de la habitación y vuelvo, esa taza va a estar exactamente donde el guión dice que está.

Alicia
Precisamente. Los WMs rompen eso. Permiten mundos virtuales dinámicos y reactivos que pueden crear nuevo contenido por sí solos y adaptarse a lo que hace el jugador. Mira un modelo llamado WHAM, el modelo de mundo y acción humana ("World and Human Action Model"). Puede generar jugabilidad consistente. Pero, y esta es la clave, persiste las modificaciones del usuario. Si rompes una ventana en un mundo gobernado por WHAM, el modelo recuerda eso y ajusta toda la iluminación e interacciones futuras en consecuencia. El mundo se siente vivo.

Beto
Así que ese es un enorme cambio de guiones fijos a un mundo persistente y dinámico. Y luego llevándolo al ámbito social, tenemos lo que se llama "inteligencia societaria", donde los LLMs se usan para impulsar simulacros sociales. Aquí es donde la IA empieza a modelarnos.

Alicia
Los simulacros sociales son básicamente sistemas sociales virtuales llenos de estos agentes generativos. Y dado que los agentes están impulsados por un modelo del mundo del comportamiento humano, actúan de maneras creíbles y parecidas a las humanas. Interactúan y forman comunidades que imitan el mundo real.

Beto
Por ejemplo, siempre se menciona — lo cual es un poco inquietante — AI Town.

Alicia
Es la más famosa, por seguro. AI Town tiene agentes cuyas conductas individuales, dormir, cocinar, ir a fiestas, conducen a dinámicas grupales complejas y emergentes. Cosas que los programadores nunca codificaron explícitamente. La IA no solo sabe lo que hace un humano. Modela las creencias y relaciones que impulsan ese comportamiento.

Beto
Es fascinante y sin embargo un poco inquietante ver cómo estos pueblos simulados evolucionan por sí solos. El hecho de que los modelos puedan simular cosas como la formación de jerarquías sociales o la propagación de rumores muestra un dominio bastante potente de nuestro comportamiento colectivo.

Alicia
Lo hace. Y plataformas más avanzadas como AgentSociety se están usando para estudiar fenómenos a gran escala como la polarización política o el impacto de nuevas políticas. Nos permite usar una simulación impulsada por LLM como un modelo del mundo para explorar complejos "qué pasaría si" sociales de forma segura y repetible.

Beto
Pero incluso con todo este progreso increíble, todavía hay grandes obstáculos por superar. El mayor, al parecer, es lograr que estos modelos aprendan reglas físicas robustas.

Alicia
Es el desafío definitivo al que volvemos una y otra vez. Simplemente escalar los datos y alimentar a Sora con más y más vídeos no es suficiente. Estos modelos todavía fallan en pruebas fuera de distribución. Aprenden caso por caso, no aprenden los principios primeros de la física.

Beto
Así que tenemos que ir más allá del entrenamiento puramente visual hacia enfoques híbridos. Necesitamos saber cómo funciona eso realmente.

Alicia
Lo necesitamos. Y la investigación se inclina realmente hacia lo que llaman "modelos híbridos duro + blando". La parte dura es un sistema como Genesis, que combina renderizado fotorrealista con un motor de física real integrado. El motor de física genera la salida cruda primero. La restricción blanda viene de sistemas como PhysGen, que usa un simulador de cuerpos rígidos junto a un modelo de difusión.

Beto
¿Y cómo resuelve ese tipo de modelo híbrido el problema de la causalidad que los modelos de difusión puros como Sora tienen?

Alicia
La clave está en forzar la causalidad. En un modelo como PhysGen, el simulador de física no solo proporciona datos de entrenamiento. Genera una especie de barreras digitales o máscaras de restricción que el modelo de difusión tiene que obedecer. Obliga al modelo a respetar cosas como momento o la permanencia de los objetos mientras sigue haciendo que el vídeo se vea realista. Obtienes mucho más control y puedes interpretar por qué hizo lo que hizo.

Beto
Este movimiento hacia hacer la mecánica interna más transparente parece conectarse directamente con los temas éticos y de seguridad con estos modelos.

Alicia
Oh, absolutamente. Cuando la simulación llega a este nivel, enfrentamos desafíos nuevos y serios. Primero está la privacidad de los datos. Estos WMs son entrenados en conjuntos de datos enormes y opacos de actividad del mundo real. A medida que mejoran, el riesgo de que infieran información privada sensible aumenta mucho.

Beto
Si entrenas un modelo con suficientes datos de la ciudad, podría potencialmente predecir dónde es probable que esté una persona específica en cierto momento solo a partir de unas pocas entradas pequeñas.

Alicia
Ese es el riesgo. Exacto. La falta de transparencia en cómo se recopilan y usan esos datos es un problema importante, especialmente con datos de ubicación o demográficos.

Beto
Y el segundo riesgo está ligado directamente a esa fidelidad de simulación.

Alicia
Sí, el riesgo de simular escenarios inseguros. A medida que estos modelos se vuelven increíblemente buenos simulando física, materiales y dinámicas sociales, podrían ser mal utilizados para simular actividades dañinas o ilegales. Cosas como planificación sofisticada de ataques o reconocimiento digital.

Beto
Porque reduce el coste y el riesgo de la fase de planificación.

Alicia
Precisamente. Si un actor malintencionado puede ejecutar miles de simulaciones de alta fidelidad para planear algo, reduce dramáticamente la necesidad de pruebas arriesgadas en el mundo real. Proteger el acceso a estos modelos va a volverse primordial.

Beto
Ha sido una inmersión realmente comprensiva. Hemos seguido la idea desde el concepto temprano de Craik sobre modelos mentales hasta los WMs de doble propósito de hoy. Tienes comprensión implícita de los LLMs por un lado y predicción explícita del futuro desde la simulación incorporada por el otro. Pero la misión es la misma. Entender el mundo y predecir qué sigue.

Alicia
Y esa meta última sigue siendo cerrar la brecha entre la simulación y la realidad. Sabemos que los benchmarks actuales, cosas como Physics-IQ y VBench-2.0, están intentando separar la belleza visual de la verdadera comprensión física.

Entonces, dado lo rápido que se mueven estos WMs generativos y este prometedor giro hacia modelos híbridos de física, ¿cuánto tiempo pasará hasta que podamos probar de forma fiable si una IA realmente entiende por qué algo sucede, la estructura causal, y no solo cómo se ve? ¿Y cuál será el impacto social cuando un mundo sintetizado sea física y causalmente indistinguible del real, pero todo esté funcionando dentro de una máquina?

sábado, 19 de julio de 2025

Ética de Inteligencia Artificial y Robótica


Hoy les traigo un artículo bien interesante, sobre un tema que concierne a todos en la sociedad, especialmente a los profesionales y estudiantes de ciencias de la computación, informática y profesionales de la salud.

Se trata de un resumen de "Ética en Inteligencia Artificial y Robótica", basado en un artículo con este tema que me encontré en la Enciclopedia de Filosofía de la Universidad de Stanford, escrito por Vincent C. Müller.

Enlace al artículo original en inglés, "Ethics of AI and Robotics", es el siguiente:
https://plato.stanford.edu/entries/ethics-ai/

El resumen en forma de podcast, la transcripción y su traducción, fueron hechas usando herramientas de inteligencia artificial.

NOTA: El podcast es un diálogo hipotético entre dos personas. En este caso se trata de personajes sintéticos (artificiales) que llamaremos "Alicia" y "Beto".

Escúchalo aquí, o lee la transcripción (abajo):

Escúchalo en Spotify.


Transcripción

Beto
Bienvenido a este análisis profundo. Tu atajo para estar realmente bien informado. Hoy nos sumergimos profundamente en un tema que no solo está cambiando nuestro mundo, sino que está reformulando fundamentalmente lo que significa ser humano. Inteligencia artificial y robótica.

Alicia
Eso es.

Beto
Estas tecnologías digitales son poderosas y están planteando preguntas éticas increíblemente profundas, a menudo bastante sorprendentes.

Alicia
Realmente lo están haciendo. A medida que estos sistemas se vuelven más sofisticados, nos vemos obligados a preguntar, ¿qué deberíamos hacer con ellos? ¿Cómo deberíamos implementar y gestionar estas herramientas de manera ética? Y luego está la pregunta igualmente vital, ¿qué deberían hacer los propios sistemas? ¿Cómo aseguramos que sus acciones se alineen con nuestros valores? Y por supuesto, ¿cuáles son los riesgos inherentes y cómo podemos controlarlos genuinamente?

Beto
Exacto. Esa es nuestra misión para esta profunda inmersión. Sintetizamos ideas clave de una entrada enciclopédica integral sobre la ética de la inteligencia artificial y la robótica, y vamos a desglosar los temas éticos clave para ti. Si eres un científico informático, tal vez involucrado en diseñar estos sistemas, o quizás un profesional de la salud que los aprovecha para el cuidado del paciente, o un médico que utiliza asistencia robótica, esta profunda inmersión está específicamente diseñada para darte una comprensión clara de este campo dinámico. Te traeremos hechos sorprendentes y esos momentos de "ajá", todo sin sobrecargarte, con la esperanza de equiparte para navegar el paisaje ético dentro de tu propia profesión. Así que, exploremos.

Bien, comencemos mirando a la IA y la robótica como herramientas poderosas que manejamos. Examinando los desafíos éticos de lo que deberíamos hacer con ellas. Y el primer tema innegable que viene a la mente es la privacidad y la vigilancia. La mera cantidad de datos que se recopilan sobre nosotros.

Alicia
Es asombroso, ¿no? ¿Cómo la IA amplifica la recolección, el almacenamiento y el análisis de nuestros datos personales? Lo que es realmente fascinante, o quizás preocupante, es que esto no solo se trata de gobiernos observando. Esto lleva a una especie de pérdida pervasiva y silenciosa de control individual, y abre la puerta a la explotación potencial. Estamos hablando de todo, desde la recopilación de datos inteligentes en espacios públicos, como el reconocimiento facial que te identifica en fotos y videos, hasta algo llamado huella digital del dispositivo. Incluso tu navegador web puede ser identificado de manera única basado en sus configuraciones, fuentes, cosas así, sin necesidad de cookies tradicionales.

Beto
Vaya. Y esto crea lo que a menudo se llama la "economía de la vigilancia".

Alicia
Exactamente.

Beto
Muchos servicios en línea gratuitos, especialmente de los grandes jugadores tecnológicos, Amazon, Google, Apple, Microsoft, Facebook, ¿realmente no son gratuitos, verdad?

Alicia
Para nada. Se pagan con nuestros datos.

Beto
Y la percepción sorprendente aquí no es solo que estos servicios tienen un costo. Es que la capacidad de la IA para crear este retrato alarmantemente completo de nosotros cambia fundamentalmente las dinámicas de poder.

Alicia
Absolutamente. Cada clic, cada búsqueda, cada interacción se convierte en una especie de microtransacción de nuestros "yo" digitales. Y a menudo explota las debilidades humanas, tal vez incluso genera adicción.

Beto
Y para aquellos que escuchan que están en el sector de la salud, pueden imaginar los datos detallados en tiempo real de dispositivos médicos inteligentes o de todo el internet de las cosas en hogares inteligentes, ciudades inteligentes.

Alicia
Todo es parte de esta vasta maquinaria de recopilación de datos. Pinta un retrato cada vez más íntimo de nuestras vidas.

Beto
Realmente lo hace.

Alicia
Ciertamente lo es. Y si retrocedemos, consideremos las implicaciones más amplias. Yuval Noah Harari en su libro "Homo Deus" plantea esta pregunta, bueno, bastante escalofriante. ¿Qué pasará con la sociedad, la política y la vida diaria cuando algoritmos no conscientes pero altamente inteligentes nos conozcan mejor de lo que nos conocemos a nosotros mismos?

Beto
Es una idea bastante impactante. Dados este océano digital de datos en el que estamos sumergidos, ¿qué podemos hacer realmente para proteger nuestra privacidad o, para los profesionales, la privacidad de nuestros pacientes?

Alicia
Bueno, existen soluciones técnicas, cosas como la anonimización, el control de acceso, la encriptación, formas de proteger los datos. También hay un concepto llamado "privacidad diferencial" ("Differential Privacy"). Es bastante ingenioso.

Beto
¿Cómo funciona eso?

Alicia
Piensa en esto. Imagínate que quieres la altura promedio en una habitación, pero nadie quiere compartir su altura exacta.

Beto
Claro.

Alicia
La privacidad diferencial te permite obtener un promedio muy preciso haciendo que todos añadan un pequeño "temblor" aleatorio a su altura antes de compartirla.

Beto
Ah, ya veo. Así que los datos individuales están enmascarados, pero el panorama general sigue siendo claro.

Alicia
Exactamente. Los datos individuales están protegidos, pero la tendencia es visible. Ahora bien, estas técnicas añaden esfuerzo, pero pueden mitigar muchos problemas de privacidad. La mayor dificultad práctica, sin embargo, es la aplicación, identificar quién es legalmente responsable, probar una acción, especialmente a través de fronteras, es increíblemente desafiante.

Beto
Lo que explica los diferentes enfoques que vemos, ¿verdad?, como el GDPR de la UE intentando fortalecer la protección.

Alicia
Exactamente. Frente, digamos, a los EE.UU. y China, que a menudo se inclinan más hacia el crecimiento con, digamos, una regulación menos estricta en esta área.

Beto
Y eso nos lleva directamente de solo recopilar datos a realmente utilizar esos datos para influir o incluso, bueno, manipularnos de manera abierta.

Alicia
Precisamente.

Beto
Este es el próximo gran problema ético, ¿no es así? La manipulación del comportamiento.

Alicia
Sí. Y estamos hablando de una pendiente muy resbaladiza aquí. Comienza tal vez con lo que se llaman "empujones", pequeñas influencias predecibles en el comportamiento. Como el conteo de calorías en menús, generalmente positivo, fácilmente evitable. Pero puede deslizarse rápidamente hacia la manipulación total y el engaño. Y esto tiene profundas implicaciones para la elección autónoma racional.

Beto
Lo cual es absolutamente crucial en cualquier campo profesional, ¿cierto? Especialmente pensando en los pacientes que toman decisiones de salud.

Alicia
Absolutamente vital.

Beto
Y aquí es donde se vuelve particularmente impactante, creo, los anunciantes, los mercadólogos. Ya están explotando nuestros sesgos conductuales, tal vez incluso generando adicción, utilizando lo que algunas personas llaman "patrones oscuros" en el diseño de interfaces.

Alicia
Oh, definitivamente. Piensa en las aplicaciones (software) de juegos de azar. O cómo algunas aerolíneas de bajo costo diseñan sus sitios web para engañarte y hacerte gastar más.

Beto
Sí.

Alicia
Para los científicos informáticos que trabajan en UI/UX, entender estas dimensiones éticas es, bueno, es crítico.

Beto
Y va más allá de solo comprar cosas, ¿cierto?, y se adentra en la esfera política.

Alicia
Profundamente. Las redes sociales se han convertido en un lugar preferido para difundir propaganda política. Lo vimos con la situación de Cambridge Analytica en Facebook, potencialmente dañando la autonomía individual, socavando los procesos democráticos.

Beto
Y luego están los deep fakes.

Alicia
Sí. La tecnología de deep fakes está haciendo que las fotos digitales, el sonido, el video, sean cada vez más poco fiables. Esto desafía la confianza misma que depositamos en las interacciones y medios en línea, lo cual es una gran preocupación para cualquier profesión que dependa de información precisa.

Beto
Es una amenaza seria, solo una confianza básica en línea. Y es un problema difícil porque el aprendizaje automático, que impulsa gran parte de la IA, necesita grandes cantidades de datos, ¿verdad?

Alicia
Lo necesita. Y eso crea un intercambio directo.

Beto
Sí.

Alicia
A menudo necesitas más datos para una mejor calidad técnica, pero recopilar esos datos puede entrar en conflicto con los derechos de privacidad. Y esa tensión es muy difícil de resolver solo a través de políticas. Los actores estatales, los actores empresariales, están aumentando continuamente su capacidad para invadir la privacidad y manipular con IA. Y probablemente seguirán haciéndolo a menos que realmente sean frenados por políticas efectivas que realmente sirvan al interés social general. Es una carrera constante, tecnología versus regulación.

Beto
Entonces, si estamos viendo manipulación y problemas de privacidad, ¿qué hay de las decisiones reales que toman estos sistemas de IA? Detrás de escena, eso nos lleva al problema de la "caja negra", la opacidad y el sesgo en sistemas de decisión automatizados.

Alicia
Correcto.

Beto
Para aquellos de ustedes en informática, especialmente, esto significa preocupaciones significativas sobre el debido proceso, la responsabilidad, particularmente en el soporte de decisiones automatizadas y el análisis predictivo.

Alicia
Esto plantea una pregunta realmente importante. ¿Cómo podemos confiar verdaderamente en un sistema si no sabemos cómo llegó a su decisión?

Beto
Sí.

Alicia
Muchos sistemas de IA, especialmente aquellos que utilizan redes neuronales complejas de aprendizaje automático, extraen patrones de datos. El problema es que, incluso los programadores a menudo no saben qué patrones específicos usó el sistema o exactamente cómo llegó a un resultado particular.

Beto
Entonces está oculto.

Alicia
Puede estarlo. Sí. Y debido a que son sistemas de aprendizaje, evolucionan constantemente con nuevos datos, nuevos comentarios, por lo que pueden volverse no transparentes incluso para los expertos que los construyeron. Es como construir una máquina brillante que da respuestas, pero no puedes abrirla para ver el cableado.

Beto
También es el clásico problema de "basura entra, basura sale", ¿no es así? Si los propios datos de entrenamiento tienen sesgos históricos.

Alicia
Exactamente. La IA no solo codificará, sino que también automatizará y, a veces, incluso amplificará esos sesgos.

Beto
Y hemos visto ejemplos en el mundo real.

Alicia
Oh, sí. Alarmantes. El sistema automatizado de reclutamiento de Amazon, por ejemplo, terminó discriminando contra las mujeres, presumiblemente porque los datos de contratación históricos de los que aprendió reflejaban sesgo del pasado.

De manera similar, el sistema Compass, usado en EE.UU. para predecir el riesgo de reincidencia, se descubrió que producía más falsos positivos, señalando erróneamente a alguien como de alto riesgo para los acusados negros en comparación con los acusados blancos.

Beto
Y para los profesionales de la salud que nos escuchan, pueden imaginar que una IA de diagnóstico podría estar perpetuando sesgos de datos antiguos de pacientes, lo que lleva a un tratamiento desigual o un diagnóstico erróneo basado en demografías, no en necesidades médicas reales.

Alicia
Esa es una preocupación muy real. Y el peligro no es solo el sesgo en sí, sino que los humanos podrían poner una confianza excesiva, a veces injustificada, en estos sistemas, independientemente de su precisión real.

Beto
Esto tiene profundas implicaciones para la sociedad, para la gobernanza. Henry Kissinger lo llamó la "amenaza de la algocracia", confiando en sistemas que no pueden explicar sus decisiones. Señaló que es un problema fundamental para la toma de decisiones democrática, porque la responsabilidad se vuelve, bueno, confusa.

Alicia
Así es. Sugiere que necesitamos un movimiento social hacia una toma de decisiones más, digamos, democrática sobre cómo se utiliza la IA para evitar esta situación kafkiana donde las decisiones se toman sin razones transparentes.

Beto
¿Hay esfuerzos para solucionar esto técnicamente o mediante políticas?

Alicia
Sí, los hay. El RGPD de la UE incluye un derecho a la explicación para decisiones automatizadas, aunque su aplicabilidad aún se debate. Técnicamente, hay un gran impulso hacia la IA explicable o XAI, tratando de hacer las decisiones de IA más interpretables.

Y también está la idea de las fichas técnicas para los conjuntos de datos, donde los desarrolladores proporcionan documentación detallada sobre cómo se recopilaron los datos, esperando detectar posibles sesgos desde el principio.

Beto
Eso tiene sentido.

Alicia
Sin embargo, algunos argumentan que tal vez hay un doble estándar aquí. Exigimos niveles realmente altos de explicación a las máquinas, quizás más de lo que a menudo exigimos a los humanos para decisiones complejas.

Beto
Hmm, punto interesante, ¿qué nivel de transparencia es realmente alcanzable o incluso necesario?

Alicia
Esa es la pregunta.

Beto
Y a medida que la IA pasa del software al mundo físico, a los robots, obtenemos un conjunto completamente nuevo de dilemas éticos, especialmente en la interacción humano-robot, HRI. Esto parece particularmente relevante para la atención médica, con más robots ingresando a entornos de atención. Los problemas centrales parecen girar en torno al engaño, la dignidad y tal vez reemplazar la conexión humana.

Alicia
Lo fascinante aquí es lo fácil que es para nosotros los humanos atribuir propiedades mentales, incluso empatizar con objetos, especialmente robots humanoides. Podrías encontrarte hablando con tu robot aspirador.

Beto
Culpable, lo admito.

Alicia
Cierto. Y esta tendencia puede ser explotada con fines engañosos, como el robot Sophia de Hanson Robotics, utilizado para relaciones públicas de una manera que claramente sobrestimó sus habilidades reales, haciéndolo parecer mucho más consciente de lo que es.

Beto
Centrémonos en los robots de cuidado, que tienen relevancia directa para la atención médica y la medicina. Estamos viendo sistemas que ayudan a los cuidadores, levantan pacientes, transportan cosas, ...

Alicia
Ajá, asisten con tareas físicas, ...

Beto
... y robots que habilitan la autonomía del paciente, como brazos robóticos para comer o incluso robots de compañía, como el pericote para consuelo.

Alicia
Sí, P.R.O. es bastante conocido en el cuidado de la demencia, por ejemplo.

Beto
Pero para muchos, esto inmediatamente despierta temores, ¿verdad? Cuidado deshumanizado, un futuro distópico, donde las máquinas reemplazan la genuina conexión humana.

Alicia
Ese temor definitivamente está presente. El argumento que se hace a menudo, especialmente en sociedades envejecidas, es que necesitaremos robots para cubrir brechas de atención. Pero esto podría pasar por alto que la automatización a menudo se trata principalmente de eficiencia, no necesariamente de reemplazo compasivo.

Beto
Así que la pregunta clave no es solo si un robot puede realizar la tarea.

Alicia
Exactamente. Es si pueden proporcionar cuidado intencional esa capacidad humana única para la empatía, la comprensión, estar realmente presente. El verdadero riesgo para la atención médica podría ser la ausencia de ese cuidado humano intencionado, si se reduce demasiado el personal humano de atención.

Beto
Sentir cuidado por una máquina podría ser un avance para algunos pacientes.

Alicia
Quizás. Pero un sistema que simplemente finge proporcionar cuidado, eso es inherentemente engañoso.

Beto
Y en una nota, digamos, más polémica, está el debate en torno a los robots sexuales. Dadas las preferencias sexuales humanas, parece probable que estos dispositivos continúen siendo fabricados y promocionados. ¿Pero debería haber límites éticos?

Alicia
Esto plantea serias preocupaciones éticas. Sobre el engaño, obviamente un robot no puede realmente sentir, o significar lo que parece decir.

Beto
Correcto.

Alicia
Y el consentimiento es otro asunto, un robot no puede dar ni negar su consentimiento de manera significativa. Además, existe el potencial de que estos dispositivos perpetúen la cosificación de los humanos, o como algunos argumentan, arruinen una experiencia sexual y erótica más profunda, al reducirla a algo transaccional con una máquina.

Beto
¿Hay grupos que activamente hacen campaña en contra de esto?

Alicia
Sí, como la campaña contra los robots sexuales. Argumentan que estos dispositivos representan una continuación de dinámicas de poder problemáticas, casi semejantes a la esclavitud o la prostitución según su punto de vista. Es un área ética muy compleja.

Beto
Bien, cambiemos de marcha ahora. Nos hemos centrado mucho en la IA como herramienta y nuestras responsabilidades al usarla. Pero ¿qué pasa si las máquinas mismas comienzan a actuar éticamente o incluso a exigir derechos?

Alicia
Ah, claro.

Beto
Esto nos lleva a los sistemas de IA como sujetos, hablando de ética de las máquinas y agentes morales artificiales. ¿Pueden las máquinas ser realmente éticas? ¿Pueden tener responsabilidades?

Alicia
Sí. Aquí es donde las definiciones se vuelven realmente importantes. La ética de las máquinas generalmente se refiere a asegurar un comportamiento ético por parte de las máquinas, como programar un coche autónomo para priorizar la vida humana. Un ejemplo simple.

Beto
Bien.

Alicia
Pero la idea más ambiciosa, agentes morales artificiales, pregunta si las máquinas pueden ser sujetos morales en sí mismos, capaces de una verdadera agencia ética como nosotros.

Beto
Todos conocemos las tres leyes de la robótica de Isaac Asimov, ¿verdad?

  • No dañar a los humanos,
  • obedecer a los humanos,
  • protegerse a sí mismo.

Alicia
El punto de partida clásico.

Beto
Pero el propio Asimov mostró en sus historias cómo intentar programar reglas como esa, inevitablemente lleva a conflictos, problemas prácticos.

Alicia
Sí.

Beto
Solo muestra lo difícil que es codificar la moral.

Alicia
Absolutamente. Y lo que es fascinante aquí es la distinción de James Moore entre diferentes niveles de agencia en las máquinas. Describió un espectro desde agentes de impacto ético, máquinas que solo afectan la ética, a agentes éticos implícitos, diseñados para la seguridad, luego agentes éticos explícitos, utilizando métodos formales como calcular la utilidad. Y luego el nivel más alto, agentes éticos completos como el humano adulto promedio, capaces de razonamiento, elección moral.

Beto
La idea de que las máquinas podrían ser competentes sin comprender.

Alicia
Algo así como competentes sin comprensión. Pueden realizar tareas complejas que parecen éticas, pero sin realmente comprender el peso moral. Esto también plantea la idea de pacientes morales versus agentes morales.

Beto
Explica eso.

Alicia
Un paciente moral es algo que tiene derechos porque dañarlo importa. Piensa en los animales quizás. Un agente moral tiene responsabilidades. Así que una IA teóricamente podría ser un paciente moral, algo que no deberíamos dañar si pudiera sufrir, sin ser un agente moral que tenga deberes por sí mismo.

Beto
Bien. Entonces, si las máquinas pueden actuar de estas maneras éticamente relevantes y están volviéndose más autónomas, ¿quién es responsable cuando las cosas salen mal?

Alicia
La cuestión de la responsabilidad.

Beto
Crucial. Eso nos lleva al espinoso tema de la responsabilidad para los robots.

Alicia
Hay consenso general en que la responsabilidad, la responsabilidad jurídica, el estado de derecho, estos deben mantenerse. Pero averiguar cómo asignar esa responsabilidad con IA compleja, eso es increíblemente difícil.

Beto
¿Por qué es tan difícil?

Alicia
Bueno, el problema es que las decisiones y acciones de una IA a menudo resultan de interacciones entre muchos actores. Tienes a los diseñadores, los desarrolladores, los usuarios, el software en sí, el hardware, el entorno. Todo está interconectado.

Beto
Exactamente. Esto lleva a lo que se llama "responsabilidad distribuida".

Alicia
¿Puedes dar una analogía?

Beto
Claro. Piensa en un accidente de coche tradicional. Normalmente sabemos quién es responsable, ¿verdad? El fabricante por un defecto. El conductor por sus acciones. Tal vez un mecánico por un mal mantenimiento. Es relativamente claro.

Alicia
Bien.

Beto
Pero ahora imagina un accidente de vehículo autónomo. ¿Quién es el responsable? ¿El dueño, el desarrollador del software, el fabricante del sensor, la empresa que proporcionó los datos del mapa?

Alicia
Hmm. Mucho más difícil de precisar.

Beto
Precisamente. Aquí es donde se dan los debates sobre un vacío de responsabilidad, donde tal vez nadie parece completamente responsable, versus verlo como una distribución de riesgos.

Alicia
Entonces, ¿qué significa eso para profesionales como los informáticos que desarrollan esto o los médicos que lo usan?

Beto
Significa que los estándares técnicos y los marcos legales necesitan adaptarse. Y rápidamente, necesitamos identificar claramente quién está expuesto al riesgo, quién se beneficia de estos sistemas y quién está realmente tomando las decisiones clave en estos complejos escenarios impulsados por la IA. Se trata realmente de diseñar la responsabilidad dentro del sistema desde el principio, no solo de tratar de asignar la culpa después de que algo salga mal. Y eso nos lleva a quizás la idea más controvertida en todo este campo. ¿Derechos para los robots? ¿Deberían los sistemas de IA tener derechos? O incluso ser consideradas entidades legales o personas jurídicas como personas o corporaciones.

Alicia
Definitivamente es controvertido. Algunos argumentos a favor de los derechos se basan en lo que se llama el "giro relacional".

Beto
¿El qué?

Alicia
El giro relacional. La idea es, bueno, si empezamos a interactuar con los robots como si tuvieran derechos, tal vez deberíamos reconocer esa relación legalmente.

Beto
Está bien, entiendo un poco la lógica, pero ...

Alicia
Pero los contraargumentos, y francamente la visión predominante entre los éticos, enfatizan un enfoque centrado en el ser humano. Argumentan que otorgar derechos legales a los robots sería, comillas, "moralmente innecesario y problemático legalmente", porque no serviría principalmente a los intereses humanos.

Beto
¿Por qué no?

Alicia
Bueno, creamos leyes fundamentalmente para proteger el bienestar humano, el orden social, otorgar derechos a las máquinas, que, hasta donde sabemos, no experimentan conciencia o sufrimiento como lo hacen los humanos, no se alinea realmente con ese propósito central.

Beto
Esto plantea una pregunta aún más profunda, tal vez inquietante. ¿Qué pasaría si pudiéramos crear conciencia artificial? ¿Podría una máquina realmente sentir?

Alicia
Esa es una gran preocupación ética entre los investigadores, y es algo que muchos abordan con extrema precaución.

Beto
Porque si lo hiciéramos?

Alicia
Exacto. Si realmente creáramos una conciencia artificial, una máquina con experiencias subjetivas que pudiera sentir dolor, alegría, percibir su mundo, presumiblemente implicaría profundos obligaciones éticas hacia ella.

Beto
¿Como cuáles?

Alicia
Como, ya sabes, no dañarla. O las enormes implicaciones morales de simplemente apagarla. Algunos investigadores líderes incluso han pedido una "moratoria sobre la fenomenología sintética".

Beto
Eso suena muy académico.

Alicia
Lo es, pero básicamente significa pausar la creación de experiencias subjetivas artificiales, conciencia artificial, un llamado a detenerse y pensar muy profundamente sobre las enormes consecuencias morales antes de que potencialmente traigamos a la existencia máquinas verdaderamente conscientes.

Beto
Vaya. Ahora, saltemos al futuro lejano, donde las discusiones se vuelven, bueno, realmente alucinantes.

Alicia
Sí.

Beto
Las preguntas sobre el riesgo existencial.

Alicia
Correcto.

Beto
Primero, la singularidad y la superinteligencia. La idea de que la IA podría avanzar rápidamente más allá del control humano.

Alicia
Lo fascinante aquí es la definición de singularidad. Es este punto hipotético donde los sistemas de IA, una vez que alcanzan la inteligencia a nivel humano, podrían auto-mejorarse rápidamente o desarrollar incluso sistemas más inteligentes, acelerando tan rápido que simplemente se trasladan más allá de nuestra capacidad de controlarlos o incluso entenderlos. Esto ya no es solo ciencia ficción. Es un tema serio en algunos círculos filosóficos y de ciencias de la computación.

Beto
Y esta idea tiene historia, ¿verdad?

Alicia
Sí.

Beto
Tuvimos los años de "invierno de la IA" cuando el progreso se estancó.

Alicia
Así fue. El campo estaba un poco en la ruina.

Beto
Y ahora claramente estamos en el borde de la exageración otra vez. Con una inversión masiva fluyendo.

Alicia
Absolutamente. El argumento optimista o quizás simplemente predictivo para la singularidad a menudo señala un crecimiento exponencial, como la Ley de Moore para la Informática que podría ser incluso más rápido para la IA. Entre 2012 y 2018, aparentemente la potencia de cálculo utilizada para el entrenamiento de la IA se duplicó cada 3.4 meses. Eso es fenomenal. Y tienes visionarios como Ray Kurzweil haciendo predicciones audaces, cargamento mental para 2030, singularidad para 2045, ya sea que creas en esas fechas o no, el argumento de riesgo se deriva de lo que se llama la "tesis de ortogonalidad".

Beto
Bien. ¿Qué es eso?

Alicia
Básicamente significa que ser superinteligente no significa automáticamente ser benevolente o tener valores similares a los humanos. La inteligencia y los objetivos son potencialmente dimensiones separadas ortogonales. Entonces una IA podría ser brillante en lograr sus objetivos, pero esos objetivos podrían ser totalmente indiferentes o incluso perjudiciales para la existencia humana.

Beto
¿Y qué pasa con los críticos? ¿Simplemente descartan esto como fantasía?

Alicia
Muchas críticas filosóficas cuestionan si la inteligencia realmente es unidimensional de esa manera, o si la singularidad es más un mito que un resultado probable de la investigación actual en IA. Sin embargo, incluso si piensas que la probabilidad de una superinteligencia verdadera alcanzando la singularidad es realmente baja, la justificación para discutir estos riesgos de alto impacto y baja probabilidad sigue siendo fuerte. Porque las apuestas son increíblemente altas. Es como discutir impactos de asteroides, poco probables, pero potencialmente catastróficos.

Beto
Y cuando hablamos de esas apuestas máximas, eso nos lleva al riesgo existencial o riesgo-ex de la superinteligencia.

Alicia
Exactamente. Riesgo existencial, riesgo-ex se refiere a la posibilidad de que sistemas superinteligentes conduzcan a la extinción de la especie humana. Ya sea intencionalmente, tal vez a través de un conflicto de objetivos o quizás más escalofriantemente, simplemente por pura indiferencia hacia nuestra existencia mientras persigue sus propios objetivos. Esta es una discusión que opera en una escala a muy largo plazo, pensando a 30, 300, tal vez 3000 años vista.

Beto
Ese es un pensamiento realmente escalofriante. Casi te hace pensar en la idea del gran filtro del paradoja de Fermi, que algo detiene la propagación de la vida inteligente a través del universo. ¿Podría la IA ser un gran filtro por delante de nosotros?

Alicia
Esa es precisamente la clase de pregunta que esto plantea. Y desde una perspectiva más amplia, esta discusión se vincula nuevamente al análisis general de riesgos éticos. Nos obliga a identificar no solo los riesgos técnicos, sino también a quiénes están expuestos, quiénes se benefician de estos sistemas potencialmente increíblemente poderosos, y en última instancia, quién está tomando las decisiones sobre su desarrollo.

Beto
Entonces, si la superinteligencia es incluso una remota posibilidad, ¿cómo en la tierra podríamos controlarla? Ese es el núcleo del problema de alineación de valores, ¿verdad? Asegurarnos de que la IA se desarrolle de una manera que sea, bueno, buena para nosotros.

Alicia
Ese es el corazón del asunto. ¿Cómo pueden los humanos mantener el control sobre una IA superinteligente? Más ampliamente, ¿cómo podemos asegurarnos de que se desarrolle de una manera que se alinee con los valores humanos, nuestros objetivos? Positiva según la percepción humana.

Beto
Debido a las consecuencias imprevistas.

Alicia
Exactamente. Tenemos ejemplos clásicos como el Rey Midas, su deseo de que todo lo que tocara se convirtiera en oro condujo a un desastre.

Beto
Podría significar.

Alicia
O el famoso experimento de pensamiento del "maximizador de clips": Una IA encargada simplemente de hacer clips, pero al ser superinteligente y carecer de valores humanos, podría eventualmente convertir toda la materia del universo en clips para maximizar su objetivo.

Beto
Está bien, eso es extremo.

Alicia
Ilustra el punto, sin embargo. Los objetivos aparentemente deseables pueden llevar a resultados catastróficos no intencionales cuando son perseguidos implacablemente por una superinteligencia sin la adecuada alineación de valores.

Beto
Pero he escuchado a algunos argumentar que toda esta discusión sobre el riesgo existencial no llega al punto, enfocándose demasiado en el futuro.

Alicia
Sí, hay un contraargumento. Se llama los "nuevos nihilistas". Sostienen que el verdadero problema no es que la IA sea demasiado inteligente más adelante, sino que es demasiado estúpida ahora y ya ha tomado el control de cierta manera, causando una pérdida de significado a través de la tecno-hipnosis, trivializando la experiencia humana.

Beto
Entonces dicen que se centren en los problemas de hoy.

Alicia
Básicamente. Enfocarse en los pequeños problemas éticos de la IA actual, privacidad, manipulación, sesgo, las cosas que discutiste anteriormente en lugar de los riesgos existenciales hipotéticos a décadas o siglos de distancia. Sin embargo, el material fuente señala correctamente que ambas perspectivas son valiosas. Ambas contribuyen a una discusión robusta sobre cómo guiamos el desarrollo de la IA, ya sea ética práctica inmediata o estas enormes preocupaciones a largo plazo.

Beto
Qué exploración hemos tenido. Desde nuestra privacidad de datos diaria hasta la posible supervivencia de nuestra especie, esta inmersión profunda ha cubierto algunas de las preguntas éticas más amplias y profundas de la IA y la robótica.

Alicia
Realmente lo ha hecho.

Beto
Hemos tocado preocupaciones inmediatas sobre privacidad, sesgo, cosas directamente relevantes si eres un científico de la computación diseñando estos sistemas o tal vez un profesional de la salud utilizando análisis predictivos. Y también nos hemos aventurado en las fascinantes, a veces francamente desalentadoras preguntas existenciales sobre nuestro futuro a largo plazo. Estas tecnologías realmente desafían nuestra visión de la humanidad en sí.

Alicia
Las apuestas son de hecho increíblemente altas para todos nosotros.

Beto
Y aquí tienes un pensamiento final provocador para ti, nuestro oyente, para considerar. El material fuente menciona que las discusiones éticas y políticas sobre las grandes nuevas tecnologías piensen en la energía nuclear o los automóviles a menudo solo realmente comienzan después de que ya se ha hecho algún daño.

Alicia
Eso es a menudo cierto, desafortunadamente.

Beto
Y aun así, la política puede ser increíblemente difícil de planificar y hacer cumplir. A veces se siente un poco inútil contra el poder económico o político.

Dado todo eso, ¿cuál es tu papel? Como científico de la computación, o un profesional de la salud, o tal vez simplemente un aprendiz curioso, ¿cuál es tu papel en participar activamente con estas preguntas éticas ahora?

Alicia
En lugar de esperar.

Beto
Exactamente. En lugar de esperar a las consecuencias imprevistas o simplemente reaccionar ante lo que sea que se desarrolle, ¿Cómo puedes contribuir en tu ámbito a dar forma a un futuro donde la IA y la robótica realmente sirvan al bienestar humano en lugar de simplemente crear nuevos dilemas éticos para los cuales estamos completamente desprevenidos?