Mostrando entradas con la etiqueta CoPilot. Mostrar todas las entradas

sábado, 29 de agosto de 2026

Copilot en el desarrollo colaborativo de software de código abierto

Este estudio investiga cómo GitHub Copilot, una herramienta de IA generativa, influye en el desarrollo colaborativo de software de código abierto (OSS) mediante el análisis de datos de proyectos y métricas de uso propietarias. Los investigadores descubrieron que, si bien la adopción de la IA aumenta las contribuciones de código en casi un 6 % e impulsa la participación de los desarrolladores, también conlleva un aumento del 8 % en el tiempo de coordinación debido a debates de código más intensos. Esto genera una disyuntiva importante: la IA facilita la generación de contenido más rápida, pero complica el proceso de integración dentro de equipos descentralizados. El impacto es notablemente desigual, ya que los desarrolladores principales experimentan mayores ganancias de productividad y menores retrasos en la coordinación en comparación con los desarrolladores periféricos, quienes enfrentan mayores dificultades para integrar su código. En definitiva, el artículo sugiere que, si bien la IA proporciona un beneficio neto para la producción de proyectos, puede transformar fundamentalmente la gobernanza y la estructura social de las comunidades de código abierto. Para mantener una amplia participación, los autores argumentan que las comunidades podrían necesitar nuevas estrategias de gestión para manejar el mayor volumen de contribuciones asistidas por IA.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "The Impact of Generative AI on Collaborative Open-Source Software Development: Evidence from GitHub Copilot". Por Fangchen Song y colegas. Publicado el 12 de Agosto de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Alicia
Está bien, vamos a desglosar esto. Se suponía que la IA generativa era una varita mágica. La agitabas y ¡pum!, tu factura de software, tu plan de marketing está escrito y tus informes legales han sido redactados.

Beto
Correcto, el milagro de la productividad absoluta.

Alicia
Exacto. Pero según este nuevo y masivo conjunto de datos de GitHub, desplegar IA en un entorno de equipo es, en realidad, mucho menos como encontrar una varita mágica y mucho más como contratar a un interno increíblemente rápido y altamente cafeinado.

Beto
Esa es una muy buena manera de decirlo.

Alicia
Correcto. Producen una cantidad masiva de trabajo en solo tiempo récord. Pero también requieren una supervisión monumental y una discusión interminable y comprobación doble para asegurarse de que no rompan accidentalmente todo tu sistema mientras tú no lo estabas viendo.

Beto
Lo cual es una prueba de realidad que necesitamos desesperadamente ahora mismo. Porque la narrativa predominante ha sido esta idea simplista de que la IA hace el trabajo y los trabajadores humanos simplemente pueden tomarse el resto del día libre.

Alicia
Correcto. Y por eso estamos haciendo un análisis profundo en esto hoy. Estamos explorando un próximo artículo de investigación de la Universidad de Texas, en Austin. Se titula "El Impacto de la IA Generativa en el Desarrollo Colaborativo de Software de Código Abierto". La evidencia proviene de GitHub Copilot.

Beto
Es un estudio fascinante.

Alicia
Lo es. Así que nuestra misión para esta inmersión profunda es mirar más allá del bombo, ¿verdad? La idea de que "la IA me hace más rápido". Y queremos examinar los cuellos de botella ocultos e inesperados que la IA crea cuando los humanos intentan trabajar juntos. Y aún más sorprendentemente, vamos a explorar cómo esta tecnología está remodelando fundamentalmente quién tiene el poder en una comunidad profesional.

Beto
Sí. Ese cambio en la dinámica de poder es enorme.

AI_Reshaping_Open-Source_Collaboration_1024.png

Alicia
Sí. Para realmente entender el cuello de botella, primero tenemos que establecer la capacidad potencial base. Porque para ser justos con nuestros internos altamente cafeinados, sí consiguen hacer mucho trabajo.

Beto
Lo consiguen absolutamente. Y la magnitud de los datos aquí lo demuestra. Los investigadores no solo atendieron a unas pocas docenas de programadores. Analizaron un conjunto de datos masivo que abarca desde enero de 2021 hasta diciembre de 2022, mirando más de 7,600 proyectos activos de software de código abierto.

Alicia
Vaya. Eso es una muestra masiva.

Beto
Oh, completamente. Y al rastrear la adopción de GitHub Copilot, que funciona como un programador de pareja de IA, encontraron un aumento del 5.9% en las contribuciones de código a nivel de proyecto.

Alicia
Vale.

Beto
Y para ser específicos, eso significa un aumento del 5.9% en las solicitudes de extracción (pull requests) fusionadas exitosamente, que es código que ha sido revisado, aceptado e integrado en el producto final.

Alicia
Vaya. Un salto de casi el 6% en código totalmente aceptado e integrado en todos estos proyectos descentralizados. Eso es masivo. Pero cuando revisé la metodología, mi lectura fue que este impulso no provino solo de que los programadores existentes escribieran más rápido. Fue en realidad una expansión de dos frentes.

Beto
Ese es el detalle crucial. En economía, dividimos este tipo de crecimiento en el margen extensivo y el margen intensivo.

Alicia
Sí, extensivo e intensivo.

Beto
Correcto. El margen extensivo se trata de la cantidad pura de participantes. Así que los datos mostraron un aumento del 3.4% en el número de desarrolladores únicos que contribuían activamente con código.

Alicia
Oh, vaya.

Beto
Sí. Así que la introducción de la IA trajo en realidad a mucha más gente a la mesa, que de otro modo podrían haberse quedado al margen.

Alicia
Es interesante.

Beto
Y luego tienes el margen intensivo, que mide cuánto trabajo está produciendo realmente cada individuo. Y eso también tuvo un repunte con un aumento del 2.1% en la cantidad de código que cada desarrollador individual logró escribir.

Alicia
Así que tienes una multitud más grande de personas, y cada persona en esa multitud está produciendo más resultados.

Beto
Exacto.

Alicia
Pero la psicología subyacente de por qué sucede esto en un entorno de código abierto es lo que encontré tan intrigante. Los investigadores filtran esto a través de algo llamado "el marco de costo-beneficio y valor esperado". Porque, quiero decir, en un trabajo normal, tu jefe te dice que uses IA, así que la usas.

Pero el código abierto es totalmente voluntario. Nadie está obligando a estos desarrolladores a trabajar gratis.

Beto
Lo que significa que tenemos que mirar su cálculo interno. Un desarrollador solo ofrece su tiempo voluntariamente si los beneficios esperados de contribuir superan los costos esperados. E históricamente, los costos son increíblemente altos. Tienes que gastar una cantidad masiva de esfuerzo mental solo para entender una base de código desde la lógica de un problema, y luego teclear meticulosamente la sintaxis correcta.

Alicia
Correcto, sin cometer un solo error tipográfico que lo rompa todo.

Beto
Exacto. Pero la IA generativa altera fundamentalmente esa ecuación, al reducir esos costos esperados. Se encarga de la escritura repetitiva. Recuerda la sintaxis básica, y autocompleta las cosas mundanas.

Alicia
Sí, entiendo la reducción de costos. La IA reduce drásticamente la barrera de entrada.

Pero permíteme que cuestione el lado del beneficio de ese marco. El artículo argumenta que la IA aumenta los beneficios percibidos de participar. Pero espera, si la IA está escribiendo el código esencialmente, ¿por qué un desarrollador obtendría un impulso en su reputación por eso, o sentiría alguna satisfacción intrínseca?

Beto
Esa es una pregunta justa.

Alicia
¿No están básicamente tomando crédito por el trabajo de un robot? Quiero decir, si uso una calculadora para resolver una ecuación matemática compleja, no de repente me siento como un genio matemático.

Beto
Entiendo completamente ese escepticismo. Pero si conectamos esto con la realidad de la ingeniería de software compleja, el valor central del desarrollador no está realmente en la escritura física de la sintaxis. Está en la ideación, la resolución de problemas y la arquitectura de alto nivel. Piénsalo como ser un arquitecto de un rascacielos. Si alguien te entrega una máquina milagrosa que dibuja instantáneamente los planos perfectos para cualquier diseño que conceptualices, no te sientes como un fraude. Te sientes liberado.

Alicia
Correcto. Porque no estás atascado con una regla dibujando líneas rectas durante horas. Realmente estás diseñando el edificio.

Beto
Exactamente el mismo principio. La IA libera el ancho de banda mental del desarrollador. En lugar de estancarse en los detalles mundanos y frustrantes de cómo teclear una función específica, pueden echar toda su energía en lo que esa función debería lograr para el ecosistema de software en general.

Alicia
Eso tiene mucho sentido.

Beto
Correcto. Les permite explorar soluciones novedosas, abordar desafíos arquitectónicos más grandes y experimentar con ideas complejas. Quizás no tenían tiempo o energía para intentarlo antes.

Así que un costo de participación drásticamente menor, más una recompensa intrínseca mucho mayor por la resolución de problemas de alto nivel.

Alicia
Esto equivale a un aumento masivo en el volumen de código generado.

Beto
Exacto.

Alicia
Bien. Eso tiene todo el sentido porque el costo de generar esas grandes ideas se desplomó casi a cero, el volumen puro de código que se enviaba a dispararse.

Beto
Sí.

Alicia
Pero aquí es donde chocamos con el conflicto central de los datos. Y realmente, la tensión central de todo este análisis profundo.

Beto
Oh, sí. Aquí vamos.

Alicia
El desarrollo de software no es un deporte en solitario. No escribes código brillante, lo lanzas en un vacío y dices que terminaste. Tiene que ser revisado, debatido e integrado con el trabajo que cientos de otras personas están haciendo simultáneamente. Y es exactamente donde este tren de productividad de IA desbocado choca contra un muro de ladrillos masivo.

Beto
Realmente lo hace. Cuando leí este artículo por primera vez, tuve que leer la estadística del cuello de botella principal dos veces. Sí, porque en la superficie, se siente tan completamente contraintuitivo para la promesa de la IA. A pesar de lo increíblemente rápido que se estaba generando todo este código, el tiempo de coordinación, que es el tiempo promedio que tarda la comunidad en revisar, discutir y aceptar una pieza de código, en realidad aumentó en un 8%.

Alicia
Un 8% de carga en el tiempo de coordinación.

Así que la IA acelera salvajemente la fase de creación, pero ralentiza severamente la coordinación de esto.

Beto
Y para entender por qué los engranajes de repente se detienen allí, tenemos que verlo a través de la lente de la "teoría de la coordinación". Si estás en un entorno corporativo tradicional, normalmente tienes una estructura jerárquica, ¿correcto? Un jefe o un gerente sénior dicta el flujo de trabajo. Asigna tareas muy específicas y toma decisiones unilaterales para resolver conflictos.

Alicia
Correcto. Simplemente dicen que lo hagas de esta manera.

Beto
Exacto. Pero el software de código abierto es profundamente descentralizado. No hay un jefe dictando órdenes. La comunidad depende completamente de la discusión entre pares para resolver conflictos e integrar tareas interdependientes.

Alicia
Así que cuando inyectas una IA que infla drásticamente el volumen de ideas complejas en un sistema descentralizado que depende de la conversación, esencialmente bloqueas los canales de comunicación.

Beto
Oh, completamente. Los números que detallan ese bloqueo son asombrosos. Los investigadores rastrearon un aumento del 6.5% en el volumen total de comentarios por envío de código.

Alicia
Vaya.

Beto
Y hubo un aumento del 1.7% en el número de personas únicas que se sumaron a esos hilos de comentarios. Y un aumento del 5.9% en el número de comentarios hechos por desarrollador. Cada persona está hablando mucho más.

Alicia
Y noté que no solo estaban lanzando más emojis o diciendo, "se ve bien".

Los investigadores usaron una herramienta de análisis de texto llamada "Latent Dirichlet Allocation", o LDA ("asignación de distribución latente") para analizar más de 5 millones de comentarios de solicitudes de extracción. Y lo que hace el algoritmo LDA, es mirar grandes bloques de texto y agrupar palabras que aparecen frecuentemente juntas para identificar temas subyacentes.

Así que no era solo contar cuántas veces alguien decía "bug". Mostró que la diversidad real de los temas debatidos se expandió significativamente.

Beto
Lo cual es un hallazgo crucial. La IA estaba ayudando a los desarrolladores a generar tantas aproximaciones diferentes, a utilizar tantas bibliotecas diferentes, y a proponer tantas arquitecturas alternativas, que la comunidad tuvo que pasar por muchos más ciclos iterativos de debate solo para llegar a un consenso sobre qué camino tomar.

Alicia
Es como organizar una reunión de lluvia de ideas corporativa. Imagina que tienes un equipo de 10 personas. Y históricamente, todos aportan una idea bastante buena a la mesa. Discuten 10 ideas, eligen una, van a almorzar.

Pero ahora, gracias a la IA, cada persona entra en esa sala con 10 ideas increíbles, complejas y totalmente desarrolladas.

Beto
Oh, hombre.

Alicia
Correcto. La fase de generación fue ligera y rápida. Y todos se sienten como un genio absoluto. Pero esa reunión ahora va a tomar cuatro horas agotadoras porque tienes que debatir, hacer referencias cruzadas y conciliar una montaña de nuevas perspectivas antes de que puedas decidir qué hacer.

Beto
Esa es la analogía perfecta. Y recuerda, en un sistema de código abierto descentralizado, nadie puede simplemente golpear un mazo y decir, vamos con la idea número 42, reunión terminada.

Alicia
Correcto, no hay jefe.

Beto
Correcto. Ese proceso de conciliación requiere una discusión escrita intensa y prolongada.

Alicia
Así que si el proceso de revisión está tardando 8% más, y las secciones de comentarios están inundadas de debates arquitectónicos complejos, mi primera suposición fue que los revisores sénior, los veteranos que gestionan estos proyectos, están completamente abrumados, o tal vez simplemente están siendo perezosos porque confían en la IA para hacer la revisión por ellos.

Beto
Esa sería la suposición lógica.

Alicia
Pero los datos muestran algo completamente diferente. Y esto revela una división estructural muy profunda en cómo la IA impacta a diferentes tipos de trabajadores.

Beto
Me iría un paso más allá y diría que esta es la revelación más profunda de todo el estudio.

Alicia
¿De verdad?

Beto
Sí. Los proyectos de código abierto generalmente consisten en dos tipos distintos de colaboradores. Tienes desarrolladores principales (core) y desarrolladores periféricos.

Los desarrolladores principales son los internos. Son los arquitectos del proyecto. Contribuyen de manera constante. Mantienen la base de código. Y poseen una profunda comprensión histórica de la visión a largo plazo del proyecto.

Los desarrolladores periféricos, por otro lado, son los forasteros. Son colaboradores irregulares que pueden aparecer para arreglar un error específico o añadir una característica menor. Pero no tienen familiaridad profunda con la estructura general o la historia del proyecto.

Alicia
Y el primer mito importante que esta data desmantela es, que los desarrolladores principales, esos internos, ralentizaron su proceso de revisión porque absolutamente no lo hicieron.

Beto
No, para nada.

Alicia
Su volumen de revisión en realidad aumentó un 5.9%. Hicieron más revisiones, participaron en más discusiones y exhibieron una productividad de revisión general más alta.

Beto
Estaban trabajando más duro que nunca solo para gestionar la avalancha de código nuevo.

Pero el hallazgo más impactante es, ¿quién se benefició realmente más de las capacidades de generación de la IA?

Alicia
Correcto.

Beto
Pensarías que la IA ayudaría más a los desarrolladores periféricos, ¿correcto? Para ayudarlos a ponerse al día.

Alicia
Sí, eso es lo que yo asumiría.

Beto
Pero la IA favoreció enormemente a los desarrolladores principales. La proporción de código fusionado exitosamente proveniente de los internos aumentó en un 6.5%.

Alicia
Espera, ¿entonces los internos que ya tenían el poder y el conocimiento se llevaron aún más de la porción? ¿Por qué funcionó la IA tan bien para ellos?

Beto
Todo se reduce al contexto. Los desarrolladores principales tienen conocimiento institucional profundo, porque conocen la evolución histórica del proyecto: por qué se tomaron ciertas decisiones extrañas hace tres años, o cómo interactúan diferentes módulos. Saben exactamente cómo solicitarle a la IA que genere cambios arquitectónicos grandes y complejos que se alineen perfectamente con las dependencias existentes únicas del proyecto.

Alicia
Así que cuando un desarrollador principal envía su código asistido por IA, encaja como una pieza de rompecabezas faltante. La comunidad lo mira, dice, sí, encaja perfectamente y lo fusiona sin necesidad de un gran debate.

Beto
Precisamente.

Pero para los desarrolladores periféricos, que tienen una historia muy diferente, ciertamente estaban usando la IA para escribir y enviar más código. Pero su tiempo promedio de fusión relativo, el tiempo que pasaron atrapados en el purgatorio de la coordinación, discutiendo en los comentarios, saltó en un 5.4%.

Alicia
Permíteme adivinar. Es porque carecen de ese contexto institucional.

Beto
Exacto. Los investigadores se refieren a esto como "el problema de la aclaración del contexto". Los desarrolladores periféricos simplemente no conocen la historia desordenada del proyecto. Así que encienden Copilot y la IA les ayuda a escribir una pieza de código hermosa y elegante increíblemente rápido.

Alicia
Correcto.

Beto
Pero la IA en sí solo está mirando la solicitud inmediata. Tampoco sabe la historia arquitectónica específica de este proyecto en particular. Así que el desarrollador periférico termina generando lo que los investigadores llaman "código ciego al contexto".

Alicia
Correcto. Para ponerle cara a esto, imagina a un desarrollador periférico hipotético llamado Dave.

Beto
Correcto.

Alicia
Dave encuentra un proyecto de código abierto, quiere añadir una característica nueva y genial, y usa la IA para escribir 500 líneas de código impecable usando la biblioteca de software más nueva y llamativa. Lo envía, sintiéndose genial.

Beto
Naturalmente.

Alicia
Pero Sarah, un desarrollador principal, lo revisa y se da cuenta de que, aunque el código es técnicamente brillante en un vacío, este proyecto específico utiliza una biblioteca más antigua y diferente para la gestión de memoria debido a una decisión heredada tomada hace cuatro años.

Beto
Correcto.

Alicia
Así que el código de Dave es totalmente ciego al contexto.

Beto
Exacto. Y ahora Sarah tiene que saltar a los comentarios y escribir un ensayo de tres párrafos explicando cuatro años de arquitectura histórica a Dave.

Alicia
Oh, hombre.

Beto
Y luego explicarle las 10 cosas específicas que necesita cambiar para que su brillante código de IA encaje en su realidad desordenada.

Alicia
Correcto.

Beto
Ahora, multiplica días por 1000, y puedes ver exactamente cómo los investigadores probaron esto. Al mirar el contenido de esos hilos de comentarios masivos, vieron que las discusiones no eran sobre arreglar errores tipográficos. Eran ejercicios profundos y que consumían mucho tiempo de aclaración del contexto. La IA dio a los desarrolladores periféricos su increíble velocidad, pero no pudo darle conocimiento institucional.

Alicia
Aquí es donde se pone realmente interesante. Porque cuando generalmente hablamos de IA en el "Zeitgeist" cultural, la vemos como este gran igualador, ¿correcto?

Beto
Absolutamente.

Alicia
Pensamos que es una herramienta que ayuda a un empleado junior a ponerse al día con el veterano, haciendo el trabajo pesado. Pero esta investigación muestra que en realidad ha consolidado el poder de los internos.

Beto
Lo hace.

Alicia
¿Significa esto que el conocimiento institucional es ahora la habilidad más valiosa que una persona puede tener?

Beto
Creo que los datos respaldan fuertemente esa conclusión.

A medida que la IA comoditiza el acto básico de la creación, ya sea escribir código, redactar un correo electrónico, o diseñar un logotipo, la prima se desplaza fuertemente hacia el conocimiento contextual: saber qué pedirle a la IA que construya, y saber cómo integrar esa salida en un sistema humano preexistente y complejo, se vuelve exponencialmente más valioso que simplemente poder generar la salida tú mismo.

Alicia
Vaya.

Beto
La IA niveló el campo de juego para la sintaxis básica, pero ampliamente amplió la brecha para la integración a nivel de sistema.

Alicia
Eso es un cambio fascinante en el valor del trabajo humano.

Pero también plantea una pregunta práctica aterradora. Si tienes una acumulación de desarrolladores periféricos inundando el sistema con código ciego al contexto, y tienes un grupo más pequeño de desarrolladores principales tratando frenéticamente de revisarlo, discutirlo e integrarlo todo mientras lidian con una carga del 8% y un tiempo de coordinación, ¿no es el producto final solo un desastre defectuoso y descoordinado?

Beto
Esa es la pregunta definitiva sobre la calidad. Y los datos aquí son maravillosamente matizados. Si solo miras el volumen bruto, el número total de errores y problemas sí aumentó. Los investigadores observaron un aumento del 7% en los problemas totales y un aumento del 5.2% en problemas graves relacionados con errores.

Alicia
Oh, Dios mío. Así que la IA está creando objetivamente más errores y rompiendo cosas. Eso suena como una pesadilla.

Beto
Espera, no es tan apocalíptico.

Alicia
Bien.

Beto
Tienes que mirar la medida normalizada. Sí, el número absoluto de errores aumentó, pero eso es simplemente porque el volumen absoluto de envíos de código aumentó tan drásticamente, cuando los investigadores calcularon los errores y los bugs por solicitud de extracción.

Alicia
Es decir, la calidad normalizada de cada envío individual.

Beto
Exacto. Se mantiene estadísticamente sin cambios.

Alicia
Ah, ya veo. Así que para volver a nuestra analogía del rompecabezas, la calidad de las piezas individuales del rompecabezas no bajó. Simplemente había muchas más piezas de rompecabezas siendo arrojadas a la mesa en general, lo que naturalmente significa que más piezas defectuosas entraron en el mix.

Beto
Ese es el punto clave. La IA no hizo que el código fuera peor. Simplemente aumentó el volumen de todo. El buen código, los errores y las discusiones agotadoras necesarias para arreglar esos errores.

Y esto nos lleva a la conclusión definitiva del análisis cuantitativo del artículo. A pesar de esa carga del 8% en el tiempo de coordinación, a pesar del aumento masivo en los comentarios, y a pesar de la afluencia de código ciego al contexto, el efecto neto general en la productividad sigue siendo positivo.

Alicia
Así que ¿la pura fuerza bruta del auge de la productividad supera la carga de coordinación?

Beto
Sí. Los investigadores midieron la fusión oportuna del código, lo que rastrea cuánto código fue aceptado exitosamente dentro de ventanas de tiempo ajustadas y específicas de un día, tres días y 10 días.

Alicia
Ok.

Beto
En todas esas ventanas, vieron aumentos que oscilaron entre el 3.5% y el 5.1%.

Así que aunque requirió hablar, revisar y fricción significativamente más, la comunidad en su conjunto aún logró enviar código funcional e integrado más rápido de lo que lo hizo antes de que se introdujera la IA.

Alicia
Vaya. Así que si estás escuchando y estás gestionando un equipo ahora mismo, ya sea que estén escribiendo código, redactando documentos legales o preparando un texto de marketing, estos datos deberían ser una llamada de atención masiva.

Beto
Oh, absolutamente.

Alicia
Desplegar IA generativa no solo corta limpiamente la mitad del trabajo de tu equipo para que todos puedan irse temprano. Fundamentalmente cambia dónde reside tu cuello de botella operativo.

Beto
Es un cambio de paradigma completo. Estamos pasando de un mundo donde la restricción principal era la creación, y estamos acelerando hacia un mundo donde la restricción principal es la coordinación y la revisión.

Alicia
Correcto. Si le das a tu equipo creativo una IA para hacerlos más rápidos, podrías encontrarte necesitando contratar más gerentes, más editores y más revisores sénior solo para manejar la avalancha de resultados. Ya no tienes un problema de generación. Tienes un problema de integración. Tu nuevo trabajo a tiempo completo es conciliar todas estas ideas altamente detalladas, hermosamente formateadas, pero ligeramente ciegas al contexto que tu equipo junior está produciendo de repente a velocidad de rayo.

Beto
Y la dura realidad es que, si no ajustas tu estructura organizacional para manejar ese nuevo cuello de botella de integración, toda esa productividad generada por la IA será totalmente inútil. Simplemente se quedará en la bandeja de entrada de un gerente esperando a ser revisada, acumulándose y creando una fricción masiva. Las organizaciones que ganen en esta nueva era no solo serán las que usen la IA para generar más contenido. Serán las que construyan los sistemas de coordinación más robustos y eficientes para integrar realmente ese contenido.

Alicia
Correcto. Quiero dejar a todos con un pensamiento final, ligeramente desconcertante, para que lo piensen hoy.

Beto
Te escuchamos.

Alicia
Hemos establecido claramente que la IA está cambiando el cuello de botella de escribir el trabajo a revisar el trabajo.

Pero los revisores humanos, estos desarrolladores principales, estos gerentes sénior, eventualmente van a llegar a un límite físico absoluto.

Beto
Correcto. Solo pueden hacer tanto.

Alicia
Solo pueden leer tantas envíos ciegos al contexto y escribir tantos comentarios explicativos antes de que se agoten por completo.

Beto
Lo que significa que esa carga de coordinación del 8% no es estática. Eventualmente se convertirá en una carga del 20% o un 50% si el volumen de generación sigue aumentando mientras la capacidad de revisión humana se mantiene exactamente igual.

Alicia
Exacto.

Así que para resolver esta carga de coordinación, es el siguiente paso inevitable construir revisores de IA, o coordinadores de IA que estén entrenados específicamente en el conocimiento institucional profundo y desordenado de una empresa diseñada con el único propósito de evaluar e integrar el trabajo de los generadores de IA.

Beto
Vaya.

Alicia
Y si llegamos a un punto en el que las IAs están generando el trabajo, y otras IAs están revisando, debatiendo y discutiendo el trabajo para forzarlo a alinearse, ¿qué queda exactamente para que haga el humano? ¿Vamos todos a convertirnos en la gente que enchufa las máquinas y miramos las luces parpadeantes?

Beto
Es un punto final lógico profundo y ligeramente aterrador. Quiero decir, trajimos al interno cafeinado para ayudarnos a teclear más rápido. Y pronto podríamos darnos cuenta de que tenemos que contratar a un gerente de IA solo para mantener al interno bajo control.

Alicia
Y de repente, somos nosotros los que vamos a buscar el café.

Bueno, gracias a todos por acompañarnos en esta exploración. Como siempre, sigan cuestionando lo obvio y mantengan sus ojos abiertos para esos cuellos de botella ocultos. Los encontraremos en el próximo análisis profundo.

lunes, 6 de julio de 2026

Integridad académica en educación de informática con IA


Este artículo examina la integración de herramientas de IA generativa en la educación informática, centrándose en cómo equilibrar sus ventajas pedagógicas con la necesidad de integridad académica. Los autores argumentan que, dado que el uso de la IA es ahora una práctica habitual en el ámbito académico, las instituciones deberían pasar de las prohibiciones restrictivas a un marco estructurado de uso responsable. Para ello, el texto clasifica diversas evaluaciones informáticas —como proyectos de codificación y revisiones bibliográficas— y describe estrategias específicas de mitigación, incluyendo la divulgación obligatoria y las defensas orales. Además, los investigadores presentan un modelo matemático formal para cuantificar el esfuerzo del estudiante, el refinamiento de los resultados de la IA y el dominio de la materia durante el proceso de calificación. En definitiva, estas directrices proporcionan una hoja de ruta práctica para que los docentes garanticen que la IA sirva como apoyo al aprendizaje y no como sustituto del pensamiento crítico y el esfuerzo independiente.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Use of AI Tools: Guidelines to Maintain Academic Integrity in Computing Colleges". Por Hatem M. El-boghdadi y colegas. Publicado el 11 de Abril de 2026.

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Imagínate esto. Es finales de 2022 y el mundo académico es lanzado de repente a un caos absoluto.

Alicia
Sí, prácticamente de la noche a la mañana.

Beto
Correcto. De la noche a la mañana, ChatGPT se convierte en la aplicación de crecimiento más rápido en la historia de Internet. Alcanzó a cien millones de usuarios en solo cuestión de meses.

Alicia
Lo cual sigue siendo asombroso de pensar.

Beto
Es salvaje. Y en todo el mundo, las universidades están entrando en pánico. Algunas instituciones lo prohíben de inmediato. Están tratando esta nueva tecnología como si fuera material radiactivo.

Alicia
Sí.

Beto
Y luego otras están luchando por adoptar algo, simplemente reescribiendo sus sílabos sobre la marcha.

Alicia
Bueno, la base de cómo medimos el conocimiento humano, esencialmente se rompió de la noche a la mañana.

Beto
Completamente.

Alicia
Porque durante décadas, el sistema se basó en esta suposición: si un estudiante entregaba un ensayo bien razonado o un fragmento de código funcional, esa producción era un reflejo directo de su esfuerzo cognitivo interno.

Beto
Realmente hacían el trabajo en su cabeza.

Alicia
Exacto. Y de repente, esa suposición fue completamente comprometida. El concepto mismo de integridad académica estaba en el equilibrio.

Beto
Porque el punto de una universidad no es solo producir una pila de papeles perfectamente escritos. Es producir una mente humana que realmente sea capaz de hacer ese trabajo.

Lo que nos lleva a la misión de este análisis profundo. ¿Cómo arreglamos esto?

Alicia
Sí.

Beto
¿Cómo impedimos que los estudiantes simplemente externalicen sus cerebros a la inteligencia artificial, sin prohibir una herramienta que inevitablemente usarán en el mundo real, todos los días?

Alicia
Y el material de origen de hoy aborda exactamente ese problema. Estamos viendo un artículo de 2025 del International Journal of Energy, Environment, and Economics.

Beto
Sí, titulado "Uso de Herramientas de IA, directrices para mantener la integridad académica en facultades de computación".

Alicia
Correcto. Y aunque el enfoque está fuertemente en programas de informática e ingeniería, ...

Beto
... como si fuera la opción más rápida para nosotros.

Alicia
Oh, definitivamente la más rápida y la más disruptiva. Pero el marco que proponen es sorprendentemente universal.

Beto
Sí, yo también lo pensé. Así que, ya sea que seas un estudiante tratando de navegar tus clases, o un educador construyendo un sílabo moderno, o simplemente un aprendiz de por vida descubriendo cómo verificar tus propias habilidades en este mundo saturado de IA, este análisis profundo te dará un marco totalmente nuevo para pensar en cómo demostramos que realmente sabemos algo.

AI_Integrity_Education_Framework_1024.png
Marco de Integridad de IA: Balancear Innovación y Honestidad en Educación de Informática

Beto
Está bien, desglosémoslo.

Alicia
Para apreciar la solución, realmente primero necesitamos mirar por qué el viejo sistema se rompió tan catastróficamente.

Beto
Correcto.

Alicia
Los autores ilustran esto mapeando lo que llaman "el doble impacto de la IA". Funciona esencialmente como una enorme cuerda de guerra en el desarrollo de un estudiante.

Beto
Tirando en dos direcciones totalmente opuestas al mismo tiempo.

Alicia
Exacto.

Beto
Porque por un lado, los beneficios de aprendizaje son innegables. Estamos hablando de un ahorro de tiempo sin precedentes para tareas rutinarias. Generación rápida de ideas.

Alicia
Sí, y un gran impulso en lo que los investigadores llaman "autoeficacia académica".

Beto
Okay, espera, ¿qué significa ese término en este contexto?

Alicia
La autoeficacia académica simplemente significa la creencia de un estudiante en su propia capacidad para tener éxito.

Tener un tutor incansable e instantáneo disponible 24/7 hace que los estudiantes se sientan mucho más seguros. Quiero decir, pueden desenmarañar conceptos complejos a las dos de la mañana sin tener que esperar por las horas de oficina.

Beto
Correcto, lo cual es increíble. Pero el otro extremo de esa cuerda es aterrador.

Alicia
Sí, realmente lo es.

Beto
Porque no es solo la amenaza obvia del plagio, donde un estudiante simplemente copia y pega un ensayo generado por IA. El riesgo más profundo es esta caída brusca en el pensamiento crítico independiente.

Alicia
Porque las habilidades cognitivas y analíticas no simplemente aparecen de la nada.

Beto
Correcto. Las construyes luchando por resolver problemas. Necesitas esa fricción cognitiva. Lo que me hace preguntarme sobre la naturaleza central de la herramienta misma.

Alicia
¿Qué quieres decir?

Beto
¿Es usar la IA algo como llevar una calculadora a una prueba de matemáticas, o es más como contratar a otra persona para que simplemente tome la prueba por ti?

Alicia
Lo fascinante aquí es que el artículo sugiere que puede ser ambas cosas.

Beto
¿En serio?

Alicia
Sí. Y el factor determinante es el entorno que construimos a su alrededor.

Beto
Oh, okay.

Alicia
La IA no regulada actúa absolutamente como un reemplazo para el esfuerzo del estudiante. Se convierte en una persona que contrataste para tomar la prueba.

Pero con directrices claras y límites estructurales, funciona exactamente como esa calculadora o quizás como un simulador de vuelo.

Beto
Una ayuda de apoyo para el aprendizaje.

Alicia
Exacto. Se convierte en una ayuda de apoyo para el aprendizaje. El objetivo no es eliminar la lucha por completo. El objetivo es preservar el desarrollo progresivo de las habilidades cognitivas mientras se utiliza la herramienta para mejorar el proceso, no para eludirlo por completo.

Beto
Correcto. Pero tratar la IA como una calculadora universal asume que todos tienen la misma calculadora.

Alicia
Oh, sí.

Beto
Y sabemos que no todas las herramientas de IA son iguales. Y más importante aún, no todos tienen el mismo acceso a ellas.

Alicia
Ese es un punto enorme.

Beto
El artículo divide específicamente el panorama de amenazas de la IA basándose en la capacidad de la herramienta. Y las diferencias allí son bastante marcadas.

Alicia
Son bestias completamente diferentes. Quiero decir, los modelos de lenguaje grandes, o LLMs, como ChatGPT, son principalmente generadores de texto.

Beto
Correcto.

Alicia
Excelen en el lenguaje natural, la explicación, la ideación. Así que el riesgo principal en un entorno de aula es la comprensión superficial.

Beto
Tal como un estudiante que entrega una revisión de literatura bellamente articulada ...

Alicia
... pero que realmente no capta los conceptos subyacentes. Simplemente posee esta ilusión de competencia.

Beto
Correcto. Lo cual tiene perfecto sentido para una clase de inglés o historia.

Alicia
Sí.

Beto
Pero el enfoque del artículo está en las facultades de computación, donde herramientas como GitHub Copilot no solo están escribiendo ensayos. Quiero decir, están escribiendo software funcional.

Alicia
Sí. Copilot y herramientas similares orientadas a código están diseñadas para la generación de sintaxis y el autocompletado de flujos de trabajo complejos.

Beto
Así que el riesgo se mueve mucho más allá de un ensayo superficial.

Alicia
Exacto. Se mueve hacia la externalización pura de código. Un estudiante podría entregar teóricamente un programa informático completamente funcional, con toda la arquitectura compleja, sin comprender una sola línea de la lógica detrás de él.

Beto
Eso es salvaje. Y cuando miramos a esos asistentes de codificación altamente avanzados o incluso solo a los niveles premium de los LLM, nos encontramos con una gran señal de alarma.

Alicia
El problema de la equidad.

Beto
Sí. El artículo dedica una sección completa a la equidad y la accesibilidad. Sabemos que estas compañías ofrecen niveles gratuitos, ¿verdad?

Alicia
Claro.

Beto
Pero las cosas realmente poderosas, los modelos que pueden diseñar un proyecto de software completo, esos están bloqueados detrás de suscripciones premium de pago.

Alicia
Lo están.

Beto
Así que tengo que preguntar, ¿cómo es mecánicamente justo calificar una clase, cuando algunos estudiantes están conduciendo un coche deportivo y otros están conduciendo una bicicleta? Básicamente solo estás calificando tus cuentas bancarias.

Alicia
Y los autores abordan esa justicia mecánica de frente.

Beto
Okay.

Alicia
Su solución propuesta requiere que las evaluaciones institucionales sean rediseñadas fundamentalmente, de manera que no dependan de características premium exclusivas.

Beto
Okay.

Alicia
Los educadores deben diseñar explícitamente proyectos que puedan completarse utilizando herramientas de acceso libre. Y deben exigir lo que el artículo llama "divulgación del uso de IA".

Beto
... lo que forza la transparencia en todos los ámbitos.

Alicia
Exacto. El instructor también debe utilizar el proceso de verificación de "humano en el ciclo".

Beto
¿El humano en el ciclo?

Alicia
Sí, lo cual nivela el campo de juego, asegurando que la comprensión personal del estudiante sea siempre la métrica final a juzgar, independientemente de la herramienta que usen para generar ese primer borrador.

Beto
Así que sabemos que las herramientas son diferentes y sabemos que el acceso es inherentemente desigual.

Alicia
¿Cómo ponen los instructores realmente este manual de transparencia en práctica? ¿Cómo miran un trabajo entregado fuera del aula y verifican lo que realmente hay en la cabeza del estudiante?

Beto
Entonces, el manual para el trabajo no supervisado fuera de clase se basa en algunos pilares clave.

Alicia
Okay.

Beto
El primero, como acabamos de mencionar, es la divulgación obligatoria del uso de IA. Si lo usas, lo citas y explicas exactamente cómo lo usaste.

Alicia
Entendido.

Beto
El segundo pilar es salvajemente innovador, sin embargo. Son tareas asistidas por IA con revisión crítica. En estas tareas específicas, los instructores realmente obligan a los estudiantes a usar la IA.

Alicia
Espera, ¿hacen obligatorio usar el código trampa?

Beto
Sí. Pero el borrador inicial de IA no es lo que se califica. Se califica a los estudiantes en un informe separado donde deben analizar críticamente la salida de la IA.

Alicia
Okay.

Beto
Deben identificar sus fallas, explicar su lógica subyacente y luego entregar una versión mejorada y modificada intensamente basada en su propia perspicacia humana.

Alicia
Así que el instructor está calificando la capacidad del estudiante para criticar y mejorar a la máquina, no a la máquina en sí.

Beto
Oh, me encanta ese concepto porque simplemente invierte completamente el guión. Pero mirando las otras directrices generales, proponen específicamente entrevistas posteriores a la entrega y exámenes orales. Yo solo veo una pesadilla logística.

Alicia
Sí. Te entiendo.

Beto
Porque exigir una entrevista posterior a la entrega para cada estudiante suena completamente imposible. Quiero decir, algunos de estos profesores universitarios tienen cientos de estudiantes en una sola sala de conferencias.

Alicia
Y los autores anticipan exactamente ese cuello de botella.

Beto
Okay.

Alicia
La solución no es realizar una agotadora defensa oral de una hora para cada tarea semanal de tarea. Más bien, se trata de cambiar el peso de la calificación.

Beto
¿Cómo es eso?

Alicia
La calificación ya no es solo sobre el documento entregado. Una porción sustancial de la calificación ahora está ligada a una demostración de comprensión dirigida y muy rápida.

Beto
Oh, como una auditoría aleatoria.

Alicia
Precisamente como una auditoría. Así que si un estudiante entrega un fragmento de código brillante, el instructor podría pasar tres minutos durante una sesión de laboratorio pidiéndole que simplemente explique por qué eligió una función específica en lugar de una alternativa.

Beto
¿Y si no puede?

Alicia
Si el estudiante no puede explicar la arquitectura de su propia entrega, el código entregado pierde todo su valor.

Beto
Vaya.

Alicia
Sí, es un sistema de verificación puntual que desincentiva dramáticamente la dependencia ciega en la IA, porque el riesgo de exposición está constantemente presente.

Beto
Puesto que los profesores no pueden pasar toda su vida haciendo esas auditorías orales, el artículo proporciona estos ajustes específicos increíblemente ingeniosos a las tareas cotidianas, para básicamente protegerlas de la IA desde el principio.

Aquí es donde se pone realmente interesante. Tenemos que pasar por algunos de estos ajustes tácticos, porque explican activamente cómo fabricar esa fricción cognitiva de la que hablamos antes.

Alicia
La tarea tradicional es un buen lugar para empezar con esto. Históricamente, los instructores usaban indicaciones bastante amplias, tal como "explica cómo funcionan los algoritmos de ordenación".

Beto
Correcto. Y hoy, una IA genérica te dará una respuesta perfecta a eso, como en dos segundos.

Alicia
Exacto. Así que el ajuste táctico es usar restricciones hiperespecíficas.

Beto
Correcto. En lugar de una indicación vaga, el instructor pregunta, "compara la complejidad temporal y espacial del ordenamiento de mezcla ("merge sort") y del ordenamiento rápido ("quicksort") cuando se aplican a un conjunto de datos de 106 elementos bajo las peores condiciones del caso".

Alicia
Y ese nivel de restricción rompe una respuesta de IA genérica.

Beto
¿Lo hace?

Alicia
Oh, sí. Para siquiera plantear correctamente a la IA o para verificar si la IA está alucinando su respuesta, el estudiante tiene que comprender fundamentalmente lo que significa "la complejidad temporal y espacial".

Beto
Correcto.

Alicia
Deben comprender cómo funcionan los límites de memoria cuando se trata de conjuntos de datos masivos. El "prompt" forza al estudiante a contextualizar la salida.

Beto
Y para los ensayos escritos, el artículo recomienda el método del "doble borrador" ("double draft"), que forza ese mismo nivel de contextualización, pero desde un ángulo totalmente diferente.

Alicia
Sí. El doble borrador es fascinante.

Beto
El estudiante tiene que entregar tres cosas: un ensayo generado completamente por IA, un ensayo escrito de forma independiente hecho sin IA, y luego un informe comparativo de evaluación que analiza las diferencias entre los dos.

Alicia
Y la psicología del doble borrador es brillante.

Beto
¿Qué quieres decir?

Alicia
Cuando un estudiante compara dos borradores lado a lado, su cerebro se ve obligado a reconocer sus puntos ciegos. Tiene que preguntar, "¿por qué la IA estructuró el argumento de esta manera? ¿Dónde careció mi borrador independiente de profundidad?"

Beto
Forza el razonamiento activo.

Alicia
Exacto.

Beto
Es casi como pedirle a un artista que muestre sus capas de boceto. No solo la pintura final.

Alicia
Sí.

Beto
Estás calificando el proceso humano desordenado e iterativo.

Alicia
Bueno, me encanta esa analogía. Sí.

Beto
Y vemos esto aplicado también a las tareas de programación, con modificaciones en clase. Por ejemplo, un estudiante escribe su código en casa, tal vez confiando mucho en Copilot, y luego lo trae a clase.

Alicia
Correcto.

Beto
Pero para obtener la calificación, el instructor les da una tarea de modificación en vivo en el momento. Como "cambiar esta variable" o "hacer que el código produzca la salida en orden inverso".

Alicia
Y lo que pasa es que, si no lo escribieron, o no entienden la arquitectura subyacente, se congelarán.

Beto
Congelados por completo.

Alicia
No podrán modificarlo en vivo. Expone instantáneamente quién es el dueño real del conocimiento.

Beto
Muy cierto. Y ¿qué hay de los proyectos colaborativos? Porque el trabajo en grupo es notoriamente doloroso de todos modos, y la IA simplemente hace que sea infinitamente más fácil para una persona automatizar en secreto su parte y sacarla mientras el resto del grupo lucha.

Alicia
Correcto. Para proyectos grupales basados en computadoras, los autores enfatizan el seguimiento del proceso de desarrollo auténtico a lo largo del tiempo utilizando herramientas como Git para control de versiones.

Beto
Okay. Probablemente deberíamos explicar qué es exactamente Git para cualquiera fuera del desarrollo de software.

Alicia
Claro. Piensa en Git como un libro de contabilidad digital o tal vez una cámara de lapso de tiempo para el código. Registra cada pulsación de tecla, cada cambio guardado y registra exactamente quién hizo qué ajuste y cuándo.

Beto
Eso es súper útil.

Alicia
Lo es. Los instructores no solo califican el software final. Califican el libro de contabilidad. Miran los "commits" iterativos y las revisiones entre pares. El producto final es solo una pieza de un rompecabezas mucho más grande de esfuerzo humano verificado.

Beto
Ahora, todas estas directrices tácticas son increíbles en teoría. Pero ¿cómo estandariza una universidad completa esto entre miles de estudiantes?

Alicia
Correcto. Esa es la gran pregunta.

Beto
Por ejemplo, si un algoritmo hiciera el 40% del trabajo en un proyecto, ¿cómo calculas una calificación final que sea matemáticamente justa y consistente, de clase en clase?

Alicia
Si conectamos esto con la imagen más grande, aquí es donde el artículo se eleva de ser solo una lista de consejos de enseñanza ingeniosos a un marco institucional sólido.

Los autores introducen un modelo matemático formal para evaluar las evaluaciones asistidas por IA. Transforman toda esta filosofía de la fricción cognitiva en una ecuación concreta.

Beto
Me entusiasma completamente esta sección. Quiero decir, es como "Moneyball" para la integridad académica.

Alicia
Realmente lo es.

Beto
Están tomando la honestidad como sudor intelectual y la están convirtiendo en una métrica cuantificable. En lugar de calificar todo el proyecto como un gran bloque, el modelo básicamente divide la calificación en tres compartimentos específicos.

Alicia
Exacto. La calificación final es una combinación de tres variables. Primero es la puntuación base, que evalúa la calidad del trabajo realmente entregado.

Beto
Okay.

Alicia
El segundo compartimento es el factor de refinamiento. Esto mide cuánto mejoró el estudiante sobre el borrador inicial de IA.

Y el tercer compartimento es la puntuación de verificación, que es el resultado de esa rápida verificación puntual donde la modificación de código en vivo que discutimos antes.

Beto
Espera, mirando esta ecuación, mirando cómo está estructurada. Si el factor de refinamiento se basa puramente en cuánto mejoró el estudiante el borrador de IA, eso significa que un estudiante que simplemente entrega una salida cruda de ChatGPT obtiene un cero por esa parte de la calificación completa.

Alicia
Lo hacen. Si simplemente copias y pegas, obtienes cero puntos por el refinamiento.

Beto
Vaya. Y como el instructor puede ajustar el peso de cada compartimento, dependiendo de la tarea, castigar matemáticamente el uso perezoso de la IA se vuelve increíblemente fácil.

Beto
Tiene sentido.

Alicia
Para una tarea de codificación, el instructor podría ponderar mucho la verificación en vivo.

Para un informe escrito, el compartimento de refinamiento podría llevar más peso.

Beto
El artículo realmente proporciona un ejemplo trabajado de esto.

Imagina que el estudiante entrega una tarea y la entrega física obtiene una puntuación base del 80%. El instructor evalúa cuánto editó el borrador de IA y le da un 60% por refinamiento. Pero durante la rápida auditoría oral, el estudiante lo logra perfectamente, demostrando una comprensión perfecta, y obtiene una puntuación de verificación del 100%.

Alicia
Así que si el instructor puso los pesos en digamos 40% para la entrega base, 30% para el refinamiento y 30% para la verificación en vivo, la calificación final del estudiante equilibra un 82%.

Beto
Okay.

Alicia
Es una calificación increíblemente matizada que refleja toda la imagen del esfuerzo del estudiante.

Beto
Pero hay un gran obstáculo en este modelo, tal como una medida de seguridad construida justo en la parte inferior de la ecuación.

Alicia
Sí. La bandera de integridad. Es posiblemente la parte más importante, filosóficamente, de todo el modelo.

Beto
Definitivamente.

Alicia
La bandera de integridad es una métrica binaria simple. Es solo un 1 o un 0. Y se calcula basándose en dos cosas: la divulgación y la verificación.

Beto
Significa: ¿admitiste usar IA?, y, ¿aprobaste la auditoría en vivo?

Alicia
Precisamente. Si un estudiante oculta el hecho de que usa IA, o si falla completamente la defensa oral y demuestra que no entiende su propio material entregado, la bandera de integridad baja a 0.

Beto
Y como es un multiplicador en la ecuación, si la bandera de integridad es 0, toda la fórmula de evaluación se multiplica por 0.

Alicia
Exacto.

Beto
Las matemáticas ni siquiera importan más. Todo ese sudor intelectual, todos los puntos que ganan en los otros compartimentos se evaporan por completo.

Alicia
Actúa como un interruptor de apagado definitivo. Inválida la evaluación porque el estudiante violó la premisa central de la honestidad académica.

Beto
Correcto.

Alicia
Esta medida de tolerancia cero es necesaria porque asegura que la fórmula de calificación solo se aplique a estudiantes que realmente estén operando de buena fe. Protege el contrato social de la educación en una era donde fingir confianza nunca ha sido más fácil.

Beto
Entonces, ¿qué significa todo esto? Tomemos un paso atrás y veamos el viaje por donde el material de origen nos llevó.

Alicia
Okay.

Beto
Empezamos en este lugar de pánico institucional total, en 2022, con la IA vista como este código trampa aterrador que iba a romper fundamentalmente el aprendizaje humano.

Alicia
Sí, un gran presagio de desdicha.

Beto
Exacto. Pero terminamos con un flujo de trabajo matemático altamente estructurado. La IA no rompe el sistema, ¿verdad? Cuando se integra con restricciones estrictas, en realidad obliga al cerebro a trabajar más duro.

Alicia
Realmente lo hace.

Beto
Transiciona a los estudiantes de ser meros escritores, a ser editores, críticos y defensores activos de su propia lógica.

Alicia
Representa un cambio monumental en el enfoque, de solo mirar el producto final a evaluar el proceso subyacente.

Beto
Y la lección central aquí va mucho más allá de solo estudiantes universitarios sentados en un laboratorio de ciencias de la computación.

Alicia
Absolutamente.

Beto
Ya sea que estés preparando una presentación importante en el trabajo, redactando un escrito legal, o tratando de aprender un nuevo lenguaje de programación durante los fines de semana, el verdadero valor no está en el documento pulido que ChatGPT escupe en tres segundos.

Alicia
No, para nada.

Beto
El verdadero valor está en la fricción cognitiva. Está en el proceso desordenado de reconocer los puntos ciegos de la IA, desafiar sus suposiciones y comprender por qué el resultado final funciona. Porque si no puedes explicarlo en vivo en la sala, realmente no posees el conocimiento.

Alicia
Esto plantea una pregunta importante, sin embargo, con respecto al futuro de ese proceso exacto. Si la educación se adapta exitosamente a este marco, es decir, si pasamos la próxima década entrenando a los estudiantes no para generar respuestas, sino para criticar y refinar las salidas de la IA, estamos cambiando la naturaleza fundamental del trabajo cognitivo. Pero ¿qué pasa cuando el sitio de evaluación se ponga al día?

Beto
Caminando por ese camino. ¿Cómo se verá eso realmente?

Alicia
Bueno, piensa en la mecánica de la calificación. Si los estudiantes están usando IA para hacer el trabajo pesado de la redacción y están actuando principalmente como editores, ¿qué pasa cuando las instituciones empiecen a desplegar IA altamente avanzada para hacer el trabajo pesado de calificar esas ediciones?

Beto
Oh, hombre.

Alicia
Correcto. Dentro de 10 años, ¿significará la integridad académica que la IA de un estudiante intente astutamente superar a una IA calificadora? O ¿que el instructor humano simplemente se siente y observe la puntuación?

Beto
Vaya.

Alicia
¿Estamos avanzando hacia un bucle académico totalmente automatizado donde los humanos son literalmente solo espectadores?

Beto
Los robots escribiendo los artículos para los robots que están calificando los artículos.

A
Eso es un pensamiento salvaje, ligeramente distópico para dejar pasar y definitivamente algo para que lo reflexiones hasta nuestra próximo análisis profundo.

Beto
Pero mirando hacia atrás al caos de 2022, el instinto inicial fue construir un muro contra la tecnología. Simplemente fingían que no estaba sucediendo. Pero ya no pueden calificar la pintura final. Tienen que calificar las capas de boceto desordenadas que están debajo. Y este marco nos da un plano bastante sólido para cómo hacer eso realmente.

viernes, 17 de abril de 2026

Informe Stanford 2026 - Educación


El informe presentado ilustra un auge global en el interés por la IA que actualmente supera la capacidad de preparación estructural de los sistemas educativos. Si bien la matrícula en ciencias informáticas tradicionales está disminuyendo, se observa un aumento significativo de estudiantes que cursan estudios de posgrado en IA y utilizan herramientas generativas para el trabajo académico. Esta adopción generalizada se topa con una brecha en la implementación, caracterizada por la falta de políticas escolares claras, una formación docente insuficiente y estándares curriculares fragmentados. A nivel nacional, países como China y los Emiratos Árabes Unidos están implementando la enseñanza formal de la IA para asegurar una ventaja competitiva. Mientras tanto, el panorama profesional está cambiando a medida que las personas adquieren cada vez más conocimientos sobre IA y habilidades de ingeniería a través de vías no tradicionales para satisfacer las demandas cambiantes del mercado laboral. A pesar de estos avances, las disparidades de género y raza siguen siendo desafíos persistentes tanto en el profesorado como en la obtención de títulos técnicos.

Enlace al artículo científico, para aquellos interesados en profundizar en el tema: AI Index Report 2026 - Chapter 7 - Education

El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.


Resumen

Beto
Ahora mismo, en este preciso momento, como el 80% de los estudiantes universitarios del mundo están usando inteligencia artificial para sus tareas. Pero aquí está el truco. Más de la mitad admite en privado que en realidad podría estar erosionando su propia capacidad de pensar por sí mismos.

Alicia
Claro.

Beto
Estamos presenciando el experimento cognitivo más grande, más rápido y, honestamente, completamente no regulado en la historia de la educación, y se está desarrollando en tiempo real.

Alicia
Sí. Así que estamos completando partes que las instituciones formales en las que normalmente confiamos para gestionar este tipo de transiciones están, efectivamente, paralizadas. Quiero decir, la tecnología avanza a la velocidad de la luz y nuestra infraestructura educativa todavía funciona con un reloj analógico del siglo XX.

Beto
Completamente. Bienvenidos a un nuevo análisis profundo. Nuestra misión hoy es explorar estos enormes cambios en tiempo real que están ocurriendo en todo el mundo. Analizaremos la explosión en la demanda de educación en IA y cómo los sistemas formales básicamente se están resquebrajando intentando ponerse al día. Extraemos nuestras conclusiones hoy del capítulo 7 del muy esperado informe AI Index 2026.

Alicia
Es un conjunto de datos increíble. Realmente descorre el telón sobre todo, desde la matrícula universitaria global y los cuellos de botella en políticas de K-12 hasta cómo profesionales cotidianos están desesperadamente intentando mejorar sus habilidades.

Beto
Sí. Y si estás escuchando esto ahora, ya seas un estudiante clásico preparándote para una reunión estratégica importante, o intentas averiguar cómo navegar un mercado laboral que cambia rápidamente, o simplemente sientes una curiosidad insaciable sobre hacia dónde va la economía global: entender cómo el mundo está aprendiendo realmente sobre IA es absolutamente crucial para tu propio éxito.

Alicia
Definitivamente.

Beto
Así que vayamos al grano.


Beto
Para entender realmente este panorama, necesitamos empezar por la parte superior del embudo académico, que son las universidades, porque las decisiones de matrícula estudiantil son, esencialmente, una reacción visceral e inmediata al mercado laboral global.

Alicia
Sí. Ellos son "el canario en la mina de carbono".

Beto
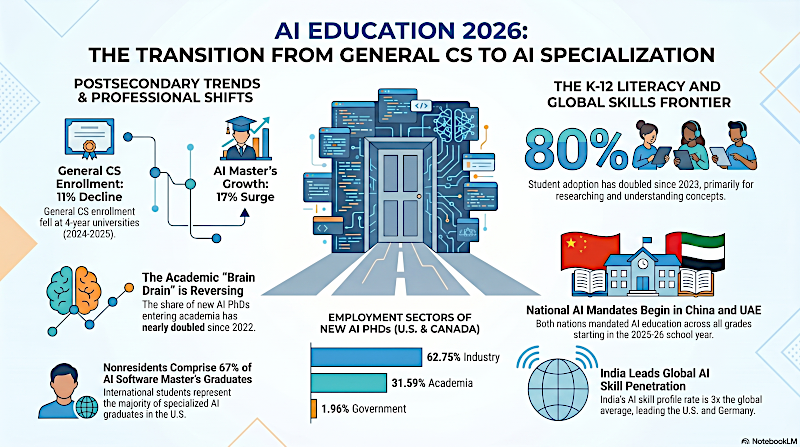
Y los datos aquí me volaron la cabeza: entre 2024 y 2025, la matrícula en programas de grado en informática (computer science) fundamentales cayó en un 11%.

Alicia
Lo cual es enorme.

Beto
Espera, un momento. En los últimos 10 años, el mayor clamor en toda la economía global ha sido "aprende a programar". ¿Por qué de repente la informática fundamental caería más de un 10%?

Alicia
Suena contraintuitivo hasta que miras la mecánica real del mercado laboral de ingeniería de software ahora mismo. El informe vincula este descenso directamente con la automatización de tareas y los puestos de programación de nivel inicial. Piensa en cómo un desarrollador junior solía pasar sus primeros dos años en el trabajo: escribiendo código repetitivo, depurando scripts simples, haciendo el trabajo base.

Beto
Sí. Lo tedioso.

Alicia
Exacto. Pero hoy, un asistente de codificación con IA como Copilot o Cursor puede generar ese código base en, qué, tres segundos. Y la empresa simplemente ya no necesita contratar a un ejército de veinteañeros para hacer la codificación fundamental. El peldaño inferior de la escalera profesional ha desaparecido efectivamente.

Beto
Sí.

Alicia
Y los estudiantes son actores altamente racionales, ¿cierto? Ven que una licenciatura general en CS ya no garantiza un empleo de entrada lucrativo como lo hacía hace cinco años. Y por eso están pivotando.

Beto
OK. Desenmarañémoslo. ¿Este cambio de CS a IA es como la transición entre estudiar cómo construir un motor y estudiar diseño automotriz? Parece que los estudiantes ya no solo quieren saber cómo funcionan las computadoras; quieren saber cómo construir la mente de la IA.

Alicia
Pero lo fascinante aquí es que se parece, pero yo diría que es menos diseño automotriz y más pasar de estudiar metalurgia a estudiar ingeniería civil.

Beto
Interesante.

Alicia
La informática general es la materia prima, ¿no? Es el acero. Es esencial. Pero los estudiantes se dan cuenta de que el mercado ya no paga una prima por la gente que solo sabe forjar acero. El mercado quiere a quienes saben usar ese acero para construir un rascacielos.

Beto
Correcto.

Alicia
Y se van a especializar, y los datos lo prueban. Mientras que la CS general se enfría, el informe del talento en IA de la Casa Blanca muestra que los graduados de máster en campos relacionados con software de IA aumentaron un 17% en un solo año, de 2023 a 2024.

Beto
Así que hay una huida absoluta hacia la especialización. La gente corre para obtener ese conocimiento avanzado. Pero, ¿quién consigue realmente construir esos rascacielos?

Alicia
Sí, esa es una gran pregunta.

Beto
El informe profundiza en la demografía de estos programas de máster en software de IA y está fuertemente sesgada. Las mujeres representan casi el 60% de todos los títulos universitarios, pero solo alcanzan un máximo del 36% entre estos graduados de software de IA.

Alicia
Lo cual es una caída muy pronunciada.

Beto
Lo es. Y vemos una subrepresentación persistente para estudiantes negros, hispanos y nativos americanos también.

Alicia
Esas brechas demográficas representan una enorme pérdida de talento potencial en un campo que, francamente, tiene hambre de talento.

Pero hay otra capa en los datos universitarios que es estructuralmente crítica para la posición de Estados Unidos en la carrera global por la IA.

Beto
¿Cuál es?

Alicia
La abrumadora mayoría de estos estudiantes de posgrado no son residentes de Estados Unidos. En los programas de máster en software de IA, un 67% masivo de los graduados son estudiantes internacionales.

Beto
¿Qué? 67%. Dos tercios del grupo de talento avanzado.

Alicia
Dos tercios.

Beto
Es una dependencia enorme del talento global.

Alicia
Lo es. Y el informe señala explícitamente una vulnerabilidad acumulada aquí. Con cambios en las políticas federales —incluyendo la potencial revocación de visados estudiantiles y entornos que desalientan la matrícula internacional—, se espera ver descensos adicionales en esos números.

Beto
Exacto. Lo que crea un enorme cuello de botella.

Alicia
Exacto. Si EE. UU. forma a las mejores mentes del mundo pero las políticas de visado les obligan a irse inmediatamente tras graduarse, representa una amenaza directa para la canalización de talento doméstico.

Beto
Veo el riesgo ahí. Pero mirando al lado del profesorado universitario, hay un dato que realmente me sorprendió. Durante años, todo lo que hemos oído es la fuga de cerebros, ¿no?

Alicia
El saqueo por parte de las empresas.

Beto
La narrativa siempre fue que las grandes tecnológicas estaban lanzando sueldos millonarios a doctores en IA y las universidades simplemente no podían retener a nadie para enseñar las clases. Pero los datos dicen que esa tendencia se está revirtiendo. Quiero decir, sí, el 65% de los doctores en IA siguen yendo a la industria. Pero la proporción de nuevos doctores en IA que toman cargos académicos casi se ha duplicado desde 2022, subiendo a más del 31%.

Alicia
Sí, eso sorprende a mucha gente.

Beto
Espera, eso no tiene sentido para mí. Pensé que la carrera corporativa por la IA estaba más candente que nunca. ¿Por qué elegiría un doctor de primer nivel un salario universitario en lugar de uno de industria ahora mismo?

Alicia
Asumes que la industria es una mina de oro interminable y sin riesgos. Lo fascinante es que la carrera caótica inicial hacia la industria podría estar estabilizándose.

Beto
¿En serio?

Alicia
Sí. Es decir, las empresas tecnológicas pagan bien, pero la tasa de burnout en los laboratorios corporativos de IA es asombrosa ahora mismo. Además, la academia se está adaptando. Las universidades están formando asociaciones masivas con firmas tecnológicas para obtener acceso al enorme poder de cómputo que los investigadores necesitan desesperadamente.

Beto
Ah, así no tienen que abandonar la universidad para conseguir buen hardware.

Alicia
Precisamente. Además, un puesto académico con tenencia ofrece libertad de investigación que un laboratorio corporativo orientado a producto rara vez permite.

Beto
Así que es una combinación de estabilidad, acceso a cómputo y libertad de investigación, lo cual es increíblemente buena noticia para el sistema. No puedes crear nuevos expertos en IA si no tienes profesores.

Alicia
Exacto. Así que aquí está la tensión: Las universidades están cambiando lentamente sus catálogos de titulaciones y están reteniendo a algunos profesores más, pero esos cambios estructurales tardan años en filtrarse hasta el aula real.

Beto
Lo que plantea la pregunta: si las instituciones se mueven a paso de glaciación, ¿qué están haciendo los estudiantes ahora mismo? Porque los datos revelan que no están esperando a que el currículo se ponga al día.

Alicia
En absoluto.

Beto
Según la encuesta global de Chegg, un 80% masivo de estudiantes universitarios ya están usando IA generativa para la universidad. Literalmente se duplicó desde el 40% en solo dos años.

Alicia
Y la desagregación geográfica es muy reveladora. Indonesia lidera el mundo con un 95% de estudiantes que la usan.

Beto
Wow. 95.

Alicia
Sí. EE. UU. y Reino Unido están en 67%. Y esto no es una experimentación casual. Más de la mitad de esos estudiantes consulta una IA al menos una vez al día.

Beto
Aquí es donde se pone realmente interesante. Existe una narrativa persistente, casi cínica, de que los estudiantes son simplemente perezosos: meten prompts de ensayo en ChatGPT y se van a jugar videojuegos.

Alicia
Pánico por plagio.

Beto
Exacto. Pero Anthropic analizó cómo los estudiantes realmente usan sus herramientas. Y la realidad es muy distinta. Casi el 40%, 39,8% para ser exactos, las usan para crear. Y un 30,2% las usan para analizar. Las tareas de orden inferior, como comprender algo simple o aplicar fórmulas, están solo alrededor del 10% cada una. Así que si los estudiantes usan la IA para analizar textos complejos y sintetizar ideas, ¿no la están tratando básicamente como un compañero de debate personalizado al estilo socrático?

Quiero decir, ¿eso no destruye lo que una tarea tradicional debería ser?

Alicia
Ciertamente destruye la tarea tradicional. Pero no me apresuraría a romantizarlos a todos como rigurosos interlocutores socráticos todavía. Hay una enorme tensión psicológica oculta en estos datos.

Sí, los estudiantes reportan que la IA hace su flujo de trabajo mucho más eficiente, creo que fue un 55% los que dicen que aprendieron más rápido. Pero al mismo tiempo, el 55% de los estudiantes universitarios de EE. UU. también admite que usar estas herramientas ha tenido un efecto mixto en su propia capacidad de pensamiento crítico independiente.

Beto
Espera, ¿entonces saben que los hace más rápidos? Pero también sienten que podría debilitarlos intelectualmente.

Alicia
Exacto. El aprendizaje requiere cierta fricción cognitiva. La lucha productiva de mirar una página en blanco o batallar con un texto denso es lo que realmente construye vías neuronales.

Beto
El trabajo duro.

Alicia
Correcto. Si externalizas la síntesis y el análisis a un algoritmo, quitas la fricción. La tarea se completa, pero no ocurre el desarrollo cognitivo.

Beto
Eso da miedo.

Alicia
Sí.

Beto
¿Pero qué pasa con los estudiantes que se niegan a usarla? Los que se resisten. El informe dice que el 45% de los no usuarios están aterrorizados por acusaciones falsas de mala conducta académica.

Alicia
Sí, esa estadística muestra perfectamente la falla institucional que estamos viendo ahora. La política administrativa está causando una ansiedad mensurable real. En este momento, menos de la mitad de las instituciones de educación superior tienen políticas claras establecidas que regulen el uso aceptable de la IA generativa.

Beto
Así que los estudiantes están atrapados en esta área gris estresante. Saben que necesitan usar las herramientas para mantenerse competitivos con sus pares, pero temen ser expulsados por un escáner automatizado de detección de IA, porque ni siquiera se han escrito las reglas del juego.

Alicia
Es una paradoja total para ellos.

Beto
Si los jóvenes de 19 años están luchando para navegar esta zona gris no regulada, ¿qué pasa cuando miramos a los más jóvenes? ¿Les estamos entregando este mismo poder sin guía a un niño de 10 años?

Alicia
Ahí es donde las cosas se ponen realmente preocupantes.

Beto
Porque al pasar a los datos de K-12, la situación pasa, de una zona gris, a un cuello de botella sistémico. En EE. UU., el acceso a informática fundamental en la secundaria básicamente se ha estancado en el 60%.

Alicia
Sí. Creció con constancia desde el 35% en 2018, pero no se ha movido ni un centímetro desde el año académico 2023–2024. Y ese promedio nacional del 60% enmascara disparidades sistémicas flagrantes.

Beto
Examinémoslas.

Alicia
Si miras las grandes secundarias suburbanas, el 91% ofrece informática, pero en las escuelas pequeñas es solo 44%. Las escuelas rurales están estancadas en el 57%.

Beto
E incluso para los alumnos que toman clases avanzadas, el crecimiento en el examen AP de informática se desaceleró hasta un mero 5% este último año. Así que si la informática es la tubería fundamental necesaria para entender la IA y el acceso a CS en K-12 en EE. UU. se está estancando, ¿no estamos esencialmente tratando de construir un rascacielos de alta tecnología sobre una base agrietada del siglo XX?

Alicia
Exactamente eso está pasando. Esto plantea una pregunta importante sobre los riesgos estructurales de un sistema educativo altamente descentralizado.

Beto
¿Cómo es eso?

Alicia
Bueno, en Estados Unidos, la política educativa no se dicta desde arriba. Está determinada en gran medida a nivel estatal y local. El proyecto Expanding Computing Education Pathways mapeó esto y encontró una brecha de implementación masiva. Ahora mismo, solo cuatro estados enfatizan la IA en sus estándares estatales de informática.

Beto
Cuatro estados. De cincuenta. ¿Pero espera, no emitió el gobierno federal una orden ejecutiva sobre avanzar en la educación en IA?

Alicia
Sí, la emitió. Pero las órdenes ejecutivas federales sobre educación son, en gran medida, guía. Son sugerencias. La responsabilidad operativa real de contratar profesores, comprar software y escribir planes de lección recae por completo en las agencias educativas locales.

Beto
Entonces, espera: si la política educativa es mayoritariamente local y el gobierno federal solo ofrece sugerencias, ¿significa eso que tu código postal determina literalmente tu preparación para la economía del futuro?

Alicia
En un sistema descentralizado, sí. El rigor de la educación en IA de un estudiante está determinado puramente por los impuestos locales y la capacidad administrativa. Un distrito urbano y rico puede permitirse licencias empresariales premium de IA y contratar coaches instruccionales especializados.

Beto
¿Y un distrito pobre?

Alicia
Un distrito pobre y rural puede tener a una única persona de TI intentando atender tres escuelas diferentes. Por eso la encuesta a docentes en este informe es tan alarmante. Solo el 6% de los maestros de K-12 siente que sus escuelas tienen políticas claras y comprensivas sobre IA.

Beto
6%: eso significa que el 94% de los docentes está efectivamente a ciegas, intentando gestionar una revolución industrial en sus aulas sin ningún apoyo institucional.

Estamos describiendo la creación en tiempo real de un nuevo sistema de clases socioeconómicas.

Alicia
Es una vulnerabilidad estructural masiva. Y mientras EE. UU. depende de este mosaico fracturado de distritos locales, competidores globales están tomando decisiones completamente distintas y muy centralizadas. El informe destaca que tanto China como los Emiratos Árabes Unidos impusieron una educación integral e incremental en IA a partir del año escolar 2025–26.

Beto
Lo han hecho obligatorio. ¿Cómo se ve eso en la práctica? ¿Solo le dicen a los profesores que hablen de ChatGPT ocasionalmente?

Alicia
Para nada. En áreas como Pekín y Guangdong han instituido un número mínimo de horas docentes dedicadas y un currículo que progresa formalmente por niveles. Los alumnos de primaria aprenden alfabetización fundamental en IA y ética. Los de secundaria aprenden la mecánica de los algoritmos. Para cuando llegan al instituto, se espera que diseñen y prueben sistemas de IA físicamente. Los EAU han impuesto una canalización muy similar y altamente estructurada.

Beto
Hombre, el equilibrio económico a largo plazo depende totalmente de movimientos como este. Tienes a una superpotencia vertiendo una enorme base centralizada y de hormigón para la próxima generación, mientras la otra espera que miles de distritos subfinanciados se las arreglen por su cuenta.

Alicia
Es un enfoque muy distinto hacia el futuro.

Beto
Entonces, la K-12 formal está fracturada. Las universidades apenas están empezando a pivotar, pero la tecnología avanza más rápido que nunca. Eso significa que la carga de aprender a sobrevivir este cambio ha caído directamente sobre los hombros de los profesionales cotidianos.

Alicia
Sí.

Beto
Esto trae la conversación directamente a ti, el oyente, y a la realidad de tener que mejorar habilidades sobre la marcha.

Alicia
Los datos de LinkedIn en este capítulo ofrecen una ventana brillante sobre cómo reacciona la fuerza laboral. Porque los sistemas formales están rezagados, la gente adquiere habilidades en IA en gran medida en la práctica. Están tomando cursos, obteniendo microcertificaciones y aprendiendo por ensayo y error en el trabajo. Y la carrera global de habilidades es fascinante. India lidera actualmente el mundo en penetración relativa de habilidades en IA.

Beto
¿Por cuánto?

Alicia
Sus profesionales listan habilidades en IA en sus perfiles casi tres veces la media global. EE. UU. está segundo, al doble de la media.

Beto
¿Por qué India se adapta mucho más rápido que el resto del mundo?

Alicia
Por su capacidad: India tiene una enorme economía de externalización tecnológica y de servicios. Esos son los trabajos de conocimiento exactos más vulnerables a la automatización por IA.

Beto
Entiendo.

Alicia
Los profesionales indios reconocen que si no pivotan de ofrecer servicios digitales manuales a ofrecer servicios aumentados por IA, todo su sector podría quedar hueco.

Beto
Pero incluso en este espacio profesional autodidacta y altamente motivado, los datos muestran que estamos replicando las mismas desigualdades que vimos en los datos universitarios. La brecha de género es evidente.

Alicia
Está profundamente arraigada. En India, los hombres listan habilidades en IA en sus perfiles profesionales a una tasa 1,5 veces superior a la de las mujeres. Vemos brechas proporcionales muy similares en EE. UU. y Europa.

Beto
El informe también hace una distinción vital entre los tipos de habilidades que la gente realmente está aprendiendo. Lo dividen en dos categorías: alfabetización en IA, que es saber cómo usar herramientas como Copilot, cómo escribir un buen prompt, cómo integrarlo en tu flujo de trabajo; versus ingeniería de IA, que es la informática pura y dura de construir modelos de aprendizaje automático fundamentales.

Y los datos muestran que la alfabetización en IA está creciendo mucho más rápido que la ingeniería en casi todos los países.

En EE. UU., las habilidades de más rápido crecimiento no son arquitectura de redes neuronales; son cosas como desplegar agentes de IA, prompting de IA y usar Microsoft Copilot Studio.

Alicia
Sí, las aplicaciones prácticas.

Beto
¿Entonces qué significa todo esto?

Para mí, prueba que no necesitas un doctorado en matemáticas avanzadas para prosperar en la economía actual.

Alicia
En absoluto.

Beto
Aprender prompt engineering es menos como aprender un lenguaje complejo de programación como C++, y más como aprender a gestionar a un becario brillante pero extremadamente literal. Un becario que ha leído todos los libros del planeta pero no tiene ningún sentido común. Es un superpoder increíblemente accesible.

Alicia
Si conectamos esto con el panorama general, demuestra que estas vías alternativas autodidactas sí tienen el poder de democratizar el acceso a la economía del futuro. No necesitamos una carrera de cuatro años en una universidad Ivy League para volvernos muy competentes en gestionar a ese becario literal.

Sin embargo, no podemos ser ingenuos sobre cómo escala esto. Si dejamos simplemente que el libre mercado dicte quién tiene acceso a estas herramientas y el tiempo para entrenarse en ellas, simplemente reproducirá las desigualdades históricas.

Beto
Como ya estamos viendo.

Alicia
Correcto. Acabamos de discutir las brechas de género. Discutimos las brechas geográficas entre escuelas rurales y urbanas. Si no intervenimos activamente, la revolución de la IA amplificará nuestras desigualdades sociales existentes en lugar de nivelar el terreno.

Beto
Tiene todo el sentido.

Alicia
Aunque hay algunas excepciones geopolíticas fascinantes a la tendencia de alfabetización. Países como EAU, Chile y Sudáfrica están viendo en realidad un crecimiento más pronunciado en esas habilidades de ingeniería hardcore comparado con la alfabetización básica.

Beto
¿De verdad?

Alicia
Sí. No solo están enseñando a su fuerza laboral a usar las herramientas; están formando a los que construyen las herramientas.

Resumen

Beto
Y esto nos cierra el círculo perfectamente.

Hemos cubierto una enorme cantidad de terreno hoy. Empezamos a nivel universitario desenmarañando esa contraintuitiva caída del 11% en informática fundamental mientras la automatización devora el peldaño inferior de los empleos de codificación y los másteres en IA se disparan.

Alicia
Examinamos la realidad de la experiencia estudiantil, donde el 80% usa globalmente IA para pensamiento de orden superior, pero siguen atrapados en un área gris administrativa, aterrorizados por los algoritmos de mala conducta.

Beto
Profundizamos en la brecha de implementación en K-12, destacando la cruda realidad de que, en un sistema descentralizado, la preparación de un estudiante para la economía de la IA está dictada en gran medida por la financiación de su código postal, mientras naciones como China y los EAU imponen una educación centralizada rigurosa.

Alicia
Y finalmente, vimos cómo el gran auge en la alfabetización autodidacta en IA está empoderando a profesionales comunes, aun cuando amenaza con ampliar las divisiones históricas de género y geográficas.

Beto
Es un panorama donde los aprendices se mueven mucho más rápido que los profesores y la tecnología se mueve más rápido que todos nosotros.

Y antes de despedirnos, quiero dejarte con el pensamiento final que te inquiete:

Alicia
Vimos en los datos de Anthropic que los estudiantes están externalizando cada vez más la pesada carga cognitiva, el análisis, la síntesis, la creación, a la IA. Si toda una generación depende de algoritmos para procesar el pensamiento complejo desde sus deberes de primaria hasta sus carreras profesionales, ¿qué pasa con el desarrollo cognitivo humano?

Beto
Ese es el gran desconocido.

Alicia
En un futuro donde absolutamente todo el mundo tiene un asistente de IA que haga su pensamiento por ellos, ¿será entonces que la habilidad premium más valorada y mejor pagada será, en realidad, la capacidad de pensar completamente sin él?

Beto
Vaya, esa es la pregunta de un millón de dólares. Si la fricción es donde ocurre el crecimiento, ¿qué pasa cuando removemos toda la fricción?

Muchísimas gracias por acompañarnos en esta inmersión profunda. Sigue aprendiendo, sigue cuestionando y sigue explorando tu propia alfabetización en IA. Nos vemos la próxima vez.

viernes, 5 de diciembre de 2025

LLMs para código


Hoy les traigo otro tema científico reciente e interesante. Han creado grandes modelos de lenguaje (LLMs) aptos para generar código y hacer ingeniería de software. Y lo hacen muy bien, quizás mejor que la mayoría de los ingenieros del mundo. Y en la frontera de estos avances, equipos de agentes autónomos que pueden generar sistemas de aplicaciones completas.

Enlace al artículo, para aquellos interesados en profundizar en el tema: "From Code Foundation Models to Agents and Applications: A Comprehensive Survey and Practical Guide to Code Intelligence". 29 autores incluyendo departamentos de investigación de universidades y compañías privadas. Publicado en Diciembre 3 del 2025.

Este es un artículo larguísimo, y parece más bien un libro. Consta de 304 páginas, y más de 1340 citaciones. Para vuestra conveniencia el artículo ha sido resumido, transcrito y traducido al español, usando herramientas de software de Inteligencia Artificial.

El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos, que llamaremos Alicia y Beto.


Resumen

Alicia
Bienvenidos a un nuevo análisis profundo. Hoy dejaremos de lado el arte generativo y las grandes discusiones filosóficas. Nos vamos a centrar en pura potencia de ingeniería.

Beto
Entrar en las tuercas y tornillos.

Alicia
Exacto. Nos adentramos profundamente en el estado actual de los grandes modelos de lenguaje, específicamente diseñados para el desarrollo de software profesional. Los LLMs para código.


Evolución de LLMs para código

Beto
Sí, y esa es una distinción realmente importante. Quiero decir, tus modelos de propósito general, tus GPT estándar o Claude, son increíblemente poderosos para cosas cotidianas. Pero nuestras fuentes muestran de forma consistente que a menudo carecen de esa profundidad crucial, de la robustez y de la alineación de dominio que realmente necesitas para desarrollo de software profesional.

Alicia
¿Qué significa eso en la práctica?

Beto
Bueno, hablamos de mantener invariantes complejas, esas reglas estrictas en tu sistema que simplemente no pueden romperse, especialmente en bases de datos; o de satisfacer contratos de API muy sutiles y navegar por enormes bases de código con múltiples ficheros. Ese nivel de rigor técnico es exactamente por lo que los LLMs especializados en código se han convertido en su propia categoría.

Alicia
Y la línea de tiempo aquí se mueve a un ritmo salvaje. Quiero decir, estamos viendo fuentes que trazan este progreso desde los primeros modelos de código cerrado en 2018, hasta lo que se espera en 2025. Modelos como GPT-5, Claude 4.5, lo último de GROK; es una hiper-evolución que parece casi exigir especialización para mantener el ritmo.

Beto
Absolutamente. El propio espacio de problemas, la ingeniería de software, está tan altamente constreñido que requiere corrección verificable. Y las recetas de entrenamiento tienen que reflejar eso.

Alicia
Así que esa es nuestra misión hoy. Queremos entrar en la sala de máquinas de la especialización. Queremos entender la salsa secreta, ¿verdad?

Los enormes datos curados con los que se entrenan estos modelos, los trucos arquitectónicos únicos que los hacen tan rápidos y eficientes para código, y qué pueden hacer realmente hoy con retos de ingeniería del mundo real. Bien, desempacemos esto.

Probablemente deberíamos comenzar por la base, el combustible de todo esto: los enormes conjuntos de datos de código. Pero parece que la industria ha avanzado más allá de los simples volúmenes gigantes de datos.

Beto
Oh, absolutamente. Ese es el cambio crítico. El recurso más influyente aquí es la familia de conjuntos de datos, el Stack. Proviene de la gran colaboración de código.

Alicia
El Stack, OK.

Beto
Y realmente representa esa comprensión a nivel industria de que la calidad y la gobernanza importan mucho más que la pura cantidad, especialmente cuando trabajas con código.

Alicia
Y hemos visto un escalado serio aquí. El Stack original V1 ya era enorme, 3.1 terabytes.

Beto
Fue impresionante, sí. Código con licencia permisiva a través de cientos de lenguajes. Pero V2 está en otro nivel.

Alicia
Es casi 10 veces más grande.

Beto
Es enorme. El Stack V2 son 32.1 terabytes y cubre más de 600 lenguajes. Pero quizás lo que importa más que la escala es el proceso de gobernanza detrás.

Alicia
¿A qué te refieres con gobernanza?

Beto
Incluye higiene de datos rigurosa como deduplicación avanzada, para que el modelo no memorice simplemente código. Y, de forma crítica, hay un proceso formal y transparente de exclusión (opt-out).

Alicia
Para que los propietarios de repositorios puedan decir: "oye, no uses mi código".

Beto
Exacto. Y ese nivel de curación debe ser una pesadilla operacional masiva. Pero es esencial para generar confianza. Y, francamente, para asegurar la corrección de esa base de entrenamiento.

Alicia
Tiene mucho sentido. Si entrenas con código defectuoso o redundante, simplemente estás horneando esos errores en el modelo final.

Beto
Directamente en el producto final.

Alicia
Bien, pasemos de los datos al silicio, a la arquitectura.

¿Qué características especializadas se incorporan a estos LLMs de código antes del ajuste fino que les dan ventaja?

Beto
Bueno, los modelos de código usan objetivos de preentrenamiento especializados. Van mucho más allá de la simple predicción de tokens siguiente.

Una de las técnicas clave se llama "fill-in-the-middle", o FIM. Se ve en muchos modelos como StarCoder.

Alicia
Fill-in-the-middle. Así que en lugar de solo completar una línea de código, ...

Beto
... se le enseña a predecir un fragmento faltante de código usando contexto tanto de lo que viene antes, el prefijo, como de lo que viene después, el sufijo, al mismo tiempo.

Alicia
Ah, entonces está mirando hacia adelante y hacia atrás en el archivo. Eso parece esencial para la edición de código, ¿no? Bueno, estás cambiando el cuerpo de una función pero dejando todo lo demás intacto.

Beto
Exactamente. Potencia enormemente su capacidad para hacer un relleno ("in-filling"), que es pan de cada día para cualquier asistente de editor de código ("Integrated Development Environment", IDE).

Alicia
¿Qué más?

Beto
También está la predicción de múltiples tokens, ("Multi-Token Prediction", o MTP), donde predice varios tokens a la vez para una mejor coherencia. Y ahora vemos cosas de vanguardia con difusión para código en el entrenamiento.

Alicia
OK. Tenemos que parar en difusión un segundo. La asociamos mayormente con generación de imágenes, ese proceso iterativo de remover el ruido. ¿Cómo se aplica eso al código?

Beto
Todo va de control y diversidad. ¿Sabes cómo un modelo estándar genera código token por token?

Alicia
Sí. Puede quedarse atascado en un camino extraño desde el principio.

Beto
Exacto. El entrenamiento por difusión toma un trozo de código ruidoso o incompleto y luego lo refina iterativamente paso a paso. Esto permite que el modelo coordine mejor la estructura global de la salida.

Alicia
Así obtienes más control sobre la estructura final y probablemente evitas esos ciclos repetitivos raros que a veces ves.

Beto
Esa es la idea. Es una dirección muy prometedora.

Alicia
Aquí es donde el ingeniero se vuelve realmente estratégico, ¿verdad? El movimiento hacia "mezcla de expertos" ("Mixtures of Experts" o arquitecturas MoE), lo hemos visto en todas partes.

Beto
Seguro. La serie DeepSeek es un gran ejemplo en el espacio de código open source, especialmente la V3.2. Su versión tiene este nuevo mecanismo de atención dispersa ("DeepSeek Sparse Attention", DSA).

Alicia
Y la afirmación es bastante grande.

Beto
Lo es. Dicen que reduce el coste de inferencia para entradas largas en un 50%. Y para una audiencia profesional, eso es extremadamente estratégico.

Alicia
Explícame eso. ¿Por qué un recorte del 50% en costes es tan estratégico? Es más que ahorrar algunas monedas en la factura de la nube, supongo.

Beto
Oh, mucho más. Cuando tratas de lograr comprensión a nivel repositorio, tu ventana de contexto puede tener cientos de miles de tokens.

Alicia
Todo el proyecto.

Beto
Claro. Reducir a la mitad el coste de procesarlo hace que la operación en tiempo real sea económicamente viable a escala. Significa que tu asistente de IDE, como el construido sobre Claude 4.5 Sonnet, que mostró grandes mejoras en edición multi-archivo, puede usar ese contexto masivo sin arruinar a la empresa o tardar minutos.

Alicia
Bien, así que esa arquitectura especializada es lo que realmente hace posibles las herramientas comerciales.

Beto
Es lo que sustenta toda la comercialización de los LLMs de código.

Alicia
Eso deja clara la tendencia de especialización. Entonces, si la arquitectura nos da la potencia para parsear y generar código eficientemente, ¿cómo le enseñamos a entender la intención humana y la corrección?

Beto
Bien. Eso nos lleva a la alineación. La segunda fase mayor.

Alicia
El entrenamiento de alineación.

Beto
Exactamente. Aquí es donde adaptas el modelo a instrucciones humanas. Comienza con fine-tuning supervisado ("Supervised Fine-Tuning", o SFT). Y desde el principio, los LLMs de código especializados que se entrenan así tienden a superar a los modelos generales en cosas como la autocompletación de código.

Alicia
Pero SFT ha tenido problemas serios de integridad, ¿no? Las fuentes que leí apuntaron a dos grandes problemas. Filtración de datos y sesgo por complejidad de tareas.

Beto
Son problemas extremadamente serios, sobre todo porque conducen a una falsa sensación de confianza.

Alicia
¿Qué es exactamente la filtración de datos?

Beto
Es la contaminación del conjunto de pruebas. El modelo ha visto las respuestas a las preguntas del benchmark durante su entrenamiento. Así que su rendimiento parece increíble, pero desaparece en el mundo real.

Alicia
¿Y el sesgo por complejidad de tareas?

Beto
Ahí es donde los conjuntos de datos SFT están inundados de tareas simples de completar función. Entonces el modelo se vuelve genial en problemas cortos y fáciles, pero se desmorona completamente cuando le pides diseñar un sistema multiarchivo.

Alicia
¿Cómo están luchando los investigadores contra eso? Vi menciones de usar un LLM para juzgar a otro LLM.

Beto
Sí, esos jueces LLM.

Alicia
Pero ¿no introduce eso otra capa de sesgo potencial?

Beto
Es un punto válido. Pero los nuevos métodos sofisticados se enfocan en detectar solapamientos semánticos, no solo copias exactas. Intentan ver si dos problemas son conceptualmente idénticos, incluso si aparecen redactados de forma diferente.

Alicia
Eso suena computacionalmente caro.

Beto
Lo es. Pero ese rigor es lo necesario para crear benchmarks que realmente prueben la capacidad de razonamiento genuino.

Alicia
Y el razonamiento genuino, parece ser el gran cambio de paradigma aquí. La principal herramienta del modelo para resolver problemas complejos ahora es el propio código.

Beto
Eso es. Nos movemos hacia métodos basados en razonamiento como "cadena de pensamiento ("Chain-of-Thought", CoT) y, aún más efectivamente, los "Modelos de Lenguaje Ayudados por Programa" ("Program-Aided Language Models", o PAL).

Alicia
Con PAL, no pides la respuesta final.

Beto
No. Induces al modelo a generar una serie de pasos ejecutables, normalmente código Python, que te lleven a la respuesta.

Alicia
Así que el modelo básicamente escribe un pequeño programa para resolver el problema meta. Ejecuta ese programa en un intérprete, verifica el resultado y luego genera la solución final.

Beto
Exacto. Es un movimiento crucial porque descarga la lógica compleja y las matemáticas fuera de la red interna no determinista del LLM y las pone en un entorno externo verificable.

Alicia
Y eso le permite autocorregirse.

Beto
Eso le permite autocorregirse con retroalimentación de ejecución. Ese es el salto de la fluidez a la corrección.

Alicia
Y este enfoque en la corrección verificable nos lleva a lo que llamaste la cima de la alineación: el "Aprendizaje por Refuerzo con Recompensas Verificables" ("Reinforcement Learning with Verifiable Rewards", RLVR).

Beto
RLVR es un punto de inflexión crítico.

Alicia
Esto suena como la salsa secreta para conseguir que un modelo sea un ingeniero realmente fiable.

Beto
Así es. Porque optimiza el modelo directamente para una métrica de éxito binaria: el código tiene que ejecutarse y pasar todas las pruebas unitarias.

Alicia
Así que no se trata solo de imitar una solución bien escrita que vio durante el entrenamiento.

Beto
No. La señal de recompensa pasa de algo subjetivo — "¿esto parece bueno?" — a algo objetivo — "¿pasó la prueba?" Sí o no.

Alicia
Y eso requiere conjuntos de datos totalmente nuevos.

Beto
Totalmente. Las fuentes apuntan a cosas como AceCoder-87K, que tiene 87K problemas emparejados explícitamente con casos de prueba automatizados. Proporciona una señal de recompensa clara y sin ambigüedad. Otro, KodCode, se concentra en temas diversos y verificabilidad. Este ciclo de retroalimentación estructurado es cómo los modelos finalmente aprenden a manejar casos límite de forma fiable.

Alicia
Entonces, si cuentas con estas arquitecturas optimizadas y esta alineación impulsada por "Aprendizaje por Refuerzo" ("Reinforcement Learning", RL), ¿cómo se ve realmente en el mundo? ¿Dónde los desarrolladores profesionales están viendo estas capacidades?

Beto
La especialización ahora aparece en tareas realmente complejas que los LLMs tradicionales simplemente no podían manejar. Estamos viendo un rendimiento sólido en comprensión a nivel repositorio.

Alicia
Es decir, completado o refactorización que necesita contexto de múltiples ficheros.

Beto
Múltiples ficheros, dependencias del proyecto, estructura interna, todo el paquete. El modelo tiene que básicamente entender todo el grafo del proyecto.

Alicia
Para que sepa cómo una función utilitaria en un archivo está siendo llamada por una ruta de API en otro y cómo ambos se relacionan con un esquema de base de datos en un tercer archivo.

Beto
Exactamente, el desafío que nuevos benchmarks como RepoEval y CrossCodeEval están diseñados para probar. También lo estamos viendo en aplicaciones multimodales.

Alicia
Generar código a partir de algo que no sea texto.

Beto
Correcto. Generación de interfaces front-end: le das una captura de pantalla de un sitio web y genera un componente React funcional. O generar código boilerplate directamente a partir de un diagrama UML.

Alicia
Pero incluso con todo este progreso, las fuentes dicen que los LLMs generales todavía flojean en tareas de ingeniería largas y multi-paso. Hablan de razonamiento frágil en horizontes largos y de alucinaciones con herramientas.

Beto
Y esa fragilidad es exactamente por lo que necesitamos agentes. Un LLM independiente podría decidir usar un comando git, pero luego inventa una bandera de línea de comandos que no existe.

Alicia
O simplemente se inventa un mensaje de éxito sin haber comprobado nunca el estado del repositorio.

Beto
Precisamente. La solución son agentes de software, que son sistemas que envuelven al LLM con lógica de planificación, ejecución y verificación.

Alicia
Bien, desgranemos los dos diseños principales de agentes que estamos viendo.

Beto
Primero, tienes tus sistemas de agente único. Un buen ejemplo es AlphaCode 2. Es un LLM potente que mejora iterativamente su propio trabajo mediante autorreflexión y re-prompting.

Alicia
Simple y con menor sobrecarga.

Beto
Cierto. Favorece la iteración rápida.

Pero luego tienes el enfoque colaborativo más robusto ...

Alicia
... la tubería de agentes múltiples.

Beto
Y estos sistemas simulan todo un equipo de desarrollo. Frameworks como MetaGPT o ChatDev asignan roles especializados.

Alicia
Como un CEO para la planificación, un programador, un tester.

Beto
Exacto. Esta división del trabajo fortalece la modularidad y minimiza el riesgo de un único punto de fallo o de que una sola alucinación descarrile todo el proceso.

Alicia
Vamos a cerrar con las herramientas comerciales. Las que los desarrolladores usan cada día. Tenemos que empezar con GitHub Copilot.

Beto
Sigue siendo el referente. Copilot procesa algo así como 150 millones de sugerencias de código cada día. Ahora es una potencia multi-modelo.

Alicia
Cierto. Ya no es solo un modelo.

Beto
No, podría por defecto usar algo como GPT-4.5. Pero los usuarios premium pueden acceder a modelos de vanguardia como Claude 4.5 Sonnet o GPT-5. Y, de forma crucial, ha ido mucho más allá de la simple finalización. Funciones como Copilot Edits para refactorización multiarchivo lo colocan firmemente en esa categoría de uso profesional.

Alicia
Y las cifras son enormes. Copilot supuestamente generó alrededor de 500 millones de dólares en ingresos en 2024.

Pero la competencia de herramientas como Cursor se está poniendo realmente intensa.

Beto
Cursor es una historia fascinante. Es un fork de VS Code, pero diseñado desde cero para ser primero-IA ("AI-first"). Realmente crearon funciones como "modo compositor" ("Composer Mode"), ...

Alicia
... que te deja describir cambios a nivel de proyecto en lenguaje natural.

Beto
Correcto. Habilitando refactors complejos que antes eran imposibles. Cambia radicalmente el flujo de trabajo de ser reactivo — aceptar una sugerencia — a ser proactivo y hacer cambios holísticos del sistema.

Alicia
Y puede hacerlo porque gestiona el contexto muy bien, hasta 200,000 tokens.

Beto
Exacto. Resuelve ese problema de comprensión a nivel de repositorio del que hablamos. Y demostró que el modelo funciona. Alcanzaron 500 millones de dólares en ingresos anuales en solo dos años. Es increíble.

Alicia
Y, por último, tienes a Tabnine, que ha tallado un nicho muy potente alrededor de seguridad y privacidad.

Beto
La estrategia entera de Tabnine está construida sobre la gobernanza. Solo entrenan con código con licencia permisiva— MIT, Apache, BSD — lo que elimina completamente el riesgo de propiedad intelectual. Y, más importante para grandes empresas, se especializan en despliegues on-premises y locales.

Alicia
Todo queda detrás del firewall corporativo.

Beto
Obtienes soberanía total sobre los datos. Quizá sacrifiques las funciones más punteras de un Copilot respaldado por GPT-5, pero ganas seguridad total. Para industrias reguladas, es un intercambio no negociable.

Alicia
Ese análisis realmente nos devuelve al círculo completo. Hemos ido de modelos de lenguaje generales hasta estos LLMs de código hiper-especializados, impulsados por datos curados, optimizados por arquitecturas MoE y alineados mediante retroalimentación de ejecución.

Beto
Es una historia increíble de especialización de ingeniería. La industria ha dado pasos monumentales para resolver problemas complejos dentro de un sistema cerrado y verificable: la base de código misma.

Alicia
Correcto. Pero con todo eso, hay un reto mayor que sigue siendo frustrantemente fuera de alcance. A pesar de todo este progreso increíble en codificación, nuestras fuentes muestran que los benchmarks más rigurosos, los que se centran en tareas interactivas sin restricciones a escala web — como los benchmarks de búsqueda web — aún reportan tasas de éxito cercanas a cero, incluso para los mejores modelos.

Beto
Lo que nos lleva a la pregunta definitiva para que la pienses.

Alicia
Si estos LLMs ya son lo suficientemente sofisticados como para escribir, depurar y verificar de forma fiable software perfecto y multiarchivo, ¿por qué el acto aparentemente simple de navegar y lograr un objetivo complejo en la web abierta, ruidosa y caótica sigue siendo un problema importante sin resolver?

Beto
¿Y qué avance fundamental y específico será necesario para finalmente cerrar esa brecha entre el mundo controlado de una base de código y el mundo caótico abierto del razonamiento?