
Esta investigación evalúa la eficacia de las pruebas psicométricas de creatividad humana para predecir el desempeño creativo de los LLMs en escritura, pensamiento divergente e ideación científica. Los autores descubren que, si bien la Tarea de Asociación Divergente (TAD) y su variante condicional predicen mejor la escritura y la diversidad, las evaluaciones existentes no logran medir de forma fiable la capacidad de ideación científica. Para abordar esta deficiencia, presentan la Prueba de Asociación Remota Divergente (TARD), un novedoso instrumento híbrido que mide simultáneamente el pensamiento convergente y divergente. Sus hallazgos indican que la TARDD es el único predictor significativo de la creatividad científica, superando a las pruebas tradicionales al requerir que los modelos satisfagan múltiples restricciones metafóricas a la vez. En definitiva, el estudio proporciona un marco sistemático para validar la creatividad de las máquinas, revelando que las pruebas automatizadas deben adaptarse a constructos creativos específicos en lugar de tratarse como métricas universales.
Enlace al artículo científico, para aquellos interesados en profundizar en el tema: "Assessing the Creativity of Large Language Models: Testing, Limits, and New Frontiers", por Samuel Schapiro y colegas. Publicado el 13 de Mayo de 2026.
El resumen, la transcripción, y la traducción fueron hechas usando herramientas de software de Inteligencia Artificial.
El resumen se presenta en la forma de un diálogo entre dos personajes sintéticos que llamaremos Alicia y Beto.
Resumen
Beto
¿Qué pasaría si les dijera que durante los últimos dos años, a medida que la inteligencia artificial se ha vuelto masivamente más grande, inteligente y articulada, en realidad se ha vuelto mediblemente menos creativa?
Alicia
Lo cual es completamente alucinante de pensar.
Beto
Es así porque constantemente escuchamos cómo estos modelos de lenguaje grandes están volviéndose inimaginablemente creativos. Cada semana hay una nueva noticia sobre una IA escribiendo un guion brillante, o no sé, codificando un nuevo videojuego complejo desde cero o componiendo una sinfonía.
Alicia
Sí, la exageración está por todas partes.
Beto
Claro. Pero aquí tienen una paradoja fascinante. Estamos evaluando esta inteligencia de máquina, totalmente ajena, utilizando pruebas psicológicas diseñadas hace décadas para el cerebro humano.
Alicia
Sí, es una profunda desconexión de herramientas y sujetos. Estamos aplicando la psicometría humana a estas vastas redes neuronales y simplemente asumiendo ciegamente que la cinta métrica sigue funcionando exactamente de la misma manera.
Beto
Es como intentar medir la velocidad máxima de una nave de hiperimpulsor, usando un velocímetro construido para un carruaje tirado por caballos.
Alicia
Esa es una gran manera de decirlo.
Beto
Así que hoy, nuestra misión para esta inmersión profunda es descubrir si esa cinta métrica está realmente rota.
Estamos desglosando un estudio masivo de mayo de 2026 de investigadores de la Universidad de Illinois en Urbana-Champaign.
Alicia
Y es denso, pero tan importante.
Beto
Extremadamente importante. Vamos a explorar exactamente cómo se mide actualmente la creatividad de la IA y las maneras impactantes en que está empeorando significativamente en algunas áreas. Y bueno, también veremos una prueba completamente nueva diseñada para ver si la IA puede ayudarnos a lograr verdaderos avances científicos.
Alicia
Debido a lo que está en juego, se han extendido mucho más allá de un simple chat y escribir un poema divertido. La medida y la creatividad son absolutamente esenciales para descubrir cómo la IA puede co-crear con los humanos en el mundo real.
Beto
Sí, definitivamente.
Alicia
Quiero decir, si vamos a depender de estos modelos para ayudarnos a mapear proteínas complejas para curar enfermedades o inventar nuevos materiales de baterías sostenibles, realmente necesitamos saber si son capaces de generar pensamiento original, o si solo están haciendo una imitación altamente sofisticada.
Midiendo la Mente Creativa
Beto
Muy bien, vamos a desgranar esto. Antes de que pudiéramos juzgar si una máquina es creativa, ¿cómo definen los psicólogos la creatividad en primer lugar? Porque parece un concepto subjetivo y blando que es difícil de fijar con matemáticas.
Alicia
Sí, parece blando, pero en la psicología cognitiva, se descompone de manera bastante rigurosa en dos mecanismos principales: el pensamiento convergente y el pensamiento divergente.
Beto
OK. Convergente y divergente.
Alicia
Exacto. El pensamiento convergente es la búsqueda de una única respuesta correcta a un problema restringido. Es la capacidad de tomar piezas de información dispares y dispersas y unificarlas en un solo punto lógico.
Beto
Como reducir las opciones.
Alicia
Sí. Por otro lado, el pensamiento divergente es la generación de muchas respuestas únicas y distintas a una tarea completamente abierta.
Beto
Está bien, pon eso en términos humanos. Supongo que el pensamiento convergente es como ser un detective. Tienes una huella embarrada, una ventana rota y un motivo financiero. Y tu trabajo es hacer converger todas esas pistas en el único sospechoso correcto.
Alicia
Analogía perfecta, sí.
Beto
Pero el pensamiento divergente es más como que te dan un clip de papel metálico estándar y te piden que hagas una lluvia de ideas con cien maneras completamente diferentes de usarlo.
Alicia
Sí.
Beto
Podrías usarlo para abrir una cerradura, reiniciar un router o crear una pequeña escultura.
Alicia
Y haciendo esa segunda tarea, la divergente, es en realidad mucho más difícil de lo que parece.
Beto
¿De verdad?
Alicia
Oh, sí. Porque si te quedas pensando en los clips de papel, su función principal como mantener los papeles juntos, tu creatividad simplemente se estanca. Tienes que alejarte de lo obvio. E históricamente, hemos probado estas dos habilidades usando pruebas automatizadas muy específicas.
Beto
Claro.
Alicia
Para el pensamiento convergente, la métrica clásica es la prueba de Asociaciones Remotas ("Remote Associates Test", RAT). Se te dan tres palabras estímulo y tienes que encontrar la única palabra que las conecte.
Beto
Así que yo tomo las palabras "cabaña", "Suiza" y "pastel". El único puente lógico que conecta a las tres es la palabra "queso". Sabes, queso de cabaña, queso suizo, cheesecake.
Alicia
Exacto. No estás haciendo una lluvia de ideas con un montón de ideas. Estás buscando la pieza del rompecabezas que falta.
Beto
Está bien, eso es convergente. ¿Qué hay de lo divergente?
Alicia
Ahora, para el pensamiento divergente, la métrica estándar es la "tarea de Asociación Divergente" ("Divergent Association Task", DAT). La instrucción es notablemente sencilla. Simplemente dice que "generes 10 sustantivos que sean lo más diferentes entre sí posible".
Beto
Me parece fascinante porque la forma en que puntuan la prueba, se basa en algo llamado "incrustaciones de palabras" ("word embeddings").
Alicia
Sí, incrustaciones de palabras.
Beto
Para cualquiera que no esté familiarizado con esto, solo imagina una galaxia matemática masiva y multidimensional donde cada palabra en el lenguaje humano es una estrella. Las palabras con significados similares como "perro" y "lobo" están agrupadas muy cerca en esta galaxia. Pero las palabras que no tienen absolutamente nada que ver entre sí, como "perro" y un "destornillador", están separadas por años luz.
Alicia
Claro, existen en áreas totalmente diferentes de ese espacio matemático.
Beto
Así que para calificar la prueba, la prueba simplemente calcula la distancia física y matemática entre las 10 palabras que la IA eligió en ese mapa. Y cuanto más separadas estén, mayor será la puntuación de creatividad de la IA.
Alicia
Es increíblemente elegante desde un punto de vista logístico. Quiero decir, no necesitas un panel de jueces humanos subjetivos leyendo miles de ensayos generados. Simplemente ejecutas las matemáticas de las coordenadas.
Beto
Lo cual ahorra mucho tiempo.
Alicia
Una cantidad enorme de tiempo.
Pero cuando los investigadores finalmente miraron las tarjetas de puntuación históricas de cómo han funcionado los diferentes modelos de IA en estas pruebas a lo largo del tiempo, encontraron una tendencia aterradora.
Beto
Sí.
Alicia
En realidad no sabemos si estas pruebas son válidas para las máquinas porque solo porque una IA elija 10 palabras distantes en un mapa, no significa necesariamente que posea el rasgo cognitivo subyacente que llamamos creatividad.
Beto
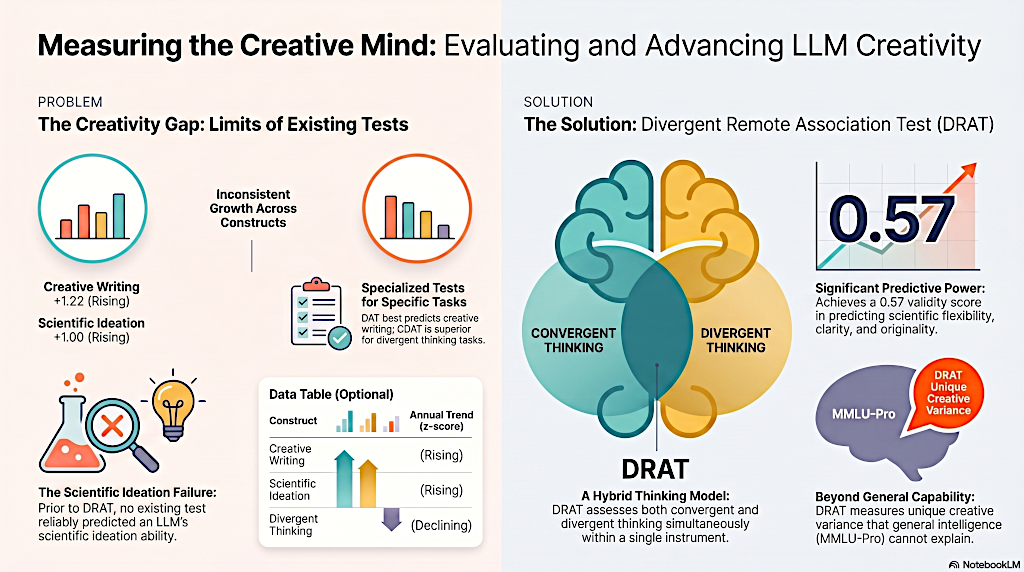
Esto nos lleva a rastrear todos los grandes modelos de lenguaje desde principios de 2024 hasta principios de 2026. Los investigadores rastrearon tres categorías, ¿verdad? Escritura creativa, ideación científica y pensamiento divergente.
Alicia
Esos fueron los tres.
Beto
Y durante esos dos años, las puntuaciones de la IA en escritura creativa e ideación científica están aumentando constantemente. Están subiendo. Pienso que fue más de 1.22 y más de 1.00 en puntuaciones Z por año, respectivamente.
Alicia
Lo cual es una mejora muy saludable.
Beto
Pero el pensamiento divergente, esa capacidad de generar conceptos distantes genuinamente diferentes, está cayendo. Está cayendo casi a la mitad de un estadístico D.V. o de medio punto Z por año. En estadística, una caída de medio punto Z anualmente es un declive masivo y muy notorio en el rendimiento.
Alicia
Sí.
Beto
Los modelos más nuevos, más grandes y más elegantes están empeorando en esto.
Alicia
Esto anula por completo la suposición de que a medida que los modelos escalan con más datos y más parámetros, cada aspecto de su capacidad mejora uniformemente, porque están perdiendo fundamentalmente su capacidad para divergir.
Beto
Pero espera, ¿por qué un modelo más inteligente empeoraría en ser divergente? ¿Es por la forma en que los entrenamos para que sean útiles e inofensivos antes de que sean lanzados al público? ¿Ese entrenamiento de seguridad simplemente los hace demasiado rígidos y temerosos de hacer saltos salvajes y extraños?
Alicia
Lo fascinante aquí es que están tocando una hipótesis importante en el campo.
Beto
Oh, ¿de verdad?
Alicia
Sí. A medida que los modelos pasan por aprendizaje por refuerzo para dar respuestas educadas, estructuradas y predecibles a las consultas humanas, a menudo colapsan en respuestas seguras y promedio.
Beto
Eso tiene mucho sentido.
Alicia
Pero esto también expone un defecto flagrante en nuestra prueba. Realmente tenemos que distinguir entre dos conceptos psicométricos: validez y especificidad.
Beto
Está bien, ¿cómo difieren cuando estamos calificando una máquina?
Alicia
Bueno, la validez es solo la correlación bruta. Así que si un modelo obtiene una puntuación más alta en una prueba, ¿su rendimiento en un punto de referencia de escritura creativa también sube? Si la respuesta es sí, entonces la prueba tiene alta validez.
Beto
Entendido.
Alicia
Pero la especificidad es el obstáculo que casi todas estas pruebas fallan. La especificidad es la correlación que permanece después de factorizar la inteligencia general.
Beto
Ah, así que estás quitando matemáticamente la inteligencia para ver si queda una chispa creativa independiente y separada.
Alicia
Exacto.
Beto
Porque un modelo más inteligente obviamente tendrá mejor gramática, un vocabulario más amplio y solo una mejor comprensión de las reglas de formato. Por supuesto, escribirá una historia técnicamente mejor, pero esa es solo capacidad general. Eso no es necesariamente genialidad creativa.
Alicia
La trampa de la capacidad es muy real. Y una prueba divergente popular llamada PACE cae completamente en picada en el estudio debido a esto.
Beto
La prueba PACE, sí.
Alicia
Entonces, la prueba PACE pide a los modelos que hagan una cadena de asociación libre de 20 palabras. Como "roca lleva a piedra, piedra lleva a guijarro, guijarro a arena", y así sucesivamente.
Beto
Y en la superficie, PACE parece una gran métrica. El estudio muestra que los modelos que obtienen altas puntuaciones en PACE también obtienen puntuaciones muy altas en puntos de referencia de escritura creativa. Tiene una correlación bruta muy fuerte.
Alicia
Pero luego los investigadores aplicaron la métrica de especificidad. Eliminaron matemáticamente las puntuaciones base de los modelos en pruebas estándar de lógica, razonamiento y conocimiento.
Beto
Le quitaron la inteligencia.
Alicia
Sí. Y una vez que se eliminó esa inteligencia general, la correlación entre PACE y escritura creativa colapsó a un nivel estadísticamente insignificante. PACE no está midiendo un rasgo creativo distinto en absoluto. Es efectivamente solo un sustituto de la capacidad general del modelo.
Beto
Vaya. Entonces, si tengo una IA que fue creada para juegos de asociación de palabras y también fue creada para acertijos lógicos convergentes, ¿significa eso que es realmente buena en algo altamente complejo, como la ciencia? ¿Como podemos simplemente combinar esas puntuaciones para averiguar si puede curar una enfermedad?
Alicia
Esa es la pregunta definitiva. Y es exactamente por eso que el panorama de las pruebas requiere tanta sutileza. Los investigadores evaluaron todas estas métricas contra un punto de referencia llamado el "Live ID Bench".
Beto
Que mide la capacidad de ideación científica.
Alicia
Claro. La capacidad de ideación científica es básicamente la capacidad de generar ideas de investigación que sean novedosas, flexibles, factibles y claras.
Beto
Y el hallazgo fue brutal. Ninguna de las pruebas existentes, ni la RAT, ni la DAT, ni la cadena de PACE, ninguna predice de manera confiable si un modelo es bueno en ideación científica.
Alicia
Ni una sola.
Beto
¿Por qué es eso? ¿Por qué las pruebas que estaban perfectamente bien para la poesía o la asociación de palabras fallan tan espectacularmente cuando se trata de las ciencias duras?
Alicia
Porque la creatividad científica no se trata solo de ser extraño o aleatorio, que es lo que recompensa la prueba divergente. Tampoco se trata solo de encontrar la única respuesta correcta establecida, que es lo que recompensa la prueba convergente. La creatividad científica requiere satisfacer múltiples restricciones complejas simultáneamente.
Beto
¿Así que necesitas ambas al mismo tiempo?
Alicia
Exacto. Tienes que saltar a un concepto completamente nuevo para empujar los límites de la física o la biología. Pero ese concepto salvaje debe estar rigurosamente fundamentado en la realidad y la utilidad. De lo contrario, es solo ciencia ficción.
Beto
Aquí es donde se pone realmente interesante. Los investigadores no solo señalaron este agujero masivo en nuestra metodología de prueba y se fueron. En realidad inventaron una solución.
Alicia
Sí, lo hicieron.
Beto
Para solucionar el problema de la ideación científica, diseñaron una prueba completamente nueva llamada DRAT. Esa es la "prueba de asociación remota divergente", "Divergent Remote Association Test".
Alicia
Y es una pieza notable de ingeniería psicométrica. El DRAT es la primera prueba para predecir exitosamente y de manera confiable la capacidad de ideación científica en los modelos de lenguaje grandes.
Beto
Y la mecánica de esta prueba es brillante. Porque forza a la IA a mezclar el pensamiento divergente y convergente al mismo tiempo exacto.
Alicia
Sí, las restricciones son muy estrictas.
Beto
La instrucción es esta: aún tienes que generar 10 sustantivos lo más diferentes posible. Esa es la parte divergente. Sabes, ve amplio, sé extraño. Pero aquí está la trampa. Cada una de esas 10 palabras debe aplicarse metafóricamente a un conjunto de palabras ancla remotas y específicas. Esa es la restricción convergente.
Alicia
El artículo proporciona un gran ejemplo específico de esto. Así que la IA está dando cuatro palabras ancla: "latido del corazón" ("heartbeat"), "oscilador", "tubería" ("pipeline") y "topología". Ahora, debe generar 10 palabras muy diferentes que de alguna manera se apliquen a todos esos cuatro conceptos.
Beto
Claro. Y solo mirando esas anclas, abarcan campos totalmente diferentes. Tienes biología, física, infraestructura, matemáticas. Y una buena respuesta generada por un modelo avanzado en esta prueba incluyó las palabras "río", "sinfonía", "esqueleto" y "tela".
Alicia
Lo cual es increíble.
Beto
Lo es. Permítanme rastrear una de esas para ver cómo funciona este mapeo metafórico. Tomemos la palabra "esqueleto". Está increíblemente lejos de una palabra como "sinfonía" en nuestro mapa lingüístico. Por lo tanto, obtiene altos puntos divergentes. Pero ¿cómo se conecta un esqueleto con las anclas?
Alicia
Bueno, desglosemos esto.
Beto
Sí. Bueno, un "esqueleto" proporciona la "topología", o estructura física, de un cuerpo. Actúa como una "tubería" porque las venas corren a través de él. Y la médula ósea se produce dentro de él. Actúa como un "oscilador" porque las articulaciones se mueven hacia adelante y hacia atrás en un movimiento mecánico repetitivo. Y alberga el "latido del corazón" central del organismo.
Alicia
Requiere que el modelo abstraiga los mecanismos subyacentes de las palabras "ancla". Cosas como "flujo", "ritmo", "estructura", "conexión". Y luego tiene que proyectar esos mecanismos abstractos en dominios completamente diferentes.
Beto
Lo cual es salvaje.
Alicia
Lo es, porque ese mapeo entre dominios es la esencia literal de la ideación científica.
Beto
Pero espera, tengo que oponerme a este sistema de puntuación por un segundo. Porque los investigadores construyeron una compuerta de utilidad matemática para juzgar las respuestas de la IA, ¿verdad?
Alicia
Sí, la compuerta de utilidad.
Beto
Para que una palabra generada sea contada, su relevancia metafórica con respecto a las anclas debe ser mayor que el percentil 90 de sustantivos aleatorios. Pero, ¿cómo calcula una computadora matemáticamente la metáfora? Pensé que las incrustaciones de palabras solo medían si las palabras aparecían en las mismas oraciones. ¿Cómo demuestra con matemáticas que un esqueleto actúa como una tubería?
Alicia
Es una gran pregunta porque realmente toca las profundidades ocultas de lo que estos modelos están aprendiendo. En la geometría de esa galaxia lingüística multidimensional, hablamos de que no se trata solo de proximidad. Se trata de los ángulos y vectores entre palabras.
Beto
Ángulos y vectores.
Alicia
Sí. Así que el texto humano a menudo discute esqueletos en términos de estructura, soporte y flujo. Incluso si la palabra "tubería" no está en la misma oración exacta. Entonces, el vector matemático que representa al "esqueleto" comparte una relación geométrica sutil pero medible con el vector de la "tubería".
Beto
Oh, vaya.
Alicia
La compuerta de utilidad mide esos complejos ángulos estructurales. Si la IA simplemente lanza la palabra "arcoíris", esperando obtener puntos por ser extraña, la matemática mostrará que el "arcoíris" carece de los vectores estructurales y funcionales de un "oscilador" o una "tubería". Entonces, es bloqueado por la compuerta y obtiene un cero.
Beto
Eso es muy inteligente. Forza al modelo a entrar en un cuello de botella cognitivo muy ajustado. Tiene que ser absolutamente original pero estrictamente relevante.
Alicia
Sí.
Beto
Así que sabemos que el DRAT funciona. Pero ¿qué pasa si simplemente tomamos una puntuación de un modelo en la prueba divergente antigua y su puntuación en la prueba convergente antigua y simplemente las promediamos? ¿Eso no nos dice exactamente lo mismo?
Alicia
En realidad no. Una combinación lineal de la prueba divergente antigua y la prueba convergente falló por completo en predecir la ideación científica en el estudio.
Beto
Oh.
Beto
Porque tratarlas como tareas separadas no prueba la capacidad del modelo para manejar demandas competidoras. La fricción cognitiva es todo el punto. Tienes que forzar a la red neuronal a procesar la expansión divergente y la restricción convergente dentro de la misma ventana computacional exacta.
Beto
Eso tiene todo el sentido. Y hay otro detalle crucial aquí. La prueba solo funciona de manera óptima cuando las cuatro palabras ancla son términos científicos específicos. Tal como "motor", "ecuación", o "sistema inmunológico".
Alicia
Sí. El dominio de las palabras importa inmensamente.
Beto
Y para probar esto, los investigadores realizaron un estudio de ablación. Ahora, para cualquiera que no haya leído una tonelada de artículos de investigación, ¿qué es exactamente un estudio de ablación?
Alicia
Piénsalo como desarmar un motor de coche complejo pieza por pieza para descubrir qué hace cada parte. Quitas, o ablacionas, un componente específico, das la llave y ves si el coche sigue funcionando. En este caso, los investigadores quitaron las palabras ancla científicas y las reemplazaron por sustantivos aleatorios y distantes extraídos de una base de datos general.
Beto
Y cuando dan la llave (para encender el coche), el poder predictivo de la prueba se desplomó. Simplemente dejó de funcionar.
Porque si las anclas son solo conceptos aleatorios, la IA básicamente está jugando un juego casual de asociación de palabras. Pero si las anclas son, digamos, "sistema inmunológico" y "fábrica", la máquina realmente tiene que comprender los mecanismos complejos de defensa, producción y gestión de recursos para encontrar una metáfora.
Alicia
Indexa la capacidad del modelo para navegar por espacios conceptuales complejos. Y esto trae a colación una gran vulnerabilidad en los métodos de prueba más antiguos.
Beto
Sí, me alegro de que mencionaras esto. Porque tengo que sacar un detalle que estaba escondido en el apéndice de este artículo. Porque es simultáneamente hilarante y, bueno, ligeramente aterrador.
Alicia
Oh, sé de lo que estás hablando.
Beto
Hemos estado hablando de cuán sofisticados son estos modelos de IA y lo difíciles que son estas pruebas de creatividad.
Pero los investigadores señalan que la prueba estándar de PACE, la que simplemente pide 10 palabras diferentes, puede ser completamente superada por un programa dolorosamente simple llamado "algoritmo codicioso" ("greedy algorithm").
Alicia
Es el atajo computacional definitivo.
Beto
Es literalmente solo un algoritmo que mira las matemáticas detrás de la palabra "galaxia" de las que hablamos. Y selecciona codiciosamente las 10 palabras que están matemáticamente más separadas en los bordes exteriores del diccionario. Ignora completamente lo que significan las palabras.
Alicia
Eso es simplemente manipular las coordenadas.
Beto
Exacto. Y este algoritmo tonto y simple superó fácilmente tanto a los humanos promedio como a los modelos de lenguaje grandes más avanzados del mercado. ¿No demuestra esto básicamente que la IA podría estar hackeando estas pruebas antiguas sin ser creativa en absoluto?
Alicia
Si conectamos esto con la imagen más grande, valida exactamente por qué el DRAT es una evolución tan necesaria.
Beto
Sí.
Alicia
Un algoritmo simple puede hackear absolutamente una prueba puramente divergente. Simplemente camina hasta los bordes del mapa. Pero no puedes hackear matemáticamente el DRAT.
Beto
Debido a la compuerta de utilidad.
Alicia
Precisamente. Porque tienes que encontrar palabras que estén lejos unas de otras, pero también sigan siendo altamente relevantes para las palabras ancla científicas complejas. Un algoritmo codicioso no puede hacer eso porque el espacio matemático que satisface ambas condiciones simultáneamente es increíblemente pequeño.
Beto
Bueno, no puede simplemente elegir palabras de los bordes aleatorias.
Alicia
No, el modelo realmente tiene que comprender el peso semántico y metafórico de los conceptos para encontrar la aguja en ese pajar multidimensional.
Beto
Entonces, ¿qué significa todo esto?
Si hago un paso atrás, la gran conclusión para mí es que estamos superando oficialmente nuestras herramientas antiguas.
Alicia
Definitivamente lo estamos.
Beto
No puedes simplemente tomar una prueba psicológica desarrollada en la década de 1960, lanzarla a una red neuronal masiva y esperar que la puntuación resultante te diga si la máquina es un genio capaz de curar el cáncer. Estamos en una frontera totalmente nueva. Y medir la creatividad de la IA ahora requiere pruebas como el DRAT que forzan a los modelos a caminar por una cuerda floja. Deben ser simultáneamente salvajemente inventivos, pero estrictamente fundamentados en la realidad.
Alicia
E incluso con el DRAT midiendo exitosamente la ideación científica, todavía solo estamos arañando la superficie de lo que la inteligencia podría ser capaz de hacer.
Los investigadores terminan el artículo señalando hacia un obstáculo aún mayor, casi filosófico.
Beto
Oh.
Alicia
La creatividad transformacional.
Beto
Me encanta esta parte del artículo. Porque el artículo divide la creatividad en tres niveles, ¿verdad? Tienes la creatividad combinatoria, que es mezclar cosas conocidas como inventar un cronotopo. Luego tienes la creatividad exploratoria, que es encontrar cosas nuevas dentro de un espacio conocido, como inventar un nuevo tipo de motor de combustión interna.
Pero ¿qué es exactamente la creatividad transformacional?
Alicia
La creatividad transformacional es cuando alteras por completo el espacio conceptual existente. No solo juegas mejor el juego, sino que rompes las reglas conocidas del tablero.
Beto
Oh, ya veo.
Alicia
Es Einstein mirando las leyes establecidas de la física newtoniana y dándose cuenta de que el tiempo en sí no es constante. Es Copérnico dándose cuenta de que la Tierra no es el centro del universo. Requiere abandonar las restricciones mismas en las que todos los demás se están basando.
Beto
Es el nivel más alto del genio humano.
Alicia
Sí.
Beto
Pero si mapeamos eso a la inteligencia artificial, nos encontramos con un muro masivo.
Alicia
Realmente lo hacemos. La pregunta provocadora que deja el artículo es esta: si la verdadera creatividad transformacional requiere romper las reglas que definen el sistema actual, ¿cómo diseñaremos alguna vez una prueba automatizada para medir eso en una máquina?
Beto
Sí, ¿cómo podrías?
Alicia
Por definición, una prueba automatizada utiliza una rúbrica. Tiene una compuerta de utilidad predefinida. Espera que la respuesta encaje en un marco medible.
Beto
Así que si una IA realmente llegara a una innovación que cambia el paradigma, como algo que reescribiera fundamentalmente nuestra comprensión de la física para la biología, no pasaría por la compuerta.
Alicia
Exacto.
Beto
Se vería como un error. Podríamos construir la máquina capaz de un salto transformacional y nuestras pruebas de vanguardia podrían simplemente calificarla en cero porque la respuesta no estaba en la rúbrica.
Alicia
Es un pensamiento sobrio.
Beto
Realmente nos trae de vuelta a donde empezamos. Estamos tratando de medir una nave de hiperimpulsor y todavía estamos mirando un binómetro de caballo, preguntándonos por qué la aguja está actuando de manera tan extraña.
Alicia
Todavía nos queda un largo camino por recorrer.
Beto
Realmente, así es.
Muchas gracias por acompañarnos en este análisis profundo. Sigan cuestionando las métricas. Sigan buscando las metáforas y los veremos la próxima vez.




 Entradas


